内存重排全景 —— 四种重排 × 成因 × 架构
本篇是"重排"导读 reordering-overview 的第3层(内存重排)细分篇。前面 store-buffer 讲了 StoreLoad 一种重排、invalidate-queue 讲了它引发的读侧可见性乱序、atomic 提了内存屏障——但"内存重排"这个话题本身横跨这几篇,一直缺一张总图。本篇就是那张总图。
⚠️ 先分清:本篇讲的内存重排(跨核可见顺序)和 CPU 乱序执行(cpu-out-of-order,单核性能引擎)不是一回事——详见导读 reordering-overview 第一节。
核心澄清:经典内存重排就是 4 种(LoadLoad / LoadStore / StoreLoad / StoreStore),不是"StoreLoad 又分几种"。真正的复杂度在另一个维度——同一种重排可能由不同硬件部件造成,且各 CPU 架构允不允许它各不相同。所以本篇的主线是一张二维矩阵:
4 种重排 × (成因 / 架构 / 怎么封堵)。
分工:部件怎么造成重排看分篇(store-buffer/invalidate-queue);四种重排的全景、跨架构对比、屏障如何逐一对应看本篇。
一、什么叫"重排":程序序 vs 内存序
先把概念钉死。一段代码里内存操作的书写顺序叫程序序(program order);而其他核实际观察到这些操作生效的顺序叫内存序(memory order)。两者不一定相等——中间隔着编译器、乱序流水线、store buffer、invalidate queue 好几层,每层都可能让"别人看到的顺序 ≠ 你写的顺序"。
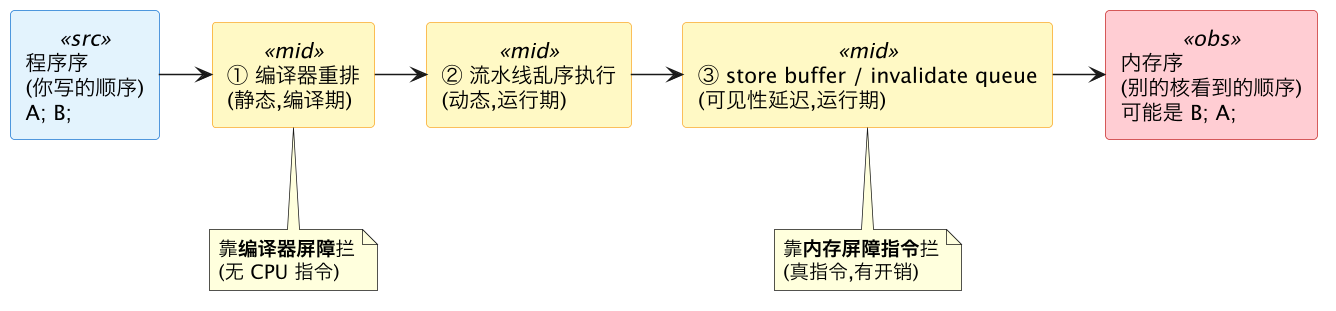
关键:"重排"不是一个机制,而是多层机制叠加后的现象。同一种"LoadLoad 被重排"可能来自编译器、也可能来自乱序执行、还可能来自 invalidate queue——封堵手段也因成因而异(编译器屏障 vs 硬件屏障)。这是理解一切的前提,下面先分清四种,再分清成因。
二、四种重排:两两操作的 4 种先后颠倒
任意两条内存操作,按"前一条是读还是写、后一条是读还是写"排列组合,只有 4 种。所谓"某种重排",就是这一对的先后顺序对外被颠倒:
| 重排类型 | 程序序 | 被重排后(对外可见) | 一句话 |
|---|---|---|---|
| LoadLoad | 读A; 读B; | 别人看 读B 的效果先于 读A | 两个读被换序 |
| LoadStore | 读A; 写B; | 写B 的效果先于 读A 完成 | 读还没做完,后面的写先生效了 |
| StoreStore | 写A; 写B; | 别人先看到 B 的新值、后看到 A 的 | 两个写被换序 |
| StoreLoad | 写A; 读B; | 读B 先执行、写A 的新值还没对别人可见 | 写被拖后、读被提前 |
记忆法:名字 = "前操作类型 + 后操作类型",XY 重排 就是"程序序里 X 在前 Y 在后,却被颠倒成 Y 先生效"。
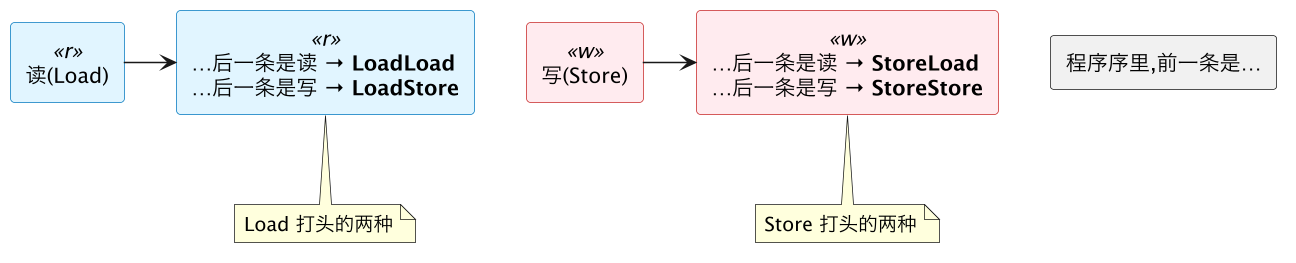
这 4 种里,StoreLoad 最"顽固"(几乎所有架构都允许,因为它来自 store buffer 这个人人都有的部件),StoreStore/LoadLoad 次之(强模型禁、弱模型允),LoadStore 各架构差异也大。下一节把"允不允许"按架构摊开。
三、成因归属:每种重排是谁造成的
这是本篇最有价值的一张表——把 4 种重排映射到具体硬件部件,你就知道"要防它该用哪种屏障、以及为什么 x86 上大多不用防"。
| 重排 | 主要成因(硬件部件/机制) | x86-TSO | ARM/Power(弱序) | 对应分篇 |
|---|---|---|---|---|
| StoreLoad | store buffer:写压在 buffer 没提交,后面的读先打到缓存 | ✅ 允许 | ✅ 允许 | store-buffer §4 |
| StoreStore | store buffer 非 FIFO 提交(弱序)/写合并 | ❌ 禁(FIFO) | ✅ 允许 | store-buffer §4.3 |
| LoadLoad | invalidate queue(失效延迟生效,读到旧值)+ 投机乱序执行读 | ❌ 禁 | ✅ 允许 | invalidate-queue §3-4 |
| LoadStore | 乱序执行:读未完成时后面的写先提交 | ❌ 禁 | ✅ 允许 | invalidate-queue §4 |
从这张表能一眼看出几件事:
- x86 只放行 StoreLoad 一种——因为 x86 的 store buffer 是 FIFO(挡住 StoreStore)、读不被暴露地投机重排(machine-clear 拉回,挡住 LoadLoad/LoadStore)。这就是"x86 是强内存模型 TSO"的全部含义:唯一漏网的是 store buffer 造成的 StoreLoad。
- ARM/Power 四种全放行——store buffer 不保证 FIFO、invalidate queue 乱序对软件可见、读可投机重排。所以同一段无屏障代码"x86 上碰巧对、ARM 上偶发错"。
- StoreLoad 是唯一"人人都有"的重排——因为 store buffer 是几乎所有现代 CPU 的标配,没人愿意为了消灭 StoreLoad 而砍掉 store buffer(那等于回到"写就干等"的年代)。所以连最强的 x86 也留着它。
一句话:x86-TSO = "只有 StoreLoad"、ARM/Power = "四种都有"。差异的根源不是"谁更先进",而是弱模型把更多硬件缓冲的乱序直接暴露给软件(换更高性能),让软件用屏障按需收口;强模型替你兜住了大部分(编程简单,但硬件多做了保证)。
四、三种成因,三种拦截手段(别用错)
第一节说"重排是多层叠加",这里落到实处:同一种重排,成因在哪一层,就得用哪一层的屏障拦。用错层完全无效。
| 成因层 | 什么时候发生 | 现象 | 拦截手段 | 有无 CPU 指令 |
|---|---|---|---|---|
| 编译器重排 | 编译期(静态) | 编译器为优化调换无依赖的读写 | 编译器屏障 asm volatile("":::"memory")、std::atomic_signal_fence | ❌ 无指令,零运行开销 |
| 流水线乱序执行 | 运行期 | 乱序引擎投机执行 | x86 靠 machine-clear 自动拉回 TSO(基本不用管);弱模型靠硬件屏障 | —— |
| store buffer / invalidate queue | 运行期 | 写可见延迟 / 失效延迟生效 | 硬件内存屏障 mfence/lfence/sfence、dmb/ldar/stlr | ✅ 真指令,有开销 |
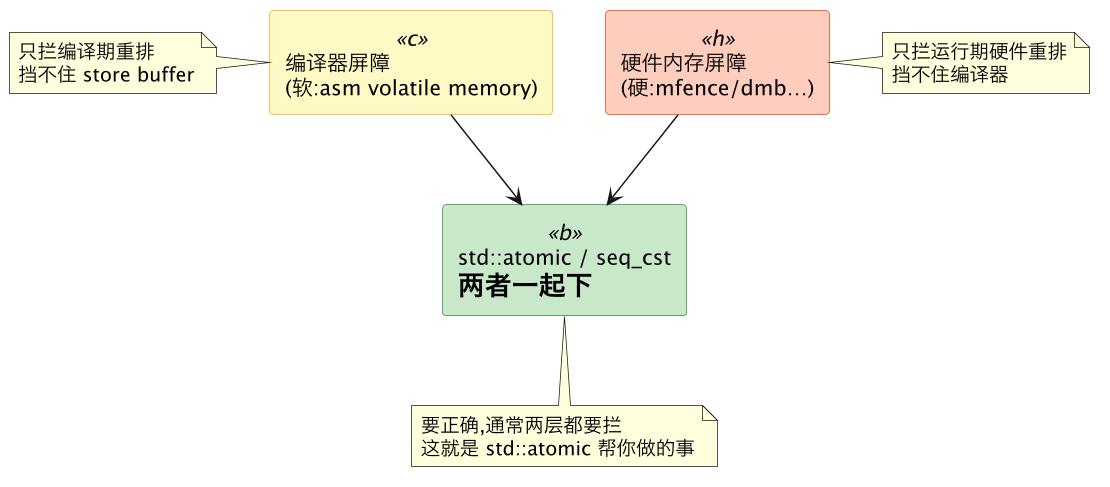
最容易踩的坑:以为加了编译器屏障(asm volatile("":::"memory"))就万事大吉——它只拦编译器,拦不住 store buffer 的 StoreLoad。反过来,std::atomic 的 seq_cst 会同时压住编译器和硬件两头,所以才"贵但安全"。
五、屏障如何逐一封堵四种重排
内存屏障不是"一刀切全禁",而是按需只禁某几种——这正是 release/acquire/seq_cst 分档的本质:各自对应"禁哪几种重排"。
| 屏障(概念) | 禁止的重排 | C++ 对应 | 硬件例子 | 典型用途 |
|---|---|---|---|---|
| LoadLoad + LoadStore 屏障 | 屏障前的读不能被排到屏障后 | acquire | ARM ldar;x86 普通 load 自带 | 读锁/读标志后,保证后续读到的是新数据 |
| StoreStore + LoadStore 屏障 | 屏障后的写不能被排到屏障前 | release | ARM stlr;x86 普通 store 自带 | 写完数据再发布标志,保证别人看到标志时数据已就绪 |
| 全屏障(含 StoreLoad) | 四种全禁(尤其 StoreLoad) | seq_cst | x86 mfence/lock;ARM dmb ish | 需要全局一致顺序(如 Dekker 锁) |
几个要点串起前面的分篇:
acquire(读屏障) 治的是 LoadLoad/LoadStore——正是 invalidate-queue 里"排空失效队列、别读到旧值"那半;所以acquire的硬件含义就是排空 invalidate queue。release(写屏障) 治的是 StoreStore/LoadStore——正是 store-buffer 里"让此前的写先出去"那半;所以release的硬件含义偏向按序排空 store buffer。- 只有
seq_cst/全屏障能治 StoreLoad——因为 StoreLoad 来自 store buffer 的本质(写没提交、读先跑),必须强制排空 store buffer才堵得住,这也是mfence/lock最贵的原因。acquire/release 都各做半边,唯独不碰 StoreLoad,所以便宜。 release/acquire必须配对:发布方release(写侧,压 store buffer)、接收方acquire(读侧,排 invalidate queue),两半合起来才封住一次"发布-读取"的完整乱序窗口(见 invalidate-queue §4 的 producer/consumer)。
一句话:屏障的分档 = "禁哪几种重排"的分档。acquire 管两种(读打头)、release 管两种(写收尾)、seq_cst 管全部(唯一能收拾 StoreLoad 的)。选最弱够用的那档,就是内存序调优的全部。
六、一张全景速查表(收口)
把前面所有维度压成一张表——遇到"这个重排是什么/谁造成的/x86 会不会/怎么防"直接查这里:
| 重排 | 含义 | 主因部件 | x86 | ARM | 防它用 |
|---|---|---|---|---|---|
| LoadLoad | 两读换序 | invalidate queue + 投机读 | ❌ | ✅ | acquire |
| LoadStore | 读未完写先行 | 乱序执行 | ❌ | ✅ | acquire 或 release |
| StoreStore | 两写换序 | store buffer 非 FIFO | ❌ | ✅ | release |
| StoreLoad | 写后读提前 | store buffer(人人都有) | ✅ | ✅ | 仅 seq_cst/全屏障 |
配套记忆:
- 横看架构:x86 那列只有 StoreLoad 打 ✅(强模型 TSO);ARM 那列全 ✅(弱模型)。
- 竖看防御:读打头的(LoadLoad/LoadStore)归
acquire,写收尾的(StoreStore/LoadStore)归release,唯独 StoreLoad 谁都收拾不了、只能上全屏障。 - LoadStore 出现两次:它既能被 acquire(约束前面的读)也能被 release(约束后面的写)挡住,是唯一"两边都沾"的重排。
七、和本仓库其他文档的关系
- 成因分篇:store-buffer(StoreLoad/StoreStore 的来源——发起侧缓冲)、invalidate-queue(LoadLoad/LoadStore 的来源——接收侧缓冲)。本篇是这两篇的导读,建议先读分篇看机制、再回本篇看全景。
- 应用:atomic(
std::memory_order各档、lock自带全屏障)——本篇第五节的屏障分档,就是 atomic 里 relaxed/acquire/release/seq_cst 的重排语义解释。 - C++ 语义视角:memory-order——从 happens-before / synchronizes-with 模型自顶向下讲六个
memory_order各自承诺什么、配可运行代码。本篇讲硬件为什么、那篇讲语言怎么用,互补。 - 上游硬件:msi/mesi(一致性协议保证"最终一致",而重排讨论的是"中间过程的顺序可见性"——协议管值对不对,内存序管顺序看得对不对,是正交的两件事)。
- 观测:内存序相关的流水线清空可用 perf 看(x86 的
machine_clears.memory_ordering就是投机读违反 TSO 被拉回的计数):
perf stat -e cycles,instructions,machine_clears.memory_ordering ./app
perf list | grep -i "machine_clears\|mem_"
八、一句话总结
内存重排只有 4 种(LoadLoad/LoadStore/StoreStore/StoreLoad),复杂的不是种类而是"成因 × 架构":每种由不同硬件部件造成(store buffer 管 Store 打头的、invalidate queue 管 Load 打头的),x86-TSO 只放行 StoreLoad、ARM/Power 四种全放行。封堵要对成因下药——编译期用编译器屏障、运行期用硬件屏障;而屏障的 acquire/release/seq_cst 分档,本质就是"禁哪几种重排"的分档,其中只有 seq_cst/全屏障能收拾那个人人都有、最顽固的 StoreLoad。