Core Dump 机制详解 —— 从产生原理到崩溃现场分析
崩溃排查的另一条主线。前面
tools/里的工具解决"进程还活着、但很慢/很忙";Core Dump 解决"进程已经死了、要还原案发现场"。二者互补:性能问题看实时工具,崩溃问题看 core。
一、Core Dump 是什么
Core Dump(核心转储)是进程异常终止瞬间的内存快照:操作系统把崩溃那一刻的内存镜像、CPU 寄存器、函数调用栈、线程列表、进程信息等,按 ELF 格式写到磁盘的一个文件里。
它相当于案发现场的完整监控录像——日志只记录你主动打印的、你预料到会出事的地方,而 core 直接冻结了整个进程状态,告诉你:
- 哪一行崩的、哪个线程崩的、哪块内存非法
- 完整调用栈(谁调了谁、参数是什么)
- 所有变量的值(全局、局部、堆)
- CPU 寄存器(
rip程序计数器停在哪、rsp栈指针指向哪) - 打开的文件描述符、信号掩码、栈有没有被踩坏
最适用场景:一个月才偶发一次、无法实时复现的随机崩溃(如高并发下的内存竞争)。这类问题日志往往只留一句 Segmentation fault,core 是唯一救命稻草。C/C++ 这类无 GC 的语言尤其依赖它。
Core 文件的本质(ELF 两类段)
core 文件和可执行程序、.so 是同一种 ELF 格式,可用 readelf -l core、objdump 直接解析。核心是两类段:
| 段类型 | 内容 | 作用 |
|---|---|---|
PT_NOTE | 进程 PID/UID、信号信息、CPU 寄存器状态、线程列表等元数据 | GDB 解析 core 的核心依据 |
PT_LOAD | 崩溃瞬间的用户态内存完整镜像:代码段、数据段、堆、栈、共享库映射 | 把进程内存空间完整"冻住" |
下面这张概念卡把 core dump 的本质与产生条件一图收束:它是内核(不是程序自己)在致命信号发生时拍下的 ELF 快照,PT_NOTE 存寄存器与信号等元数据、PT_LOAD 冻住整个内存空间;能否生成还取决于 ulimit、dumpable 标志与 core_pattern 三道开关。
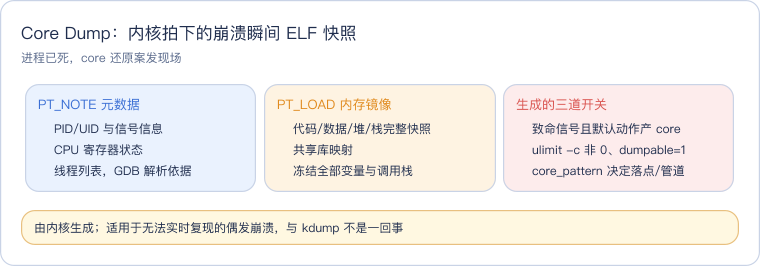
边界:这里讲的是用户态进程的 core dump,和内核崩溃用的
kdump不是一回事(kdump 是内核挂了时用的)。名字来自老 UNIX 年代的磁芯内存(core memory)。
二、产生机制(核心问答)
Core dump 不是程序自己生成的,而是由内核生成。 内核像"监考老师",进程一"作弊"(非法访问内存、触发致命错误),内核就叫停它并拍下现场。
完整流程(12 步)
① 进程在用户态触发异常(如访问非法内存)
② CPU 切到内核态,抛硬件异常
③ 内核解析异常,判定为用户态进程的致命错误 → 发送对应致命信号
④ 信号分发时检查处理方式:若是默认处理(SIG_DFL) 且该信号默认行为是产生 core → 进入转储流程
⑤ 检查 rlimit(core file size / ulimit -c):为 0 直接终止,不生成 core
⑥ 检查 dumpable 标志(/proc/<pid>/dumpable):为 0 不生成
⑦ 解析 /proc/sys/kernel/core_pattern:判断是文件路径还是管道程序
⑧ 文件路径分支:检查路径权限、磁盘空间 → 创建文件 → 写入内存镜像+元数据
⑨ 管道分支:启动管道程序,通过标准输入把 core 数据喂给它
⑩ 转储完成
⑪ 内核终止进程,释放资源
⑫ 结束一句话概括:进程异常 → 内核捕获信号 → 检查配置(ulimit/dumpable/core_pattern) → 冻结进程 → 导出内存映像 → 写文件 → 终结进程。
哪些信号会触发 core(默认行为)
| 信号 | 编号 | 典型触发场景 |
|---|---|---|
SIGSEGV | 11 | 段错误:空指针、野指针、越界、无权限访问(最常见) |
SIGABRT | 6 | abort():assert 失败、double free、glibc 内存 corruption 检测 |
SIGFPE | 8 | 浮点异常:除零、数值溢出、非法浮点运算 |
SIGILL | 4 | 非法指令:栈破坏后跳到无效地址、CPU 不支持的指令 |
SIGBUS | 7 | 总线错误:内存对齐错误、mmap 文件被截断、物理地址非法 |
SIGQUIT | 3 | 键盘 Ctrl+\,用户主动终止并生成 core |
SIGTRAP | 5 | 断点陷阱(调试器用) |
SIGSYS | 31 | 非法系统调用 |
SIGKILL(9) 不会产生 core——直接杀死,进程连"写遗书"的机会都没有。这就是kill -9和 OOM Killer 杀掉的进程都没有 core 的原因。
为什么我的机器不产生 core?(原因清单)
ulimit -c为 0(发行版默认,怕撑爆磁盘)- core 路径无写权限 / 磁盘满 / inode 耗尽
core_pattern指向的管道程序执行失败- 进程
setrlimit自己限制了 core 大小 - SUID/SGID 进程,出于安全内核默认不生成(需
fs.suid_dumpable) core_pattern是相对路径且当前目录不可写- 用了
prctl(PR_SET_DUMPABLE, 0)主动禁用 - 收到的是
SIGKILL(9) - systemd 服务没在 .service 里设
LimitCORE,不继承 shell 的 ulimit(超高频坑,见第四节) - 给致命信号注册了非
SIG_DFL的自定义 handler,内核不再自动转储
三、启用与配置
3.1 soft limit vs hard limit(先搞懂,否则配置不生效)
| 含义 | 谁能改 | |
|---|---|---|
| soft limit | 当前进程实际生效的限制 | 普通用户可调高,但上限是 hard limit |
| hard limit | 资源的最大上限 | 只有 root 能提高 |
ulimit -c unlimited 只改 soft limit;若 hard limit 本来很小,普通用户改不动。所以永久配置要两个都设。
3.2 临时开启
ulimit -c            # 查看当前限制,输出 0 表示禁用
ulimit -c unlimited  # 开启(仅当前 shell 及其子进程生效,重启失效)
3.3 core_pattern —— 自定义路径与命名(最推荐)
默认文件名就叫 core 或 core.<pid>,多进程崩溃会互相覆盖,也没有崩溃时间/程序名。改 /proc/sys/kernel/core_pattern 解决:
# root 权限,统一存到 /var/core,带时间戳、程序名、PID、信号编号
echo '/var/core/core-%t-%e-%p-s%s' > /proc/sys/kernel/core_pattern
占位符:
| 占位符 | 含义 | 占位符 | 含义 | |
|---|---|---|---|---|
%t | 时间戳(秒) | %s | 导致转储的信号编号 | |
%e | 可执行文件名 | %h | 主机名(集群必备) | |
%p | 进程 PID | %u/%g | 进程 UID / GID(多租户必备) | |
%E | 可执行文件完整路径(/→!) |
坑:
/proc/sys/kernel/core_uses_pid只在 core_pattern 是默认的core时才生效;一旦你改了 core_pattern,它就失效,别被老教程误导。
实践建议:给
/var/core挂独立分区,避免 core 撑爆系统盘。
3.4 管道模式
core_pattern 以 | 开头时,内核把 core 数据通过标准输入喂给管道程序。现代发行版多走这条路(如 systemd-coredump),也可自定义脚本实现自动分析/告警/归档(见第四节 4.3)。
3.5 永久生效完整示例
# 永久配 ulimit(重启不失效)——给所有用户开 core 无限制
echo '* soft core unlimited' >> /etc/security/limits.conf
echo '* hard core unlimited' >> /etc/security/limits.conf

# 永久配 core_pattern
echo 'kernel.core_pattern = /var/core/core-%t-%e-%p-s%s' >> /etc/sysctl.conf
sysctl -p        # 立即生效
不同发行版细节有差异,对照自己系统文档核对,别无脑复制。
四、systemd 与容器环境
4.1 超高频坑:systemd 服务不生成 core
systemd 管理的服务不继承 shell 的 ulimit! 哪怕你 ulimit -c unlimited 后手动跑能生成,systemd 起的服务就是不生成。必须在 .service 里显式设置:
# /etc/systemd/system/your-service.service
[Service]
ExecStart=/usr/bin/your-app
LimitCORE=infinity          # 核心:开启 core 无限制
WorkingDirectory=/var/core  # 可选:确保工作目录可写
改完必须:
systemctl daemon-reload
systemctl restart your-service
4.2 systemd-coredump 与 coredumpctl
⚠️ 核心前提:coredumpctl 只管理 systemd-coredump 捕获的 core。 如果
kernel.core_pattern指向传统文件路径(如/var/core/core.%e.%p)或自定义管道脚本,core 文件虽然会生成,但 coredumpctl 看不到。可以用cat /proc/sys/kernel/core_pattern确认当前配置。
现代发行版默认把 core 交给 systemd-coredump,core_pattern 被设成:
|/usr/lib/systemd/systemd-coredump %P %u %g %s %t %c %h
如何判断你的环境是否走了 systemd-coredump:
cat /proc/sys/kernel/core_pattern→ 看是否包含systemd-coredumpsystemctl status systemd-coredump→ 看服务是否 running- 如果 core_pattern 是文件路径(如
/var/core/...),说明是传统模式,coredumpctl 命令必然返回空- 切换到 systemd-coredump:
sudo sysctl -w kernel.core_pattern='|/usr/lib/systemd/systemd-coredump %P %u %g %s %t %c %h'(重启后可能被覆盖,需要/etc/sysctl.conf里也改掉kernel.core_pattern)
优势:自动压缩、带时间戳命名、不覆盖、自带管理工具。配置在 /etc/systemd/coredump.conf:
[Coredump]
Storage=external      # external=存 /var/lib/systemd/coredump,journal=存日志,none=不存
Compress=yes          # 自动压缩
ProcessSizeMax=10G    # 单个 core 最大
MaxUse=100G           # 总存储上限
KeepFree=20G          # 至少保留的磁盘空间
coredumpctl 管理工具(不用自己找文件):
coredumpctl list                      # 列出所有捕获的 core
coredumpctl info                      # 最近一次崩溃详情
coredumpctl debug                     # 直接用 GDB 分析最近的 core(自动找二进制+符号)
coredumpctl debug /usr/bin/myapp      # 分析指定程序
coredumpctl dump <PID> -o my.core     # 导出 core 文件
coredumpctl --until="3 days ago" delete   # 清理 3 天前的
4.3 崩溃自动处理脚本(管道模式)
生产环境不可能天天盯服务器。写个管道脚本,崩溃时自动生成调用栈、压缩、告警、清理:
#!/bin/bash
# /opt/coredump-handler.sh
# 内核按顺序传入:%e %p %t %s %u %g
EXE_NAME=$1; PID=$2; TIMESTAMP=$3; SIGNAL=$4; UID=$5; GID=$6
CORE_DIR="/var/core"; LOG="/var/log/coredump-handler.log"; KEEP_DAYS=7; MAX=10G
mkdir -p "$CORE_DIR"; cd "$CORE_DIR" || exit 1
CORE="core-${EXE_NAME}-${PID}-${TIMESTAMP}-signal${SIGNAL}"
echo "[$(date '+%F %T')] 捕获 core: 程序=$EXE_NAME PID=$PID 信号=$SIGNAL" >> "$LOG"

# 从标准输入收 core,限制大小并压缩
cat | head -c "$MAX" | gzip -c > "${CORE}.gz"

# 自动生成调用栈(需 gdb + 带符号的二进制)
if [ -x /usr/bin/gdb ]; then
  EXE=$(readlink -f /proc/${PID}/exe 2>/dev/null)
  [ -f "$EXE" ] && gdb -batch -ex "bt full" -ex "thread apply all bt full" \
      "$EXE" <(zcat "${CORE}.gz") > "${CORE}.backtrace" 2>&1
fi

# 清理过期文件
find "$CORE_DIR" -type f -mtime +${KEEP_DAYS} -name "core-*" -delete

# 可选:curl 推送企业微信/钉钉/飞书告警chmod +x /opt/coredump-handler.sh
echo '|/opt/coredump-handler.sh %e %p %t %s %u %g' > /proc/sys/kernel/core_pattern4.4 容器 / Kubernetes
core_pattern 是内核级参数,容器共享宿主机内核,所以必须在宿主机节点配置;容器内只需单独设 ulimit。
Docker:
# 宿主机:配 core_pattern
echo "/var/core/core-%e-%p-%t" > /proc/sys/kernel/core_pattern

# 启动容器:设 core ulimit + 挂载宿主机 core 目录
docker run --ulimit core=-1:-1 -v /var/core:/var/core myimage ./myappKubernetes:① 用 DaemonSet 在所有节点统一配 core_pattern;② Pod 里设 ulimit 并挂载宿主机目录:
spec:
  containers:
  - name: app
    image: your-app-image
    securityContext:
      capabilities:
        add: ["SYS_PTRACE"]   # 可选,gdb/gcore 需要
    volumeMounts:
    - name: core-dir
      mountPath: /var/core
  volumes:
  - name: core-dir
hostPath: { path: /var/core, type: DirectoryOrCreate }关键:容器内生成的 core,必须用生成时容器镜像里的二进制来分析,否则符号不匹配。
4.5 手动触发:gcore(不杀进程)
进程没崩、但要抓现场(内存泄漏、死锁、CPU 100% 且不能重启)时:
gcore -o /tmp/myapp-core $(pidof myapp) # 生成 /tmp/myapp-core.<pid>,进程继续运行死锁排查神器——程序卡死不会崩、不会自动产生 core,用 gcore 手动抓。
4.6 程序内主动开启(守护进程必备)
守护进程不继承 shell ulimit,可在启动最开始、fork 之前主动开:
#include <sys/resource.h>
#include <sys/prctl.h>
int enable_core_dump() {
    struct rlimit rl = { RLIM_INFINITY, RLIM_INFINITY };
    if (setrlimit(RLIMIT_CORE, &rl) != 0) { perror("setrlimit"); return -1; }
    if (prctl(PR_SET_DUMPABLE, 1, 0, 0, 0) != 0) { perror("prctl"); return -1; }
    return 0;
}
fork+exec的子进程,exec 后 dumpable 可能被清除,需在子进程里重设prctl(PR_SET_DUMPABLE, 1)。
五、用 GDB 分析 core(全流程)
5.1 前置:符号必须对(bt 全是问号 90% 是符号问题)
核心原则:符号必须和 core 匹配——分析 core 的二进制必须是生成 core 时那一个(重编都不行),否则 bt 全是问号。
生产标准玩法是分离调试符号:线上二进制 strip 后很小,符号单独归档,分析时再"接"回来。完整三步配方(objcopy --only-keep-debug → strip → objcopy --add-gnu-debuglink)、build-id 精确匹配、版本归档见 symbol-separation。
系统库符号缺失(libc/libstdc++ 全是问号)用 debuginfod 自动下载,无需手动装 debuginfo 包(细节见 symbol-separation 第四节):
export DEBUGINFOD_URLS="https://debuginfod.ubuntu.com"   # 或 centos: https://debuginfod.centos.org
gdb ./test core.file
5.2 加载与基本流程
gdb ./myapp /path/to/core.file    # 格式:gdb <崩溃时的二进制> <core文件>
coredumpctl debug                 # systemd 环境一条命令直达
进入后典型流程:
- 看崩溃信息:加载后自动打印
   Program terminated with signal SIGSEGV, Segmentation fault.

#0 0x... in ?? ()- 看调用栈
bt full:带局部变量、参数的完整栈。空指针类问题这里直接给出函数和行号:
   (gdb) bt
   #0  Test::print (this=0x0) at test.cpp:6      <- this=0x0,空指针实锤
#1 0x... in main () at test.cpp:13- 栈被破坏了?看寄存器
info registers:栈溢出会让bt全是问号,此时看rip(崩溃指令地址)、rbp/rsp。若rbp的值转成 ASCII 正好是你的字符串内容 → 栈被字符串覆盖了。 - 反汇编对源码
disassemble /m <func>:看栈布局,确认buf在rbp-0x10、strcpy把返回地址覆盖了。 - 看源码
list <func>确认 bug 行。
5.3 GDB 核心命令表
| 命令 | 作用 |
|---|---|
bt / bt full | 调用栈 / 带局部变量+参数的完整栈 |
thread apply all bt / ... bt full | 所有线程的栈(死锁、多线程必打) |
frame N / f N | 切到第 N 层栈帧 |
info locals | 当前帧的局部变量 |
print 变量 / p 变量 | 打印变量/表达式 |
list / l | 显示当前帧源码 |
info registers | 所有 CPU 寄存器 |
disassemble /m 函数 | 带源码的反汇编 |
x /64xb $rsp | 查看内存(这里:栈顶 64 字节,十六进制) |
info sharedlibrary | 已加载的动态库,确认符号是否加载 |
set sysroot 目录 | 指定系统库根目录(容器/交叉编译 core 分析) |
图形化:ddd、kdbg、VSCode C/C++ 插件(可直接打开 core 可视化调试,新手友好)。
六、高频崩溃场景速查
| 场景 | 信号 | 排查要点 |
|---|---|---|
| 空指针访问 | SIGSEGV | bt 看行号 → p this/p 指针 看是否 0x0 → 回溯为何没初始化 |
| double free / use-after-free | SIGABRT | bt 见 __GI_abort/malloc_printerr/_int_free;看提示 double free or corruption;回溯指针生命周期 |
| 栈溢出 / 栈破坏 | SIGSEGV/SIGILL | bt 全问号 → info registers 看 rbp/rip 是否被字符串覆盖 → x /64xb $rsp 看栈内容 → 回溯数组/字符串越界写 |
| 死锁(卡死不崩) | 无 | gcore 抓 dump → thread apply all bt full → 找卡在 pthread_mutex_lock 的线程 → 理清"持有谁、等待谁"的循环 |
| 总线错误 | SIGBUS | 确认是内存访问指令 → 看地址是否对齐 → 查 mmap 文件是否被截断 |
SIGSEGV vs SIGBUS 区别:SIGSEGV 是访问了非法的虚拟地址;SIGBUS 是虚拟地址合法、但对应物理地址无效或对齐错误。
栈破坏定位技巧:编译加
-fno-omit-frame-pointer -fstack-protector,栈被踩时直接报stack smashing detected并定位到函数。
七、生产环境实践
分环境策略
| 环境 | 策略 |
|---|---|
| 开发/测试 | 全开:ulimit -c unlimited、固定目录、保留所有 core、完整符号 |
| 预发/压测 | 限制:core 最大 2G、自动压缩、留 7 天、自动出调用栈并告警、符号分离随镜像归档 |
| 生产 | 严控:仅核心进程开启、独立分区、最大 10G、加密存储留 3 天自动清理;支付/用户数据等敏感业务禁用 core 防泄露 |
安全红线(core 含完整内存,可能有明文密码/密钥/隐私)
- 绝不外传、上公网、发第三方(哪怕测试 core)
- 生产 core 必须加密存储、严控访问权限
- 分析完用
shred彻底删除(不是rm),防恢复 - 绝不提交到代码仓库
- SUID/SGID、敏感业务谨慎开启
编译选项
要让 core 的 bt 完整,编译选项是关键:必加 -g(生产可分离符号,不影响运行)、优化用 -O2(-O3 可能指令重排/栈帧优化导致 bt 不完整)、加 -fno-omit-frame-pointer 保栈帧、别用 -fomit-frame-pointer。
各选项对"栈能否回溯完整"的作用、推荐生产组合,见 symbol-separation 第五节 的结构化对照表。
Core 文件管理
- 单独挂独立分区,绝不和系统盘/业务盘混放
- 配自动清理(logrotate 或 systemd-coredump 自带保留天数)
- 生产用管道脚本自动出调用栈,只留压缩 core + 栈日志
- 重大事故的 core 要与对应二进制、符号表、代码版本一起归档,方便复盘
八、FAQ(高频踩坑)
1. 配了 ulimit -c unlimited 还是没 core? 按序排查:
① ulimit -c 确认是 unlimited(只对当前 shell/子进程生效,systemd/crontab/守护进程不继承)→ ② systemd 服务必须 .service 加 LimitCORE=infinity + daemon-reload + restart → ③ 查 core_pattern 路径的写权限/磁盘/inode → ④ cat /proc/<pid>/dumpable 是否为 1 → ⑤ 是否注册了非 SIG_DFL 的信号 handler → ⑥ 是否被 OOM 杀(dmesg | grep -i oom,SIGKILL 无 core)→ ⑦ SUID/SGID 需 fs.suid_dumpable=2(有风险)。
2. bt 全是问号?
① 最常见:二进制和 core 不匹配(必须用生成 core 时那个二进制,重编都不行)→ ② 没加 -g,用 symbol-file test.debug 手动加载 → ③ 系统库符号缺失,开 debuginfod 或装 debuginfo 包 → ④ 栈被破坏,用寄存器/反汇编手动定位 → ⑤ 优化太高/去了帧指针,重编加 -fno-omit-frame-pointer。
3. core 太大(几个 G 甚至几十 G)?
coredump_filter过滤内存段:echo 0x7 > /proc/self/coredump_filter(默认 0x33,0x7 只留匿名私有内存)- 生成时压缩:core_pattern 走管道
|/bin/gzip -c > /var/core/core.%e.%p.gz(省 70%+) - 用 ulimit/
LimitCORE限制最大大小 - 手动抓用
gcore -a的选项控制导出段
4. 被 OOM Killer 杀了没 core? OOM 发的是 SIGKILL(9),不触发 core。
- 确认:
dmesg | grep -i 'out of memory'或journalctl -k | grep -i oom - 解决:排查内存泄漏、加 swap、调 OOM 评分、用 cgroup 限制进程内存提前触发
5. core 是 truncated(截断)? 写了一半就停了。
- 查磁盘空间和 inode
- 确认
ulimit -c是 unlimited(没限制大小) - 确认 core_pattern 路径可写
- 调
coredump_filter减小 core 体积
总结
Core dump 是内核在进程触发致命信号时按 ELF 格式写下的崩溃瞬间快照(PT_NOTE 存寄存器/信号、PT_LOAD 冻住内存),让已经死掉、无法复现的进程也能还原完整调用栈和变量值;它能否生成由 ulimit -c、dumpable、core_pattern 共同决定,分析时必须用产生 core 时的同一套二进制和符号。
最后更新:2025-08-10