MCP 协议:Agent 怎么跟外部工具打交道
最后更新:2026-11-12
MCP(Model Context Protocol,模型上下文协议)是一套开放协议,让 AI 应用能够用统一方式发现并调用外部系统提供的工具、数据和提示模板。它解决的是能力如何标准化接入和复用,不是让模型突然获得原本不存在的能力,也不意味着 Agent 的所有动作都要经过 MCP。
同一个日志分析脚本,Agent 可以直接通过 shell 执行,也可以由 MCP Server 封装后调用。两条路径得到的结果可能完全一样,真正的差别在于:要不要跨客户端复用、要不要集中管理权限与审计、要不要让不熟悉终端的人也能使用。
本文要回答的问题
- Without MCP 与 With MCP 的调用链到底差在哪?
- Host、Client、Server 和实际后端分别负责什么?
- Tools、Resources、Prompts 分别适合暴露什么能力?
- MCP、CLI、普通 API 和 Function Calling 应该怎么选?
- 哪些场景值得引入 MCP,哪些场景只会增加复杂度?
一、Without MCP vs With MCP:同一个 EDA 日志分析任务
假设你已经有一个 analyze_eda_log.py,作用是读取仿真日志、聚合同类错误并返回摘要。现在你希望对 Agent 说:“分析最近一次仿真为什么失败。”
读这张图不要得出“右边更先进”的结论。两条路径使用的是同一个脚本和同一份日志,区别只在接入层:
- Without MCP:Agent 使用内置 Shell、普通脚本或 API 客户端直接完成任务,链路短,适合个人本地工作。
- With MCP:Agent 请求 Server 声明的
analyze_eda_log工具,Server 校验参数后调用脚本,再把结果包装成 MCP 响应。 - 执行位置:Server 可以自己实现逻辑,也可以代理 CLI、数据库或远程 API;MCP 并不要求计算发生在 Server 进程内部。
- 非 MCP 能力:Agent 仍然可以直接使用内置文件工具、Shell 或其他集成,只有这个 Server 暴露的能力才走这条链。
真正变化的是集成方式,不是软件有没有功能
没有 MCP 时,不同 AI 应用可以各自写适配器,也完全可以直接调用同一 CLI;有了 MCP 后,大家尽量复用同一份能力声明与适配层。标准化减少的是重复接入,而不是替代后端接口。
| 决策维度 | Without MCP:CLI / 脚本 / 专用集成 | With MCP |
|---|---|---|
| 最短调用链 | Agent 直接执行,环节少 | 多一层 Client、Server 与协议处理 |
| 单用户本地开发 | 通常更简单,便于管道组合和临时修改 | 需要维护工具定义与服务生命周期 |
| 多种 AI 应用复用 | 每个应用分别适配,或各自生成命令 | 可复用同一 Server 的能力声明与实现 |
| 非终端用户使用 | 需要额外界面或封装 | 可由支持 MCP 的桌面或 Web Host 接入 |
| 团队权限与审计 | 分散在脚本、账号和各应用里 | 可在 Server 与后端集中实施,但并非协议自动提供 |
| 开放式探索 | Shell、管道和临时脚本更灵活 | 更适合边界明确、可重复的能力 |
| 运维成本 | 没有额外 MCP 服务 | 要处理版本、超时、进程或远程服务可用性 |
判断重点:如果你只有一个人、就在 Linux 终端里工作,现有 CLI 已经很顺,引入 MCP 往往没有收益;如果同一能力要给多个 Agent、多个用户或多个客户端复用,MCP 才开始体现价值。
二、先把四个角色分清:Host、Client、Server、后端
“Claude 直接操作软件”是一种便于理解的说法,但协议上的准确链路是:Host 协调模型与用户交互,Client 维护 MCP 会话,Server 暴露能力,后端完成实际工作。
| 角色 | 负责什么 | 不应该被误解成什么 |
|---|---|---|
| Host | 管理模型、用户界面、上下文和多个 Client,处理用户授权 | 不等同于某一个 MCP 连接 |
| Client | 与某个 Server 初始化、协商能力、收发协议消息 | 不一定独立完成实际业务操作 |
| Server | 暴露 Tools、Resources、Prompts,执行或代理请求 | 不等于背后的数据库、仿真器或整个软件 |
| 实际后端 | 运行脚本、访问数据库、调用仿真器或 SaaS API | 不一定实现 MCP,也不一定知道模型存在 |
按照官方架构,一个 Host 可以管理多个 Client;每个 Client 与特定 Server 保持一个一对一的会话。Server 默认看不到完整对话,也看不到其他 Server,哪些信息进入模型上下文由 Host 协调。
2.1 三种能力原语:不是只有 Tools
| 原语 | 主要用途 | 典型例子 | 通常由谁控制使用 |
|---|---|---|---|
| Tools | 查询或执行一个明确动作,可能改变系统状态 | analyze_eda_log、create_issue | 模型在 Host 提供的机制下选择调用 |
| Resources | 按 URI 提供可读取的数据与上下文 | 设计规范、报告、数据库 Schema | 应用或用户选择读取 |
| Prompts | 提供可复用的提示模板 | 标准代码审查、仿真失败分析流程 | 用户显式选择 |
Tool 的 description 和 inputSchema 是能力说明书:前者说明何时使用,后者约束参数。Schema 能减少传参错误,但不能代替 Server 端校验,更不能把任意 SQL、任意命令变成安全操作。
2.2 消息与传输:协议只规定其中一层
MCP 使用 JSON-RPC 2.0 表达请求、响应和通知。以官方 2025-06-18 版本为准,标准传输是以下两种:
| 传输 | 工作方式 | 适用场景 |
|---|---|---|
| stdio | Client 启动 Server 子进程,通过标准输入输出交换消息;日志走 stderr | 本地脚本、文件、代码索引、个人开发环境 |
| Streamable HTTP | Client 连接独立服务的 MCP Endpoint;服务器可按需用 SSE 流式发送消息 | 团队共享服务、远程系统、集中部署 |
早期 HTTP+SSE 是旧版独立传输,不应与 Streamable HTTP 混为一谈;WebSocket 可以实现为自定义传输,但不是该版本规定的两种标准传输之一。
下面的请求展示了 Client 如何调用 Server 已声明的工具:
{
  "jsonrpc": "2.0",
  "id": 2,
  "method": "tools/call",
  "params": {
    "name": "analyze_eda_log",
    "arguments": {
      "run_id": "sim-20261112-01",
      "max_errors": 5
    }
  }
}
Server 返回的内容既可以是文本,也可以按声明返回结构化结果。模型拿到的是这次工具调用的结果,而不是直接获得整个日志目录或完整对话。
| 消息类型 | 有 id ? | 需要响应? | 用途 |
|---|---|---|---|
| Request | ✅ | ✅ | 客户端发起调用,服务器必须响应 |
| Response | ✅ | — | 服务器对 Request 的应答 |
| Notification | ❌ | ❌ | 单向通知,无需响应 |
| Error | ✅ | — | 处理失败的响应 |
三、一次调用的完整时序:模型不直接执行 Server 里的函数
仍用 EDA 日志分析举例。初始化与能力发现先建立可用边界,用户提问后才发生工具选择与执行。
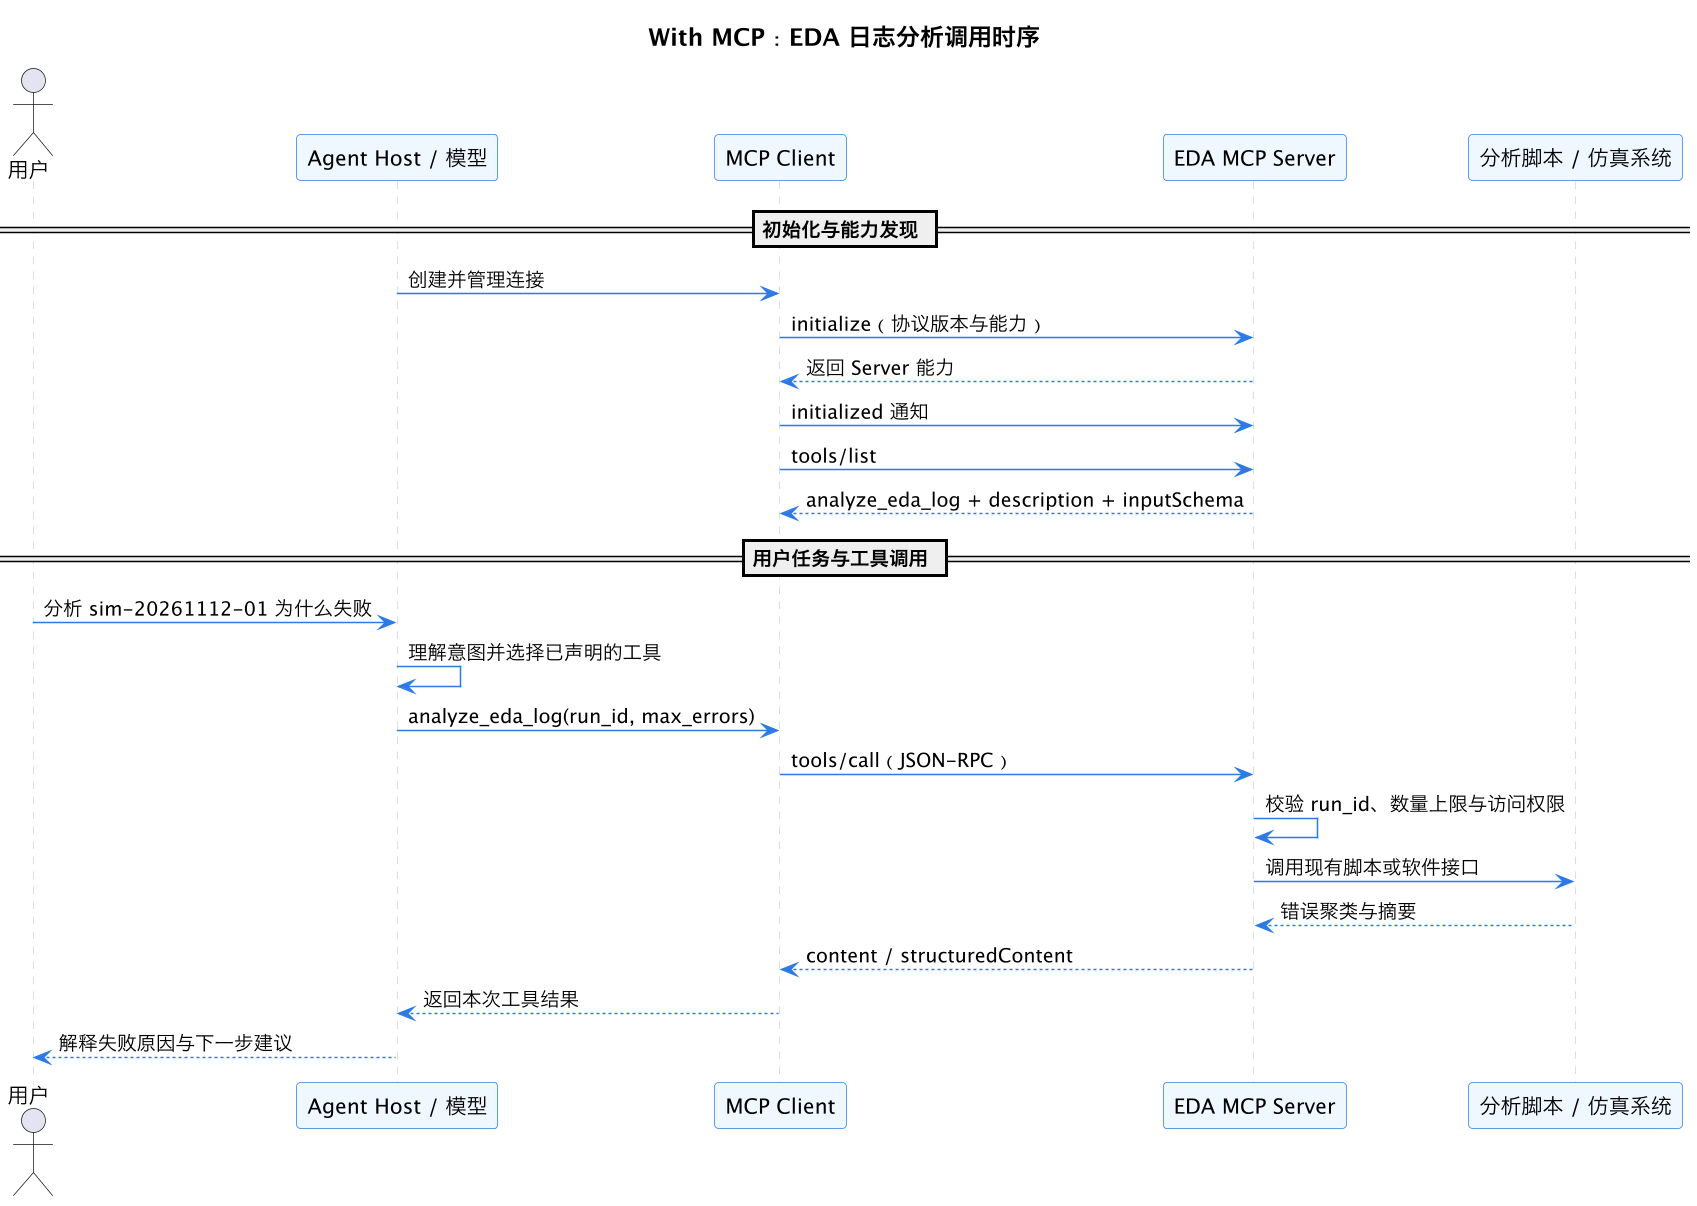
这张序列图有四个关键点:
- 发现不等于执行:
tools/list只返回能力说明,真正执行使用tools/call。 - 模型选择,Client 发请求:模型并不直接打开 Server 进程或调用其内部函数。
- Server 是执行入口,不一定是实际执行者:脚本、仿真器、数据库或远程 API 都可以位于它后面。
- 权限必须是硬约束:参数范围、目录、账号权限和超时由 Server 与后端实施,敏感操作还应由 Host 提供用户确认。
| 阶段 | 代表方法 | 结果 |
|---|---|---|
| 初始化 | initialize、initialized | 协商协议版本和双方能力 |
| 能力发现 | tools/list、resources/list、prompts/list | Client 获得可调用的能力说明 |
| 实际使用 | tools/call、resources/read、prompts/get | Server 或后端执行并返回结果 |
| 列表变化 | notifications/tools/list_changed | 声明支持时通知 Client 重新发现工具 |
四、MCP、CLI、普通 API、Function Calling 不是同一层竞争
这几种方式经常一起出现,但它们解决的问题不同。选型时先问“谁调用谁、要不要跨应用复用”,不要只比较工具数量。
| 方式 | 核心作用 | 最适合的场景 | 主要代价或边界 |
|---|---|---|---|
| CLI / 脚本 | 让 Agent 在本机执行命令并读取输出 | 单用户、本地开发、开放式探索、频繁组合命令 | 依赖本机环境;跨桌面客户端和团队复用较弱 |
| 普通 REST/RPC API | 为程序提供稳定的业务接口 | 确定性系统集成、单应用调用、已有后端服务 | 不包含面向 Agent 的统一能力发现与交互约定 |
| Function Calling | 模型按宿主应用给出的 Schema 选择函数并生成参数 | 一个应用内部的模型工具调用 | 函数如何执行、权限如何实现仍由宿主决定;不是跨应用连接协议 |
| MCP | 标准化 Host/Client 与外部能力 Server 的发现、调用和上下文交换 | 多客户端复用、共享工具服务、标准化连接外部系统 | 增加协议、工具设计、版本和运维成本 |
Function Calling 与 MCP 可以同时存在:Host 可以把 MCP 工具转换成模型可用的函数定义,模型生成调用参数后,再由 MCP Client 发出 tools/call。所以“用了 Function Calling 就不需要 MCP”或“MCP 取代 Function Calling”都不准确。
普通 API 也不会因为 MCP 出现而消失。很多 MCP Server 背后仍然调用 REST API;区别是 API 面向业务程序,MCP 在其上补充面向 AI Host 的能力描述与标准会话。
五、应用场景:什么时候值得做 MCP Server
5.1 值得优先考虑的五类场景
| 场景 | 具体需求 | MCP 带来的实际价值 |
|---|---|---|
| 跨客户端复用 | 同一套 EDA 分析能力要同时给桌面助手、编码工具和自有 Agent 使用 | 复用能力说明、参数约定与适配实现,减少重复接入 |
| 团队共享系统 | 多人查询内部工单、文档、指标或只读数据库 | 通过远程 Server 集中维护连接、凭据、权限和审计 |
| 非终端用户 | 不熟悉命令行的人也要在图形界面中调用专业能力 | Host 提供对话与确认界面,Server 屏蔽脚本细节 |
| 收窄高风险能力 | 只允许查询指定日志或申请预发部署,不开放任意 Shell/SQL | 用少量明确 Tool 和 Schema 形成可评审、可测试的入口 |
| 第三方工具生态 | 把软件能力提供给不同 AI Host,而非只服务一个插件 | 用公开协议降低逐客户端开发连接器的成本 |
这些收益都有前提:客户端确实支持你使用的能力和传输,Server 的工具边界设计合理,团队也愿意长期维护它。协议兼容不代表不同客户端的 Resources、Prompts、授权和交互体验完全一致。
5.2 暂时不值得引入的场景
- 单用户、本地 Linux CLI:Agent 已能执行命令,增加 Server 只会拉长链路。
- 一次性或低频任务:手写一条命令或一个小脚本比长期维护服务便宜。
- 高度开放的探索任务:需要不断组合
grep、awk、管道和临时脚本时,固定工具界面反而限制发挥。 - 只有一个应用调用已有 API:没有跨客户端需求时,直接使用现有客户端库通常更直接。
- 只是想“支持 MCP”:没有明确用户、能力和权限边界时,先不要做。
5.3 一个可执行的决策顺序
以 EDA 日志分析为例,合理演进通常是:先让 Agent 直接调用脚本;当多个客户端都需要同一能力时,封装只读 analyze_eda_log;当团队需要共享服务时,再部署远程 Server 并增加身份鉴别、限流和审计。不要反过来先搭平台,再寻找用途。
六、成本与安全:两个不能被口号带过的边界
6.1 工具描述与上下文成本不是固定倍数
MCP 的 tools/list 返回工具名称、描述和 Schema,但协议没有规定 Host 必须把所有内容永久放进模型上下文。实际如何注入、筛选、延迟加载或缓存由 Host 实现。工具过多确实可能增加上下文占用和选择混淆,但具体成本取决于客户端、工具数量、描述长度和任务。
因此,不能笼统宣称“MCP 成本一定是 CLI 的数十倍”。公平比较应在同一模型、同一任务和同一后端下测量:
| 指标 | 应该记录什么 |
|---|---|
| 模型成本 | 输入/输出 Token、工具描述是否注入、是否发生重试 |
| 时间成本 | 连接初始化、工具调用、后端执行和模型推理分别耗时 |
| 任务质量 | 成功率、参数错误率、是否需要人工纠正 |
| 维护成本 | 配置、版本升级、故障排查和权限管理投入 |
6.2 MCP 不等于自动拥有企业安全治理
协议提供连接与能力协商,不会自动解决多租户、数据脱敏或业务授权。安全需要 Host、Server 和后端共同完成:
- Host:清楚展示工具与参数,敏感操作让用户确认,控制哪些工具进入会话。
- Server:再次校验输入与权限,限制目录、行数、超时和资源范围,记录必要审计。
- 后端:使用最小权限账号,实施真实业务授权,不能因为请求来自 MCP 就跳过检查。
- 结果处理:工具描述和返回内容都可能包含不可信指令,不能把文本内容当成新的系统命令。
- 远程传输:部署 HTTPS、身份验证和网络安全措施;本地 HTTP 服务还要注意绑定地址与 Origin 校验。
第一版优先只读、少工具、小范围。写操作需要单独评审,不应只依赖提示词里的一句“不要误操作”。
七、继续阅读:从选型到落地
| 需求 | 推荐文档 |
|---|---|
| 判断现有 Server 是否值得信任 | MCP Server 选型目录 |
| 在客户端注册本地或远程 Server | MCP 客户端配置 |
| 自己封装一个最小能力 | 写一个最小可运行的 MCP Server |
| 设计内部数据与部署权限 | 自建内部 MCP Server 的边界设计 |
| 看代码结构查询的具体案例 | Claude Code 接 CodeGraph |
协议事实以官方文档为准:
总结
MCP 把外部系统的 Tools、Resources 和 Prompts 以标准方式提供给 AI Host,但它不替代 CLI、普通 API 或 Function Calling,也不要求 Agent 的所有动作都经过 Server。单用户本地命令行通常直接使用 CLI 更轻;当同一能力需要跨客户端、跨用户复用,或需要集中实施权限与审计时,MCP 才有明确价值。理解它最重要的链路是:模型选择能力,Client 发请求,Server 提供执行入口,真正的后端完成工作。