MESI 缓存一致性协议 —— 状态机、总线事务与伪共享
和 NUMA 同属"多核内存子系统"的底层,但层次更低:NUMA 讲内存离哪颗 CPU 近,MESI 讲每颗核的私有缓存里同一份数据怎么保持一致。不懂它,会遇到"多线程各写各的变量、没加锁、却比单线程还慢"的诡异现象——罪魁是伪共享(false sharing)。
本篇是缓存一致性协议族的主文档/导读。前身见 msi;协议机制(四态+状态机+总线事务)见 mesi-protocol;伪共享与观测见 mesi-false-sharing;变种见 mesi-variants(MOESI/MESIF/Dragon 三线合一);横向对比见 comparison。
一句话认知
MESI = 四个状态 + 两套状态机 + 一条总线规则。 多核各自有私有缓存,同一地址有多个副本;MESI 给每条 cache line 标状态(M/E/S/I),靠总线嗅探让各核互相监听,保证"写前独占、读时一致"——所有副本对外看起来像一份。它管的是缓存层一致性,和管"内存离谁近"的 NUMA 是两码事。
四态速览
| 状态 | 全称 | 一句话 | 可否直接写 |
|---|---|---|---|
| M | Modified | 本核改过、内存是旧的,独此一份(脏独占) | 可 |
| E | Exclusive | 只有本核有、未改,与内存一致(干净独占) | 可(无需通知) |
| S | Shared | 多核都有,全是干净只读副本 | 否(要先让别人失效) |
| I | Invalid | 本核这行失效/没有 | — |
核心优化:E 态让"独占干净行"首次写免总线广播直接升 M——这是 MESI 相对 MSI 的全部意义。
把上表的四个状态连成图,就是 MESI 的状态机骨架:本核的读写让状态"往上升"(I→S/E→M),总线上其他核的动作把状态"往下压"(M→S→I)。
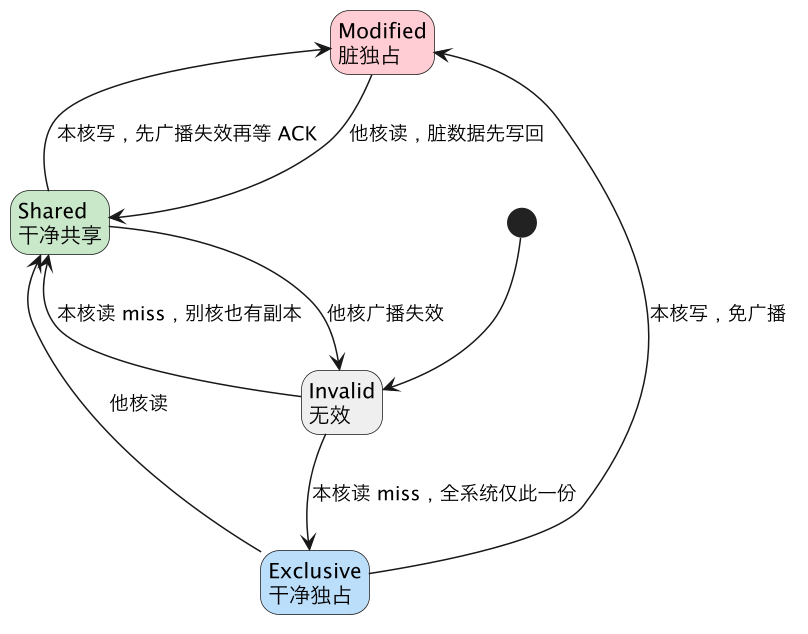
读这张图抓住两条主线就够了:向左走的 I→E→M 是"幸运路径"——全系统只有你一个副本,读不用等别人、写不用发广播,E 态的存在让这条路径上的一次写零总线开销;向右下走的 S→M→S→I 是"拥挤路径"——每次状态跌落都伴随一次总线广播或一次数据写回,跨核争用越厉害,缓存行在这条路径上循环得越频繁,性能也就越差。伪共享本质上就是一条缓存行被两个核反复按在 S→I→S 的循环里摩擦。
两条铁律(整个写失效族都遵守)
不管 MESI 还是 MOESI/MESIF,写失效协议都死守两条铁律:
- 写前必须独占:要写一行,先把它升级到 M(若在 S,先广播让所有其他副本失效并等 ACK)——保证同一时刻只有一份"可写"副本,写传播与写串行化两条一致性底线就此满足。
- 脏数据必须由持有者提供:M 态数据比内存新,别人读它不能直接读内存,必须先让 M 核 Flush(写回内存或直接转发)——否则拿到旧值。
这两条是 MSI 到 MESIF 所有写失效协议共同的骨架;变种只是在"怎么省一次广播、一次写内存、一次抢答"上做文章(见 变种篇)。
把铁律一展开成一次真实的总线事务,就是下面这个握手过程——一个核想把 S 态的行写成 M,必须经历"广播失效 → 等齐 ACK → 才能落笔"的完整回合:
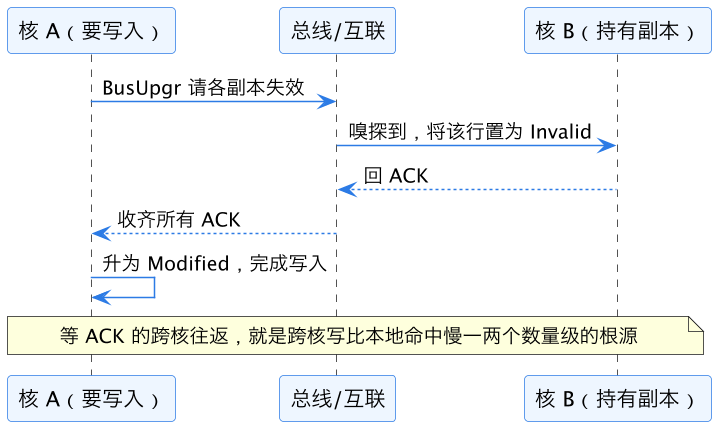
注意核 A 在第①步发出 BusUpgr 之后是停住等的:它必须等所有持有副本的核都确认失效完毕,才能把状态升为 M 并真正写入。这个"写之前先全世界打招呼"的开销是协议正确性的代价,也正是后面 store buffer 和 invalidate queue 两个异步队列想要藏起来的延迟(衔接见 协议机制篇)。
三线速览
① 协议怎么走(机制) —— mesi-protocol:
- 四态详解 + 三条不变式(M/E 独占、写前必独占、M 比内存新)
- 两套状态机:本核读写"往上升"(I→S/E→M)、总线嗅探"往下压"(M→S→I)
- 一次跨核写 =
BusUpgr失效广播 → 等 ACK → Flush → 重载,比命中本地缓存慢一两个数量级 - 与 store buffer / invalidate queue 的衔接:握手"等 ACK"的代价催生了两个异步队列
② 伪共享(头号性能坑) —— mesi-false-sharing:
- 两个核各写各的变量、却落进同一条 64B cache line,互相把对方整行打失效,line 在核间乒乓
- 现象:多线程反而比单线程慢,CPU 忙但没干有用活
- 解法:
alignas(64)/ padding 把热点变量挤出同一行;判定口诀"两个不同变量被争抢 → 对齐就能治"
伪共享的"乒乓"过程用一张图就能看清——两个核写的明明是不同变量,MESI 却以整条缓存行为单位互相失效:
图里最关键的一点是:变量 a 和变量 b 在程序逻辑上毫无关系,没有锁、没有共享读写,但因为它们恰好落在同一条 64 字节的缓存行里,核 0 每写一次 a,核 1 手里的整行(连同 b)就被打失效;核 1 再写 b 时又得把行抢回来。两个核的实际计算量都不大,时间全花在缓存行的"过户手续"上——这就是多线程比单线程还慢的机理。把 a 和 b 用对齐/填充拆到不同行,乒乓立刻停止。
③ 观测(数据来源) —— mesi-false-sharing 第四节:
perf stat看cache-misses高 +IPC低 → 一致性开销信号- Intel 上
perf c2c record/report直接指出哪个 cache line、哪两个变量、被哪些核争抢;HITM就是伪共享指纹
和 NUMA 的关系与区别
| MESI(本篇) | NUMA | |
|---|---|---|
| 层次 | CPU 缓存(cache line,64B) | 主内存(哪个节点的内存条) |
| 解决什么 | 多核缓存副本一致性 | 内存离运行的核有多远 |
| 典型坑 | 伪共享:变量挤在同一 cache line | 远程访问:数据在别的节点内存 |
| 优化 | cache line 对齐/填充 | 绑定进程/内存到同节点(numactl) |
| 观测 | perf stat cache-misses、perf c2c | numastat、numactl -H |
多路 NUMA 机器上两者叠加:跨节点 + 跨核的缓存失效最贵。优化顺序:先用 NUMA 绑定把数据和线程收拢到一个节点,再用 cache line 对齐消除节点内伪共享。
三篇速览
| 文档 | 内容 |
|---|---|
| mesi-protocol | 协议机制:问题根源(多核私有缓存)→ 四态详解 → 处理器侧/总线侧双状态机 → 一次写操作的总线事务时序 → 与 store buffer/invalidate queue 衔接 |
| mesi-false-sharing | 伪共享:原理图 + 机理拆解(64B 粒度误伤)→ 对齐/填充三种解法 → perf c2c 观测 → 对照实验 → 伪共享 vs 原子争用 vs 真共享 |
| (变种族)mesi-variants | MESI 的三条演化路线:O(脏可共享)、F(指定应答)、写更新;横向对比见 comparison |
关系导航
- 问题起点:msi —— 为什么多核非要一致性协议,三态版怎么解决,E 态补了什么(msi 第六节逐拍对比)
- 家族对比:comparison —— MSI→MESI→MOESI/MESIF/Dragon 五协议横比表
- 上层建筑:atomic —— 原子操作 = "缓存锁":先把 line 抢成 Modified 独占再读改写;memory-model —— 缓存一致性之上的内存序
- 物理基础:cache-organization(cache line 元数据含 MESI 状态位)、cache-organization-addressing(Tag+Index 决定两个变量是否同 line)
- 多线程落地:cache-friendly-code(伪共享是编码习惯的一部分)、thread-affinity(绑核避免跨核迁移加剧乒乓)
- 内存序衔接:store-buffer / invalidate-queue(MESI 握手的异步化,一致性之外还有重排)
结合本仓库
cpu_demo 是单线程程序,触发不了伪共享(需多核同时写相邻变量)。仓库已带完整对照实验:
cd demos/false-sharing && make run # 对比 未对齐 vs 对齐 两版耗时(常差数倍)perf stat -e cache-misses,cycles,instructions ./your_mt_app # 先看有无一致性开销
perf c2c record ./your_mt_app && perf c2c report # cache-miss 高就用 c2c 定位⚠️ 平台提醒:
perf c2c和精确的一致性事件需 Linux + 对应 CPU 的 PMU 支持(Intel/AMD 事件名不同),常需 root 或调低kernel.perf_event_paranoid;虚拟机里 PMU 可能被屏蔽。
常见误解
- "伪共享是锁造成的"——不是。伪共享发生时压根没有共享变量,两个线程各写各的私有字段,是 cache line 把它们的地址"绑"在了一起;加不加锁都躲不掉,只跟布局有关。
- "
/proc里能看到 MESI 状态"——不能。四态在硬件里,用户态只能靠 PMU 事件(cache-misses、perf c2c的 HITM)间接推断,这也是为什么 伪共享篇 通篇都在讲观测手段。 - "MESI 管内存序"——两码事。MESI 保证的是 coherence(每个地址最终只有一个最新值),memory ordering 由 store buffer / 失效队列与屏障管,见 memory-model。
FAQ
Q: MESI 是什么? A: MESI 是缓存一致性协议,用 Modified/Exclusive/Shared/Invalid 四个状态标记每个缓存行,通过总线嗅探保证多个 CPU 核的私有缓存副本保持一致。
Q: 为什么需要 MESI? A: 多核 CPU 各自有 L1/L2 私有缓存,同一内存地址可能被多核各缓存一份。没有一致性协议,一个核改了值,其他核仍用旧值,程序会算错。
Q: 伪共享(false sharing)是什么? A: 两个线程修改同一缓存行里的不同变量,本不相干,但 MESI 会让缓存行在两个核间来回失效(写失效),导致性能比单线程还慢。
Q: 伪共享怎么定位? A: perf stat 看 cache-misses 高 + IPC 低;Intel 上用 perf c2c record/report 直接指出 HITM 高的 cache line 和被争抢的变量。
Q: 伪共享怎么避免? A: 让不同线程的变量对齐到不同缓存行:64 字节对齐(alignas(64) / __attribute__((aligned(64))))或按线程拆分结构体。
Q: MESI 和 NUMA 的区别? A: MESI 管 CPU 缓存层(cache line 一致性),NUMA 管主内存层(内存离哪颗 CPU 近);前者典型坑是伪共享,后者是远程访问。
总结
MESI 给每条缓存行打上 Modified/Exclusive/Shared/Invalid 四个状态,靠总线嗅探和"写前独占、脏数据由持有者提供"两条铁律,让多核私有缓存的多个副本对外表现为一份数据:E 态让独占干净行首次写免广播(MESI 相对 MSI 的全部意义),S 态写入则必须先广播失效、等齐 ACK 才能落笔。它最容易被感知的代价是伪共享——两个线程各写同行不同变量、本无共享,却被缓存行绑在一起在核间反复失效,性能比单线程还差;解法只与布局有关:按 64B 对齐填充,用 perf c2c 的 HITM 定位。MESI 管 coherence 不管内存序,别和 store buffer、NUMA 混为一谈。