RSS(Receive Side Scaling)—— 网卡硬件多队列收包与流分发
高并发服务最先撞的瓶颈往往不是应用层——是网卡收包中断把 CPU0 打满。一台 100G 网卡每秒能收几百万包,如果这些包的中断全落在一个核上,这个核的
%soft直冲 100%,其他核围观。RSS 的解法简单粗暴:网卡硬件自己把不同 TCP 流的包分到不同队列,每个队列绑一个独立的中断向量和 CPU 核——在数据进入内核协议栈之前就做好了"负载均衡"。
本篇从硬件机制讲起(哈希算法、间接表、队列分配),深入到配置实践(ethtool 全套命令、中断绑定、哈希字段选择),再到RPS/RFS/XPS/Flow Director 全线对比。RSS 是"接收端缩放"的第一层,是理解 mpstat 里
%soft分布不均、/proc/interrupts里队列中断不平、DPDK 和 io_uring 高性能栈的核心前置知识。
RSS 的硬件基础是网卡多队列 + MSI-X(多中断向量),见 irq-affinity(中断投递机制);RSS 的配置入口在 kernel-tuning-net 第五节(与 RPS/RFS/offload 并列);RSS 的实践场景见
mpstat -P ALL的%soft排查(mpstat)。
〇、为什么需要 RSS:单队列瓶颈
传统单队列网卡
传统网卡只有一个硬件接收队列:
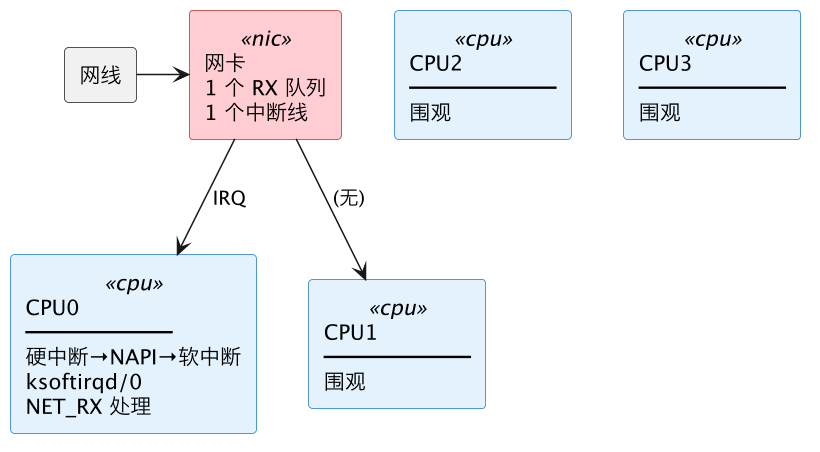
| 问题 | 后果 |
|---|---|
| 中断落在一个核 | 收包硬中断只能投递到一个 CPU |
| NAPI poll 在一个核 | 驱动软中断(NET_RX)只在一个核上跑 |
| ksoftirqd 单核 100% | mpstat 看 CPU0 的 %soft 打满,其他核空闲 |
| 协议栈是单线程 | TCP/IP 处理、数据拷贝全挤一个核,PPS 上限就是单核极限 |
| 锁争用 | 单队列 = 所有 CPU 往同一个环形缓冲区写/读,需要锁 |
量级估算:一个现代 CPU 核(~3GHz)处理软中断的效率约 1~2 Mpps(百万包/秒)。10G 网卡在最小包(64B)线速约 14.88 Mpps——单核根本扛不住,差距一个数量级。
RSS 的思路:硬件做第一层分发
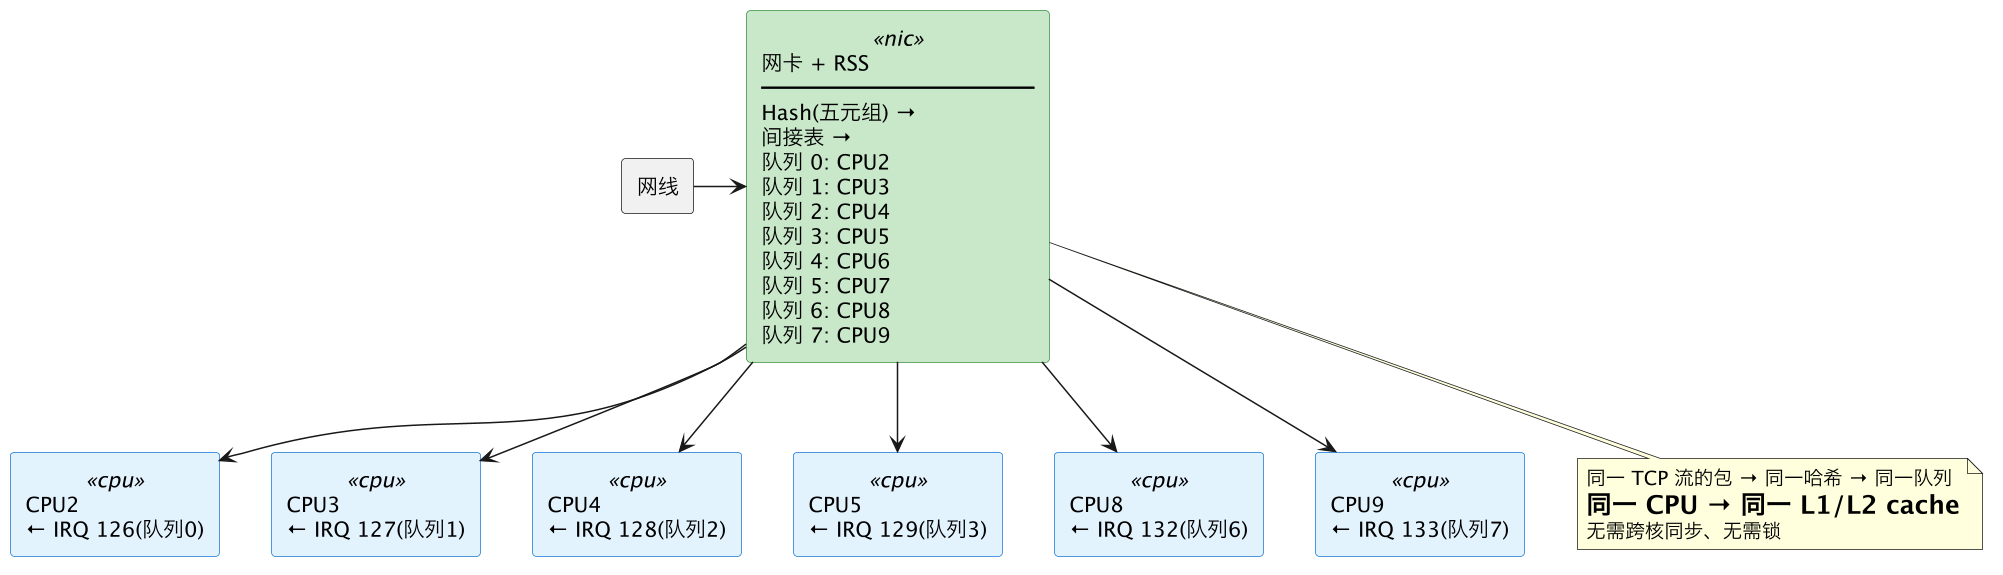
RSS 要解决的三个问题(按重要性排序):
| # | 问题 | RSS 解法 |
|---|---|---|
| 1 | 中断分散:收包中断别全挤一个核 | 每队列独立 MSI-X 向量,绑不同 CPU |
| 2 | 软中断并行:协议栈处理能多核并行 | 每队列的 NAPI poll 在不同核上跑 |
| 3 | 流的亲和性:同一 TCP 流的包始终在同一核 | 哈希保证同五元组→同队列→同 CPU |
RSS 不保证:队列间负载绝对均衡——如果流量集中在少数几条大流(elephant flows),哈希会把这些流全部分到一个队列,那个队列对应的 CPU 仍然可能被打满。这就是为什么还有 Flow Director(见第八节)和 RPS(见第六节)等补充手段。
一、RSS 的硬件工作机制
RSS 是在网卡 ASIC 内部完成的三步流程,全程不消耗 CPU 周期:
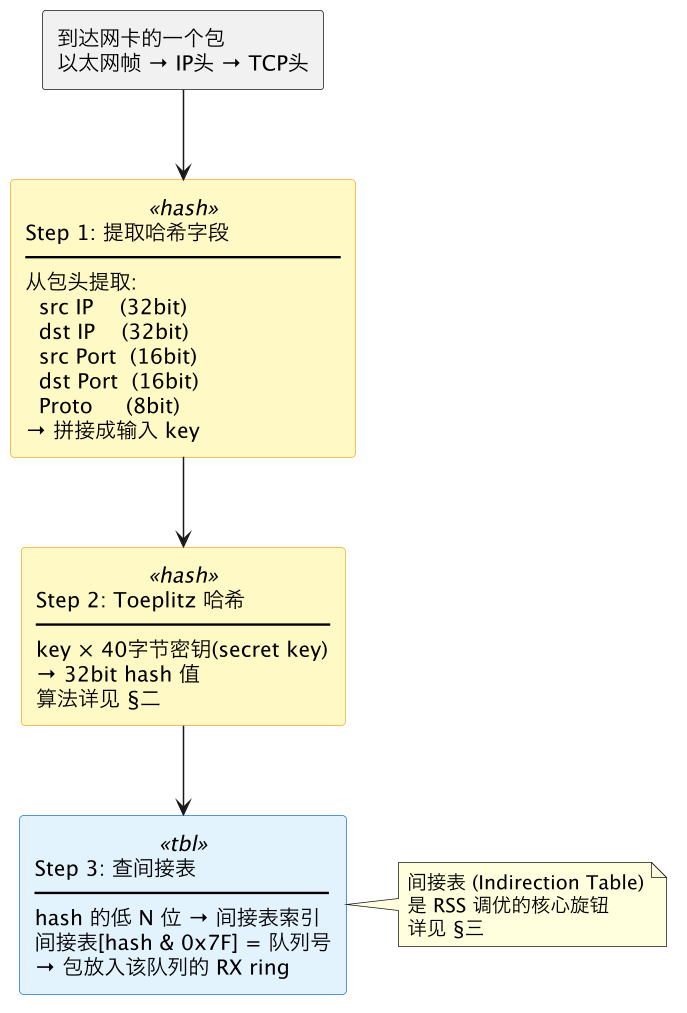
1.1 三个核心组件
| 组件 | 是什么 | 在哪里 | 怎么调 |
|---|---|---|---|
| 哈希密钥 (Secret Key) | 40 字节(320 bit)随机数,用于 Toeplitz 哈希 | 网卡寄存器 | ethtool -X eth0 hkey <hex> |
| 哈希函数 (Toeplitz Hash) | 固定的数学函数:对输入 key 和密钥做逐 bit 运算,产生 32bit hash | 网卡 ASIC 固化逻辑 | 不可改(算法固定) |
| 间接表 (Indirection Table) | 一张 128 条目(或更多)的查找表,每个条目是一个队列号 | 网卡 SRAM | ethtool -X eth0 equal N(均分)/ 自定义权重 |
1.2 数据流:从包到队列的完整路径
收到的以太网帧:
┌─────────┬──────┬─────────┬───────┬───────────┐
│ Eth Hdr │ IP头 │ TCP/UDP │ 数据  │  FCS     │
└─────────┴──────┴─────────┴───────┴───────────┘
                │
                ▼
      提取哈希输入 (key):
      ┌──────────────────────────────────────────┐
      │ src IP (32bit) │ dst IP (32bit) │ 共64bit │  若 IPv6: 256bit
      │ src Port(16bit)│ dst Port(16bit)│ 共32bit │
      │ Protocol (8bit)│                │    8bit │
      └──────────────────────────────────────────┘
                │
                ▼
      Toeplitz Hash(key, secret_key) → 32bit hash
                │
                ▼
      查间接表: table[hash & 0x7F] = 队列号 Q
                │
                ▼
      DMA 把帧描述符写入 队列Q的RX ring
                │
                ▼
网卡触发 MSI-X 向量[Q] → 目标 CPU[Q]关键:哈希输入字段不是写死的——
ethtool -n eth0 rx-flow-hash tcp4 sdfn中sdfn= srcIP + dstIP + srcPort(f= flow = 同流)。你可以选择只用 IP(sd,不区分端口),也可以加端口(sdfn)。决定哪些字段参与哈希直接决定了"同一个哈希值 = 同一个 TCP 流"的粒度。
二、Toeplitz 哈希算法详解
这是 RSS 最核心的数学——它不是普通的 CRC32 或 murmur hash,而是一个比特级卷积,设计目标是:输入 key 的散列性 + 硬件实现简单(只需要 XOR 门阵列)。
2.1 算法定义
输入:
  key[0..N-1]:  从包头提取的 N 位输入(典型 96bit ~ 288bit)
  secret[0..M-1]: 40 字节 = 320 bit 密钥(存在网卡寄存器中)
输出:
  hash[0..31]: 32 bit 哈希值
计算: 对每个输出位 i (0 ≤ i ≤ 31):
  hash[i] = 0
  对 key 的每个位 j:
    如果 key[j] == 1:
hash[i] = hash[i] XOR secret[i + j]直观地说:hash 的第 i 位 = 所有 key 位为 1 的位置对应的密钥位(偏移 i)的异或和。
2.2 具体计算示例(简化版)
为理解方便,假设 key 只有 4 bit,secret 是 7 bit(实际是 320 bit),输出 3 bit:
key     = [k0, k1, k2, k3] = [1, 0, 1, 1]  (源端口 0xB)
secret  = [s0, s1, s2, s3, s4, s5, s6] = [0,1,1,0,1,0,1]
hash[0] = s[0] XOR s[2] XOR s[3] = s0 XOR s2 XOR s3 = 0 XOR 1 XOR 0 = 1
            ↑k0=1     ↑k2=1     ↑k3=1
hash[1] = s[1] XOR s[3] XOR s[4] = s1 XOR s3 XOR s4 = 1 XOR 0 XOR 1 = 0
hash[2] = s[2] XOR s[4] XOR s[5] = s2 XOR s4 XOR s5 = 1 XOR 1 XOR 0 = 0
hash = 1  (b001, 即 hash[2]=0, hash[1]=0, hash[0]=1)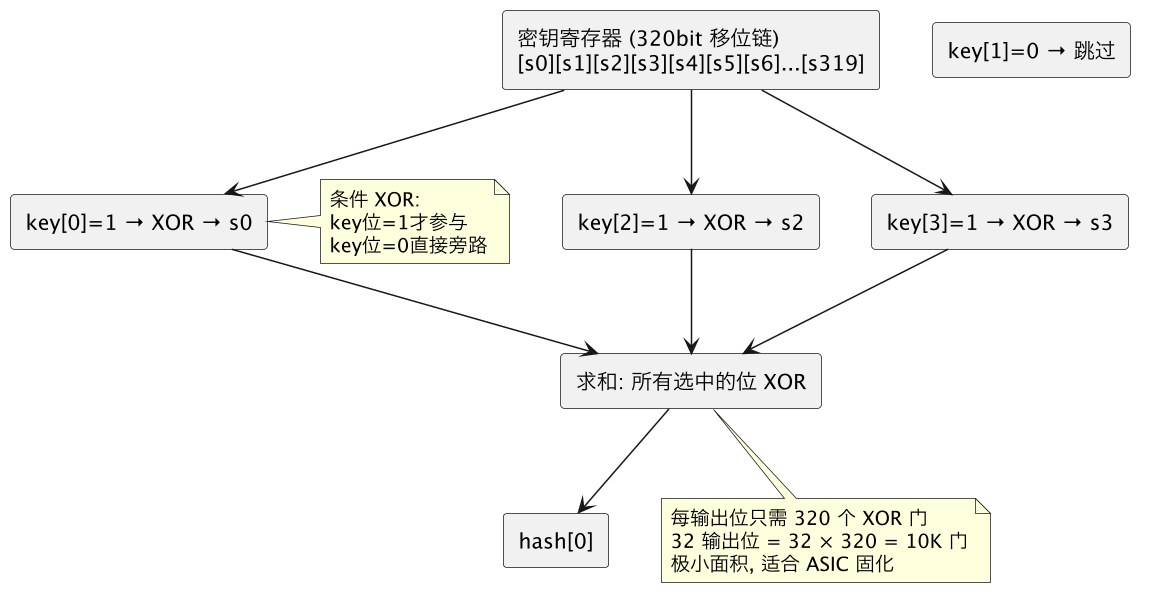
2.3 为什么选 Toeplitz 哈希
| 需求 | Toeplitz 如何满足 |
|---|---|
| 确定性 | 同一 key + 同一 secret → 同一 hash(同流的包必进同队列) |
| 均匀分布 | 随机密钥 + 足够长的 key → hash 在 32bit 空间均匀分布 |
| 硬件友好 | 每个输出位 = 一维 XOR 阵列,无乘法/除法,纯组合逻辑,1 cycle 出结果 |
| 可配置密钥 | 不同机器配不同密钥 = 不同哈希分布(防止对称哈希碰撞) |
| 字段灵活 | 不想区分端口?不填端口到 key 即可——哈希输入是可编程的 |
| IPv4/IPv6 通用 | key 长度可变,IP 包头越长 key 越长,算法不变 |
2.4 Linux 默认 RSS 密钥
Linux 内核为所有支持 RSS 的网卡提供了统一的默认密钥(drivers/net/ethernet/*/ 中定义)。不同驱动可能略有差异,但长度统一为 40 字节。查看当前密钥:
ethtool -x eth0
# 输出示例:
# RSS key:
# 6d:5a:56:da:25:5b:0e:c2:41:67:25:3d:43:a3:8f:b0:d0:ca:2b:cb: ...
# (40 bytes)需要改密钥吗?一般不需要。除非你发现某些流哈希碰撞严重(流量集中在少数队列)而且碰撞是哈希密钥导致的——这种情况极罕见。真正影响均衡的是流量的五元组分布和间接表配置。
三、间接表(Indirection Table)—— RSS 调优的核心
3.1 间接表是什么
间接表是一张索引→队列号的查找表,网卡用 hash 的低 7 位(典型)做索引,查到"包应该进哪个队列"。
间接表示例 (128 条目,8 个队列,默认均分):
  索引:  0   1   2   3   4   5   6   7   8   9   ... 127
  队列:  0   1   2   3   4   5   6   7   0   1   ...   7
         ↑每 8 个一组循环↑
hash = 0xABCD1234
hash & 0x7F = 0x34 = 52
间接表[52] = 队列 4 → 包进队列 4 的 RX ring间接表的价值:
| 能力 | 说明 |
|---|---|
| 权重控制 | 给队列 0 分配更多槽位(如 32 个),队列 1 少一些(8 个)→ 队列 0 收到约 4 倍流量 |
| 队列数与表大小解耦 | 128 条目的表,可以只映射到 4 个队列(或 16 个),表大小 ≥ 队列数即可 |
| 动态重配置 | ethtool -X eth0 equal 8 瞬间生效,无需重启网卡(但会短暂丢包) |
| Flow pinning | 如果只想让 CPU 2 核处理某类流量——把对应哈希槽位全指向 CPU 2 绑定的队列 |
3.2 配置实操
# 1. 查看当前间接表和哈希密钥
ethtool -x eth0
# 输出:
# RX flow hash indirection table for eth0 with 8 RX ring(s):
#    0:  0 1 2 3 4 5 6 7  0 1 2 3 4 5 6 7
#    16: 0 1 2 3 4 5 6 7  0 1 2 3 4 5 6 7
#    ...
#   112: 0 1 2 3 4 5 6 7  0 1 2 3 4 5 6 7
# RSS key: <40 bytes hex>
# 2. 调整队列数(需先 down 网卡)
ip link set eth0 down
ethtool -L eth0 combined 16   # 16 个收发队列
ip link set eth0 up
# 3. 重新均分间接表(128条目均匀分给16队列)
ethtool -X eth0 equal 16
# 4. 自定义权重分配(给队列0分配更多流量)
# 间接表第0~31条目=队列0, 32~47=队列1, 48~63=队列2, 64~127=队列3
ethtool -X eth0 weight 8 4 4 16   # 权重比: 8:4:4:16 → 间接表 32:16:16:64
# 5. 修改哈希密钥(如果需要)
ethtool -X eth0 hkey 6d:5a:56:da:25:5b:0e:c2:41:67:25:3d:43:a3:8f:b0:...
3.3 间接表不平会怎样
# 检查各队列收包是否均匀
ethtool -S eth0 | grep rx_queue_.*_packets
# rx_queue_0_packets: 12345678    ← 远高于其他
# rx_queue_1_packets: 2000
# rx_queue_2_packets: 1500
# rx_queue_3_packets: 1800
# 再看中断分布
cat /proc/interrupts | grep eth0
# 126:  12000000  ...  eth0-0     ← CPU2 的 %soft 100%
# 127: 1500 ... eth0-1 ← 其他核基本空闲这说明间接表配置不当(或者流量分布本身不均——少数大流占绝大多数流量,哈希把它们分到同一队列了)。
四、哈希字段选择:什么字段参与哈希
4.1 可选的哈希字段组合
ethtool -n eth0 rx-flow-hash <protocol> <fields>:
| 协议 | 可选字段 | 含义 |
|---|---|---|
tcp4 | s | 源 IPv4 地址 |
d | 目标 IPv4 地址 | |
f | 源端口 + 目标端口(flow) | |
n | 目标端口(destination port) | |
sd | 源 IP + 目标 IP | |
sdfn | 全部四元组 + 协议号(最常用) | |
udp4 | 同上 | UDP over IPv4 |
tcp6 | s d f n | IPv6 对应字段 |
ah4/esp4 | s d | IPSec |
4.2 不同组合的适用场景
场景 A: 反向代理(nginx/haproxy)
  所有客户端连接 → 同一个目标 IP + 目标端口(nginx的80端口)
  只有 srcIP + srcPort 变化
  → 必须用 sdfn(全部)→ 否则所有包进同一队列
  如果只用 sd(只哈希 src+dst IP):
    所有客户端 IP 不同 → 可以分散 ✓
    同一客户端多连接 → 不同端口 → 但 port 不参与哈希 → 同一连接所有包同队列 ✓
    痛点:同源 IP 的 1000 个连接全在一个核 ✗
场景 B: VPN 网关
  所有流量封装后只有隧道IP → src/dst IP 不变
  → 必须加端口(sdfn)或仅用内层IP(需要硬件支持)
场景 C: 大量短连接 + 客户端 IP 足够多样化
可只用 sd(不哈希端口)→ 减少哈希输入 → 但同IP的连接会串在同一核默认推荐:
ethtool -n eth0 rx-flow-hash tcp4 sdfn—— 四元组 + 协议号全部参与哈希,粒度最细。
五、RSS + 中断亲和性:队列→中断→CPU 的链式绑定
RSS 只负责"包进哪个队列",不负责"队列的中断投递到哪个 CPU"——这部分由 IRQ affinity 控制(见 irq-affinity)。
5.1 完整的三环链
  网卡 RSS 哈希          MSI-X 中断向量        IRQ affinity (smp_affinity)
  ─────────────          ─────────────        ─────────────────────────
  TCP流A → 队列0   →    向量 126         →    CPU 2
  TCP流B → 队列1   →    向量 127         →    CPU 3
  TCP流C → 队列2   →    向量 128         →    CPU 4
  TCP流D → 队列3   →    向量 129         →    CPU 5
  ...                    ...                   ...
为什么这三环要一一对应?
| 如果断在哪一环 | 后果 |
|---|---|
| RSS 没开(单队列) | 所有包进同一队列 → 所有中断同一向量 → 不管 affinity 怎么配,中断都只能投递到一个核 |
| RSS 开了但没配 IRQ affinity | 多个队列的中断全部默认投到 CPU0 → RSS 白开了 |
| RSS + IRQ affinity 都配了但应用线程没绑核 | 软中断在 CPU2 处理完包,唤醒应用线程 → 内核把线程调度到 CPU5 → L1/L2 cache 白热,跨核唤醒开销 |
| 全配了但 irqbalance 在跑 | irqbalance 可能"优化"中断分布 → 把队列0的中断从 CPU2 搬到 CPU7 → 破坏一一对应 |
5.2 完整配置脚本(8 队列网卡,CPU 2~9 处理网络)
# Step 0: 关闭 irqbalance(防止它捣乱)
systemctl stop irqbalance
systemctl disable irqbalance
# Step 1: 设置网卡队列数
ip link set eth0 down
ethtool -L eth0 combined 8
ip link set eth0 up
# Step 2: 均分间接表
ethtool -X eth0 equal 8
# Step 3: 配置哈希字段
ethtool -n eth0 rx-flow-hash tcp4 sdfn
ethtool -n eth0 rx-flow-hash udp4 sdfn
ethtool -n eth0 rx-flow-hash tcp6 sdfn
ethtool -n eth0 rx-flow-hash udp6 sdfn
# Step 4: 查中断号
grep eth0 /proc/interrupts
# 126: ... eth0-0
# 127: ... eth0-1
# 128: ... eth0-2
# ... (共8个)
# Step 5: 绑中断到 CPU 2~9(一一对应)
echo 4    > /proc/irq/126/smp_affinity    # CPU 2 (bit2=1 → 0x04)
echo 8    > /proc/irq/127/smp_affinity    # CPU 3
echo 16   > /proc/irq/128/smp_affinity    # CPU 4
echo 32   > /proc/irq/129/smp_affinity    # CPU 5
echo 64   > /proc/irq/130/smp_affinity    # CPU 6
echo 128  > /proc/irq/131/smp_affinity    # CPU 7
echo 256  > /proc/irq/132/smp_affinity    # CPU 8
echo 512  > /proc/irq/133/smp_affinity    # CPU 9
# 或更友好的方式
echo 2 > /proc/irq/126/smp_affinity_list   # CPU 2
echo 3 > /proc/irq/127/smp_affinity_list   # CPU 3
# ...
# Step 6: 把应用线程也绑到同核(DPDK/io_uring 场景需要)
# 应用线程1: taskset -cp 2  <TID>
# 应用线程2: taskset -cp 3  <TID>
# ...
# Step 7: 验证
cat /proc/interrupts | grep eth0
mpstat -P 2,3,4,5,6,7,8,9 1   # 观察各核 %soft 分布
ethtool -S eth0 | grep rx_queue_.*_packets   # 各队列收包是否均匀
六、RPS / RFS / XPS:RSS 的软件侧补充
RSS 是硬件层做的工作——需要网卡支持多队列 + MSI-X。如果网卡不支持 RSS(嵌入式、虚拟网卡、老旧网卡),或者 RSS 队列数不够用,内核提供了三套软件方案:
6.1 RPS(Receive Packet Steering)
RPS 是"软件版 RSS"——在网卡单队列场景下,驱动收包后、进入协议栈处理前,由软件(内核)做同样的哈希 → 把包分到不同 CPU 的per-CPU backlog 队列中处理:
网卡(单队列) → 驱动收包 → RPS (软件哈希) → CPU0的backlog
                                            → CPU1的backlog
                                            → CPU2的backlog
→ CPU3的backlog配置:
# 允许 CPU 0-7 参与处理 eth0 的收包(每个 CPU 对应掩码的一位)
echo ff > /sys/class/net/eth0/queues/rx-0/rps_cpus  # 单队列网卡
# 或对多队列网卡的每个队列分别配
echo 02 > /sys/class/net/eth0/queues/rx-0/rps_cpus   # 队列0的包分给 CPU1
echo fc > /sys/class/net/eth0/queues/rx-1/rps_cpus   # 队列1的包分给 CPU2~7
6.2 RFS(Receive Flow Steering)
RPS 只管把包分散到多核,不知道应用在哪。RFS 补上这层:维护一张"流→CPU"映射表,让包在目标应用所在的 CPU上处理软中断——最大化 L1/L2 cache 命中:
RPS: 包 → Hash(五元组) → CPU X (纯随机/轮询)
RFS: 包 → Hash(五元组) → Flow→CPU 映射表 → CPU Y (应用线程所在的核)配置:
echo 32768 > /proc/sys/net/core/rps_sock_flow_entries   # 全局流表大小
echo 4096 > /sys/class/net/eth0/queues/rx-0/rps_flow_cnt  # 每队列流的条目数
6.3 XPS(Transmit Packet Steering)
XPS 是发送端的 RSS——把发包任务分散到多核。一个 CPU 核发包时,只往自己"拥有"的 TX 队列写,避免多核抢同一个 TX 队列的锁:
# 让 CPU 0 独占 TX 队列0、CPU1 独占 TX 队列1...
echo 01 > /sys/class/net/eth0/queues/tx-0/xps_cpus   # TX队列0由CPU0管
echo 02 > /sys/class/net/eth0/queues/tx-1/xps_cpus   # TX队列1由CPU1管
6.4 全线对比
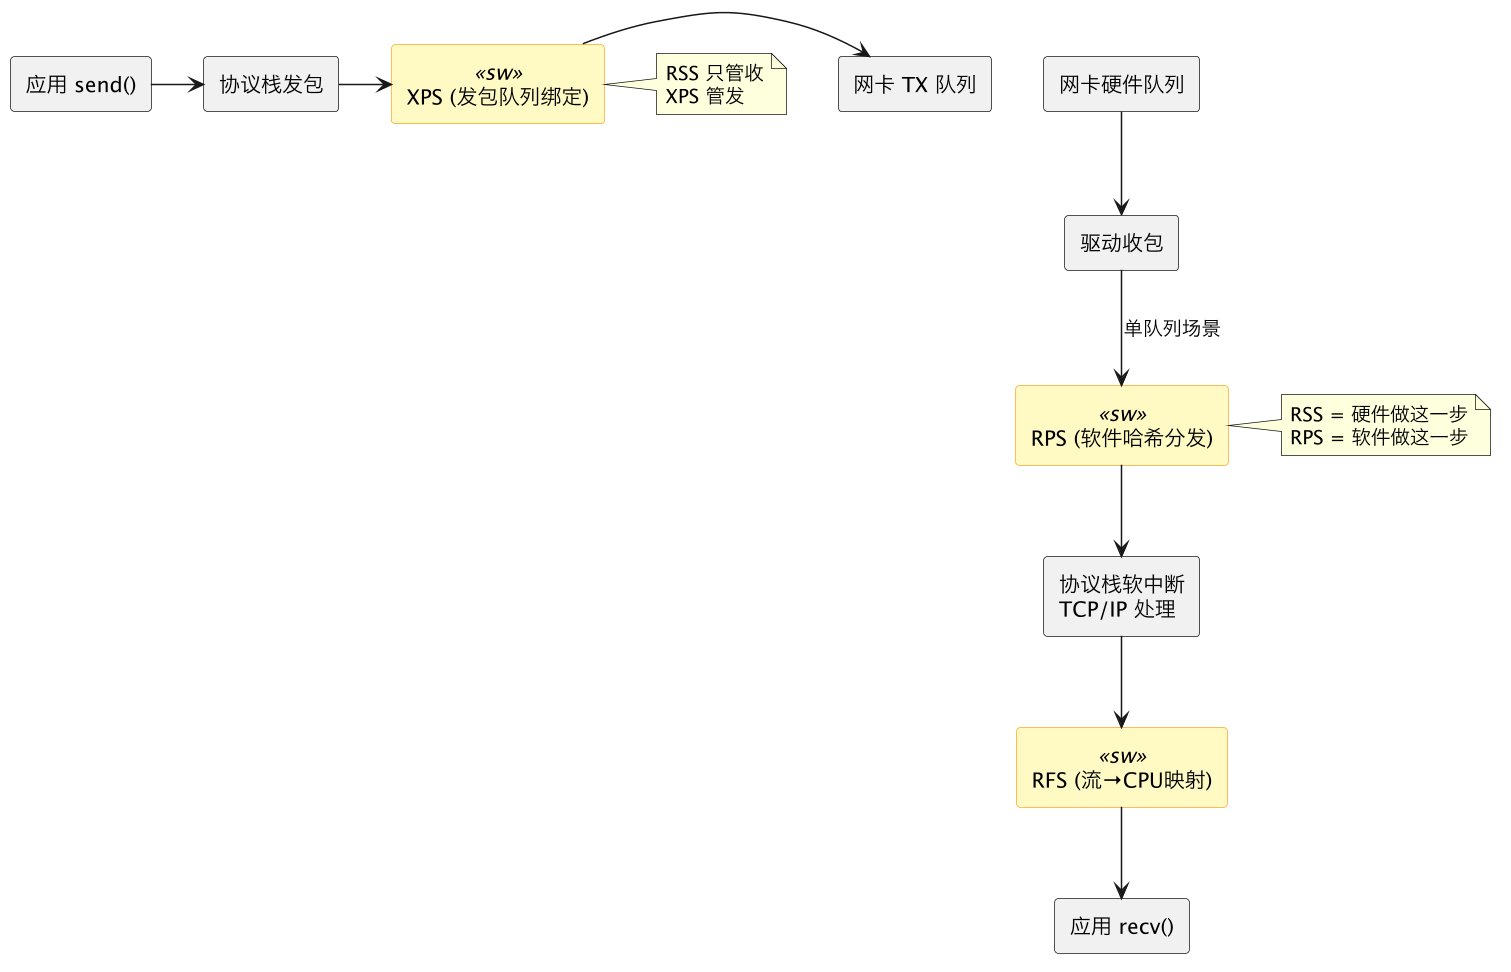
| 技术 | 层次 | 方向 | 做什么 | 需要硬件支持? |
|---|---|---|---|---|
| RSS | 硬件 | 收 | 网卡硬件哈希 → 多队列分流 | 是(多队列 + MSI-X) |
| RPS | 软件 | 收 | 内核软件哈希 → 分散到多核处理软中断 | 否 |
| RFS | 软件 | 收 | 在 RPS 基础上增加流→CPU 映射 | 否(在 RPS 之上) |
| XPS | 软件 | 发 | CPU 独占 TX 队列,避免锁争用 | 是(多 TX 队列,但老网卡也有) |
| Flow Director | 硬件 | 收 | 网卡硬件按精确匹配规则定向到特定队列 | 是(网卡 FDir 模块) |
选型建议:能用 RSS 就用 RSS(零 CPU 开销);网卡不支持 RSS 用 RPS;需要最大化 cache 命中用 RFS(叠加在 RPS/RSS 之上);发包侧用 XPS(多 TX 队列网卡)。
七、Flow Director(FDir)—— RSS 的高级替代
7.1 RSS 的局限:完全靠哈希,不区分流
RSS 的本质是无状态的哈希——不关心这条流是"大流量视频流"还是"心跳包",只要哈希值一样,就进同一队列。痛点:
- 80% 流量集中在一条大流 → 哈希把这 80% 全塞进一个队列 → 那个 CPU 仍然打满
- 一条对延迟敏感的流和一条大容量传输混在同一队列 → 延迟抖动
7.2 Flow Director 的做法
Flow Director 允许配置精确匹配规则 → 指定的流进指定的队列:
# 把 src IP=10.0.0.1 的 TCP 流定向到队列 3
ethtool -N eth0 flow-type tcp4 src-ip 10.0.0.1 action 3
# 把 dst IP=192.168.1.100 的 UDP 流定向到队列 5
ethtool -N eth0 flow-type udp4 dst-ip 192.168.1.100 action 5
# 把来自 10.0.0.1:80 的流定向到队列 7
ethtool -N eth0 flow-type tcp4 src-ip 10.0.0.1 src-port 80 action 7
# 查看已有规则
ethtool -n eth0
# 删除规则(用 rule ID)
ethtool -N eth0 delete 42
7.3 RSS vs Flow Director
| 维度 | RSS | Flow Director |
|---|---|---|
| 分发方式 | 哈希(无状态) | 精确匹配(有状态规则表) |
| 硬件开销 | 极低(固定组合逻辑) | 较高(CAM/TCAM 匹配,有功耗) |
| 规则数量 | 无限制(哈希自动分散) | 有限(8K~32K 条目,网卡型号决定) |
| 粒度 | 粗糙(按哈希槽位) | 精细(精确到五元组甚至应用层字段) |
| 适用场景 | 流量均匀分布 + 大量并发流 | 少数大流 + 需要隔离的流 |
| 配置复杂度 | 低(equal N 一行) | 高(需要先知道哪些流要隔离) |
| 两者能共存 | 可以——未命中 FDir 规则的包 fallback 到 RSS | ✓ |
一句话:RSS 负责"大量流的均匀分散",Flow Director 负责"少数特殊流的精确隔离"——两者互补,不是互斥。
八、观测与诊断
8.1 检查 RSS 是否生效
# 1. 看网卡队列数
ethtool -l eth0
# Pre-set maximums:
# RX:             16
# Current hardware settings:
# RX:             4        ← 当前只有4个队列=只用了4个核!
# 如果 Current < Maximum → 没启用足够队列,调 ethtool -L
# 2. 看间接表是否合理
ethtool -x eth0
# 间接表应该均匀分布到所有队列(默认行为)
# 3. 看各队列收包是否均匀
ethtool -S eth0 | grep -E 'rx_queue_[0-9]+_packets'
# 如果某个队列的包数远超其他 → 流量分布不均 或 间接表权重不对
# 4. 看中断分布
cat /proc/interrupts | grep eth0
# 各队列的中断计数应该大致均匀
# 5. 看软中断分布
mpstat -P ALL 1
# 处理网络的核(CPU2~9)的 %soft 应该接近
8.2 诊断场景
| 症状 | 根因 | 命令 | 修理 |
|---|---|---|---|
%soft 全在 CPU0 | 网卡单队列 / RSS 没开 | ethtool -l eth0 看 Current | ethtool -L eth0 combined N |
队列数 > 1 但 %soft 仍集中在 CPU0 | RSS 开了但 IRQ affinity 没配 | cat /proc/irq/*/smp_affinity_list | 绑中断到不同核 |
| 队列间包数严重不均(某队列 10× 其他) | 哈希碰撞(elephant flow) / 间接表不平 | ethtool -x eth0 | 调间接表权重 / 改用 Flow Director |
| 流乱串核(同一 TCP 流有时在 CPU2 有时在 CPU3) | irqbalance 在跑 / 间接表非对称(RSS 配置被改过) | systemctl status irqbalance | 关 irqbalance / ethtool -X equal N |
| 队列数够了但 PPS 还是上不去 | 中断合并(coalescing)没调 / ring buffer 太小 | ethtool -c eth0 ethtool -g eth0 | 调 ethtool -C / ethtool -G |
8.3 整体性能验证
#!/bin/bash
# RSS 健康检查脚本
echo "=== 队列数量 ==="
ethtool -l eth0 | grep -A1 Current | tail -1
echo "=== 各队列收包数 ==="
ethtool -S eth0 | grep rx_queue_.*_packets
echo "=== 各队列丢包数 ==="
ethtool -S eth0 | grep rx_queue_.*_drops
echo "=== 中断分布 ==="
cat /proc/interrupts | grep eth0 | awk '{print $NF, $1, $2, $3, $4, $5, $6, $7, $8, $9}'
echo "=== RSS 间接表 ==="
ethtool -x eth0 | head -20
echo "=== 软中断负载 ==="
mpstat -P ALL 1 1 | grep -E 'CPU|%soft'
九、RSS 与高性能网络栈的关系
RSS 不仅是"优化"——它是现代高性能网络栈的基石:
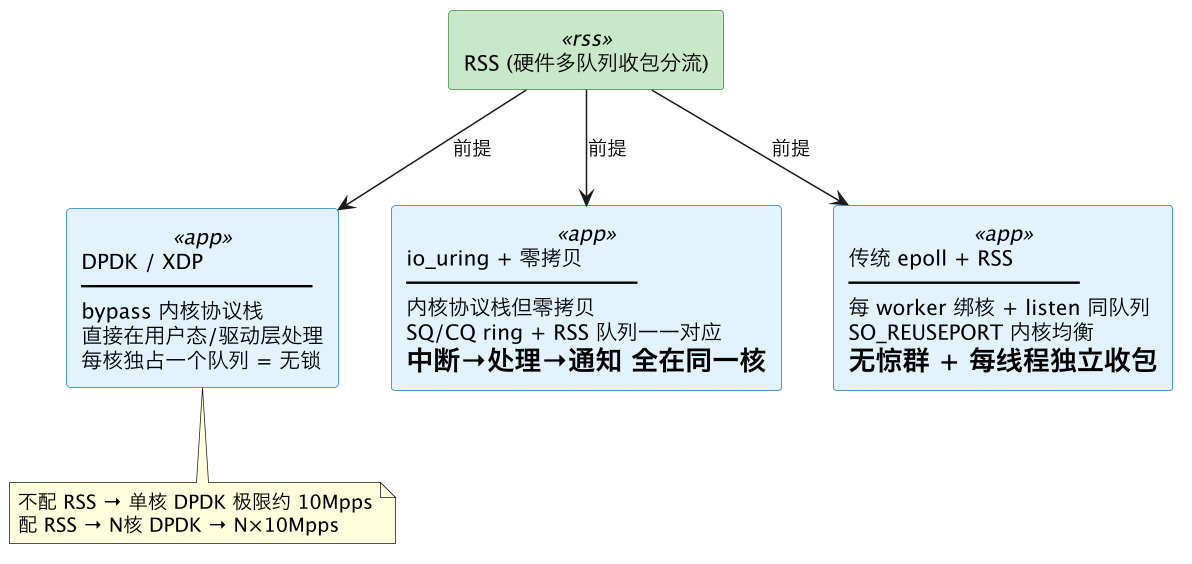
三种模式都依赖 RSS 的同一个承诺:同一个流的包始终在同一个 CPU 核上——这是实现无锁、零 cache miss、零跨核唤醒的前提。
十、一句话总结
RSS 是网卡硬件在收包侧做的第一层"流负载均衡"——用 Toeplitz 哈希(五元组 × 40 字节密钥 → 32bit hash)把不同 TCP 流的包分发到不同硬件队列,每个队列独立的中断向量通过 IRQ affinity 绑定到不同 CPU 核,从而把收包中断、软中断、协议栈处理全部并行化。RSS 管硬件层"包进哪个队列",RPS 管软件层"没有 RSS 时怎么办",RFS 管"让包在应用所在的核上处理",XPS 管发送端的队列绑定——四套协同才是完整的"接收端 + 发送端缩放"。配置核心:
ethtool -L设队列数 →ethtool -X均分间接表 →ethtool -n选哈希字段 →smp_affinity绑中断到不同核 → 关 irqbalance 防止它乱改。