Linux 内核侵入式链表:struct list_head
内核链表不是"链表里装数据",而是"数据里嵌链表节点"。这个翻转是理解所有
list_head用法的起点。
零、一句话认知:侵入式链表
传统链表是"容器模式"——先有 struct node { data; node *next; },数据是节点的一部分。内核链表反过来——节点嵌入在数据里:struct my_struct { int data; struct list_head list; }。
这样做的后果:
- 一个结构体可以同时挂在多条链表上(每条链一个
list_head字段) - 节点只存前后指针,不关心包含它的数据结构是什么
container_of()宏从节点指针反推出包含它的结构体指针
传统链表:                              内核侵入式链表:
┌─────┐    ┌─────┐    ┌─────┐          ┌──────────┐     ┌──────────┐
│node │ → │node │ → │node │          │ my_struct │     │ my_struct │
│data │   │data │   │data │          │  data=1   │     │  data=2   │
│next │   │next │   │next │          │ ┌──────┐  │ →  │ ┌──────┐  │
└─────┘   └─────┘   └─────┘          │ │list  │──┼────│→│list  │──┼→...
                                      │ └──────┘  │ ←──│ └──────┘  │
                                      └──────────┘     └──────────┘
一、核心数据结构
1.1 struct list_head —— 链表节点(嵌入在宿主结构体中)
// include/linux/types.h
struct list_head {
    struct list_head *next;
    struct list_head *prev;
};
节点本身只有两个指针,不包含数据 payload。可嵌入到任意结构体中使用。
1.2 list_head 的两种语义:头 vs 节点
同一个 struct list_head 扮演两种角色,靠用法区分:
| 角色 | 含义 | 初始化方式 |
|---|---|---|
| 链表头 | 不承载数据,next/prev 指向首/尾节点;空链表时指向自身 | LIST_HEAD(name) 或 INIT_LIST_HEAD(&head) |
| 节点 | 嵌入在承载数据的宿主结构体中,是链表上的一个元素 | INIT_LIST_HEAD(&node->list) |
空链表形态:head.next == &head 且 head.prev == &head。这是判断 list_empty() 的根据。
// 定义并初始化一个链表头
static LIST_HEAD(my_list);  // 展开: struct list_head my_list = { &my_list, &my_list }
// 或动态初始化
struct list_head head;
INIT_LIST_HEAD(&head);      // head->next = &head; head->prev = &head;
二、基本操作
2.1 添加
// include/linux/list.h
// 添加到 head 后面(头插法)
void list_add(struct list_head *new, struct list_head *head);
// 添加到 head 前面(尾插法,即加到链表末尾)
void list_add_tail(struct list_head *new, struct list_head *head);
内部实现就是对 prev/next 的四指针调整,等价于:
list_add(new, head):
    new->next = head->next;
    new->prev = head;
    head->next->prev = new;
    head->next = new;
2.2 删除
void list_del(struct list_head *entry);       // 删除节点(不重新初始化)
void list_del_init(struct list_head *entry);  // 删除并 INIT_LIST_HEAD(安全)
list_del 删完后 entry->next / entry->prev 被设为 LIST_POISON1 / LIST_POISON2(调试用毒化指针),防止 use-after-free 时还能遍历。
list_del_init 删完后将 entry 重新初始化为自环(空节点),对 list_empty(entry) 返回 true——常用于"从链表上摘下再挂到别处"的场景。
2.3 移动与拼接
// 将 list 节点从原链表移到 head 后面
void list_move(struct list_head *list, struct list_head *head);
// 将 list 节点从原链表移到 head 前面(移到末尾)
void list_move_tail(struct list_head *list, struct list_head *head);
// 将整个 src 链表(不含 src 头)拼接到 head 后面
void list_splice(const struct list_head *src, struct list_head *head);
// 同 list_splice,但 src 链表头随后被重新初始化
void list_splice_init(struct list_head *src, struct list_head *head);
2.4 判空与替换
int list_empty(const struct list_head *head);          // head->next == head ?
int list_empty_careful(const struct list_head *head);  // 同时检查 next 和 prev
void list_replace(struct list_head *old, struct list_head *new);  // 原子替换
list_empty_careful 在无锁场景下更安全——检查 head->next == head && head->prev == head,但仅在与 list_empty_careful 配对使用时才可靠。
三、遍历 —— 最常用的部分
3.1 遍历节点本身(不常用)
// 从 head 的下一个开始,每次取 pos(struct list_head *)
struct list_head *pos;
list_for_each(pos, head) {
    // pos 指向的是链表节点,不是包含数据的结构体
}
3.2 list_for_each_entry —— 遍历包含数据的结构体(★最常用)
// include/linux/list.h
#define list_for_each_entry(pos, head, member) \
    for (pos = list_first_entry(head, typeof(*pos), member); \
         !list_entry_is_head(pos, head, member);            \
         pos = list_next_entry(pos, member))
参数含义:
pos:循环变量,类型是你嵌入list_head的那个结构体的指针- head:链表头的指针
member:list_head字段在你结构体中的名字
// 示例: 遍历 task_struct 的子进程链表
struct task_struct *child;
list_for_each_entry(child, ¤t->signal->thread_head, thread_group) {
// 这里的 child 已经是 task_struct *,不需要手动 container_of
}3.3 container_of —— 这一切的基础
// include/linux/container_of.h
#define container_of(ptr, type, member) \
    ({ \
        const typeof(((type *)0)->member) *__mptr = (ptr); \
        (type *)((char *)__mptr - offsetof(type, member)); \
    })
给定一个成员的指针 ptr、包含它的结构体类型 type、成员名 member,算出包含它的结构体的地址。核心是 offsetof 获取 member 在 type 中的偏移,再从 ptr 减去这个偏移。
// 示例: 从 list_head 节点反推 task_struct
struct task_struct *task = container_of(node, struct task_struct, thread_group);
为什么需要 char * 转换? 指针运算以指向类型的大小为单位。转为 char * 后偏移就按字节计算——offsetof 返回的正是字节偏移。
3.4 安全遍历 —— 遍历过程中可能删除节点
#define list_for_each_entry_safe(pos, n, head, member) \
    for (pos = list_first_entry(head, typeof(*pos), member), \
         n   = list_next_entry(pos, member);               \
         !list_entry_is_head(pos, head, member);            \
         pos = n, n = list_next_entry(n, member))
多一个 n 参数——预先保存下一个节点指针。删除 pos 后还能继续遍历。普通 list_for_each_entry 删除 pos 后再取 pos->member.next 就是 use-after-free。
struct task_struct *child, *next;
list_for_each_entry_safe(child, next, ¤t->children, sibling) {
if (child->exit_state) {
list_del_init(&child->sibling); // 安全删除
}
}3.5 反向遍历
list_for_each_entry_reverse(pos, head, member);       // 从尾到头
list_for_each_entry_safe_reverse(pos, n, head, member);// 安全反向
四、hlist —— 哈希表优化的变体
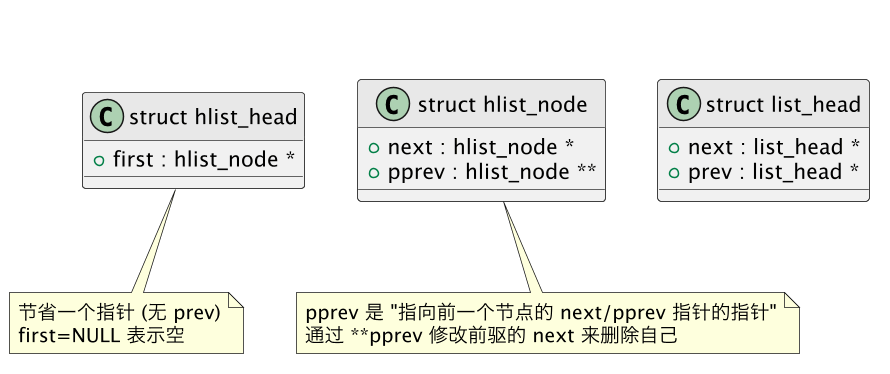
hlist 是 list_head 的变体,为哈希表桶(bucket)做了优化:
hlist_head只有一个first指针(省一半内存——哈希表有大量桶)hlist_node有next和pprev(而非prev)。pprev是 指向前一个节点的 next 指针的指针——这样从 hlist_head 和 hlist_node 删除都能用同一套代码
操作接口与 list_head 平行:
// include/linux/list.h
#define HLIST_HEAD(name) { .first = NULL }
// 遍历
#define hlist_for_each_entry(pos, head, member) ...
// 添加
static inline void hlist_add_head(struct hlist_node *n, struct hlist_head *h);
// 删除 —— hlist_del 不需要知道 head!因为 pprev 直接指向要修改的指针
static inline void hlist_del(struct hlist_node *n);
hlist_del 不需要 head 参数——这正是 pprev 设计的精妙之处:*pprev 就是前驱节点(或 hlist_head)中指向当前节点的指针,直接改它就行。
五、常见模式与陷阱
5.1 一个结构体多条链表
同一个 task_struct 挂在多张链上,每条链一个 list_head 字段:
struct task_struct {
    // ...
    struct list_head tasks;       // 全局 task 链表 (init_task.tasks)
    struct list_head children;    // 子进程链表 (父进程的 children 头)
    struct list_head sibling;     // 兄弟进程链 (挂在父进程 children 上的节点)
    struct list_head thread_group;// 线程组链表
    // ...
};
sibling 既是 children 链表上的节点(被父进程遍历),也是自己的 sibling 节点的容器——"节点"和"头"的语义在这里无缝切换。
5.2 不要在遍历普通版本中删除
// 错误 —— pos 被释放后访问 pos->member.next
list_for_each_entry(pos, head, member) {
    if (should_delete(pos))
        list_del(&pos->member);  // pos 可能已释放!
}
// 正确 —— 用 _safe 版本
list_for_each_entry_safe(pos, n, head, member) {
    if (should_delete(pos))
        list_del(&pos->member);
}
5.3 空链表判断
if (list_empty(&head)) {
    // 链表为空: head->next == &head
}
不要在 RCU 场景用 list_empty 判断空——RCU 遍历通过 list_for_each_entry_rcu 走,删除不立即生效,list_empty 可能看到中间态。
5.4 取首元素
struct my_struct *first = list_first_entry(&head, struct my_struct, list);
struct my_struct *last  = list_last_entry(&head, struct my_struct, list);
// 安全版本——空链表返回 NULL
struct my_struct *first_or_null = list_first_entry_or_null(&head, struct my_struct, list);
六、小结
        list_head 操作速查
        ──────────────────────────────────────────────
        初始化:   LIST_HEAD / INIT_LIST_HEAD
        添加:     list_add / list_add_tail
        删除:     list_del / list_del_init
        移动:     list_move / list_move_tail
        拼接:     list_splice / list_splice_init
        遍历:     list_for_each_entry         ← 最常用
                  list_for_each_entry_safe    ← 遍历中可能删除
        判空:     list_empty / list_empty_careful
        取首:     list_first_entry / list_first_entry_or_null
        取尾:     list_last_entry
        ──────────────────────────────────────────────
hlist: hlist_for_each_entry (哈希桶优化版)核心心法:
- 侵入式设计:数据嵌节点,不是节点装数据。一个结构体可以挂多条链。
container_of:从节点推宿主,整个遍历体系建立在这个宏上。list_for_each_entryvs_safe:只要循环体可能删除,就用_safe版本。- hlist 的
pprev:二级指针让删除不需要知道 head——哈希表桶删除的高效实现。
总结
Linux 内核链表的精髓是「侵入式设计 + container_of」:节点 list_head 嵌在数据结构里(数据嵌节点、而非节点装数据),一个结构体还能挂多条链;遍历靠 container_of 从节点地址反推宿主结构体地址,整个 list_for_each_entry 体系都建立在这个宏上。常用操作就几套——list_add(_tail) 增、list_del(_init) 删、list_splice 拼接、list_empty 判空、list_first/last_entry 取首尾;遍历中若可能删除节点必须用 _safe 版本(先存 next 再回调)。哈希桶用精简版 hlist(pprev 二级指针),让删除节点不必知道桶头,省一半指针开销。