Valgrind 的原理 —— 动态二进制插桩,不用重编译的内存侦探
崩溃/内存排查工具簇的第三位成员。
./asan.md讲编译期插桩的 AddressSanitizer,./tsan.md讲数据竞争检测,本篇讲 Valgrind:一个不需要重新编译、直接把现成二进制"包"起来跑的动态分析框架。它最出名的工具 Memcheck 能抓 ASan 抓不到的使用未初始化内存。 相关文档:../crash/core-dump.md(崩溃后的现场还原)、../cache/cache-organization.md(Cachegrind 缓存模拟的理论基础)、../elf/memory-layout.md(堆/栈/redzone 的地址布局)。
一、Valgrind 是什么,和 sanitizer 的根本区别
Valgrind 是一个动态二进制插桩(DBI, Dynamic Binary Instrumentation) 框架。它的工作方式和 sanitizer 完全相反:
- ASan/TSan:是编译期插桩。编译器在生成机器码时就把检测逻辑织进你的代码里,所以必须重新编译(加
-fsanitize=address等),换句话说要能拿到源码、能改编译流程。 - Valgrind:是运行期(动态)插桩。它直接接管一个已经编译好的二进制,在运行时逐条翻译、插入检测代码。不用重新编译——哪怕只有一个二进制、没有源码,也能跑(但带
-g符号能让报告显示到源码行号,体验好得多)。
这就是二者的根本分界线:
| 何时插桩 | 需要重编译吗 | 需要源码吗 | |
|---|---|---|---|
| ASan/TSan | 编译期(编译器织入) | 必须 | 通常需要 |
| Valgrind | 运行期(翻译机器码时织入) | 不需要 | 不需要(有更好) |
Valgrind 是一个工具框架,上面挂着多个工具,最常用的是 Memcheck(内存错误检测,默认工具),其他还有 Helgrind/DRD、Cachegrind、Callgrind、Massif(见第六节)。
一句话:Valgrind 靠"运行时重写机器码"实现检测,所以不用重编译;这是它和"编译期插桩"的 sanitizer 的本质区别。
二、核心原理:动态二进制翻译 + VEX IR
这是理解 Valgrind 的关键,也是它"为什么不用重编译"和"为什么慢"两个特点的共同来源。
Valgrind 并不直接运行你的程序,而是把你的程序当成"数据"来处理:它按基本块(basic block) 取出一段机器码,翻译成一种与机器无关的中间表示 VEX IR,让工具(如 Memcheck)在 IR 上插入检测桩,再把带桩的 IR JIT 编译回机器码,最后放到 Valgrind 的合成 CPU(synthetic CPU) 上执行。
也就是说:你程序的每一条指令,都跑在 Valgrind 的模拟之上,而不是裸跑在真实 CPU 上。
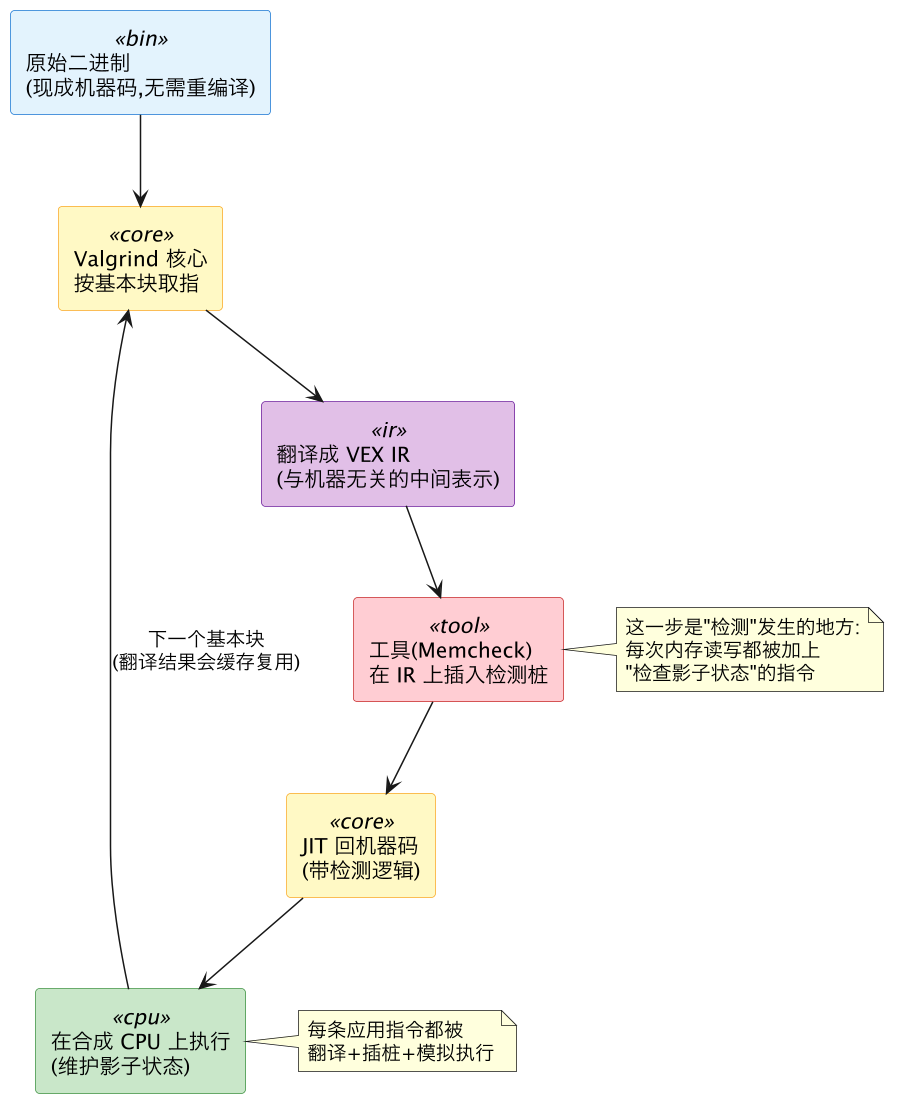
从这张图能同时读出 Valgrind 的两个核心特性:
- 为什么不用重编译:它直接对机器码动手(取指 → 翻译 → 插桩 → JIT),源码和编译器完全不参与。任何现成二进制都能被"套"进这个流程。
- 为什么慢 10–50x:你程序的每一条指令都要经历"翻译成 IR → 插入检测桩 → JIT 回机器码 → 模拟执行",还要在每次内存访问时更新/检查影子状态。相比裸跑,开销是数量级的。这也是它比 ASan(约 2x)慢得多的根本原因——ASan 的检测码是提前编译好的、直接跑在真 CPU 上,而 Valgrind 是在"模拟 CPU"上一条条翻译着跑。
翻译结果会被缓存(translation cache),同一段代码第二次执行时直接复用译码结果,所以循环体不会每轮都重翻,但"模拟执行 + 影子状态维护"的开销始终存在。
一句话:Valgrind 把机器码逐块翻译成 VEX IR、插桩后 JIT 回机器码在合成 CPU 上跑——"操作机器码"让它免于重编译,"每条指令都被模拟"让它慢 10–50 倍。
三、Memcheck 的两套影子状态
Memcheck 之所以能精确抓内存错误,靠的是为应用内存维护两套影子状态(shadow state),以及接管堆分配器。
1. V bits(valid-value bits)——追踪"是否已初始化"
Memcheck 为应用数据的每一位配一个 shadow bit,记录"这一位当前是否持有已定义(已初始化)的值"。
- 变量刚分配、还没写入 → 对应 V bits 标记为"未定义"。
- 一旦被赋值 → 对应 V bits 变为"已定义"。
- V bits 会随数据传播:未初始化的值参与运算、拷贝,结果也被标记为未初始化。
- 只有当一个未初始化的值真正影响了程序的可观测行为(比如作为分支条件、作为
write的数据、作为地址)时,Memcheck 才报错。这避免了大量误报。
这就是 Memcheck 的独门绝技:抓使用未初始化内存——而这正是 ASan 抓不到的(需要另一个工具 MSan)。
2. A bits(addressable bits)——追踪"能否合法访问"
Memcheck 为应用内存的每个字节配一位,记录"这个地址当前是否允许访问"。
- 堆块内合法范围 → 可寻址。
- 堆块前后的 redzone(保护带)、已
free的内存 → 不可寻址。 - 每次内存读写,Memcheck 都检查目标地址的 A bit;访问不可寻址的字节 → 立即报越界或访问已释放内存(UAF)。
3. 接管 malloc/free —— 抓堆错误与泄漏
Memcheck 用自己的实现替换了 malloc/free/new/delete:
- 在每个堆块前后加 redzone,配合 A bits 抓越界读写。
free后不立即归还,而是延迟释放(放进 quarantine 队列) 并把该区间标为不可寻址 → 抓 use-after-free 和 double-free。- 记录每一次分配的调用栈和大小;程序退出时,统计还有多少块没被 free → 报内存泄漏,并按"确定丢失 / 可能丢失 / 仍可达"分类。
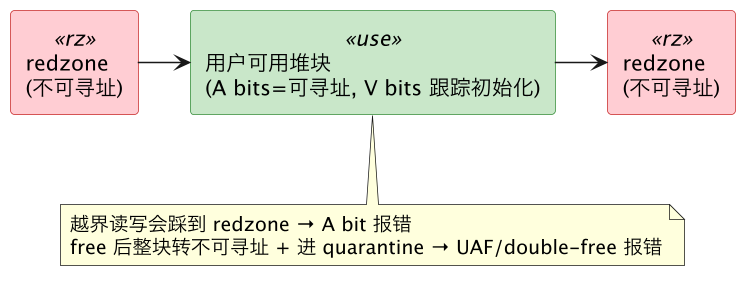
一句话:V bits 逐位追踪"初始化了没"(抓未初始化使用),A bits 逐字节追踪"能不能访问"(抓越界/UAF),再加上接管堆分配器(redzone + 延迟释放 + 退出时统计),Memcheck 就能覆盖几乎所有堆内存错误。
四、Memcheck 能抓什么
| 错误类型 | 靠什么机制抓到 |
|---|---|
| 使用未初始化内存(独门,ASan 抓不到) | V bits 传播,直到影响可观测行为才报 |
| 堆越界读写(heap buffer overflow) | redzone + A bits |
| use-after-free | free 后标不可寻址 + quarantine 延迟释放 |
| double-free | 接管 free,检查块状态 |
| 内存泄漏 | 退出时统计未释放的堆块 |
| 非法 free(free 一个非堆指针/野指针) | 接管 free,校验指针 |
mismatched new/delete(new[] 配 delete) | 接管 new/delete,记录分配方式 |
注意:Memcheck 对栈和全局区的越界检测不如对堆强(它主要围绕堆分配器工作)。这类越界 ASan 反而更擅长——两者互补。
五、核心对比:ASan / TSan / Valgrind(Memcheck)
| 维度 | ASan | TSan | Valgrind(Memcheck) |
|---|---|---|---|
| 是否需要重编译 | 必须(-fsanitize=address) | 必须(-fsanitize=thread) | 不需要(直接跑二进制) |
| 原理 | 编译期插桩 + shadow memory | 编译期插桩 + happens-before | 动态二进制翻译(VEX IR + 合成 CPU) |
| 速度开销 | 约 2x | 约 5–15x | 约 10–50x(最慢) |
| 内存开销 | 中等(shadow 约 1/8 地址空间) | 大 | 大 |
| 越界(堆/栈/全局) | ✔(堆+栈+全局都强) | ✘ | ✔(主要是堆) |
| use-after-free / double-free | ✔ | ✘ | ✔ |
| 数据竞争(data race) | ✘ | ✔(专长) | ✘(用 Helgrind/DRD) |
| 使用未初始化内存 | ✘(要用 MSan) | ✘ | ✔(独门) |
| 内存泄漏 | ✔(自带 LeakSanitizer) | ✘ | ✔(分类更细) |
选型建议
- 能重编、又要快 → 用 ASan(日常首选,越界/UAF/泄漏一把抓,只慢约 2x)。
- 查数据竞争 → 用 TSan(或 Valgrind 的 Helgrind/DRD)。
- 不能重编(只有二进制)/ 要查未初始化内存 / 要最全面地查泄漏 → 用 Valgrind。代价是慢,但覆盖面(尤其"未初始化")最广,且零重编译门槛。
一句话:能重编且要快选 ASan,查竞争选 TSan,不能重编或要抓"未初始化/泄漏"就选 Valgrind——用速度换覆盖面和零编译门槛。
六、Valgrind 家族的其他工具
Valgrind 是框架,换个 --tool= 就换一套分析能力,全都基于第二节的"翻译 + 插桩"引擎:
| 工具 | 作用 | 类比 / 呼应 |
|---|---|---|
| Memcheck(默认) | 内存错误检测 | 本篇主角 |
| Helgrind / DRD | 数据竞争 + 死锁检测 | 类似 ./tsan.md,但动态、不用重编译 |
| Cachegrind | 模拟 CPU 缓存(L1/L2/LL),统计命中/失效、分支预测 | 呼应 ../cache/cache-organization.md 的缓存组织原理 |
| Callgrind | 调用图 + 指令级 profile(Cachegrind 超集) | 配合 KCachegrind 可视化调用关系 |
| Massif | 堆内存 profile,画出堆用量随时间变化 | 找"内存越用越多"的元凶 |
Cachegrind 之所以能"数缓存命中",正是因为程序跑在合成 CPU 上——它可以顺便模拟一套缓存层级,把每次访存映射到 cache line,统计命中与否。理论背景见
../cache/cache-organization.md。
七、用法与观测
# 编译时带 -g,报告才能定位到源码行号(不带也能跑,但只有地址)
g++ -g -O0 main.cpp -o app
# 默认就是 Memcheck;--leak-check=full 打印每处泄漏的详细调用栈
valgrind --leak-check=full ./app
# 常用组合:显示可达内存 + 出错即打印来源栈
valgrind --leak-check=full --show-leak-kinds=all --track-origins=yes ./app
# 换工具:数据竞争 / 缓存模拟 / 堆 profile
valgrind --tool=helgrind ./app
valgrind --tool=cachegrind ./app
valgrind --tool=massif ./app
报告要点:
- Invalid read/write of size N → 越界或 UAF,后面跟出错地址和调用栈。
- Use of uninitialised value → 用了未初始化内存(配
--track-origins=yes能追到"未初始化的源头在哪")。 - definitely lost / indirectly lost / possibly lost / still reachable → 泄漏分类,
definitely lost是必须修的。 - 带
-g时每条都能定位到文件:行号;结合../crash/core-dump.md的读栈方法一起看更顺手。
一句话:valgrind --leak-check=full ./app 直接跑现成二进制就能查内存问题,配 -g 看行号、--track-origins=yes 追未初始化的来源。
八、一句话总结
Valgrind 是动态二进制插桩框架:它把你程序的机器码逐块翻译成 VEX IR、插入检测桩、JIT 回机器码在"合成 CPU"上模拟执行——因此无需重新编译(直接对机器码动手),代价是慢 10–50 倍(每条指令都被翻译+插桩+模拟)。其主力工具 Memcheck 用 V bits(逐位追踪初始化)和 A bits(逐字节追踪可寻址性)加接管 malloc/free,抓越界、UAF、double-free、内存泄漏,尤其能抓 ASan 抓不到的"使用未初始化内存"。选型上:能重编要快用 ASan,查竞争用 TSan,不能重编或要查未初始化/泄漏最全就用 Valgrind。