缓存的组织结构与寻址 —— 物理地址如何定位一条 cache line
本文讲透缓存的单核机制:物理地址怎么拆、怎么判命中,直接映射/全相联/组相联三种结构的原理与取舍,读写流程(逐级下探/write-back),以及时钟域与访问开销。这是理解一致性协议(msi / mesi 等)和伪共享的物理基础;"为什么需要一致性"从 msi 讲起。
破题:缓存到底在解决什么问题
程序访问内存,绝大多数可以归结为一个问题:数据在不在缓存里? 而这个问题的答案,取决于两个硬件事实:
- 数据按物理地址组织——程序用的虚拟地址要先翻译成物理地址,缓存再拿物理地址来查(PIPT)。
- 缓存不"找"数据,而是"算"位置——物理地址拆成 Tag/Index/Offset 三段,Index 直接算出在哪一组(O(1) 译码),Tag 确认是不是目标,命中判定是一套并行硬件电路,一个时钟周期出结果。
围绕这两点,本篇拆成三线展开:寻址与命中(地址怎么拆、怎么判)、映射结构(地址能放哪几个位置、冲突怎么来)、访问流程与开销(数据怎么在各级之间流动、为什么跨核通信这么贵)。
一张 64B cache line 的物理真相
把视角先降到最小单位:一条 cache line = 64 字节 = 16 个 4 字节 int。程序里所谓的"热点变量"从来不是按变量被缓存,而是按整条 line 被搬运——读 int a 时,L1 拿回来的是包含 a 的那 64 字节,邻居 b、c 顺带也进了缓存。
这个事实直接解释了三个反直觉现象:
- 伪共享:两个线程各写各的变量,只要落在同一条 line 上,MESI 状态就共享——一核写,整条 line 的状态变化波及另一核(mesi-false-sharing)。
- 顺序访问快:
arr[i]循环每读一次拉回 64B,等于预取了后面 15 个 int——天然的内存级并行;指针追逐则每条都 miss(data-hazards-l1-miss)。 - 对齐很重要:变量跨 line 边界会被拆成两次访问,读一个
int付两笔开销——这就是编译器对齐 8/16/32 字节的物理原因(memory-alignment)。
带着"64 字节是搬运的最小单位"这个直觉再看下面三条线,缓存就不那么像魔法黑盒了。
三线速览
线一:寻址与命中 —— 物理地址如何找到数据
- 缓存按物理地址组织(PIPT):VA 经 MMU+TLB 翻译成 PA 后再查缓存,避免同一物理页被多个 VA 映射导致的 aliasing。现代 L1 用 VIPT 让 TLB 与缓存并行,但语义等价。
- 地址拆三段:Offset(行内第几字节)、Index(第几组,直接算出)、Tag(确认是不是它)。
- 命中判定是硬件电路不是程序:译码器选组 + W 个比较器并行比 tag + AND/OR/MUX 汇总,一个周期出结果。W 越大比较器越多,这正是相联度不能无限高的物理原因。
- cache 不存完整地址:Index 由"数据落在第几组"隐含表达(免费),只存 Tag——省存储,也解释了为什么相联度越高 tag 越长。
- 每条 line 除 64B 数据还挂一串元数据:Valid、Tag、Dirty、MESI 状态、替换位。
- 配套算例:32KB/8-way/64B → 64 组、Index 6 位、Tag 36 位。
→ 完整展开见 寻址与命中篇
线二:映射结构 —— 一个地址能放哪些位置
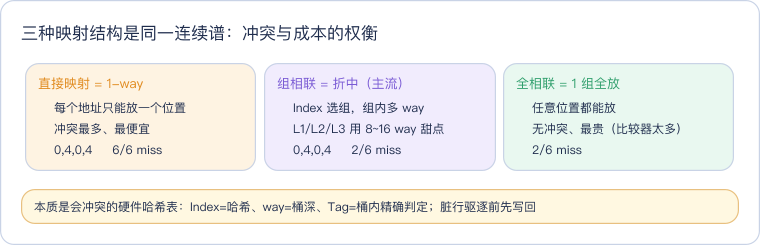
- 三个词:line(格子)、组 set(一行)、way(一列);总容量 = 组数 × way 数 × line 大小。
- 三种结构是同一连续谱的两个极端:直接映射 = 1-way(冲突最多、最便宜);全相联 = 1 组全放(无冲突、最贵);组相联 = 折中(L1/L2/L3 主流,8~16 way 是甜点)。
- 本质是一个会冲突的硬件哈希表:Index 是哈希(会撞桶)、way 是桶深(容纳冲突)、Tag 是桶内精确判定。
- 冲突失效(conflict miss)的经典 demo:
0,4,0,4,...在直接映射上 6/6 miss,2 路组相联与全相联 2/6。 - 组满了踢谁:LRU(实际多用 tree-PLRU 近似)、随机、FIFO;被踢的行若是脏的要先写回。
→ 完整展开见 映射结构篇
线三:访问流程与开销 —— 数据怎么流动、为什么贵
- 容量量级:L1/L2 每核私有(L1d 32~48KB、L2 1~2MB),L3 共享(Intel 105~320MB、AMD 最高 384MB~1.1GB);延迟逐级放大 1ns → 100ns。
- 读靠下探:CPU 只对 L1 发请求,miss 才逐级 L2→L3→内存找,取回后逐级回填;写靠写回:只改 L1 标脏,驱逐或被索要才写回(write-back + write-allocate)。
- 三把"尺子":时钟周期(CPU 的尺)、总线周期(内存的尺,差近百倍)、指令周期(看延迟还是吞吐,没有单一答案)。L1 命中 ~4~5 拍,miss 到底 ~200~300+ 拍。
- 多时钟域:核+L1/L2 一个时钟、L3+互联(uncore)另一个、内存又一个;跨域要同步,带固定开销。
- 一致性通信为什么贵:贵在"离开核心时钟域、走较慢的互联、可能多次往返"——几十到上百拍,这是 store buffer 存在的理由。
→ 完整展开见 访问流程篇
一致性、伪共享与组相联
三层机制如何与缓存组织咬合:
- 一致性状态挂在每条 line 上:多核对同一物理地址(同 Tag+Index)的那条 line,各自维护 MESI 状态(mesi)。
- 伪共享的地址级根源:两个变量只要 Tag+Index 相同(落在同一条 64B line),就共享这条 line 的同一个 MESI 状态——一个核写它,整行状态变化波及另一核。所以规避伪共享 = 让热点变量的地址落到不同 line(cache line 对齐,见 mesi-false-sharing)。
- 组相联也影响伪共享/冲突:即便变量不在同一 line,若大量热点地址 Index 相同、超过组的 way 数,也会冲突失效——高性能代码有时要注意数据的"跨距(stride)"别都撞进同一组。
与共享内存的关系
两个 CPU 核心同时写同一块共享内存——这是 MESI 缓存一致性的"活教材":两个核的 L1d 各缓存了同一物理地址(PFN 相同)的不同副本,一核写就触发 BusRdX 失效另一核的 line,下一核再写又要 RFO 抢回所有权,line 在核间乒乓——这正是共享内存的典型性能陷阱。两套接口选型(POSIX vs System V)和同步方案见 shared-memory。
关系与导航
| 主题 | 文档 | 关系 |
|---|---|---|
| 缓存寻址与命中 | 寻址与命中篇 | 本篇线一,三段拆分 + 命中判定的硬件电路 |
| 三种映射结构 | 映射结构篇 | 本篇线二,冲突失效 + 替换策略 |
| 访问流程与开销 | 访问流程篇 | 本篇线三,逐级下探 + 时钟域 |
| 一致性起点 | msi | "为什么需要一致性"从这篇讲起 |
| 主协议 | mesi | 一致性状态机 + 伪共享,含 perf c2c 观测 |
| 协议家族对比 | comparison | MSI→MESI→MOESI/MESIF/Dragon 横向比 |
| TLB 与地址翻译 | tlb | 缓存的前置一步,改步长暴跌之谜 |
| 编码习惯落地 | cache-friendly-code | 把本页机制变成具体编码习惯 |
| 原子操作底层 | atomic | 总线独占与 lock 前缀 |
| 微架构视角 | data-hazards | L1 miss 是 load→use RAW 延迟的硬件根源 |
相关:缓存访问流程与写回见访问流程篇;时钟域与开销见访问流程篇;Cachegrind 等工具模拟缓存命中的理论基础正是本篇(见 valgrind)。
一句话总结:缓存是数据怎么存的(第一条线),一致性是多个缓存怎么同步的(第二条线)。从缓存组织理解物理存取的机制,从 MSI→MESI→MOESI/MESIF/Dragon 理解多核正确的协议——两者是读懂 perf 缓存事件的基础。