生成 Core Dump 有性能问题吗?—— 开销分析与规避
结论先行:有,而且在生产环境可能很严重。核心不是"写文件慢"这么简单,而是转储期间进程(乃至相关线程)被冻结、大内存进程转储耗时可达数秒到数十秒、以及串行转储 + 磁盘争用带来的雪崩风险。下面拆开分析,并给出量化和规避手段。
一、开销从哪来?先看转储时进程处于什么状态
回顾 core-dump 的产生流程:进程收到致命信号后,内核在终止进程之前把内存镜像写出去。关键事实:
- 转储是同步进行的:内核在信号处理路径里完成 core 写出,期间该进程不再运行(它本来就要死了,所以对"这个进程"不算损失)。
- 但影响不止崩溃进程本身——真正的性能问题在于它对整个系统的连带影响,见下面各点。
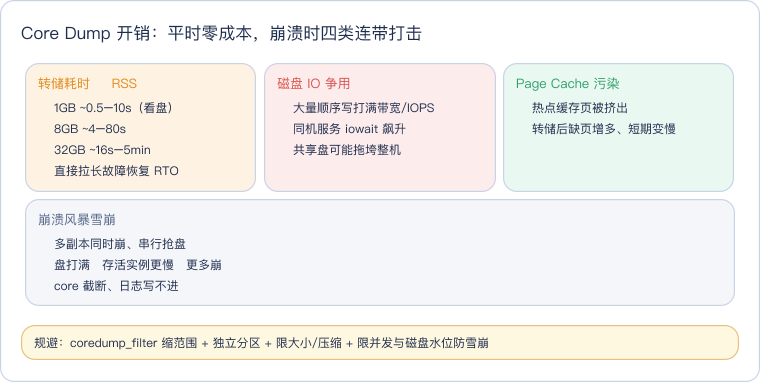
二、四类真实开销
1. 转储耗时 ∝ 进程内存大小(RSS)
core 要把进程的用户态内存镜像(PT_LOAD 段:堆、栈、数据段、部分映射)写到磁盘。进程占多少物理内存,就大致要写多少字节。
粗略量级(机械盘 ~100MB/s、SSD ~500MB/s、NVMe ~2GB/s):
| 进程 RSS | 机械盘 | SATA SSD | NVMe |
|---|---|---|---|
| 1 GB | ~10 秒 | ~2 秒 | ~0.5 秒 |
| 8 GB | ~80 秒 | ~16 秒 | ~4 秒 |
| 32 GB | ~5 分钟 | ~1 分钟 | ~16 秒 |
这就是为什么一个吃了几十 GB 内存的 Java/C++ 大进程崩溃时,"卡很久才真正退出"——它在写 core。对需要快速拉起、快速故障转移的服务,这几十秒的转储时间直接延长了故障恢复窗口(RTO)。
2. 磁盘 IO 争用 —— 对同机其他服务的连带打击
转储瞬间产生大量顺序写,会:
- 打满磁盘带宽/IOPS,挤占同一块盘上其他进程的正常 IO → 其他服务
iowait飙升、变慢(用 iostat 能看到%util打满)。 - 若 core 目录和系统盘/业务数据盘共享 → 可能拖垮整机。
3. Page Cache 污染
写 core 的大量数据会挤占 page cache,把其他进程的热点缓存页挤出去 → 转储结束后一段时间内,其他进程因缓存失效而变慢(缺页增多)。
4. "崩溃风暴"下的雪崩
最危险的场景:某个 bug 导致同一服务的多个进程/多个副本几乎同时崩溃。若每个都转储几 GB:
- 转储彼此串行争抢磁盘,总时间叠加;
- 磁盘被打满 → 拖慢存活的实例 → 更多超时/崩溃 → 更多 core → 正反馈雪崩;
- core 目录被瞬间写满 → 磁盘 100% → 新的 core 截断(truncated)、日志写不进、其他服务报错。
这是生产事故里 core dump "帮倒忙"的典型:本想留证据,结果转储风暴把集群拖垮。
三、平时不崩溃时,开启 core 有开销吗?
几乎没有运行时开销。 只是设置了 ulimit -c / core_pattern / dumpable 标志,进程正常运行期间不受影响——开销只在崩溃转储那一刻发生。所以"开启 core dump 配置"本身是安全的,要控制的是"崩溃时转储的规模和影响"。
一个例外:如果 core_pattern 走管道程序(如 systemd-coredump 或自定义脚本),崩溃时会额外 fork 一个进程来处理,并且管道程序若做压缩/生成 backtrace 会再吃 CPU——但这同样只在崩溃时发生。
四、量化验证(在本仓库/Linux 上实测)
# 造一个占用较大内存的进程,崩溃后测转储时间
# (示意:让进程 malloc 几 GB 再触发段错误,对比 core 大小与耗时)
ulimit -c unlimited
echo '/var/core/core-%e-%p-%t' > /proc/sys/kernel/core_pattern
/usr/bin/time -v ./big_mem_crash        # 看 "Elapsed (wall clock) time" 里包含转储时间
ls -lh /var/core/core-*                 # core 文件大小 ≈ 进程 RSS(受 coredump_filter 影响)
iostat -x 1                             # 崩溃瞬间观察对应盘 %util、w_await 尖峰
对本仓库的 cpu_demo:它内存很小(几 MB),转储瞬间完成,观察不到明显开销——正好说明"开销与内存规模强相关",小进程无需担心,大进程才是重点。
五、规避与优化手段
1. 用 coredump_filter 缩小转储范围(最有效)
不是所有内存都值得转储。/proc/<pid>/coredump_filter 位掩码控制哪些类型的内存段写入 core:
echo 0x7 > /proc/self/coredump_filter # 默认 0x33,改 0x7:只留匿名私有内存(堆栈),排除文件映射/共享段对映射了大量文件/共享内存的进程,能把 core 从几十 GB 降到实际有用的几 GB,转储时间和磁盘压力同比下降。子进程继承该值,可在程序启动时设置。
2. 限制 core 大小上限
ulimit -c 2097152          # 限制 2GB(单位:块,此处约 2GB);超出部分截断
# systemd: LimitCORE + coredump.conf 的 ProcessSizeMax=2G
代价:core 被截断可能影响分析,是"保护系统" vs "证据完整"的权衡。核心大进程可适当放宽,边缘服务收紧。
3. 独立分区 + 独立磁盘
把 /var/core 挂到独立磁盘/分区,让转储 IO 不争抢业务盘和系统盘——这是生产第一原则(见 core-dump 第七节)。
4. 管道转储时直接压缩/限流
echo '|/bin/gzip -c > /var/core/core-%e-%p.gz' > /proc/sys/kernel/core_pattern压缩省 70%+ 磁盘写入量(但 CPU 换 IO);脚本里可 head -c 限流限大小(见 core-dump.md 4.3 脚本)。
5. 只给关键进程开,边缘/敏感服务关
不是所有进程都需要 core。大内存但非关键、或含敏感数据的进程,可单独禁用(ulimit -c 0 或 prctl(PR_SET_DUMPABLE,0)),避免转储开销和数据泄露。
6. 防雪崩:限并发 + 磁盘水位保护
- 管道脚本里加锁,限制同时转储的数量(如
flock),避免崩溃风暴串行打满磁盘。 - 监控 core 目录磁盘水位,接近满时告警/停止转储,保住系统可用性。
六、决策速查
| 你的进程 | 建议 |
|---|---|
| 内存小(几十 MB 内),如工具/agent | 放心全开,开销可忽略 |
| 内存大(GB~几十 GB),核心业务 | 开,但配 coredump_filter=0x7、独立分区、限大小、压缩;接受几秒~几十秒转储时间 |
| 大内存 + 需极快故障转移 | 权衡:可只对少数副本开,或改用崩溃时轻量抓取(minidump/仅栈)方案 |
| 含敏感数据(支付/密钥) | 禁用或加密存储 + 严格权限(安全优先于可调试) |
| 大量副本、易同时崩 | 必须防雪崩:限并发转储 + 磁盘水位保护 + 独立盘 |
七、一句话总结
平时开启 core 零运行时开销;开销集中在崩溃转储那一刻,且与进程内存大小强相关。小进程无感,大进程要靠 coredump_filter 缩范围 + 独立分区 + 限大小/压缩 + 防雪崩 把影响控制住。core 是排查利器,但在生产要"配置好再开",而不是无脑 unlimited。
相关:符号分离(让线上二进制小、又能分析 core)见 symbol-separation;Core Dump 完整机制见 core-dump。