片外总线:从 CPU 到内存、外设和其他 CPU 的通路
CPU 芯片内部再快,最终也要通过片外总线跟内存、外设、其他 CPU 通信。本文把三条最重要的片外大动脉拆开:CPU→内存(IMC/DDR 通道/Rank/Bank)、CPU→外设(PCIe 直连 vs Chipset)、CPU→CPU(UPI/GMI 多路互联)。
关联:cpu-bus-architecture(导读)、core-and-uncore(Uncore/SA 详述)、pcie(PCIe 协议详解)、numa(NUMA 拓扑)
一、CPU 到内存的通路:IMC → DDR
1.1 IMC:从北桥到片上
历史:早年内存控制器在北桥(North Bridge)芯片上——CPU 通过 FSB(前端总线)连到北桥,北桥再连内存。2008 年 Nehalem(Intel)/ 2003 年 K8(AMD)把 IMC 集成进 CPU 芯片,FSB 消失,内存延迟骤降。
老的: CPU ←FSB→ 北桥(IMC) → DDR
新的: CPU(IMC) → DDR (IMC 在 Die 上,直连,延迟低得多)| 集成 IMC 的好处 | 集成 IMC 的挑战 |
|---|---|
| 内存延迟显著降低 | 内存频率/类型与 CPU 绑定 |
| 带宽随通道数线性扩展 | 每代 CPU 需要新的 DDR 控制器 |
| 支持多通道交错 | 信号完整性对封装引脚提出更高要求 |
1.2 DDR 通道、Rank、Bank 层级
IMC Channel 0 ─→ DIMM 0
                 ├─ Rank 0 ─┬─ Bank 0 → 行(rows)×列(columns)
                 │          ├─ Bank 1
                 │          └─ Bank ...
                 └─ Rank 1 (双面/双 Rank)
IMC Channel 1 ─→ DIMM 1 ...| 层级 | 含义 | 并行度 |
|---|---|---|
| Channel | 独立的物理总线(数据+地址+命令),完全并行 | 通道数 × 64bit = 总带宽 |
| Rank | 一组共享数据总线的 DRAM 芯片,同一时刻只有一个 Rank 在总线上传数据 | 交错访问不同 Rank(rank interleaving) |
| Bank | Rank 内部的独立存储阵列,可同时打开不同 Bank 的行 | Bank 级并行:同时激活不同 Bank 的不同行 |
| Row/Column | 一个 Bank 内部按行和列组织,访问先激活行(RAS),再读列(CAS) | 同一 Bank 内的同一个行上的多个列访问可流水;换行需先关闭旧行(precharge) |
1.3 地址映射与交错
现代 IMC 会把物理地址按特定规则分散到不同通道/DIMM/Rank/Bank,目的是最大化并行访问。
典型交错策略(简化的):
物理地址 bits [6]    → Bank 选择  (避免同一 Bank 冲突)
物理地址 bits [x:y]  → Channel 选择 (多通道并行)
物理地址 bits [a:b]  → Rank 选择   (双 Rank 交错)
物理地址 bits [c:d]  → Row 选择
物理地址 bits [e:f]  → Column 选择
内存交错做得好不好,直接决定多线程程序能不能同时从多个通道取数据。如果多个线程都命中同一个 Bank/Row,就会互相阻塞(bank conflict)。
1.4 核心延迟构成
一次内存访问的大致周期(DDR5,现代服务器级别):
总延迟 ≈ IMC 处理 + PHY 传输 + DRAM 自身
DRAM 自身 ≈ tRCD(行激活到列访问) + CL(CAS Latency) + tBurst(数据传输)
          ≈ 14ns + 14ns + ~2ns ≈ 30ns (@DDR5-5600)
加上 IMC 排队、调度、PHY 串化/解串:
Light load: ~70-80ns
Heavy load: ~100-150ns+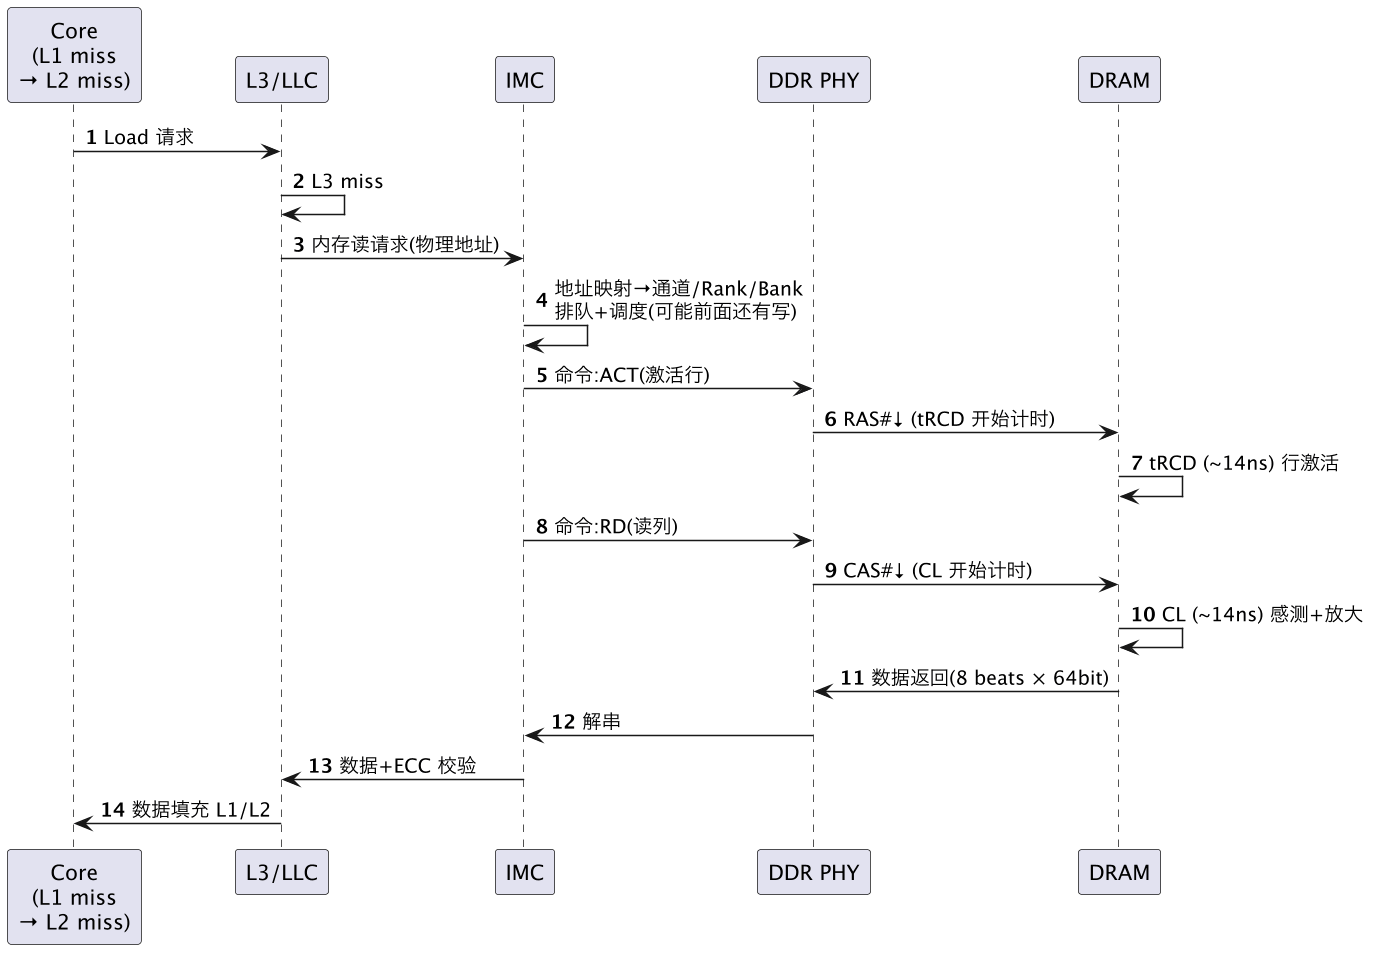
1.5 NUMA 下的本地 vs 远程
参见 numa。简言之:
| 路径 | 延迟量级(典型) |
|---|---|
| L1 命中 | ~4-5 cycles |
| L2 命中 | ~12-14 cycles |
| L3 命中(本地) | ~40-50 cycles |
| 本地 DDR | ~70-100ns (~250-400 cycles @4GHz) |
| 远程 DDR(跨 Socket) | ~140-200ns(多出 UPI/IF 往返) |
远程内存延迟约为本地的 1.5-2 倍。这就是 NUMA 感知编程的物理基础。
二、CPU 到 I/O 的通路:PCIe
2.1 PCIe Root Complex:PCIe 树的根
Root Complex 在 System Agent 内,是 PCIe 协议的 CPU 侧实现。它把 CPU 的内存空间和 PCIe 的地址空间桥接起来。
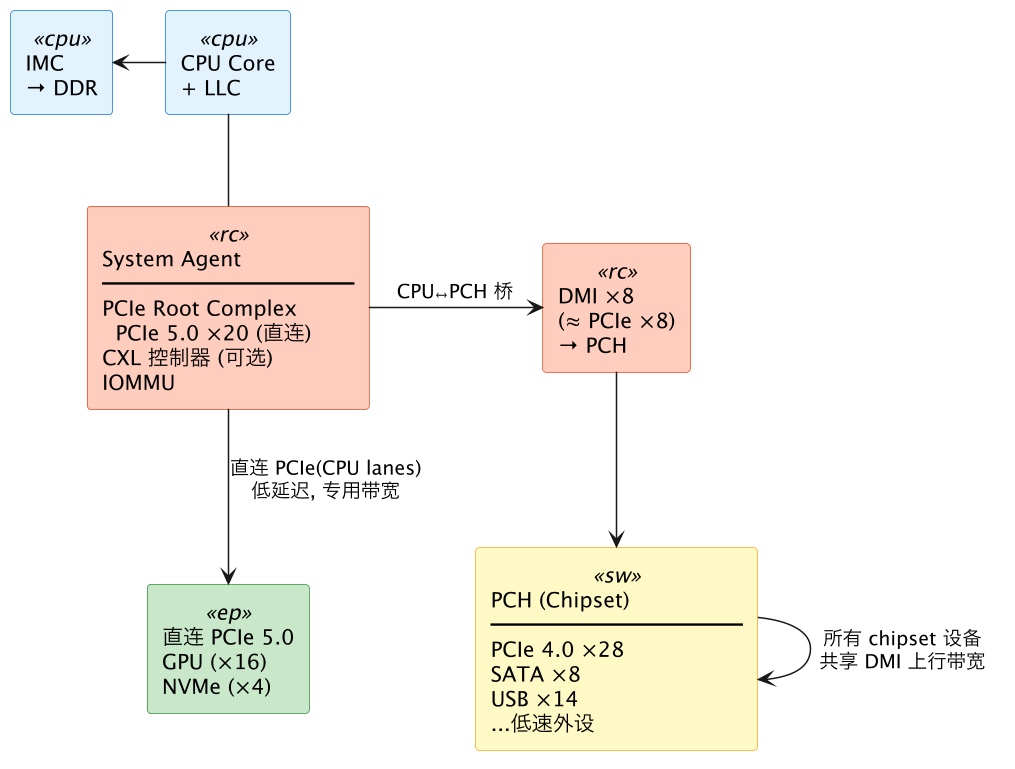
2.2 直连 PCIe vs Chipset PCIe
| 直连 CPU PCIe Lanes | Chipset (PCH) PCIe Lanes | |
|---|---|---|
| 路径 | Core → SA → PCIe PHY → 设备 | Core → SA → DMI → PCH → PCIe → 设备 |
| 延迟 | 更低 | 多出 DMI 往返 |
| 带宽 | 每条 Lane 独享,不和其他设备共享 | 所有 Chipset 设备共享 DMI 上行带宽 |
| 用途 | GPU、NVMe(低延迟、高带宽) | SATA、USB、网卡、声卡 |
| 典型配置 | Intel: CPU 20 lanes (×16 GPU + ×4 NVMe) | PCH: 28 lanes PCIe + 各种低速口 |
| AMD: CPU 28+ lanes (可配 ×16+×4+×4+×4) |
评估:如果你把两块 NVMe SSD 都接到 Chipset 上,两块盘的带宽都会受到 DMI 链路的限制(DMI ×8 ≈ PCIe 4.0 ×8 ≈ 16GB/s)。如果把一块移到直连 CPU lanes,它就独占一个 x4 链路不受 chipset 拥塞影响。
2.3 PCIe 代数与带宽
| PCIe 版本 | 单 Lane 单向带宽 | ×16 单向带宽 | 编码 |
|---|---|---|---|
| 3.0 | ~1GB/s | ~16GB/s | 128b/130b |
| 4.0 | ~2GB/s | ~32GB/s | 128b/130b |
| 5.0 | ~4GB/s | ~64GB/s | 128b/130b |
| 6.0 | ~8GB/s | ~128GB/s | PAM4 |
注意 PCIe 带宽是单向的。DMA 读(设备读内存)和 DMA 写(设备写内存)各占一个方向的带宽。GPU 双向通信时实际可用带宽要减半。
2.4 设备 DMA 的数据通路
参见 dma 和 dma-cpu-interaction。从 CPU 架构视角概览:
设备 → PCIe → Root Complex → IMC → DDR
具体流程:
1. 设备发起 DMA 读/写(通过 PCIe Bus Mastering)
2. PCIe 包到达 Root Complex
3. IOMMU(若启用) 查表翻译 IOVA→物理地址
4. 请求发往 IMC(经过片内互联 Ring/Mesh/IFOP)
5. IMC 调度请求, 访问 DRAM
6. 数据反向流回设备(写) 或 从设备流到内存(读)系统架构视角的关键:DMA 数据流经的核心路径是 PCIe → SA → 片内互联 → IMC → DRAM。这条路径的每一步都在 Uncore 内——完全不需要核心参与(除了设置 DMA 描述符和收中断)。这也是为什么"CPU 使用率不高、但 I/O 延迟大"的原因经常在总线上——PCIe 带宽不够、IMC 被写满、或片内互联拥塞。
三、CPU 到 CPU 的通路:多路互联 UPI / GMI
3.1 Intel UPI (Ultra Path Interconnect)
多路 Xeon 服务器通过 UPI 链路把多个 Socket 连成一个逻辑整体。
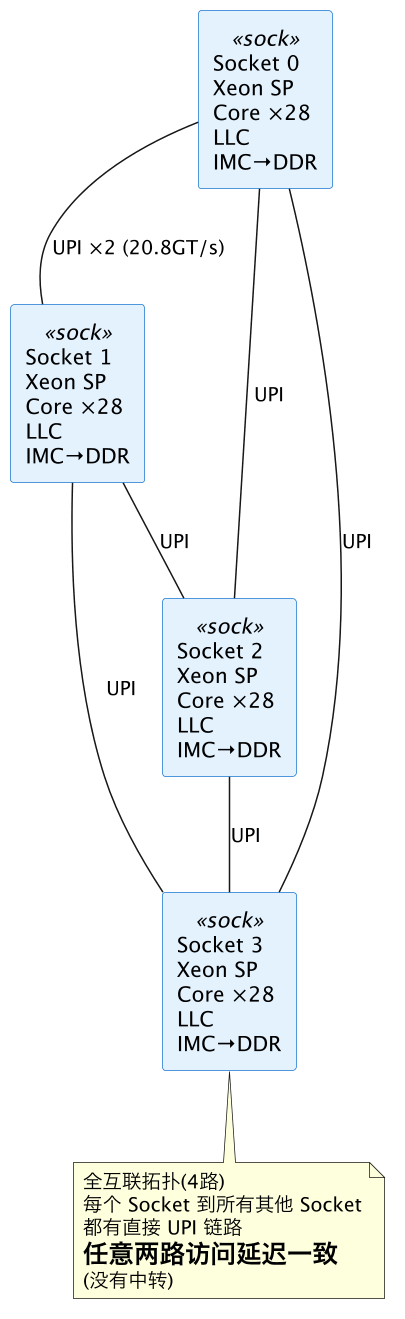
| UPI 特性 | 数值 |
|---|---|
| 单链路带宽 | 10.4 GT/s ~ 20.8 GT/s (UPI 2.0) ≈ 20.8GB/s 单向 |
| 链路数 | 2路系统:2-3 条;4路系统:3 条(全互联);8路系统:拓扑更复杂 |
| 延迟 | ~50-70ns(跨 Socket 访问内存的 UPI 部分延迟) |
| 协议 | 缓存一致性 + 数据传输(类似 QPI 的演进,snoop/directory 两种模式) |
3.2 AMD Infinity Fabric Socket-to-Socket (GMI)
AMD 的双路/多路 EPYC 通过 GMI (Global Memory Interconnect) 链路在 IOD 之间直连。
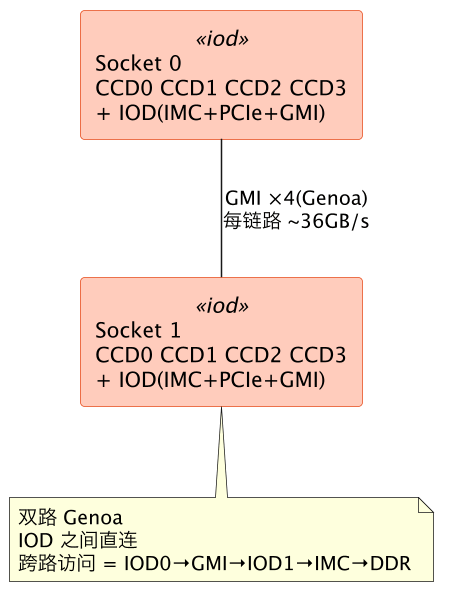
| Intel UPI | AMD GMI (IFIS) | |
|---|---|---|
| 拓扑 | Socket 间直连(全互联) | IOD 间直连 |
| 每条链路带宽 | 20.8 GT/s ≈ 20.8 GB/s | ~32-36 GB/s (Zen 4) |
| 典型链路数(双路) | 2-3 | 4 |
| 延迟增量 | ~50-70ns | ~60-90ns(IOD 中转略多) |
| 缓存一致性 | 支持 snoop + directory | 主要靠 directory(IOD 维护目录) |
3.3 跨 Socket 缓存一致性
核心问题:Socket 0 的核 0 改了某行数据,Socket 1 的核 20 的缓存里也有一份——怎么保证一致性?
方案 A: Snoop Broadcast (广播侦听,小规模)
  Socket0 的 IMC/LLC → UPI 广播 → 所有其他 Socket 查本地 cache
  优点:简单、低延迟(知道谁有就直接 inv)
  缺点:广播量大,不扩展
方案 B: Directory (目录,大规模)
  IOD/IMC 维护一个目录,记录"哪个 Socket 有这个行的缓存副本"
  只发给有副本的 Socket,不广播
  优点:可扩展(目录开销随核心数平缓增长)
  缺点:额外目录存储和查找延迟
现代大核数系统(Xeon SP 4路+、EPYC 双路+)基本都走 Directory 方案。
四、三条通路的对比
| 通路 | 起点 | 终点 | 关键瓶颈 | 性能优化点 |
|---|---|---|---|---|
| CPU→内存 | Core | DDR | IMC 排队、Bank conflict、通道数不足 | 增加通道、NUMA 绑定、避免 bank conflict |
| CPU→外设 | Core | PCIe 设备 | PCIe 带宽、Root Complex 延迟、DMI 共享 | 直连 CPU lanes、升级 PCIe 代数、避免多设备共享 DMI |
| CPU→CPU | Socket | Socket | UPI/GMI 链路带宽、跨 Socket 缓存一致性协议 | 全互联拓扑、NUMA 感知、减少跨 Socket 共享数据 |
五、一句话总结
CPU 芯片外有三条大动脉:到内存的 IMC/DDR 通路决定访存带宽和延迟;到 I/O 的 PCIe 通路决定外设性能,直连 vs Chipset 是第一条分叉;到其他 CPU 的 UPI/GMI 通路决定多路系统的扩展性和 NUMA 惩罚。理解这三条通路的拓扑和瓶颈,才能定位"CPU 不忙但程序慢"的真正原因。
关联:cpu-bus-architecture(导读)、core-and-uncore(Uncore/SA 详述)、on-die-interconnect(片内互联)、pcie(PCIe 协议详解)、numa(NUMA 拓扑)