TLB 与地址翻译 —— 一个"迭代次数不变、只改步长却性能暴跌"的实验
cache-organization 讲缓存怎么按物理地址查,只在开头带过"VA 先经 MMU+TLB 翻译成 PA"。TLB 本身也是一层缓存,它也会 miss,而且 miss 的代价能主导整个程序性能——很多"缓存算不通"的性能悬案,真凶其实是它。
本篇用一个经典实验讲透:同一段循环,迭代次数完全不变,只增大访问步长,性能却在某个点突然暴跌——你以为是 CPU 缓存不够,其实是 TLB 先崩了。 实验出自 Gallery of Processor Cache Effects,代码见 demos/tlb-thrashing/。
一、实验:迭代次数不变,只改步长
const int N = (1 << 13);   // N = 8192,迭代次数固定
int a[D * N];              // 数组大小随步长 D 变
for (int i = 0; i < D * N; i += D)
a[i] += 1; // 每次跳 D 个 int,总共只写 N 次关键:步长 D 变、数组变大,但循环体只执行 N=8192 次——迭代次数恒定。实测(D 从 16 增到 1024):
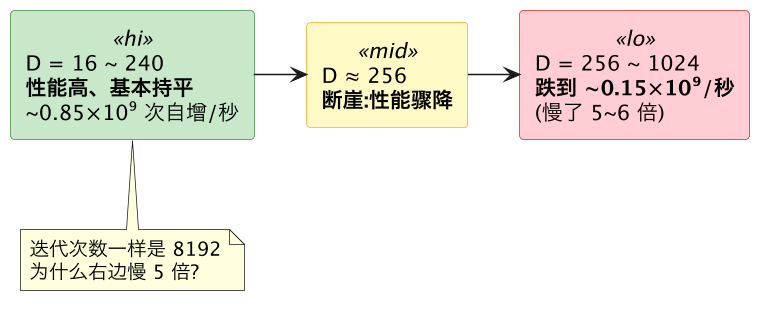
核心谜题:自增次数一模一样,为什么 D≥256 慢 5~6 倍?先排除直觉答案——不是 CPU 数据缓存。
二、先排除嫌疑:为什么不是 CPU 数据缓存?
先记住循环的关键特征:只从头到尾扫一遍,每条数据只碰一次、从不回头重复访问——数据缓存帮不上忙、也背不了锅。缓存以 64 字节 cache line 为单位(见 cache-organization):
| 步长 D | 相邻两次访问的字节间隔 | 是否落在同一 cache line? |
|---|---|---|
| D=16 | 64 字节 | 恰好每次跳到下一条新 line |
| D≥16 | ≥64 字节 | 每次都是新 line |
关键推理:D≥16 后相邻访问都落在不同 line,于是不管 D 是 16 还是 1024,循环在数据缓存眼里做的事完全一样:都碰 8192 条 line、每条各碰 1 次,唯一差别是 line 之间隔多远。
- 为什么"每条只碰 1 次"排除了容量影响:缓存的价值在重复访问时命中,可每条 line 只读一次、再不回来,第一次读必然是 miss——"留不留得住"根本没机会起作用。所以 512KB 装不装得进 L2/L3 不重要:D=16 和 D=1024 的 miss 次数完全相同。
- 数据缓存唯一"不在乎"的,恰恰是唯一在变的那一项——line 之间隔多远。
结论:数据缓存对 D≥16 的所有情况一视同仁,解释不了断崖。唯一在变的是"line 散得多开"——背后藏着一个变量:碰了多少个不同的内存"页"。对"页数"敏感的,是另一个部件——TLB。
三、真凶:TLB —— 页表翻译的缓存
3.1 补一课:虚拟地址要翻译成物理地址
程序用的是虚拟地址(VA),硬件访存前必须先翻译成物理地址(PA)。翻译以页为单位——x86 默认 4 KB:地址 = 页号(VPN) + 页内偏移(低 12 位),内核维护一张页表(VPN→PFN 映射);x86-64 是四级页表,一次完整翻译要访存 4 次。下图是"拆地址 → 只翻译页号 → 拼回物理地址"——页内偏移直接透传、不参与翻译:
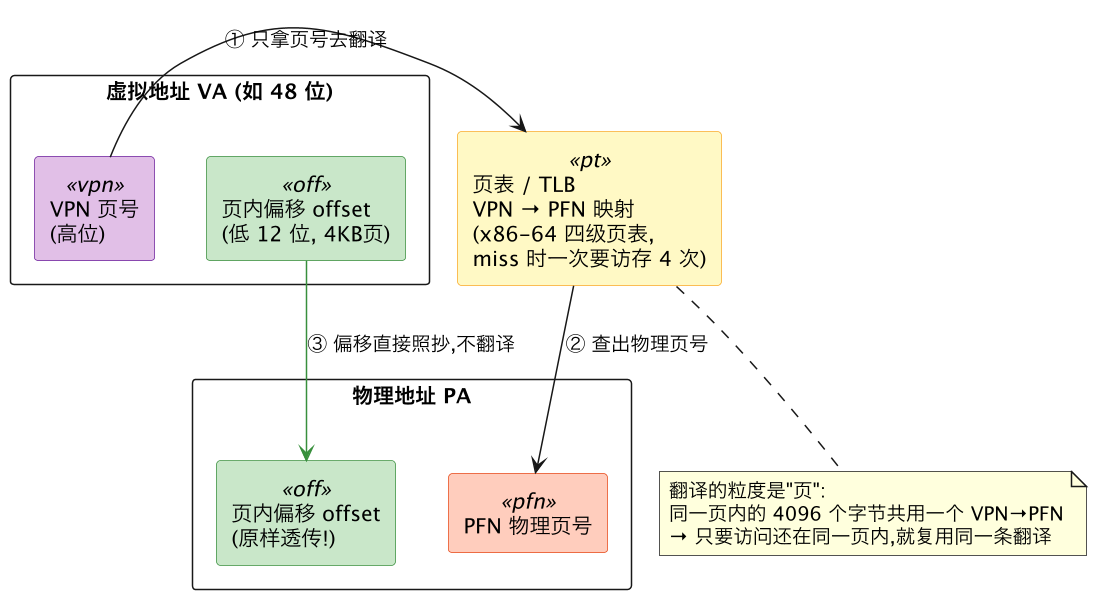
这张图埋了断崖的种子:同一页内 4096 字节共用一条 VPN→PFN,连续访问落在同一页 → 复用翻译(TLB 命中);每次访问都跳新页 → 每次新翻译——大步长正是后者。四级页表/page walk 细节见 page-table-translation,不重复,只需记住数量级:
TLB 命中 ≈ 1 拍;TLB miss → 四级 page walk ≈ 4 次访存、几十~上百拍。差几十上百倍——这正是"每次踩新页 → 每次 TLB miss → 性能暴跌"的量化根源。
3.2 TLB 就是"页表翻译的缓存"
TLB(Translation Lookaside Buffer) 缓存最近用过的 VPN → PFN 映射,让翻译绝大多数时候≈0 延迟:
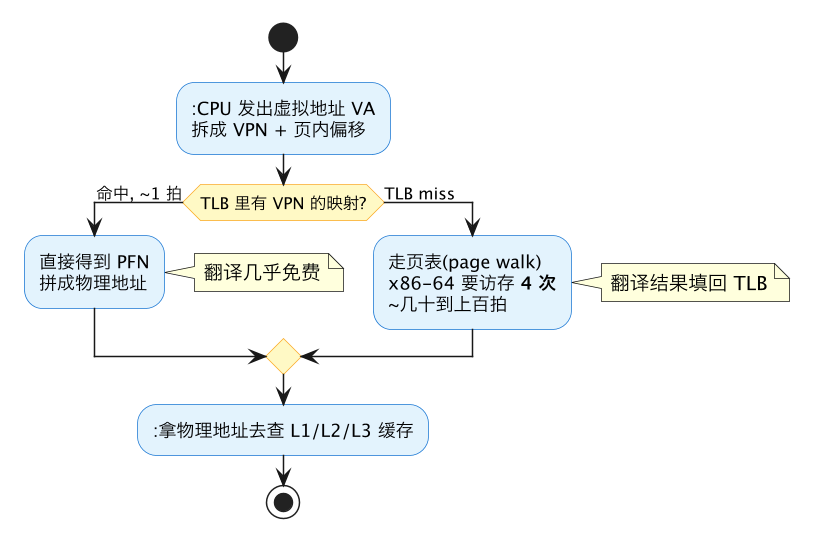
关键数字:
- 命中:翻译≈1 拍,可与查缓存并行(VIPT),几乎免费。
- miss:page walk 要额外访存 4 次,代价几十~上百拍,与一次 cache miss 同量级。
TLB 很小:高相联的小结构,典型 L1 dTLB 只有 64 条目,L2 TLB(STLB)约 512~1536 条目。覆盖范围有限:L1(64 项×4KB)只覆盖 256 KB,L2(1536 项×4KB)约 6 MB。
3.3 断崖:页"工作集"超过 TLB 容量 → thrashing
这一节是第二节的翻版,只把"单位"换成页:TLB 缓存页的翻译,容量 L1 ≈ 64 条、L2 ≈ 2048 条,比数据缓存小得多、更早告急。
前提:benchmark 是"重复扫描",不是扫一遍
要测出 10⁹ 量级吞吐,单趟 8192 次自增(几纳秒)测不出——循环被重复跑成千上万遍。单趟顺序扫永不回头,TLB 多大都无所谓;但重复扫时每趟又从头来,回到"页0"时它的翻译还在 TLB 里吗?取决于趟内"不同页数(工作集)" vs "TLB 容量"。
第一步:算出"页工作集" = 8D 个页
数组 int a[D*N](N=8192)大小 = 32D KB = 8D 个页。D≤1024 时相邻访问间隔 4D≤4096B、不跳过整页 → 数组跨越的每个页都被碰到 → 一趟踩到 8D 个不同页。
第二步:拿 8D 和 TLB 容量比,断崖就出来了
用 L2 STLB ≈ 2048 条(现代 CPU 典型值)来对:
| 步长 D | 页工作集 = 8D | 和 L2 STLB(≈2048) 比 | 结果 |
|---|---|---|---|
| 16 | 128 | 远小于 | ✅ 快 |
| 128 | 1024 | 小于 | ✅ 快 |
| 256 | 2048 | ≈ 等于 | ⚠️ 拐点 |
| 512 | 4096 | 超 2 倍 | ❌ 慢 |
| 1024 | 8192 | 超 4 倍 | ❌ 最慢 |
这就是断崖 D≈256 的来历:8 × 256 = 2048,正好等于 L2 STLB 的条目数。
第三步:为什么"装得下"是平的、"装不下"是断崖
经典的**"工作集 vs 缓存容量 → thrashing"**,只不过缓存是 TLB、缓存行是页:
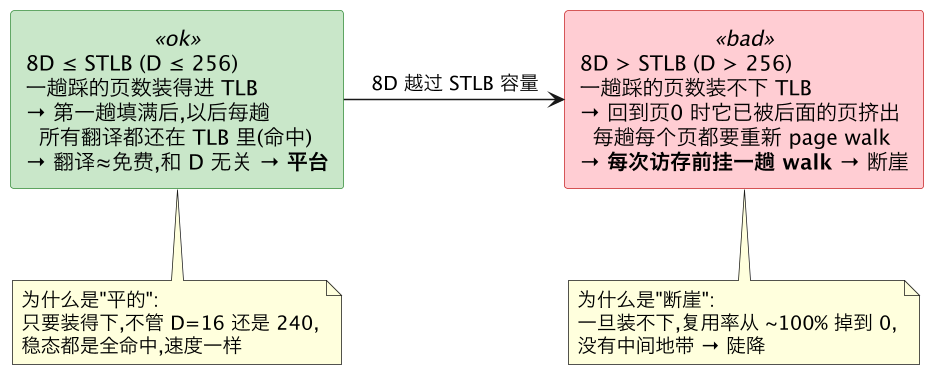
- 装得下(D≤256):第一趟填满 STLB,之后每趟都命中 → 翻译免费 → 不管 D 是 16 还是 240,稳态速度一样 → 平。
- 装不下(D>256):还没回到"页0",它的翻译早被挤掉 → 每趟每个页都重新 walk → 复用率从 ~100% 塌到 0 → 断崖(没有中间地带)。
- 叠加 L1 dTLB(64 条):D≥16 时工作集已超 L1,但 D≤256 时 STLB 兜住、只多花几拍——平台区是"L1 miss 但 STLB 便宜接住"。真正的断崖是工作集越过 STLB 那一刻。
隐藏机制:访问一个页,顺带把 7 个邻居页的"翻译原料"缓存起来
先纠正误解:TLB miss 不会把邻居页的翻译填进 TLB(一次只装一条)。但 walk 读页表项(PTE) 时,PTE 只有 8 字节、按 64B line 加载 → 一条 line 装 8 个 PTE = 8 个连续页的翻译,顺带把相邻 7 页的 PTE 拉进 L1:
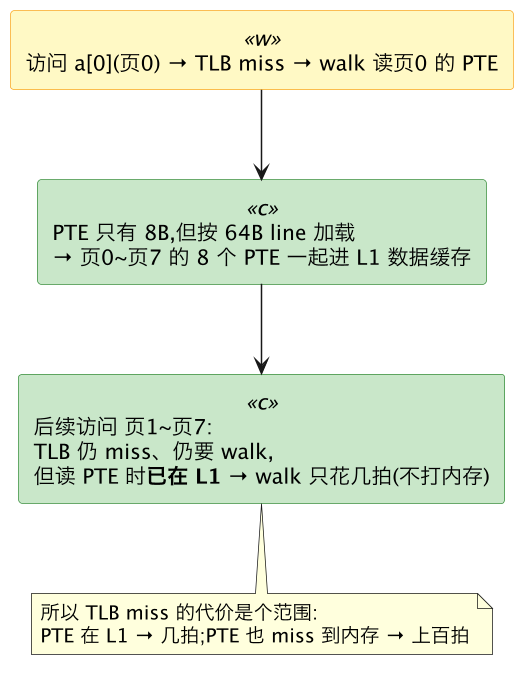
这意味着:连续页的 PTE 也连续 → 每 8 个页才 1 次 PTE 的 cache miss,walk 大多命中 L1——平台区"快"的一部分来自这里;加上 PDE 一项覆盖 2MB 和 page-walk cache(PWC),walk 真正可能 miss 的只有最后一级 PTE。
但这不改变断崖结论:PTE 缓存只影响"每次 walk 多贵",不影响"要不要 walk";D 很大时数据访问还会把 PTE 挤出缓存,walk 退回上百拍——断崖更陡。PWC 还让"8D > STLB"不是立刻崩(实测
walk_active在 D=32、D=256 两个断崖、中间回落),细节见 demos/tlb-thrashing/README §实测数据。
实测样例:不同 CPU 断崖的绝对 D 值会变
上面用"L2 STLB ≈ 2048"算 D=256,是"现代 CPU 典型值"。不同代次/品牌断崖的 D 值会变,按"拐点 D ≈ STLB 容量/8"推算:老服务器(~256~512 条)→~32~64、Haswell(1024)→~128、Ice Lake/Skylake-X(2048)→~256、Zen4(4096)→~512。
跑 demos/tlb-thrashing/ 时 demo 会自动检测拐点(L1=吞吐首跌 70% 以下;L2=之后再腰斩),本机结果略有偏差正常——原理不变,只是"STLB 容量"这个常数不同;若两级容量接近或 L2 超过最大步长对应的工作集(如 Zen4),可能只看到一级断崖。
谜底:不是数据放不进 CPU 缓存(512KB 数据量始终没变),而是一趟扫描的"页工作集 = 8D"越过了 TLB 容量(本机实测,典型 ≈2048 条)。装得下 → 每趟全命中 → 平台;装不下 → 每趟回来都被挤空 → 每次访存前挂一趟几十上百拍的 walk → 断崖。自增一样多,暴涨的是地址翻译的过路费。
四、为什么这个坑特别隐蔽
TLB 问题比普通 cache miss 更难排查,因为它不在你盯的那个维度上:
- 数据量没变:实际触达 512KB,cache 命中率分析完全正常——你会得出"缓存没问题"的错误结论。
- 迭代次数没变:算法复杂度分析也看不出差异,O(N) 就是 O(N)。
- 它藏在"访问模式"里:数据量、次数都不变,只是空间跨度(步长) 不同,TLB 压力天差地别。大步长、随机访问、指针密集结构(链表、树、哈希表)最易踩。
五、怎么确认是 TLB,以及怎么救
5.1 用 perf 确认
TLB miss 有专门的性能计数器(见 perf):
perf stat -e dTLB-loads,dTLB-load-misses,dtlb_load_misses.walk_active ./app
perf list | grep -i "dtlb\|tlb\|walk" # 事件名因型号而异判据:dTLB-load-misses 随步长增大而暴涨、page-walk 周期占大头 → TLB 瓶颈,而非数据缓存。
5.2 怎么救
| 手段 | 原理 | 适用 |
|---|---|---|
| 改访问模式/数据布局 | 让访问空间局部(小步长、顺序访问),复用同一页 | 首选,治本 |
| 大页(Huge Pages) | 2MB/1GB 替代 4KB:一条条目覆盖 2MB 而非 4KB | 大数据集、数据库、JVM 堆 |
| 紧凑结构 | 减小空间跨度,避免大步长跳跃 | 遍历、数值计算 |
| 预取 | 能藏 cache miss,对 TLB miss 帮助有限 | 辅助 |
大页为什么有效?地址位重新划分——页越大,偏移越长、页号越短,一条 entry 覆盖越大:
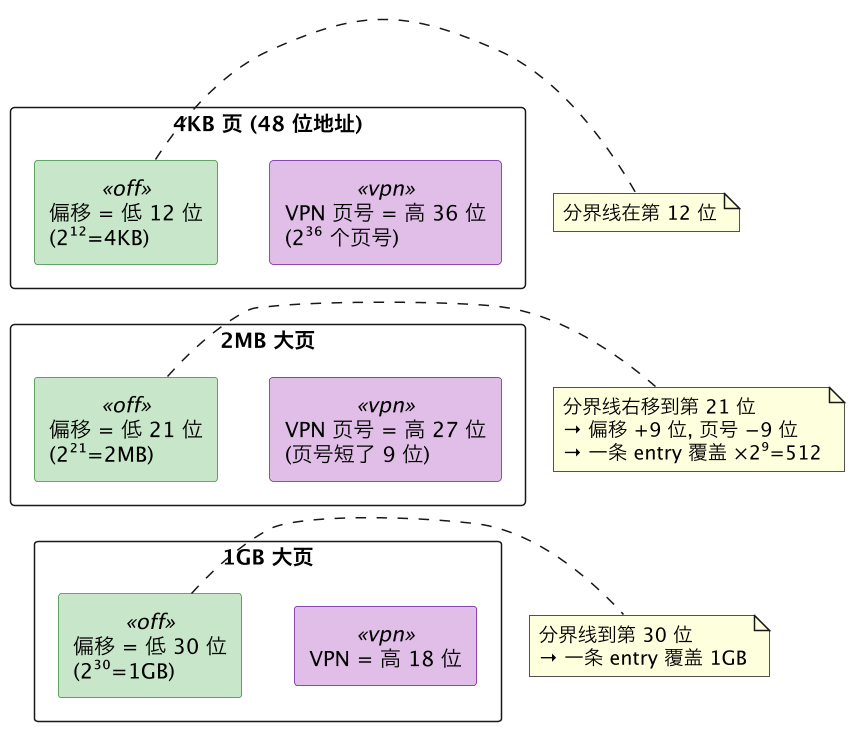
因果链:偏移变长 → 页号变短 → 同样地址空间被更少页号覆盖 → 同样 64 条 entry 罩住 512 倍范围 → 命中率暴涨。外加:偏移吃掉 PT 一级的索引位,四级页表少走一级,walk 也更便宜。对应覆盖数据:4KB→64 条 L1 dTLB 罩 256 KB;2MB→罩 128 MB;1GB→罩 64 GB(完整对比见 page-table-translation §大页)。
回到 benchmark:大页让断崖消失
最惨的 D=1024,数据 32MB:4KB 页要 8192 个 → 远超 STLB 的 2048 条 → 断崖;2MB 大页只要 16 个 → 16 条 entry 全装下 → 每趟全命中 → 断崖直接消失。
大页"银弹"的本质:不减少数据量、不改访问模式,只是把"页"放大 512 倍,让装不下的页工作集瞬间缩进 TLB 容量之内。
cat /sys/kernel/mm/transparent_hugepage/enabled   # 透明大页(THP)开关
# 显式大页:mmap 时加 MAP_HUGETLB,或用 hugetlbfs
大页的取舍:减少 TLB miss,但可能增加内存碎片、fork 时 CoW 复制粒度变大(见 process-creation)。数据库、JVM 大堆常显式配大页正是为压 TLB miss。
六、和本仓库其他文档的关系
- 前置/对比:cache-organization 讲数据层的缓存(L1/L2/L3),本篇讲地址翻译层的缓存(TLB)。两层都会 miss 但维度不同——本实验的价值正是把两者分开。
- 机制:四级页表/page walk/大页截断见 page-table-translation;iTLB 见 i-cache 第六节。
- 关联:跨 NUMA 时 walk 可能读远端页表、更贵(见 numa);共享内存多进程 PTE 指向同一 PFN,是 TLB shootdown 的典型场景(见 shared-memory)。
- 观测:perf 的 dTLB-load-misses、page-walk 事件。
七、一句话总结
"迭代次数不变、只增大步长却性能暴跌 5~6 倍",元凶不是 CPU 数据缓存(512KB 数据量始终没变),而是 TLB——地址翻译那一层的缓存。步长越大,踩的 4KB 页越多;页数越过 TLB 的几十~上千条目容量,几乎每次访存都 TLB miss、走几十上百拍的 page walk——"活一样多,翻译过路费暴涨"。确认用 perf 看 dTLB-load-misses,救治首选改访问模式,大数据集上大页是银弹。