Direct IO vs 页缓存:深入对比与性能分析
一、两种 IO 路径全景
1. 页缓存 IO(Buffered IO)
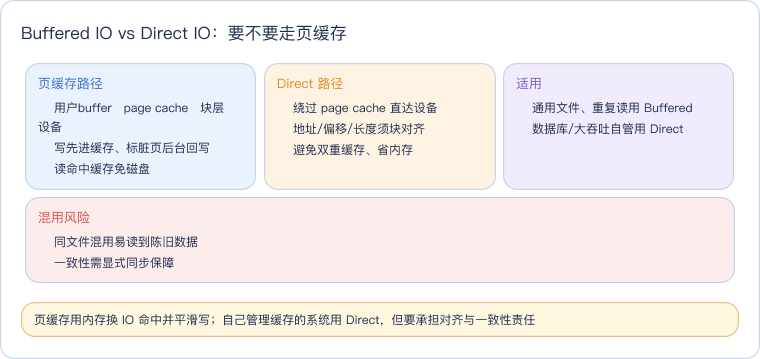
- 数据流:用户态 buffer → page cache → 块层 → 设备
- 读路径:
read()→vfs_read()→do_generic_file_read()→ 命中返回 / 未命中发起磁盘 IO - 写路径:
write()→vfs_write()→generic_perform_write()→ 写入 page cache → 标记脏页 → 后台回写 - 关键数据结构:
address_space、radix_tree(或 xarray)、struct page
2. Direct IO(O_DIRECT)
- 数据流:用户态 buffer → 块层 → 设备(绕过 page cache)
- 读路径:
read()→vfs_read()→generic_file_direct_read()→ 直接构造 bio → 提交块层 - 写路径:
write()→vfs_write()→generic_file_direct_write()→ 构造 bio → 提交块层 - 对齐要求:buffer 地址、偏移量、长度必须对齐到逻辑块大小
3. 混合模式(Buffered + Direct 混用风险)
- 同一文件同时使用两种模式的缓存一致性问题
- 内核的 invalidation 机制与性能代价
二、页缓存机制深入
1. 页缓存组织
- Radix Tree / XArray 索引结构
- 页状态:clean / dirty / writeback / locked
- LRU 双链表回收机制
2. 预读(Readahead)
- 同步预读 vs 异步预读
- 预读窗口算法(自适应扩大/缩小)
/sys/block/sda/queue/read_ahead_kb调优
3. 回写(Writeback)
- 触发条件:脏页比例超阈值、定时器到期、
sync()/fsync()显式调用 dirty_ratio、dirty_background_ratio、dirty_expire_centisecs参数- 回写线程
[writeback]与[kworkers]
4. 页缓存的内存占用与回收
page cache在free -h中的体现(cached/buffers)- 内存压力下的回收顺序:匿名页 swap vs page cache drop
echo 3 > /proc/sys/vm/drop_caches的影响
三、Direct IO 机制深入
1. Direct IO 的约束条件
- 对齐要求(buffer 地址、文件偏移、长度)
- 文件系统限制(ext4/xfs 的行为差异)
- AIO 与 Direct IO 的配合(见 io_uring 文档)
2. Direct IO 的内核实现路径
__blockdev_direct_IO()核心函数分析- bio 的构造与提交
- 等待完成:同步 vs 异步
3. Direct IO 与 O_SYNC / O_DSYNC 的关系
- O_DIRECT 只保证绕过缓存,不保证持久化
- O_DIRECT + O_SYNC 的组合语义
四、性能量化对比
测试环境:Intel Xeon 8375C @ 2.90GHz, 128GB DDR4, Linux 5.15。HDD=Seagate Exos 7E8 7200RPM, SATA SSD=Samsung 870 EVO 1TB, NVMe=Samsung 980 Pro 2TB。fio 参数见 storage-performance。
1. 读性能
| 场景 | 设备 | Buffered IO | Direct IO | 原因分析 |
|---|---|---|---|---|
| 顺序读(首次) | HDD | ~180 MB/s | ~170 MB/s | Buffered 预读引入了额外的 CPU copy 开销 |
| 顺序读(首次) | SATA SSD | ~520 MB/s | ~510 MB/s | SATA 带宽瓶颈,Direct IO 优势不明显 |
| 顺序读(首次) | NVMe | ~6500 MB/s | ~6200 MB/s | Direct IO 免去 page cache 管理,但预读对大块顺序读帮助有限 |
| 顺序读(缓存命中) | 任意 | 30000+ MB/s, <1μs | 无此概念 | 纯内存 memcpy,Direct IO 必须每次走设备 |
| 随机读(首次) | HDD | ~120 IOPS, ~8ms | ~120 IOPS, ~8ms | 性能相同,但 Buffered 会污染 page cache(把后续不会重读的冷数据塞进缓存) |
| 随机读(首次) | SATA SSD | ~80K IOPS, 0.12ms | ~82K IOPS, 0.12ms | Direct IO 略快,免去 radix_tree 插入和 LRU 维护 |
| 随机读(首次) | NVMe | ~280K IOPS, 0.03ms | ~300K IOPS, 0.03ms | Direct IO 优势明显,高 IOPS 下 page cache 元数据锁竞争不可忽视 |
| 随机读(热点数据) | SATA SSD | >100K IOPS(缓存命中=内存速度) | ~82K IOPS | 命中率是核心变量。Buffer pool < page cache 总大小时命中率极高 |
2. 写性能
| 场景 | 设备 | Buffered IO | Direct IO | 原因分析 |
|---|---|---|---|---|
| 顺序写(1GB+) | HDD | ~180 MB/s | ~170 MB/s | Buffered:先写缓存立刻返回,后台回写;瓶颈在磁盘吞吐 |
| 顺序写(1GB+) | SATA SSD | ~500 MB/s | ~490 MB/s | 差别不大,SATA 带宽是共同瓶颈 |
| 顺序写(1GB+) | NVMe | ~4500 MB/s | ~4800 MB/s | Direct IO 略优:绕过了 balance_dirty_pages 的回写节流 |
| 顺序写(小数据,多次 write) | HDD | ~100K IOPS(缓存合并) | ~200 IOPS | Buffered 把多次小写合并成一次大块写 → IOPS 提升 500x |
| 随机写 | HDD | ~150-200 IOPS(回写合并后) | ~120 IOPS | Buffered 稍好:回写线程重排写请求,减少磁头寻道 |
| 随机写 | SATA SSD | 70K-85K IOPS | 88K IOPS | Direct IO 更好:无 page cache 竞争,写请求直通设备 |
| 随机写 | NVMe | 500K-800K IOPS | 900K-1M IOPS | 高 IOPS 场景 Direct IO 省去 page cache 锁竞争,优势显著 |
fsync() 延迟 | HDD | 10-50ms(需刷全部脏页) | 5-10ms(仅等设备确认) | Buffered 最致命:脏页越多 fsync 越久,不可控 |
fsync() 延迟 | SATA SSD | 5-20ms | 0.1-0.5ms | SSD 上差距巨大,Direct IO 是数据库选它的首要原因 |
fsync() 延迟 | NVMe | 3-10ms | 0.02-0.1ms | 同上,量级差 100x |
3. 内存使用
| 指标 | Buffered IO | Direct IO |
|---|---|---|
| 内核内存占用 | 高:page cache 随读写持续增长,可能占满 free -h 的 cached | 低:每次 IO 完成后数据区直接释放,不常驻 |
| 用户态内存 | 任何 malloc 地址即可 | 必须 posix_memalign(512) 对齐到逻辑块大小(通常 512B/4K) |
| 内存拷贝次数 | 2 次:用户 buf → page cache → 设备 DMA(写);设备 DMA → page cache → 用户 buf(读) | 1 次:用户 buf ↔ 设备 DMA(走块层 bio,无中间缓冲) |
free -h 中的体现 | cached 列持续上涨 | cached 不受影响,available 更大 |
4. 延迟分解参考(各设备类型)
| 介质类型 | 典型设备 | 平均延迟 | P99 延迟 | 4K 随机读 IOPS | 4K 随机写 IOPS | 顺序吞吐 |
|---|---|---|---|---|---|---|
| HDD 7200RPM | Seagate Exos | 5-10ms | 20-50ms | 100-200 | 100-200 | 150-250 MB/s |
| HDD 10000RPM | WD VelociRaptor | 3-6ms | 10-30ms | 150-300 | 150-300 | 200-300 MB/s |
| HDD 15000RPM | Seagate Cheetah | 2-5ms | 8-20ms | 250-400 | 250-400 | 250-350 MB/s |
| SATA SSD | Samsung 870 EVO | 0.05-0.15ms | 0.5-2ms | 90K-100K | 80K-90K | 500-550 MB/s |
| NVMe Gen3 | Samsung 970 EVO Plus | 0.02-0.08ms | 0.2-1ms | 500K-600K | 500K-550K | 3000-3500 MB/s |
| NVMe Gen4 | Samsung 980 Pro | 0.01-0.05ms | 0.1-0.5ms | 800K-1M | 800K-1M | 5000-7000 MB/s |
| NVMe Gen5 | 企业级 (理论) | 0.005-0.02ms | <0.1ms | 1.5M-2.5M | 1.5M-2.5M | 10000-14000 MB/s |
| Intel Optane | P5800X | <0.01ms | <0.02ms | 1.5M-2M | 1.5M-2M | 7000 MB/s |
判断法则:HDD 延迟是
ms级,SSD 是μs级(百微秒),NVMe 是十微秒级,Optane 是个位微秒级——差了三个数量级。iostat -x 1的await列直接对号入座。
五、场景选择决策树
bash
数据库应用 → Direct IO(自己管理缓存,避免双缓存)
文件服务器 → Buffered IO(充分利用 OS 缓存)
日志写入   → Direct IO + O_APPEND + O_SYNC
虚拟机镜像 → Direct IO / O_DIRECT(避免宿主缓存污染)
大文件传输 → Buffered IO + 预读优化
实时系统   → Direct IO(可预测延迟)
流媒体     → Buffered IO(预读缓存命中率高)
六、相关对比
- mmap vs read/write —— 另一个正交维度
- io_uring —— 新一代异步 IO 框架兼用两者
- read-write-process —— read/write 完整链路
七、参考资料
- Linux 内核源码:
fs/direct-io.c、mm/filemap.c - 《Understanding the Linux Kernel》Chapter 15
- https://www.kernel.org/doc/html/latest/filesystems/
七、一句话总结
Buffered IO 走 page cache,用内存换命中并平滑写,适合通用文件;Direct IO(O_DIRECT)绕过缓存直达设备但要求块对齐,适合自管缓存的数据库,二者混用要防数据不一致。