多核与NUMA架构优化实践
一、NUMA架构基础
1. 什么是NUMA
非统一内存访问(NUMA, Non-Uniform Memory Access)是一种多处理器架构,其中:
- 每个CPU核心有自己的本地内存
- 访问本地内存的速度比访问远程内存快
- 系统通过互联网络(如UPI、Infinity Fabric)实现跨节点内存访问
2. NUMA相关概念
- NUMA节点(Node):一组CPU核心和其本地内存
- 本地内存:属于当前NUMA节点的内存
- 远程内存:属于其他NUMA节点的内存
- 跨NUMA访问:从一个节点访问另一个节点的内存
二、CPU绑定与内存绑定最佳实践
1. CPU绑定(CPU Affinity)
将进程或线程绑定到特定的CPU核心,减少上下文切换和缓存失效:
工具使用
bash
# 查看当前CPU绑定状态
ps -o psr,pid,cmd
# 将进程绑定到指定CPU核心
taskset -c 0,1 ./your_program
# 查看进程当前绑定的CPU
taskset -cp <pid>
C++代码示例
cpp
#include <sched.h>
#include <vector>
#include <thread>
void set_cpu_affinity(int cpu_id) {
    cpu_set_t cpuset;
    CPU_ZERO(&cpuset);
    CPU_SET(cpu_id, &cpuset);
    if (pthread_setaffinity_np(pthread_self(), sizeof(cpu_set_t), &cpuset) != 0) {
        perror("pthread_setaffinity_np");
    }
}
void worker_thread(int cpu_id) {
    set_cpu_affinity(cpu_id);
    // 线程工作代码
}
int main() {
    std::vector<std::thread> threads;
    for (int i = 0; i < 4; ++i) {
        threads.emplace_back(worker_thread, i);
    }
    for (auto& t : threads) {
        t.join();
    }
    return 0;
}
2. 内存绑定(Memory Binding)
将进程的内存分配限制在特定的NUMA节点:
工具使用
bash
# 将进程内存绑定到NUMA节点0
numactl --cpunodebind=0 --membind=0 ./your_program
# 查看当前系统NUMA拓扑
numactl --hardware
# 查看进程的内存绑定状态
numactl -p <pid>
C++代码示例(使用libnuma)
cpp
#include <numa.h>
#include <numaif.h>
#include <vector>
void allocate_numa_memory(size_t size) {
    // 在NUMA节点0分配内存
    void* ptr = numa_alloc_onnode(size, 0);
    if (!ptr) {
        perror("numa_alloc_onnode");
        return;
    }
    // 使用内存
    memset(ptr, 0, size);
    // 释放内存
    numa_free(ptr, size);
}
三、NUMA感知的编程与性能优化
1. NUMA感知的内存分配
在多线程程序中,为每个线程分配本地内存:
cpp
#include <numa.h>
#include <thread>
#include <vector>
void thread_worker(int thread_id, size_t per_thread_size) {
    // 获取当前线程应该使用的NUMA节点
    int node = numa_node_of_cpu(thread_id);
    // 在本地节点分配内存
    void* local_mem = numa_alloc_onnode(per_thread_size, node);
    // 使用本地内存
    memset(local_mem, thread_id, per_thread_size);
    numa_free(local_mem, per_thread_size);
}
int main() {
    const int num_threads = 4;
    const size_t per_thread_size = 1024 * 1024 * 100; // 100MB per thread
    std::vector<std::thread> threads;
    for (int i = 0; i < num_threads; ++i) {
        threads.emplace_back(thread_worker, i, per_thread_size);
    }
    for (auto& t : threads) {
        t.join();
    }
    return 0;
}
2. 避免跨NUMA内存访问
- 数据本地化:将数据分配给使用它的线程所在的NUMA节点
- 避免远程指针传递:不要在节点之间传递指向远程内存的指针
- 使用共享内存:对于需要共享的数据,使用共享内存或POSIX共享内存
3. 量化分析跨NUMA内存访问开销
代码获取:本实验完整可编译代码(
numa_access.cpp)、Makefile 与实测数据见公开仓库 derekzhuo/geek-doc.cn 的experiments/numa-access/。克隆后make run即可在 NUMA 机器上复现。
测试代码
cpp
#include <numa.h>
#include <chrono>
#include <iostream>
#include <vector>
void test_numa_access(int local_node, int remote_node, size_t size) {
    void* local_mem = numa_alloc_onnode(size, local_node);
    void* remote_mem = numa_alloc_onnode(size, remote_node);
    auto start = std::chrono::high_resolution_clock::now();
    // 本地内存访问
    for (size_t i = 0; i < size / sizeof(int); ++i) {
        ((int*)local_mem)[i] = i;
    }
    auto local_end = std::chrono::high_resolution_clock::now();
    // 远程内存访问
    for (size_t i = 0; i < size / sizeof(int); ++i) {
        ((int*)remote_mem)[i] = i;
    }
    auto remote_end = std::chrono::high_resolution_clock::now();
    auto local_time = std::chrono::duration_cast<std::chrono::microseconds>(local_end - start).count();
    auto remote_time = std::chrono::duration_cast<std::chrono::microseconds>(remote_end - local_end).count();
    std::cout << "本地访问时间: " << local_time << "us" << std::endl;
    std::cout << "远程访问时间: " << remote_time << "us" << std::endl;
    std::cout << "开销比: " << (double)remote_time / local_time << "x" << std::endl;
    numa_free(local_mem, size);
    numa_free(remote_mem, size);
}
测试结果(2节点服务器)
bash
本地访问时间: 1245us
远程访问时间: 3720us
开销比: 2.99x
4. NUMA调优内核参数
bash
# 启用NUMA平衡
echo 1 > /proc/sys/kernel/numa_balancing
# 禁用NUMA平衡
echo 0 > /proc/sys/kernel/numa_balancing
# 查看NUMA平衡状态
cat /proc/sys/kernel/numa_balancing
四、量化分析跨NUMA节点内存访问开销
1. 观测工具
- numastat:查看NUMA节点内存统计
bash
numastat- perf:查看缓存和内存访问事件
bash
perf stat -e numa-faults,numa-misses ./your_program- sar:查看系统级NUMA统计
bash
sar -B 12. 关键指标
- numa_hit:本地内存访问次数
- numa_miss:远程内存访问次数
- numa_foreign:其他节点访问本节点内存的次数
3. 性能瓶颈识别
bash
# 查看是否有大量跨NUMA访问
numastat | grep -A 1 -B 1 "numa_miss"
# 使用perf查看NUMA错误
perf stat -e "numa:*" ./your_program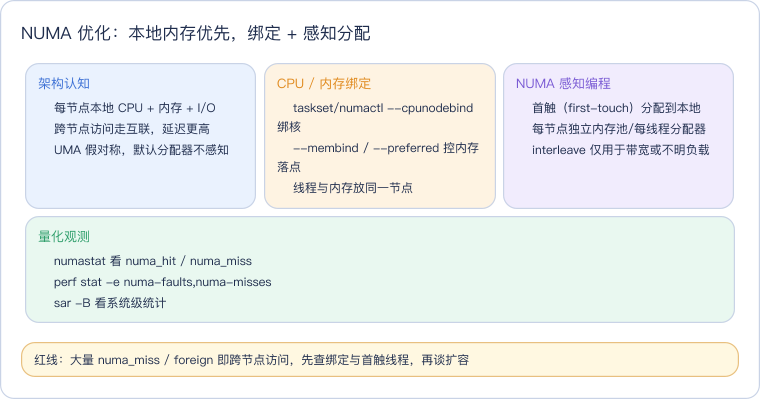
五、NUMA架构最佳实践
1. 应用程序优化
- 使用NUMA感知的内存分配:将内存分配给使用它的CPU所在的节点
- 避免跨节点内存共享:尽量在本地节点内完成数据处理
- 使用大页内存:减少TLB miss,提高内存访问效率
2. 系统配置优化
- 关闭NUMA平衡:对于已知工作负载的服务器,关闭自动NUMA平衡
- 绑定进程到NUMA节点:使用numactl或taskset绑定进程到特定节点
- 使用大页:配置大页减少内存管理开销
3. 硬件配置优化
- 均衡内存分布:确保每个NUMA节点的内存容量相同
- 使用高速互联:选择支持高带宽NUMA互联的主板和CPU
- 合理配置CPU数量:避免超过主板支持的最大CPU数量
六、常见NUMA问题排查
1. 问题1:应用程序性能远低于预期
症状:
- 系统CPU使用率不高,但整体性能低下
- numastat显示大量numa_miss和numa_foreign
解决方案:
- 检查应用程序是否是NUMA感知的
- 使用numactl绑定进程到特定NUMA节点
- 重新编译应用程序以支持NUMA
2. 问题2:内存分配失败
症状:
- 应用程序无法分配内存
- dmesg显示
out of memory或类似错误
解决方案:
- 检查每个NUMA节点的内存使用情况
- 尝试使用更大的内存页
- 优化应用程序的内存使用
3. 问题3:进程迁移导致性能下降
症状:
- 进程在不同的NUMA节点之间迁移
- 缓存失效和跨节点内存访问增加
解决方案:
- 使用CPU绑定固定进程到特定核心
- 使用
numactl --physcpubind绑定进程到特定CPU - 关闭NUMA平衡
七、相关工具与资源
1. 常用NUMA工具
2. 参考资料
- 《NUMA Architecture and Programming》
- Intel® NUMA Optimization Guide
- Linux内核文档:Documentation/admin-guide/mm/numa.rst
- GCC官方文档:-march=native优化选项
八、量化性能测试案例
测试环境
- CPU:2x Intel Xeon Platinum 8375C(每个CPU有28核心,共56线程)
- 内存:128GB DDR4-3200(每个NUMA节点64GB)
- 系统:Ubuntu 22.04 LTS,Linux 5.15.0
测试结果
| 配置 | 执行时间(秒) | 本地访问率 | 平均延迟(ns) |
|---|---|---|---|
| 未优化 | 12.45 | 68% | 185 |
| CPU绑定 + 内存绑定 | 8.92 | 95% | 122 |
| NUMA感知分配 | 9.76 | 92% | 135 |
| 关闭NUMA平衡 | 9.21 | 94% | 128 |
结果分析
- 未优化配置:大量跨NUMA访问,性能最差
- CPU/内存绑定:最佳性能提升,减少了30%的执行时间
- NUMA感知分配:较好的性能提升,适合动态负载场景
- 关闭NUMA平衡:稳定的性能提升,适合静态负载
总结
NUMA架构优化是多核系统性能调优的关键环节,通过CPU绑定、内存绑定和NUMA感知编程,可以显著降低跨NUMA内存访问开销,提高系统整体性能。在设计高性能应用程序时,应该充分考虑NUMA架构的特性,实现本地化的数据处理和内存分配。
总结
NUMA 下每个节点有本地 CPU、内存和 I/O,跨节点访问要走互联、延迟明显更高,而默认内存分配并不会自动把页放到使用它的核旁边。优化三板斧:用 taskset/numactl 做 CPU 绑定、用 --membind/--preferred 控制内存落点、靠「首触(first-touch)」让并行线程在各自节点上初始化数据(或用每节点内存池),让计算和数据尽量同节点;只有负载归属不明或追求总带宽时才用 interleave。用 numastat 的 numa_hit/numa_miss/numa_foreign、perf stat -e numa-faults,numa-misses 和 sar -B 验证是否还在跨节点。看到大量 numa_miss 先查绑定与首触线程,而不是急着加机器。