内核调度 —— 调度器怎么决定"下一个跑谁",以及有几种队列
机器上有几百个可运行的 task,却只有几个 CPU 核。内核调度器(scheduler) 就是那个反复回答"这个核,下一纳秒该跑哪个 task、跑多久"的裁判。本篇是调度全景导读:先给出一句话认知,再用三条线带你钻进去——到底有几种队列、凭什么选人、何时切换,最后是与其他文档的关系。
相关:被调度的实体是什么见 task-struct(task/
task_struct);把 task 钉在固定核上见 thread-affinity;上下文切换的开销与观测见 pidstat、vmstat;切换要保存/恢复的现场见 task-struct §一。
零、一句话认知:调度 = 从"每核的运行队列"里挑一个 task 上 CPU
内核给每个 CPU 核配一个运行队列(struct rq,per-CPU run queue)——只装此刻可运行(TASK_RUNNING) 的 task。调度器做的事,就是每次需要切换时,从当前核的运行队列里按规则挑一个放上 CPU 跑,时间到了或有更该跑的来了就换下一个。
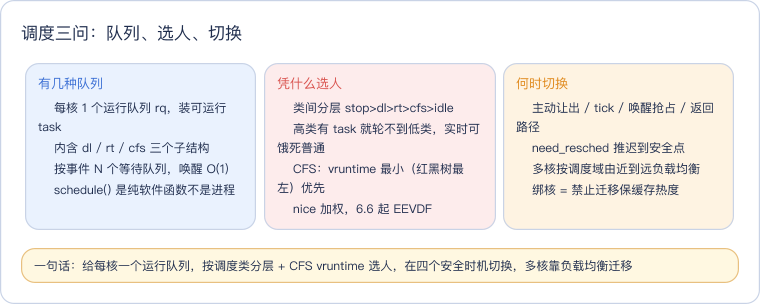
这个"挑一个"的背后有三个层次,正好是三个子篇各回答一个问题:
| 问题 | 答案骨架 | 子篇 |
|---|---|---|
| 到底有几种队列? | 每核 1 个运行队列(内含 dl/rt/cfs 三个子结构)+ 按事件 N 个等待队列;调度器是纯软件函数不是进程 | scheduling-queues |
| 凭什么选人? | 类间按调度类分层(stop>dl>rt>cfs>idle),类内 CFS 按 vruntime 最小优先(红黑树最左),nice 加权、6.6 起 EEVDF | scheduling-classes |
| 何时切换? | 主动让出/tick/唤醒抢占/返回路径四个时机,need_resched 推迟到安全点;多核间负载均衡迁移任务 | scheduling-timing |
一、三线速览
线一:到底有几种队列(→ scheduling-queues)
"队列"不是一种东西,而是一组结构:
- 运行队列
rq(每核 1 个):装可运行 task,是容器,肚子里嵌套 dl 红黑树、rt 多级链表(每优先级 0-99 一条 + bitmap)、cfs 红黑树三个子结构。 - 等待队列(按事件 N 个):装睡着等事件的 task(锁/磁盘 IO/socket/定时器…),各自内嵌在所属内核对象里——没有全局注册表、不绑定 CPU,唤醒就是精确操作那个对象的队列头(O(1))。
- 调度器:不是进程也不是硬件,是内核里跑在调用者上下文中的纯软件函数
schedule()(kernel/sched/core.c)。
线二:凭什么选人(→ scheduling-classes)
一个核内按调度类分层选人,从高到低:
- stop(内核内部)> dl(
SCHED_DEADLINE,按 deadline 红黑树)> rt(SCHED_FIFO/RR,固定优先级 0-99 多级链表)> fair/CFS(SCHED_OTHER,普通任务几乎全在这)> idle。 - 高优先级类里只要有可运行 task,就轮不到低优先级类——所以实时任务能饿死普通任务。
- CFS 核心:每个 task 记
vruntime,跑就涨,vruntime 最小 = 欠跑最多 = 下一个被选;用红黑树存,取最左 O(1)。nice 是权重因子(每差 1 约差 1.25 倍),6.6 起 EEVDF 引入虚拟截止期改善交互延迟。
线三:何时切换(→ scheduling-timing)
- 四个触发时机:主动让出(阻塞/yield/退出)、tick 时间片到(100~1000Hz 检查)、唤醒抢占(跨核靠 RES IPI 通知)、返回用户态/中断返回(检查
need_resched)。 - 上下文切换代价:保存/恢复寄存器 + 切页表(CR3→TLB 失效)+ 缓存变冷;现代内核
CONFIG_PREEMPT下内核态也可抢占。 - 多核:周期性负载均衡按调度域(SMT<L3<NUMA<跨节点)由近到远迁移任务;迁移丢缓存 → 尾延迟尖刺,绑核 = 禁止迁移保热度(thread-affinity)。
- 观测:vmstat 的
r/cs、pidstat -w、chrt、/proc/<pid>/sched;调节:nice/renice/chrt,实时优先级慎用。
观测速查(调度相关的命令一网打尽)
# 看运行队列长度 + 上下文切换速率
vmstat 1                    # r=可运行任务数, cs=每秒上下文切换
# 看每个进程的上下文切换(自愿/非自愿)
pidstat -w 1                # cswch/s 自愿, nvcswch/s 非自愿
# 看任务上次跑在哪个核、亲和性掩码
cat /proc/<pid>/status      # Cpus_allowed、State
cat /proc/<pid>/stat        # 第 39 字段 = 上次运行核号
# 看调度策略与优先级、调优先级
chrt -p <pid>               # SCHED_OTHER/FIFO/RR + 优先级
chrt -f -p 50 <pid>         # 改成实时 FIFO 50(需权限,慎用)
nice -n -5 ./app            # 以更高优先级启动(负数需权限)
# 看每核调度统计、迁移次数
cat /proc/schedstat
perf stat -e migrations ./app   # 看迁移次数
# 看 CPU 核拓扑(理解调度域)
lscpu -e # CPU/核心/套接字/NUMA 节点映射三个判读要点:
- vmstat 的
r列持续大于 CPU 核数 → 任务在排队,CPU 过载(如 4 核机器r长期 8~12 就是 2~3 倍排队压力)。 pidstat -w的非自愿切换(nvcswch/s)高 → 任务频繁被抢占/时间片耗尽,多半是 CPU 争抢激烈;结合r列看是不是真过载。cs(上下文切换)突然飙升但r不高 → 往往是大量短任务在快速轮转(如大量线程频繁 sleep 唤醒),或锁竞争导致频繁让出——这种场景先查锁,别急着加核。
和实时/多核相关的两个延伸
- 实时任务为什么危险:
SCHED_FIFO优先级 99 的任务如果不主动让出,会一直霸占某个核,普通任务连喘息机会都没有(有sched_rt_runtime_us限流兜底,但延迟依然恶劣)。实时优先级是"最后手段",不是"提升性能的开关"——详见 scheduling-classes 与 real-time-scheduling。 - 绑核的代价:
taskset/sched_setaffinity把任务钉在固定核上能保缓存热度、避免迁移尖刺,但也放弃了负载均衡的灵活性——一个核打满、其他核闲着时它不会自动搬走。到底绑不绑,取决于任务是延迟敏感(绑)还是吞吐导向(不绑)。详见 thread-affinity。
二、和本仓库其他文档的关系
- 被调度的实体:task-struct——task/
task_struct、调度字段(sched_class/prio/cpus_ptr)、R/S/D/T/Z 状态(运行队列↔等待队列的两端)。 - 绑核/亲和性:thread-affinity——限制 task 能进哪些核的运行队列、禁止迁移保缓存热度、isolcpus/nohz_full。
- 进程/线程创建:process-creation、thread-creation——新 task 建好后"加入运行队列、等调度器挑中"。
- 切换实现与开销:context-switch(switch_mm/switch_to、切线程 vs 切进程)、context-switch-cost(切换的量与代价)。
- 切换代价:tlb(换页表→TLB 失效)、pidstat(上下文切换观测)、vmstat(
r/cs列)、top(负载/状态)。
三、一句话总结
调度器给每个 CPU 核配一个运行队列(rq),只装可运行的 task;睡眠等事件的 task 待在按事件分的等待队列里,被唤醒才塞回某核 rq。一个核内按调度类分层选人——dl(截止期红黑树)> rt(每优先级一条链表的多级队列)> cfs(按 vruntime 排的红黑树,普通任务几乎全在这,谁欠跑得最多即 vruntime 最小就选谁,nice 加权、6.6 起用 EEVDF),从高到低第一个有可运行 task 的类出人。切换发生在阻塞/时钟 tick/唤醒抢占/返回用户态这些时机,代价是保存现场+换页表致 TLB 失效;多核间周期性做负载均衡迁移任务,而绑核就是禁止迁移保住缓存热度。所以"有几种队列"要分两层看:每核一个运行队列(内含 dl/rt/cfs 三种子结构)+ 按事件多个的等待队列。