RCU(Read-Copy-Update)内核实现与原理深入
前置:low-latency-patterns 第三、四节(RCU 基本概念与 API)
配套:lockfree-deep 第四节(内存回收方案对比)
一、RCU 的设计哲学
1. 核心权衡
- 读者零开销:不需要锁,不需要原子操作,不需要内存屏障(在读取路径上)
- 写者承担所有代价:复制、修改、等待所有读者完成、释放旧数据
- 适合读多写少的极致场景
2. RCU 与其他同步机制的本质区别
| 机制 | 读者开销 | 写者开销 | 读者-写者并发 | 典型读:写比 |
|---|---|---|---|---|
| 读写锁 | 原子操作 | 阻塞等待读者 | ✅(读者共享) | 10:1 |
| 顺序锁(seqlock) | 重试 | 无等待 | ✅ | 100:1 |
| RCU | 零(仅 preempt_disable) | 等待宽限期 | ✅ | 1000:1+ |
| Hazard Pointers | 原子操作 | 扫描+释放 | ✅ | 100:1 |
二、宽限期(Grace Period)机制
1. 什么是宽限期
bash
宽限期:
时间轴:  |---宽限期开始---|---reader A 离开---|---宽限期结束---|
Reader A: ==========>
Reader B:         ============>
Reader C: =====>- 宽限期 = 从写者发布更新开始 → 到所有可能看到旧数据的读者都离开为止
- 宽限期结束后,旧数据可以安全释放
2. 静默态(Quiescent State)
- 定义:CPU 发生上下文切换、进入用户态、或执行 idle —— 都是静默态
- 一个 CPU 报告静默态 = 该 CPU 上的读者全部结束
- 所有 CPU 都报告过静默态 = 宽限期结束
3. rcu_read_lock / rcu_read_unlock 的实现
c
// 抢占式内核中
rcu_read_lock()   → preempt_disable()  // 禁止抢占即可
rcu_read_unlock() → preempt_enable()   // 抢占发生 = 静默态
// 读临界区可以 sleep 吗?→ 抢占式 RCU (CONFIG_PREEMPT_RCU) 中: 不行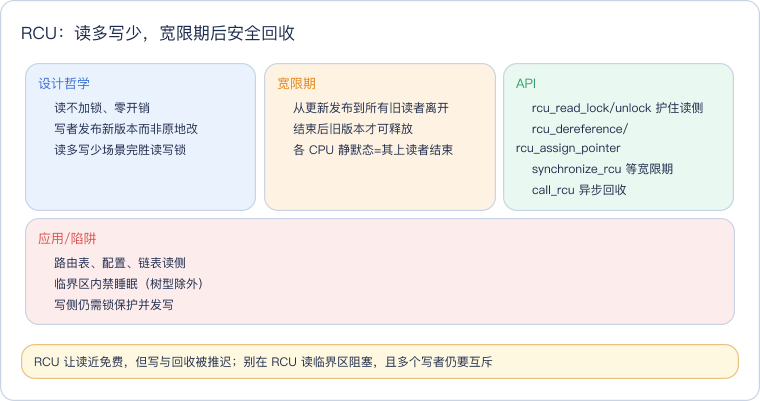
三、RCU 在内核中的四种实现
1. Classic RCU
- 最早实现,依赖全局计数器
- 宽限期检测:周期性检查所有 CPU
2. Tree RCU
- 分层树形结构管理 CPU(解决大规模 NUMA 可扩展性问题)
- 每个节点聚合子节点的静默态报告
- 当前默认实现
3. Tiny RCU
- 用于单核/小型系统
- 简化实现:上下文切换 = 宽限期结束
4. SRCU (Sleepable RCU)
- 允许读者在临界区睡眠(不依赖 preempt_disable)
- 每个 SRCU domain 有独立的计数器
- 代价:读者侧更高的开销,写者必须等待每个 domain
四、关键 API 深度解析
1. 读者 API
c
rcu_read_lock();           // preempt_disable()
ptr = rcu_dereference(p);  // READ_ONCE + 编译期屏障
// ... 使用 ptr ...
rcu_read_unlock();         // preempt_enable()
2. 写者 API
c
// 更新指针(发布新数据)
rcu_assign_pointer(p, new);  // smp_store_release + 已有的读者不受影响
// 同步等待(阻塞写者直到宽限期结束)
synchronize_rcu();           // 可能睡眠,不能用于中断上下文
// 异步回调(不阻塞写者)
call_rcu(&head, callback);   // 宽限期结束后调用 callback 释放旧数据
3. 进阶 API
c
rcu_barrier();               // 等待所有已排队的 call_rcu 回调完成
kfree_rcu(ptr, rcu_field);   // 一步到位:call_rcu + kfree
rcu_dereference_protected(); // 写者侧无需屏障的访问
五、RCU 的应用模式
1. 发布-订阅模式(最基础)
c
// 写者
new_data = copy_and_modify(old_data);
rcu_assign_pointer(global_ptr, new_data);
synchronize_rcu();
kfree(old_data);
// 读者
rcu_read_lock();
data = rcu_dereference(global_ptr);
// 使用 data
rcu_read_unlock();
2. 链表遍历与删除
list_for_each_entry_rcu():RCU 安全的遍历list_del_rcu():删除节点但不立即释放synchronize_rcu()+kfree():等待后再释放
3. 免锁计数器(RCU + percpu)
- 每个 CPU 维护本地计数器
- 读取端:
rcu_read_lock()+ 累加所有 per-CPU 计数 →rcu_read_unlock() - 写入端:直接修改当前 CPU 的本地计数
4. SLAB_TYPESAFE_BY_RCU
- 内存回收后可以立即重新分配同类型对象
- 适用于"对象被查找到后才发现已过时"的场景
六、性能开销量化
1. 读者开销(Xeon 8375C)
| 操作 | 延迟 |
|---|---|
rcu_read_lock() | ~1 ns(仅 preempt_disable) |
rcu_dereference() | ~0 ns(编译期屏障) |
rcu_read_unlock() | ~1 ns |
对比:pthread_rwlock_rdlock() → ~20 ns(无竞争)/ ~200 ns(有竞争)
2. 写者开销
| 操作 | 延迟 |
|---|---|
rcu_assign_pointer() | ~5 ns(store release) |
synchronize_rcu() | 数 ms~数十 ms(等待宽限期) |
call_rcu() | ~50 ns(排队回调,非阻塞) |
3. 宽限期时长分布
- 典型值:3-30 ms(取决于
CONFIG_RCU_LAZY和 CPU 数量) - 调优参数:
rcu_normal/rcu_expedited(需要快速 GC 时用 expedited) rcutorture测试模块
七、RCU 的陷阱
- 临界区不能阻塞(普通 RCU)→ 可能导致宽限期无限延长
- synchronize_rcu() 可能阻塞很久→ 不能用于中断上下文 / 持有自旋锁
- call_rcu 回调也可能堆积→ 高频率更新需要
rcu_barrier()控制 - RCU 不保护写者之间的竞争→ 需要额外的锁保护更新操作
- 对象复用的预期管理→ 宽限期结束前不能释放,也不能立即复用
八、参考
- lockfree-deep —— 无锁编程与内存回收全景对比
- low-latency-patterns —— 低延时设计导读
- memory-model —— C/C++ 内存模型
- 《Is Parallel Programming Hard, And, If So, What Can You Do About It?》Paul E. McKenney
- Linux Kernel:
Documentation/RCU/
总结
RCU 让读侧零开销:写者发新版本,等过宽限期(所有旧读者离开)后再回收旧数据,适合读多写少;读临界区别睡眠,多个写者仍需锁。