从源码到运行:编译、链接、加载全过程(结合 ELF 分析)
把前面的 ELF 知识串成一条完整链路:一份
.cpp是怎么变成能跑的进程的?中间生成了哪些文件、每个文件是什么 ELF 结构、运行时内核和动态链接器又做了什么、.so如何被找到和绑定。全程结合本仓库的main.cpp/cpu_demo实操。
零、全景图
main.cpp
   │  ① 预处理 (cpp)           展开 #include / #define / 条件编译
   ▼
main.i        ← 纯 C++ 源码(已展开,还是文本)
   │  ② 编译 (cc1plus)         C++ → 汇编
   ▼
main.s        ← 汇编代码(文本,x86 指令)
   │  ③ 汇编 (as)              汇编 → 机器码目标文件
   ▼
main.o        ← 目标文件【ELF, Type=REL 可重定位】
   │  ④ 链接 (ld)              合并 .o + 库,重定位,生成可执行
   ▼
cpu_demo      ← 可执行文件【ELF, Type=DYN(PIE) 或 EXEC】
   │  ⑤ 加载 (execve + ld.so)  内核映射 + 动态链接器加载 .so + 重定位
   ▼
运行中的进程 ← 内存里的段(Segment):代码/数据/堆/栈/映射的 .so进程跑起来后完整的虚拟地址空间布局(32/64 位各段怎么排、典型地址范围、以及"看地址秒判类型"),见 memory-layout。
前四步是 g++ main.cpp -o cpu_demo 一条命令默默替你做完的;第五步在你敲 ./cpu_demo 时发生。下面逐段拆开。
一、四个编译阶段与中间文件
g++(或 gcc)是个"驱动器",按需依次调用 cpp → cc1plus → as → ld。用 -save-temps 可以把中间文件留下来看:
g++ -save-temps -g -O0 main.cpp -o cpu_demo
ls  # 多出 main.ii(C++预处理产物) main.s main.o
也可以让编译停在某一步:
g++ -E main.cpp -o main.i      # 只预处理(① 后停)
g++ -S main.cpp -o main.s      # 编译到汇编(② 后停)
g++ -c main.cpp -o main.o      # 汇编到目标文件(③ 后停,不链接)
g++    main.cpp -o cpu_demo    # 一路到底(④)
① 预处理 cpp —— 文本展开,还没 ELF
g++ -E main.cpp | less做的事:展开 #include <iostream> 等头文件(把整个头文件内容贴进来,所以 .i 文件动辄几万行)、替换 #define 宏、处理 #if/#ifdef 条件编译、去掉注释。产物 main.i 仍是纯文本 C++,没有任何二进制/ELF。
本仓库里
main.cpp顶部那些#include <fstream>、<thread>kkk在这一步被展开成成千上万行 STL 声明。
② 编译 cc1plus —— C++ 变汇编
g++ -S -O0 main.cpp -o main.s
grep -A15 'busy_kernel_cpu' main.s     # 看某函数编成了什么汇编
做的事:词法/语法分析、语义检查、生成中间表示、优化(受 -O 级别控制)、最后输出目标架构的汇编代码(文本)。main.s 里能看到 push %rbp、call 等 x86 指令,和 objdump 反汇编看到的很像——区别是 .s 是编译器正向生成的,objdump 是从机器码逆向还原的。
优化就发生在这一步:
-O2(make release)会把busy_user_cpu的sum += i空循环优化掉,main.s里那段就没了。
③ 汇编 as —— 生成第一个 ELF 文件
g++ -c main.cpp -o main.o
file main.o        # ELF 64-bit LSB relocatable, x86-64, not stripped
readelf -h main.o  # Type: REL (Relocatable file)
做的事:把汇编文本翻译成机器码,打包成 目标文件 .o——这是链条上第一个 ELF 文件,类型是 REL(可重定位)。
.o 的特点(用 ELF 工具看):
readelf -S main.o     # 有 .text/.data/.bss/.rodata,但地址栏基本是 0(还没定位)
nm -C main.o          # 看符号:T=本文件定义的函数, U=未定义(要外部提供)
readelf -r main.o # 重定位表:标记"这里有个地址/符号,链接时来填"关键理解:.o 里的地址还没确定(.text 起始地址是 0),对外部符号(如 std::ofstream::write、printf)只留了 U(undefined)记号和重定位项,等着链接阶段来填。这就是"可重定位"的含义。
④ 链接 ld —— 合并、重定位,生成可执行文件
g++ main.cpp -o cpu_demo       # 内部调 ld,还自动带上 CRT 启动代码和默认库
file cpu_demo                  # ELF ... pie executable, dynamically linked
readelf -h cpu_demo            # Type: DYN(PIE) 或 EXEC
链接器做三件核心事:
- 合并 section:把多个
.o(和静态库.a)里同名的.text拼到一起、.data拼一起…… - 符号解析(symbol resolution):把每个
U未定义符号,在其他.o/库里找到定义并绑定。找不到就报经典的undefined reference to ...(用 nm 的nm -u排查)。 - 重定位(relocation):符号地址确定后,回填所有重定位项里那些"待填的地址"。
还会自动加入你没写的东西:
- CRT 启动代码(
crt1.o/crti.o/crtn.o):提供真正的入口_start,它做完初始化后才调用你的main。所以readelf -h里Entry point指向的是_start不是main。 - 默认库:
libstdc++、libc、(用了线程则)libpthread等,以动态链接方式记为依赖(readelf -d cpu_demo | grep NEEDED)。
下面把最容易含糊的两步——合并和重定位——拆开讲透。
④.1 什么叫"合并 section"
每个 .o 里都有自己的 .text/.data/.bss,而且各自的地址都从 0 开始编号(因为编译单个 .cpp 时,编译器根本不知道最终会和谁链在一起、自己会被放到哪)。链接器要做的第一步,就是把所有 .o 的同名 section 首尾相接拼成一大段,并给每段分配最终地址:

要点:
- 按 section 类型归类拼接:所有
.text拼一起、所有.data拼一起、所有.bss拼一起——这样最终才能按权限打包成 段(Segment)(代码段 R+X、数据段 R+W)。 - 拼接后每段拿到确定的虚拟地址:比如
main.o的.text可能被放到0x4019a0,util.o的.text紧随其后。一旦地址定了,下一步"重定位"才有真实数值可填。 - 静态库
.a本质是一堆.o的打包,链接器只挑出用到的那些.o成员参与合并(不是整个库都拷进来)。
可以亲眼看合并前后 .text 的地址变化:
readelf -S main.o    | grep '\.text'   # .o 里 .text 的 Address 是 0(未定位)
readelf -S cpu_demo  | grep '\.text'   # 可执行里 .text 有了真实地址(如 0x4019a0)
④.2 什么是"可重定位"、如何重定位
可重定位(relocatable) 的意思是:.o 里凡是"引用了一个现在还不知道最终地址的符号"的地方,编译器都没有把死地址写进去,而是留了一个占位 + 一条重定位记录(relocation entry),告诉链接器:"等你定了地址,回来把这个位置填上"。
为什么编译器填不了?因为编译 main.cpp 时:
- 它调用的
printf/std::ofstream::write在别的.o/库里,地址未知; - 甚至它自己的函数
main,最终会被放到哪个地址也还没定(见 ④.1,地址是链接时才分配的)。
所以编译器在 .o 里对这些引用先填 0(或一个临时值),并在 .rela.text/.rela.data 等重定位表里记一条。看这张表:
readelf -r main.oRelocation section '.rela.text' at offset ...:
Offset Type Symbol's Name + Addend
000000000012 R_X86_64_PLT32 printf - 4 ← “.text 偏移 0x12 处,引用了 printf”
00000000001f R_X86_64_PC32 _ZSt4cout - 4 ← 引用了 std::cout
...每条重定位项 = (在哪填 Offset, 填什么符号 Symbol, 怎么算 Type/Addend)。
重定位的过程(链接器第③步):
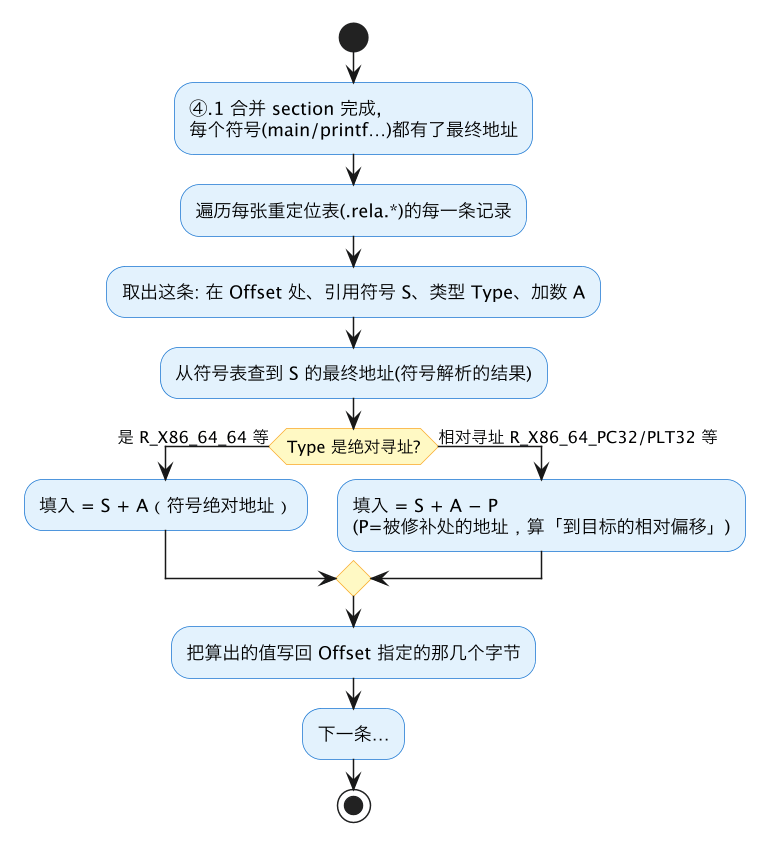
用一句话概括:重定位 = 链接器拿着"符号的最终地址",按每条重定位记录的公式,把 .o 里那些先前留空的引用位置逐个填上真实地址/偏移。
两类最常见的重定位方式:
| 类型 | 填入的值 | 用在哪 |
|---|---|---|
绝对重定位(如 R_X86_64_64) | S + A(符号的绝对地址) | 非 PIE、数据里存函数指针等 |
相对重定位(如 R_X86_64_PC32) | S + A − P(相对当前指令的偏移) | call/jmp 指令、PIE 代码——因为算的是"相对位置",整个程序换个基址加载也不用改,这正是 PIE 位置无关的基础 |
补充:调用动态库函数(如
printf)的重定位不在链接期直接填死地址,而是指向 PLT/GOT(见第六节),真实地址推迟到运行时由ld.so填——但"留占位 + 重定位记录"的机制是一样的,只是填的对象从"直接地址"变成"GOT 表项"。
小结这两步的关系:先合并(④.1)让每个符号有确定地址 → 再重定位(④.2)把引用这些符号的地方填上。缺了合并,重定位没有真实地址可填;缺了重定位,合并出来的代码里全是指向 0 的坏引用。
二、静态链接 vs 动态链接(链接阶段的两条路)
同样是第④步,链接器可以走两条路:
| 动态链接(默认) | 静态链接(-static) | |
|---|---|---|
| 库代码去向 | 不拷进可执行文件,只记"我需要 libc.so.6" | 把库里用到的代码整段拷进可执行文件 |
| 文件大小 | 小 | 大(把 libc 等打包进来) |
| file 显示 | dynamically linked | statically linked |
| 运行时 | 靠 ld.so 加载 .so | 无外部依赖,直接跑 |
| 关键 ELF 结构 | 有 .interp/.dynamic/.plt/.got | 无这些动态节 |
| 升级库 | 换 .so 即可,程序不用重编 | 必须重新编译链接 |
g++ main.cpp -o demo_dyn                 # 动态(默认)
g++ -static main.cpp -o demo_static      # 静态
ls -lh demo_dyn demo_static              # static 大很多
file demo_dyn demo_static
readelf -d demo_dyn | grep NEEDED        # 有 NEEDED 依赖
readelf -d demo_static                   # 基本没有动态节
ldd demo_static                          # "not a dynamic executable"
权衡:动态省内存(多进程共享同一份
.so)、易升级(修 libc 漏洞不用重编所有程序);静态部署简单(无依赖)、启动略快,但体积大、库有漏洞要全量重编。容器时代静态链接(或 musl 静态)又流行起来,因为镜像干净、无依赖地狱。
三、可执行文件的 ELF 结构(为运行做的准备)
链接产物 cpu_demo 已经有了完整的运行视角结构。回顾 elf-format 的两种视角,运行时靠的是 Program Header(段/Segment):
readelf -l cpu_demo关键段:
| Segment | 作用 |
|---|---|
INTERP | 存动态链接器路径 /lib64/ld-linux-x86-64.so.2——内核加载时先把控制权交给它 |
LOAD(R E) | 代码段:映射 .text/.rodata,只读可执行 |
LOAD(RW) | 数据段:映射 .data/.bss,可读写 |
DYNAMIC | 动态链接信息(依赖哪些库、符号表位置、重定位表)——ld.so 的工作清单 |
GNU_STACK | 标记栈是否可执行(安全相关,通常不可执行) |
.interp 里的路径可以直接看:
readelf -p .interp cpu_demo # /lib64/ld-linux-x86-64.so.2四、运行时:./cpu_demo 发生了什么
敲下 ./cpu_demo 后,大致这样(动态链接程序):
① shell 调 fork() + execve("./cpu_demo")
② 内核检查 ELF 魔数/架构,读 Program Header
③ 内核按 LOAD 段用 mmap 把代码段/数据段映射进新进程的虚拟地址空间
④ 内核发现有 INTERP 段 → 不直接跳 _start,而是先加载 .interp 指定的动态链接器 ld.so,把控制权交给它
⑤ ld.so 接手:
     - 读可执行文件的 .dynamic,列出所有 NEEDED 的 .so
     - 按搜索顺序找到这些 .so,逐个 mmap 映射进地址空间(递归:.so 还依赖别的 .so)
     - 做重定位:回填 .got(全局偏移表)里外部符号的真实地址
     - 处理 PLT(过程链接表),视配置做延迟绑定(lazy binding)
⑥ ld.so 跳到可执行文件的 _start(CRT 启动代码)
⑦ _start 初始化 C 运行时(全局构造、TLS、argc/argv/环境变量)后 call main
⑧ main 开始跑你的代码 —— cpu_demo 打印菜单、起线程……
用工具观察这个过程:
strace -f ./cpu_demo 2>&1 | head -40    # 看 execve、mmap 一堆 .so、openat libstdc++...
LD_DEBUG=libs ./cpu_demo                # ld.so 打印它查找/加载每个库的详细过程
LD_DEBUG=help ./cpu_demo                # 看 LD_DEBUG 支持哪些类别
strace 里能清楚看到:先
execve,然后openat/mmap加载ld-linux、libstdc++.so.6、libc.so.6——这就是第⑤步动态链接器在干活(见 strace)。
五、动态库如何被找到(搜索顺序)
第⑤步"找到这些 .so",ld.so 按固定优先级搜索,这也是排查"找不到库"的排查顺序:
DT_RPATH(旧,已不推荐)—— 编进可执行文件的路径LD_LIBRARY_PATH环境变量 —— 临时指定/调试用,生产慎用DT_RUNPATH—— 编进文件的路径(比 RPATH 新,-Wl,-rpath设置)/etc/ld.so.cache——ldconfig根据/etc/ld.so.conf(.d)生成的缓存(主力)- 默认目录
/lib、/usr/lib、/lib64、/usr/lib64
ldd cpu_demo                     # 看每个库最终解析到哪个路径(⚠️ 会执行程序,见 ldd.md 安全警告)
readelf -d cpu_demo | grep -E 'NEEDED|RPATH|RUNPATH'   # 安全:只读依赖和 rpath
ldconfig -p | grep libstdc++     # 看缓存里注册的库
LD_DEBUG=libs ./cpu_demo 2>&1 | grep -i 'trying\|found'   # 看实际查找轨迹
排查 error while loading shared libraries: xxx.so: cannot open shared object:
ldd/readelf -d看是哪个库not found;- 库在非标准路径 → 加进
/etc/ld.so.conf.d/*.conf后ldconfig,或临时export LD_LIBRARY_PATH=...; - 版本号对不上(要
.so.6只有.so.5)→ 装对应版本。
(详见 ldd。)
六、PLT / GOT 与延迟绑定(动态调用的机制)
动态库函数的地址在运行时才知道,程序里怎么调用一个"编译时还不知道在哪"的函数?靠 PLT + GOT 两张表(在 elf-format 提过):
- GOT(
.got/.got.plt,全局偏移表):存外部符号的真实地址,由ld.so在加载/首次调用时回填。 - PLT(
.plt,过程链接表):一小段跳板代码。你的代码call printf@plt实际跳到 PLT 桩,PLT 通过 GOT 找到真实地址。
延迟绑定(lazy binding):默认情况下,一个库函数第一次被调用时才由 ld.so 解析真实地址并填进 GOT(之后直接走 GOT,不再解析)。好处是启动快(没被调到的函数不解析)。
objdump -d -j .plt cpu_demo      # 看 PLT 跳板
readelf -r cpu_demo              # 看 .rela.plt(哪些 GOT 项待绑定)
objdump -R cpu_demo # 动态重定位项(GOT 条目 → 符号)安全加固相关:-Wl,-z,now(启动时全部绑定,配合 -z relro 让 GOT 只读,防 GOT 覆写攻击)会关闭延迟绑定;LD_BIND_NOW=1 ./cpu_demo 也能强制启动时全绑定。
七、结合本仓库:完整走一遍
cd performance_profile
# ① 保留所有中间文件,观察四阶段产物
g++ -save-temps -g -O0 main.cpp -o cpu_demo
ls main.ii main.s main.o cpu_demo         # 预处理/汇编/目标/可执行
# ② 每个文件的 ELF 身份
file main.o cpu_demo                       # REL 目标 vs DYN 可执行
readelf -h main.o | grep Type              # REL
readelf -h cpu_demo | grep Type            # DYN(PIE)
# ③ 目标文件里的未定义符号(等链接来填)
nm -C main.o | grep ' U ' | head           # U printf / ofstream::write / pthread...
# ④ 可执行文件的运行视角结构
readelf -l cpu_demo | grep -E 'INTERP|LOAD|DYNAMIC'
readelf -p .interp cpu_demo                # 动态链接器路径
readelf -d cpu_demo | grep NEEDED          # 依赖 libstdc++/libc/libpthread
# ⑤ 运行时加载过程
LD_DEBUG=libs ./cpu_demo                    # ld.so 查找/加载库的轨迹(选个场景快速退出)
strace -f -e trace=execve,openat,mmap ./cpu_demo 2>&1 | head -30
⚠️ 平台提醒:
.interp、ld-linux、PLT/GOT 延迟绑定、LD_DEBUG/ldconfig这套是 Linux + glibc + GNU binutils 的机制。macOS 用的是 Mach-O 格式和dyld,命令和结构都不同。要完整体验请在 Linux 上做(和本仓库其他文档一致)。
八、一句话总结
.cpp 经 预处理(.i)→ 编译(.s)→ 汇编(.o,第一个 ELF)→ 链接(可执行 ELF) 四步落地;运行时内核 mmap 映射 LOAD 段、把控制交给 .interp 指定的 动态链接器,由它按搜索顺序加载 .so、通过 GOT/PLT 做(延迟)重定位,最后经 CRT 的 _start 才进 main。每一步都能用 readelf/nm/objdump/ldd/strace/LD_DEBUG 看得见。
相关:ELF 格式基础 elf-format;逐个工具 readelf / objdump / nm / ldd / misc;符号分离 symbol-separation。