页表转换:虚拟地址到物理地址的完整翻译过程
虚拟内存让进程拥有独立地址空间,页表转换是它的关键机制。本篇从原理到硬件实现、再到 OS 落地,讲完虚拟地址如何翻译成物理地址,含实际案例、性能优化与排障。
一、为什么需要虚拟地址
在没有虚拟内存的时代,程序直接使用物理地址,会带来三个严重问题:
- 地址空间冲突:多个程序共享同一物理地址空间,一个程序的内存修改会影响其他程序
- 内存碎片严重:程序需要连续的物理内存,导致大量内存碎片无法被利用
- 无法保护内存:程序可以随意访问任意物理内存,安全性极差,恶意程序可以轻易读取或修改其他进程的数据
虚拟内存完美解决了这些问题:
- 地址隔离:每个进程拥有独立的虚拟地址空间,进程之间的内存互相不可见
- 物理内存分散分配:虚拟地址可以映射到任意物理页帧,不需要连续的物理内存
- 内存保护:通过页表的权限位控制内存访问(只读、读写、内核态仅访问等)
- 内存过载分配:可以让虚拟地址空间大于物理内存,通过交换分区实现内存过载
二、基本概念:页、页表与地址结构
2.1 页与页帧
虚拟内存和物理内存都被划分为固定大小的页(Page):
- 虚拟页(Virtual Page, VP):虚拟地址空间被划分为多个虚拟页,每个虚拟页的大小通常为4KB(x86-64默认)
- 物理页帧(Physical Page Frame, PPF):物理内存被划分为多个物理页帧,每个物理页帧的大小与虚拟页一致
- 页大小:除了标准4KB页,还有2MB、1GB等大页尺寸,用于减少TLB压力
虚拟地址到物理地址的转换以页为单位:同一个虚拟页可以映射到任意物理页帧,而且不同的虚拟页可以映射到同一个物理页帧(写时复制、共享内存等场景)。
2.2 页表
页表是内核为每个进程维护的虚拟页到物理页帧的映射关系表。每个进程有自己独立的页表,当进程切换时,操作系统会切换页表根寄存器(x86-64的CR3寄存器)。
48位虚拟地址按4KB页划分有 2^36 个虚拟页,扁平页表要存 2^36 个 8 字节表项 ≈ 32GB,完全不现实。所以现代 OS 用多级页表,只分配实际用到的表项。
2.3 虚拟地址结构
对于x86-64的48位虚拟地址,被划分为多个部分:
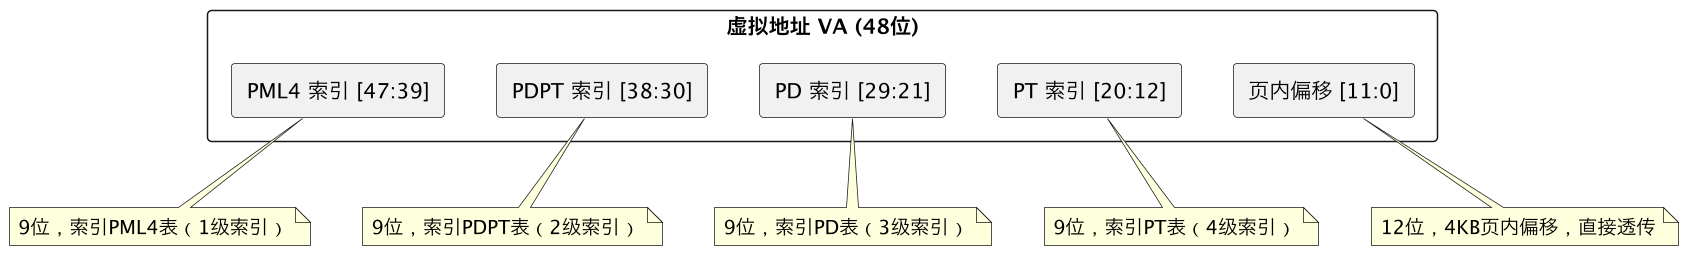
三、多级页表结构
x86-64使用四级页表结构,从最高级到最低级依次是:
3.1 四级表一览
x86-64 四级页表逐级向下:PML4(最高级,CR3 指向,每进程一张,512 项各指向一张 PDPT)→ PDPT(512 项各指向一张 PD)→ PD(512 项各指向一张 PT;PS 位为 1 时该项直接是 2MB 大页)→ PT(512 项,每项对应一个 4KB 物理页帧)。每张表都是 512 × 8B = 4KB,恰好占一个物理页。
3.5 页表项格式
每个页表项都是8字节(64位),x86-64的页表项格式如下:
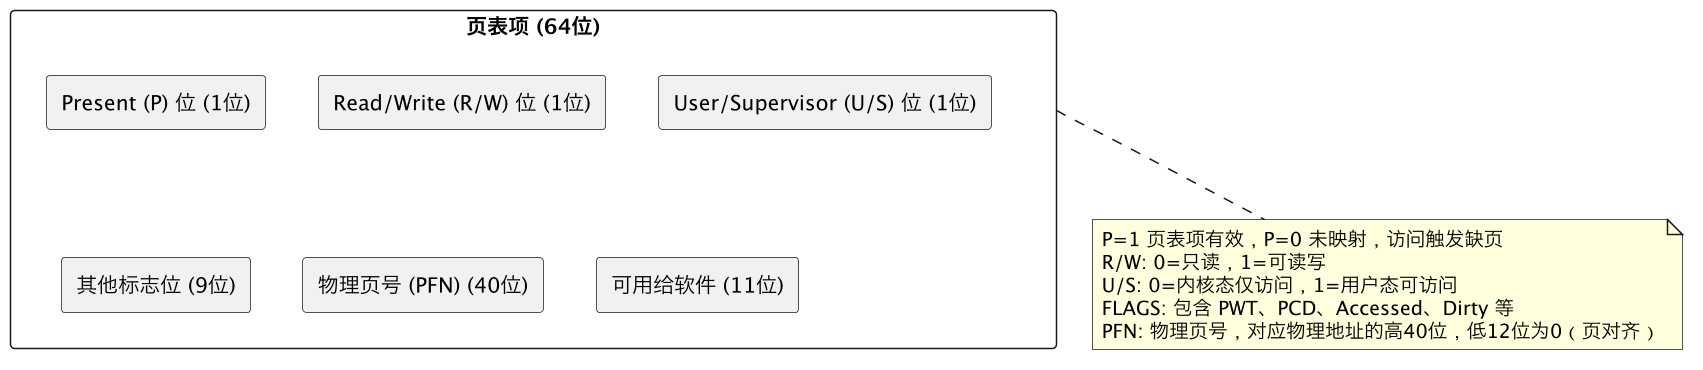
关键标志位详解:
| 标志位 | 名称 | 含义 |
|---|---|---|
| P | Present | 页表项是否有效,0表示该虚拟页未映射,访问会触发缺页异常 |
| R/W | Read/Write | 页是否可写,0表示只读,1表示可读写 |
| U/S | User/Supervisor | 访问权限,0表示仅内核态可访问,1表示用户态也可访问 |
| PWT | Page Write Through | 写穿透模式,0表示写回模式,1表示写透模式 |
| PCD | Page Cache Disable | 禁用页缓存,0表示启用缓存,1表示禁用 |
| A | Accessed | 页是否被访问过,由CPU在访问时设置,用于页面置换算法 |
| D | Dirty | 页是否被修改过,由CPU在写入时设置,用于写时复制和页面置换 |
四、完整的页表转换流程(Page Walk)
当CPU需要访问一个虚拟地址时,会通过以下步骤完成翻译,这个过程由MMU(内存管理单元)硬件自动完成:
步骤1~2:取根表并索引
CPU 从 CR3 寄存器拿到当前进程 PML4 表物理地址(进程切换时由 OS 加载),用 VA[47:39] 作索引读取表项:
PML4 表项地址 = CR3 + (PML4 索引 × 8)例:VA[47:39]=0x123 → 表项地址 = CR3 + 0x918。
步骤3~4:索引 PDPT、PD 表
若上一级表项有效(Present=1),取出其指向的下一张表物理地址,再用 VA 对应位段索引取表项:
PDPT 表项地址 = PML4 表项中的 PDPT 物理地址 + (PDPT 索引 × 8)
PD   表项地址 = PDPT 表项中的 PD 物理地址 + (PD 索引 × 8)
步骤5~6:索引 PT 表(或直接用大页)并拼出物理地址
PD 表项有效后分两种:PS=0 → 取 PT 表物理地址、用 VA[20:12] 索引读 PT 表项;PS=1 → 该项直接是 2MB 大页,跳过 PT 表。
最后拼接物理地址(PFN 左移页偏移位数,再或上页内偏移):
4KB 页:   物理地址 = (PT 表项 PFN << 12) | VA[11:0]
2MB 大页: 物理地址 = (PD 表项 PFN << 21) | VA[20:0]
1GB 大页: 物理地址 = (PDPT 表项 PFN << 30) | VA[29:0]
完整流程示意图
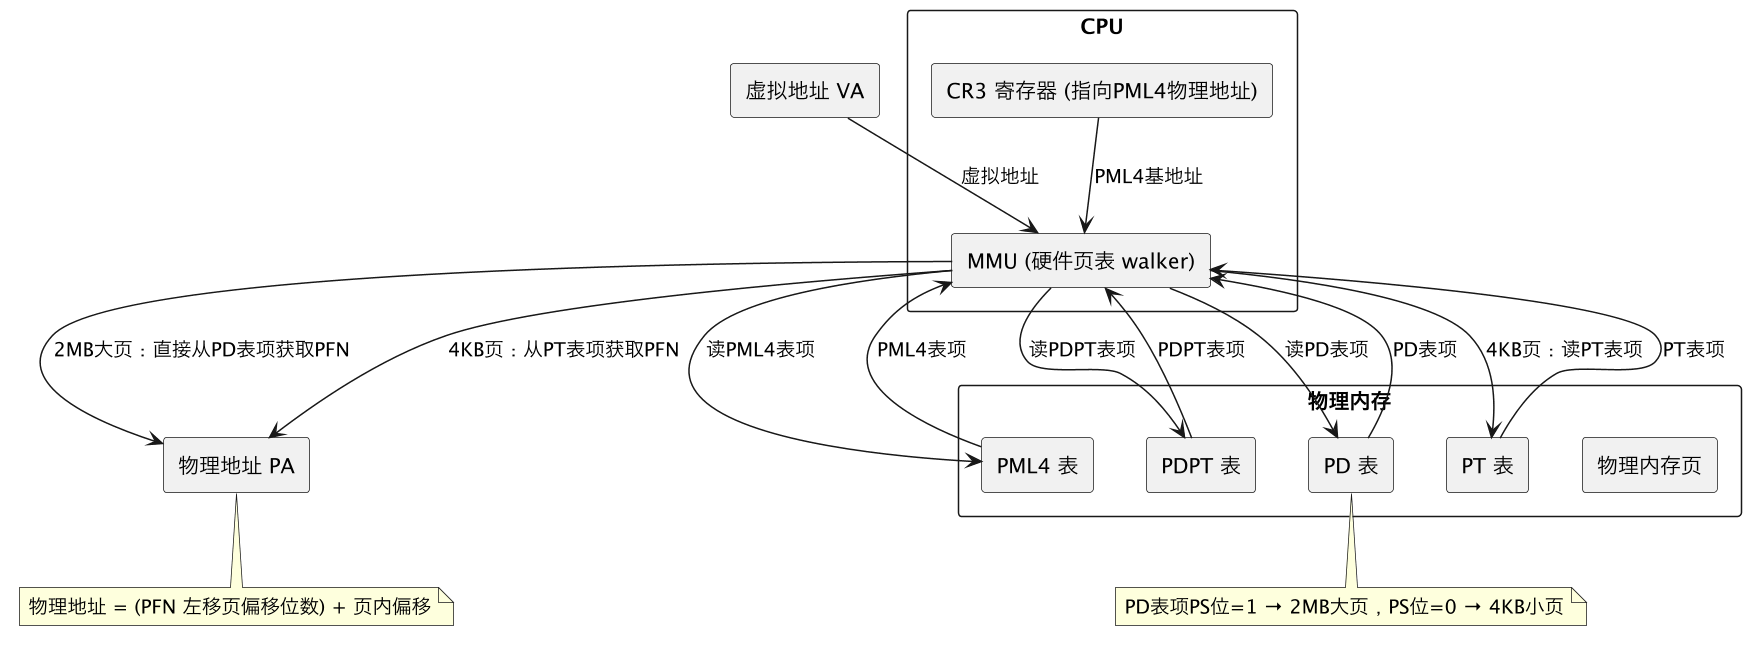
完整流程一句话:CR3 取 PML4 根 → 四级逐级索引取表项(任一级 Present=0 即触发缺页,交内核处理)→ 大页提前截断或 PT 拿到 PFN → 左移拼接页内偏移得到物理地址。
五、TLB:加速页表转换的缓存
每次地址翻译都需要访问四级页表,这意味着每次访存都要额外进行4次内存访问,这会严重降低性能。为了解决这个问题,CPU 引入了 TLB(Translation Lookaside Buffer,翻译后备缓冲)。
5.1 TLB的工作原理
TLB 是 CPU 内部缓存"VPN → PFN"映射的高速缓存(详见 tlb):命中时直接拼出物理地址,约 1 个周期;miss 时触发 Page Walk(几十~上百周期),并把结果填进 TLB。
典型大小:L1 dTLB ~64-128 条目、L1 iTLB ~32-64、L2 TLB(STLB)~512-2048(核心簇共享)、L3 TLB ~4096-8192(全核共享)——层次越高容量越大、延迟越高。
5.2 TLB 刷新
页表变化后必须刷新 TLB,否则 CPU 会用旧映射:进程切换靠换 CR3 自动整表刷新;改单个页表项用 x86 的 invlpg 失效对应条目;全局刷新用 tlbflush。TLB 缓存的是完整 VPN→PFN 映射而非页表项——命中时完全不碰内存页表,这就是它快的原因。
六、大页(Huge Pages)
标准的4KB页会导致TLB条目覆盖的地址范围很小,对于大数据集的应用(如数据库、科学计算),很容易出现TLB thrashing(TLB抖动)。大页技术通过增大页的大小,来减少需要的TLB条目数量,从而提高TLB命中率。
6.1 常见的大页类型
| 页大小 | 偏移位数 | 页号位数 | 一条TLB条目覆盖 | 优势 |
|---|---|---|---|---|
| 4KB | 12 | 36 | 4KB | 标准页,灵活,兼容性好 |
| 2MB | 21 | 27 | 2MB | 常见大页,平衡性能和内存 |
| 1GB | 30 | 18 | 1GB | 超大页,适合超大内存应用,如数据库服务器 |
6.2 大页的优势与代价
优势:一条 TLB 条目覆盖 512 倍地址范围(减 TLB 压力);2MB 大页只需三级页表遍历、1GB 只需两级(减 Page Walk 开销)。
代价:需要连续物理内存(运行久了易碎片);fork 时写时复制要复制更大块(开销增大);需要手动配置管理,不像标准页自动分配。
6.4 大页的实际使用
查看当前大页配置:
cat /proc/meminfo | grep -i huge开启透明大页(THP):
# 开启透明大页(默认通常是madvise模式)
echo always > /sys/kernel/mm/transparent_hugepage/enabled
# 仅对使用madvise的进程启用大页
echo madvise > /sys/kernel/mm/transparent_hugepage/enabled
# 关闭透明大页
echo never > /sys/kernel/mm/transparent_hugepage/enabled使用显式大页:
# 预留10个2MB大页
echo 10 > /sys/kernel/mm/hugepages/hugepages-2048kB/nr_hugepages
# 查看预留的大页
cat /sys/kernel/mm/hugepages/hugepages-2048kB/nr_hugepages
七、页表相关的异常
7.1 缺页异常(Page Fault)
当访问一个Present位为0的页表项时,CPU会触发缺页异常。缺页异常有多种类型:
| 缺页类型 | 触发原因 |
|---|---|
| 读缺页 | 访问未映射的虚拟页 |
| 写缺页 | 尝试写只读页 |
| 权限缺页 | 用户态访问内核态保护的页 |
| 大页缺页 | 访问大页时未映射 |
操作系统在缺页处理程序中:为虚拟页分配物理页帧 → 更新页表项(置 Present=1 与权限)→ 重新执行触发异常的指令。
Minor Fault vs Major Fault:
- Minor Fault:物理页已经在内存中,只是需要更新页表项,比如写时复制、共享内存,开销很小
- Major Fault:物理页需要从磁盘加载,比如交换分区、mmap的文件映射,开销很大
7.2 TLB Miss异常
当TLB中没有对应的VPN映射时,CPU会自动触发Page Walk,不需要软件干预。但在某些情况下(如进程切换、修改页表项),操作系统需要手动刷新TLB。
7.3 保护异常
当访问权限不匹配时,比如用户态尝试访问内核态的页,会触发保护异常,由操作系统内核处理,通常会终止进程并输出段错误(Segmentation Fault)。
八、实际案例与性能优化
8.1 案例:TLB thrashing导致性能暴跌
假设有一个程序,遍历一个很大的数组,步长为4KB(刚好一个页),那么每次访问都需要一个新的TLB条目。如果数组大小超过TLB的覆盖范围,就会出现TLB thrashing,性能暴跌。
解决方案:
- 使用大页,将页大小改为2MB,一条TLB条目可以覆盖512倍的地址范围
- 优化访问模式,让数组的访问步长更小,或者使用连续的内存块
- 使用更大的TLB,比如启用1GB大页
8.2 案例:页表内存开销
四级表中每张表都是 512 项 × 8B = 4KB,可逐级映射 512、512²、512³、512⁴ 个虚拟页。以占用 1GB 虚拟地址空间的进程为例:需要 1GB/4KB = 262,144 个虚拟页 → 512 张 PT 表(512×4KB=2MB)+ 1 张 PD、1 张 PDPT、1 张 PML4(各 4KB)——总页表开销约 2MB。
九、与其他文档的关系
- 前置:cache-organization(缓存层次)、tlb(TLB 详解)、mm-struct(进程地址空间)
- 关联:memory-layout(地址空间布局)、context-switch(切换时的 TLB 刷新)
- 工具:perf(TLB 事件)、procfs(pagemap/smaps)、numactl(大页 NUMA 绑定)
十、一句话总结
页表转换是虚拟内存的核心机制,通过多级页表将虚拟地址翻译成物理地址,解决了地址空间隔离、内存碎片和内存保护的问题。完整的页表遍历需要访问四级页表,TLB缓存最近使用的映射关系来加速翻译。大页技术通过增大页大小减少TLB压力,适用于大数据集应用。当页表项无效时,会触发缺页异常,由操作系统完成页的分配和映射。理解页表转换机制对于性能优化、排障和内核开发都至关重要。