mmap 详解 —— 把文件/内存"映射"进地址空间的万能接口
mmap是 Linux 上最被低估、又用得最广的系统调用之一:malloc的大块内存、.so动态库的加载、execve装入可执行文件、共享内存 IPC、零拷贝读文件、perf 的采样环形缓冲区——背后全是mmap。本篇从内核视角讲清mmap到底做了什么、它的各种"场景组合"(文件/匿名 × 私有/共享)、page fault 惰性映射的机制、和read/write的本质区别、以及性能上的坑与调优。
相关:进程地址空间里"mmap 区"在哪见 memory-layout;
.so/可执行文件怎么被 mmap 进来见 compile-link-load;缺页与 CoW 的页表机制见 process-creation §二;TLB/page walk 见 tlb。
零、一句话认知:mmap = 在页表里建一条"虚拟地址 ↔ 后备存储"的映射
mmap 不"读数据"、也不"分配物理内存"。它只做一件事:在进程的页表里登记一段虚拟地址区间(VMA),并记录这段地址"背后"是什么——可能是一个文件,也可能什么都不是(匿名)。真正的物理内存和数据搬运,统统推迟到你第一次访问那段地址、触发缺页异常时才发生(惰性/lazy)。
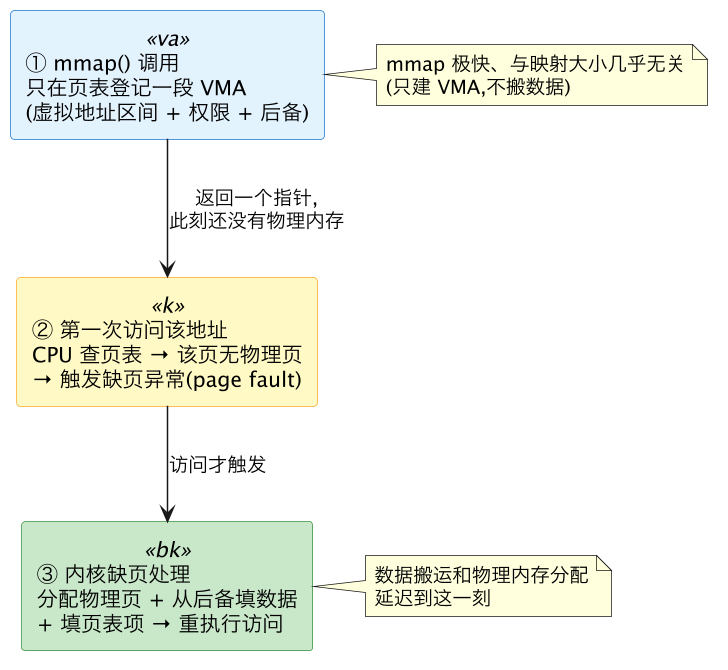
核心记忆:
mmap返回时你手里只有一个"承诺"(一段合法的虚拟地址),物理页一个都还没有。这也是为什么mmap一块 1GB 内存瞬间就返回——它没真占 1GB。
澄清:"登记进页表"到底改了哪一层?——VMA 与四级页表要分清
前面说"mmap 在页表里登记"是个方便的简化。要精确,得把进程的地址空间描述分成两层,mmap 只动上面那层:
| 层次 | 是什么 | mmap 时 | 缺页时 |
|---|---|---|---|
VMA(vm_area_struct) | 内核里描述"这段虚拟地址区间是什么"的软件结构(起止地址、权限、后备文件/匿名) | mmap 只做这件事:往进程的 mm_struct 里挂一个新 VMA | 不变 |
| 多级页表(PML4→PDPT→PD→PT 的 PTE) | CPU/MMU 真正用来做 VA→PA 翻译的硬件页表 | 一个 PTE 都不填(除非用 MAP_POPULATE) | 缺页处理时逐级建表、填最后一级 PTE |
所以更准确的说法是:mmap 登记的是 VMA(软件层的"这段地址归我了"),真正的页表项(PTE)要等第一次访问、触发缺页时,内核才顺着四级页表逐级把中间级子表和最后一级 PTE 补上。 这正是"惰性"的技术含义。
关于"页表是每个进程一份吗"——是的,每个进程独立一棵四级页表树:
- 内核为每个进程各自维护一棵页表树(根是 PML4 表),CPU 的
CR3寄存器存当前进程 PML4 表的物理地址;切换进程时内核换CR3,就切到另一棵树——这就是为什么进程之间地址空间互相隔离(同一个虚拟地址0x400000在两个进程里指向不同物理页)。 - 线程则共享同一棵:同进程的线程共享
mm_struct和这棵页表树(见 thread-creation)。 mmap填的是最后一级 PTE:四级 walk 走 PML4→PDPT→PD→PT,最末级 PT 里的页表项(PTE) 才存最终的物理页号(PFN)。缺页时内核填的、mmap映射最终落地的,就是这一级 PTE;中间三级只是"为了找到 PT"的索引表,按需创建(哪段地址没用到,那一枝子表根本不建,省内存)。MAP_SHARED的物理页可被多进程的 PTE 指向同一份:两个进程各自的最后一级 PTE 填同一个 PFN,于是共享同一块物理内存——这就是 §三共享映射、以及 perf「内核↔用户共享」在页表层的样子。
四级页表的完整结构(各级 9 位切分、CR3、page walk 为什么 4 次访存、TLB 如何缓存翻译结果)见 tlb §三。本篇只需记住:
mmap= 建 VMA(每进程的mm_struct里);PTE(四级页表最末级)缺页时才填;页表树每进程一棵、线程共享、CR3指根。
一、函数原型与六个参数
#include <sys/mman.h>
void *mmap(void *addr, size_t length, int prot, int flags,
           int fd, off_t offset);
int munmap(void *addr, size_t length);| 参数 | 作用 |
|---|---|
addr | 建议的起始虚拟地址,一般传 NULL 让内核自己挑(内核挑的落在 mmap 区,见 memory-layout) |
length | 映射长度(字节)。内核按页(4KB)向上取整 |
prot | 页权限:PROT_READ/PROT_WRITE/PROT_EXEC/PROT_NONE,按位或 |
flags | 最关键:映射类型。MAP_SHARED vs MAP_PRIVATE(二选一)+ MAP_ANONYMOUS/MAP_FIXED/MAP_POPULATE… |
fd | 要映射的文件描述符;匿名映射传 -1 |
offset | 从文件的哪个偏移开始映射,必须是页大小的整数倍 |
- 成功返回映射区首地址;失败返回
MAP_FAILED(即(void*)-1),并置errno。 munmap(addr, length)解除映射:拆掉 VMA、(对MAP_SHARED文件映射)把脏页刷回文件。prot受fd打开模式约束:想PROT_WRITE+MAP_SHARED,文件必须以可写方式open。
二、两个正交维度:这才是 mmap 的全部场景
mmap 的花样几乎都来自两个互相正交的选择,组合出四象限:
- 维度 A:有没有后备文件 —— 文件映射(file-backed) vs 匿名映射(anonymous,
MAP_ANONYMOUS) - 维度 B:改动是否对外可见 ——
MAP_SHARED(共享,写回文件/给别的进程看见) vsMAP_PRIVATE(私有,写触发 CoW,别人看不见)
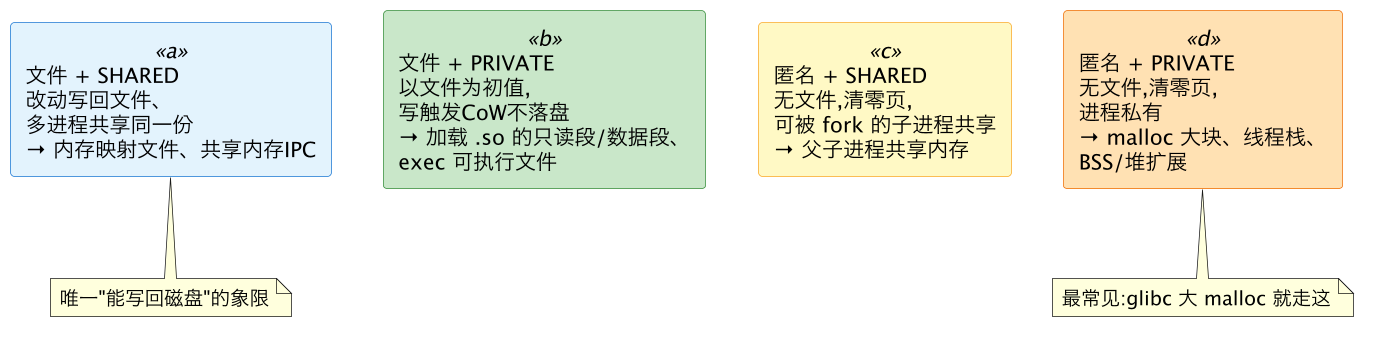
| 组合 | fd | 数据来源 | 写的后果 | 典型用途 |
|---|---|---|---|---|
文件 + MAP_SHARED | 真 fd | 文件内容 | 写回文件、其他映射同文件的进程可见 | 内存映射文件读写、共享内存(shm_open+mmap) |
文件 + MAP_PRIVATE | 真 fd | 文件内容作初值 | CoW:写触发私有副本,不落盘 | 加载 .so/可执行文件的段、只读配置 |
匿名 + MAP_SHARED | -1 | 全 0 | 父子进程间可见 | fork 前建共享内存给父子用 |
匿名 + MAP_PRIVATE | -1 | 全 0 | 进程私有 | malloc 大块、堆/BSS、线程栈 |
一句话抓住本质:
MAP_ANONYMOUS决定"数据从哪来"(文件 or 清零),MAP_SHARED/PRIVATE决定"写出去别人看不看得见 + 落不落盘"。四种组合覆盖了 Linux 里几乎一切内存的来路。
三、场景逐个拆解
3.1 匿名私有映射 —— malloc 的大块内存从这来
glibc 的 malloc 对小块用 brk 抬堆顶,对大块(默认 ≥128KB,M_MMAP_THRESHOLD)直接 mmap(MAP_ANONYMOUS|MAP_PRIVATE) 单独要一段,free 时 munmap 整段还给内核。
// 等价于 malloc 一大块(可读写、匿名、私有)
void *p = mmap(NULL, 100*1024*1024, PROT_READ|PROT_WRITE,
               MAP_PRIVATE|MAP_ANONYMOUS, -1, 0);
// 此刻还没有物理内存!第一次写某页才分配那一页(缺页)
memset(p, 0, 4096);   // 只这一页被真正分配
munmap(p, 100*1024*1024);- 为什么大块用 mmap 而非 brk:大块单独 mmap,free 能立刻
munmap把内存真正还给 OS(brk只能从顶端连续释放,中间的洞还不掉,易造成"内存已 free 但 RSS 不降")。 - 惰性分配:申请 100MB 瞬间返回,top 里 VIRT 涨 100MB 但 RES 几乎不动——真正碰到的页才计入 RSS。这正是 free/vmstat 里 VIRT ≫ RES 的常见来源(见 free)。
3.2 文件私有映射 —— 加载 .so 和可执行文件
execve 装入 ELF、ld.so 加载 .so,本质都是文件 + MAP_PRIVATE:
- 代码段(
.text)PROT_READ|PROT_EXEC:多个进程映射同一个libc.so,物理上共享同一份只读页(省内存)。 - 数据段(
.data)PROT_READ|PROT_WRITE+MAP_PRIVATE:以文件内容为初值,进程一旦写全局变量就 CoW 分裂出私有副本,各进程互不影响。
这就是为什么系统里几百个进程都链接
libc,物理内存里libc的代码段却基本只有一份——文件私有映射 + CoW 的功劳。细节见 compile-link-load。
3.3 文件共享映射 —— 内存映射文件 & 零拷贝
把文件映射进来,像访问数组一样读写文件,改动由内核异步刷回磁盘:
int fd = open("data.bin", O_RDWR);
struct stat st; fstat(fd, &st);
char *m = mmap(NULL, st.st_size, PROT_READ|PROT_WRITE,
               MAP_SHARED, fd, 0);
m[0] = 'X';                 // 直接改内存 = 改文件(异步回写)
msync(m, st.st_size, MS_SYNC);  // 需要立刻落盘就显式 msync
munmap(m, st.st_size);- 零拷贝优势:
read()要把数据从 page cache 拷到用户缓冲区;mmap 直接把 page cache 的页映射进地址空间,少一次拷贝,随机访问大文件尤其划算。 - 回写时机:
MAP_SHARED的脏页由内核 writeback 线程异步刷,或msync/munmap时刷;掉电前没刷的会丢,要持久化就msync(MS_SYNC)。
3.4 匿名共享映射 —— 父子进程共享内存
fork 之前 mmap(MAP_ANONYMOUS|MAP_SHARED),则 fork 出的子进程和父进程共享这段内存(不走 CoW,是真共享),是最轻量的父子 IPC:
int *cnt = mmap(NULL, 4096, PROT_READ|PROT_WRITE,
                MAP_SHARED|MAP_ANONYMOUS, -1, 0);
*cnt = 0;
if (fork() == 0) { (*cnt)++; _exit(0); }   // 子进程改
wait(NULL);
printf("%d\n", *cnt);   // 父进程看得到 → 1
无亲缘关系的进程要共享,用
shm_open()建一个 POSIX 共享内存对象拿到 fd,再mmap(MAP_SHARED)—— 本质是"文件共享映射",只是那个"文件"在/dev/shm里。
3.5 特殊映射:MMIO / 大页
- 设备内存(MMIO):
mmap一个设备文件(如/dev/mem、显存),得到的映射是 uncacheable 的——这正是 compiler-reordering 里volatile最初为之设计的场景。 - 大页(HugePage):
MAP_HUGETLB或映射 hugetlbfs,用 2MB/1GB 大页减少 TLB miss 和 page walk(见 tlb)。
3.6 内核↔用户共享内存:perf 的采样环形缓冲区
perf 把采样数据从内核送到用户态,用的正是 mmap——这是"应用层和内核共享同一块物理内存"的经典范例,值得单独拆开看,因为它和前面几种"用户进程之间共享"不同:这里共享的双方是内核采样代码和用户态 perf 进程。
流程是:perf_event_open() 拿到一个事件 fd 后,用户态对这个 fd 调 mmap(),内核就把它为该事件分配的一段缓冲区映射进 perf 进程的地址空间——从此内核和用户进程指向同一块物理页,读写不再需要拷贝或系统调用:
int fd = perf_event_open(&attr, pid, cpu, -1, 0);
// 对事件 fd 做 mmap:1 个元数据页 + 2^n 个数据页(必须 1+2的幂)
//   —— 内核把采样缓冲区映射进来,内核/用户从此共享这块内存
void *buf = mmap(NULL, (1 + (1<<n)) * getpagesize(),
PROT_READ|PROT_WRITE, MAP_SHARED, fd, 0);- 内核是生产者:PMU 计数器溢出触发中断,内核在中断里把一条采样记录(record)直接写进这块共享内存的
data_head处——全程不拷贝、不做系统调用,这正是 perf 开销低的根本原因。 - 用户态是消费者:perf 读
[data_tail, data_head)之间的新记录搬去perf.data,读完推进data_tail。 - 为什么用
MAP_SHARED:只有共享映射,用户态的读和内核的写才落在同一份物理页上;若用MAP_PRIVATE,内核写完就会 CoW 分裂、用户态永远看不到——这正是 §二两个维度在这里的具体体现。 - 缓冲区大小 = mmap 的页数:
perf record -m(--mmap-pages)调的就是这里 mmap 的数据页数;调大能减少"内核写太快追上用户读"导致的 LOST records(丢样本),代价是占更多内存。
完整的 ring buffer 结构(元数据页里的
data_head/data_tail、环形写入、每 CPU 一份缓冲区、libperf 封装)见 ../code/perf-internals §四。要点:perf「抓数据」的核心机制,就是本篇讲的mmap共享映射——只不过共享的对端是内核而非另一个进程。
四、mmap vs read/write —— 什么时候用哪个
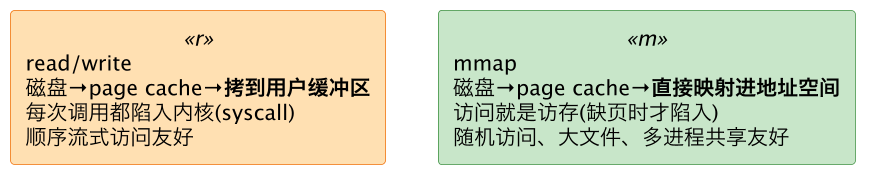
| 维度 | read/write | mmap |
|---|---|---|
| 拷贝次数 | page cache → 用户缓冲区(1 次额外拷贝) | 无额外拷贝(直接映射 page cache) |
| 触发开销 | 每次 syscall 陷入内核(见 syscall) | 只在缺页时陷入,之后是纯访存 |
| 随机访问大文件 | 每次都 lseek+read,累 | 指针随便跳,惰性加载对应页 |
| 小文件/顺序流 | 更优(无建映射/缺页开销) | 建 VMA + 缺页反而不划算 |
| 多进程共享同一文件 | 各自一份用户缓冲区 | 共享同一份 page cache 页 |
| 错误处理 | 返回值/errno,直观 | 访问越界/IO 出错是 SIGSEGV/SIGBUS(见 signals) |
选型:顺序读小文件 →
read;随机访问大文件、要零拷贝、要多进程共享 →mmap。注意 mmap 的错误以信号形式抛出(映射区超出文件真实大小再访问会SIGBUS),不像read那样返回错误码。
五、性能与坑
- 缺页开销别忽视:惰性映射意味着首次访问每页都有一次 minor fault(分配+填表)。要一次性铺满物理页、避开运行期抖动,用
MAP_POPULATE(mmap 时预填)或madvise(MADV_WILLNEED)。 madvise给内核提示访问模式:MADV_SEQUENTIAL(顺序,加大预读)、MADV_RANDOM(随机,关预读)、MADV_DONTNEED(马上释放这些页)、MADV_HUGEPAGE(透明大页)。- TLB 压力:大量小映射/大范围随机访问 → TLB miss + page walk 拖慢,考虑大页(见 tlb)。
munmap忘了 = 泄漏:VMA 一直在,虚拟地址空间和(已触碰的)物理页都不还。用valgrind//proc/$PID/maps排查(见 valgrind、memory-layout)。MAP_SHARED回写不及时:改完不msync,崩溃/掉电会丢;但每次都msync(MS_SYNC)又慢——按持久化需求权衡。SIGBUS陷阱:映射长度超过文件实际大小,访问越界那部分页触发SIGBUS(不是 SIGSEGV);文件被 truncate 后再访问也一样。
六、观测:看 mmap 真的发生了
# 1) 看进程当前所有映射:每一行就是一个 VMA(地址段/权限/后备文件)
cat /proc/$PID/maps
#   7f...  r-xp  .../libc.so.6   ← 文件私有映射(代码段,可执行)
#   7f...  rw-p  [anon]          ← 匿名私有(malloc 大块/BSS)
#   7f...  rw-s  /dev/shm/xxx    ← 共享映射(s=shared)
# 2) 用 strace 抓 mmap/munmap 调用,看参数(prot/flags/fd)
strace -e trace=mmap,munmap,mprotect,madvise -- ./app
#   mmap(NULL, 135168, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0)  ← malloc 大块
# 3) 看惰性映射造成的缺页:minor fault 计数
ps -o min_flt,maj_flt -p $PID     # min_flt=不涉磁盘的缺页(匿名/CoW), maj_flt=要读磁盘的
cat /proc/$PID/stat # 同样含 min_flt/maj_flt 字段/proc/$PID/maps里权限第 4 位p=private /s=shared,一眼分清象限;[anon]/[heap]/[stack]是匿名区,路径则是文件映射。- strace 里 glibc 大
malloc会现出mmap(...MAP_ANONYMOUS...)原形(见 strace)。 - mmap 区在地址空间里的位置、如何看地址判类型见 memory-layout。
七、和本仓库其他文档的关系
- 地址空间:memory-layout——mmap 区在虚拟地址空间的哪一段、
/proc/pid/maps怎么读。 - 加载:compile-link-load——
execve/ld.so用文件映射装入 ELF 和.so。 - CoW/页表:process-creation §二——写时复制的缺页机制,与文件私有映射同源。
- 缺页/TLB:tlb——惰性映射后每页首访的翻译与 TLB。
- 内存统计:free——VIRT≫RES、匿名页/文件页在内存账本里怎么算。
- 错误信号:signals——mmap 访问越界为何是 SIGSEGV/SIGBUS。
- 系统调用开销:syscall——mmap 建映射也是一次陷入,之后访存不再陷入的价值。
- perf/volatile 场景:perf-internals(ring buffer)、compiler-reordering(MMIO uncacheable)。
- 共享内存:shared-memory——POSIX vs System V IPC 两套接口完整对比,本质就是
mmap"文件+MAP_SHARED"场景的延伸(后备文件换成/dev/shm的 tmpfs 节点)。
八、一句话总结
mmap只在页表里登记一段"虚拟地址↔后备存储"的映射(VMA),物理内存和数据搬运全部惰性推迟到首次访问缺页时——它的一切花样来自两个正交维度:文件/匿名(数据从哪来) × SHARED/PRIVATE(写出去别人看不看得见、落不落盘),四象限覆盖了 malloc 大块、加载 .so、内存映射文件、共享内存 IPC 几乎一切内存来路;相比 read/write 它省一次拷贝、随机访问大文件和多进程共享更优,代价是缺页开销和以信号(SIGSEGV/SIGBUS)形式抛出的错误。