用 perf 初步分析多线程 + IO 混合程序
一个多线程程序同时做计算和 IO,性能有问题时该从哪查起?本文给出一套三步法:先用
perf stat做宏观体检,再按线程拆分找出 CPU 型和 IO 型线程各自的问题,最后针对异常模式深入。不要求事先知道程序瓶颈在哪——用这套方法可以逐层缩小范围,判断程序有没有明显问题。
关联:perf(perf 命令参考)、perf-advanced(
perf lock/perf sched/perf c2c)、perf-sched(perf sched完全指南)、pidstat(-t按线程拆分)、context-switch(上下文切换机制)、pmu(PMU 采样原理)、compare(perf vs 传统工具定位对比)
零、一句话结论
三步法:perf stat 四字段定类型(CPU 型 vs IO 型 vs 混合型)→ pidstat -t + perf record 拆线程定位责任人 → 按异常模式选择深入工具(perf record 抓热点 / perf lock 看锁 / perf sched 看调度 / strace 看 IO syscall),15 分钟内判断多线程+IO 程序有没有明显性能问题。
一、多线程 + IO 程序长什么样
在实际场景中,大多数"有 IO 的多线程程序"都符合以下模式:
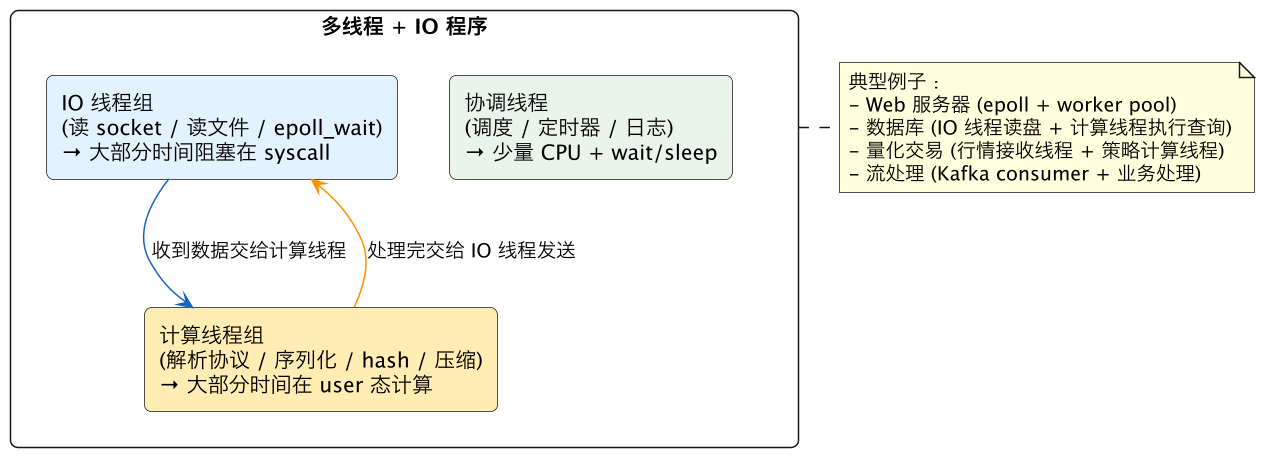
核心矛盾:IO 线程"在等"(阻塞在内核态),CPU 线程"在算"(烧用户态),两类线程的行为完全不同,不能用同一个指标一刀切。这也是为什么"多线程+IO"的分析比纯计算或纯 IO 程序复杂——你得分清谁在忙和谁在等。
二、三步分析法总览
perf stat -p <PID> -- sleep 10          ──→  第一步:宏观体检(10 秒)
      │
      ├─── 问题出在哪类线程?
      │
pidstat -t -u -w -p <PID> 1            ──→  第二步:按线程拆分
      │
      ├─── CPU 型线程 → perf record 抓热点
      ├─── IO 型线程  → strace 看阻塞在哪个 syscall
      ├─── 锁竞争     → perf lock
      ├─── 调度不均衡  → perf sched
      └─── 伪共享     → perf c2c
──→ 第三步:按异常模式深入快速启动命令(复制粘贴即用):
# 第一步:宏观体检(10 秒)
perf stat -p <PID> -- sleep 10 2>&1 | tee perf_stat.log
# 第二步:按线程拆分(5 秒采样,观察足够)
pidstat -t -u -w -p <PID> 1
下文逐步展开每一条命令输出怎么读、怎么判断。
三、第一步:perf stat 宏观体检
3.1 最简四字段:定位程序类型
先跑最简约的 perf stat,只看四个指标:
perf stat -p <PID> \
  -e task-clock,context-switches,cpu-migrations,page-faults \
  -e cycles:u,cycles:k,instructions:u,instructions:k \
-- sleep 10| 指标 | 作用 | 正常 / 异常信号 |
|---|---|---|
task-clock | 该进程累计消耗了多少 CPU 时间(ms) | task-clock / (elapsed × 核数) → 实际 CPU 利用率 |
context-switches | 上下文切换总次数 | < 100/s 正常;> 1000/s → 调度过热 |
cycles:u / cycles:k | 用户态 vs 内核态 cycle 占比 | cycles:k / (cycles:u + cycles:k) = 内核开销比例 |
instructions:u / instructions:k | 用户态 vs 内核态指令数 | 结合 cycles 算 IPC,分态对比 |
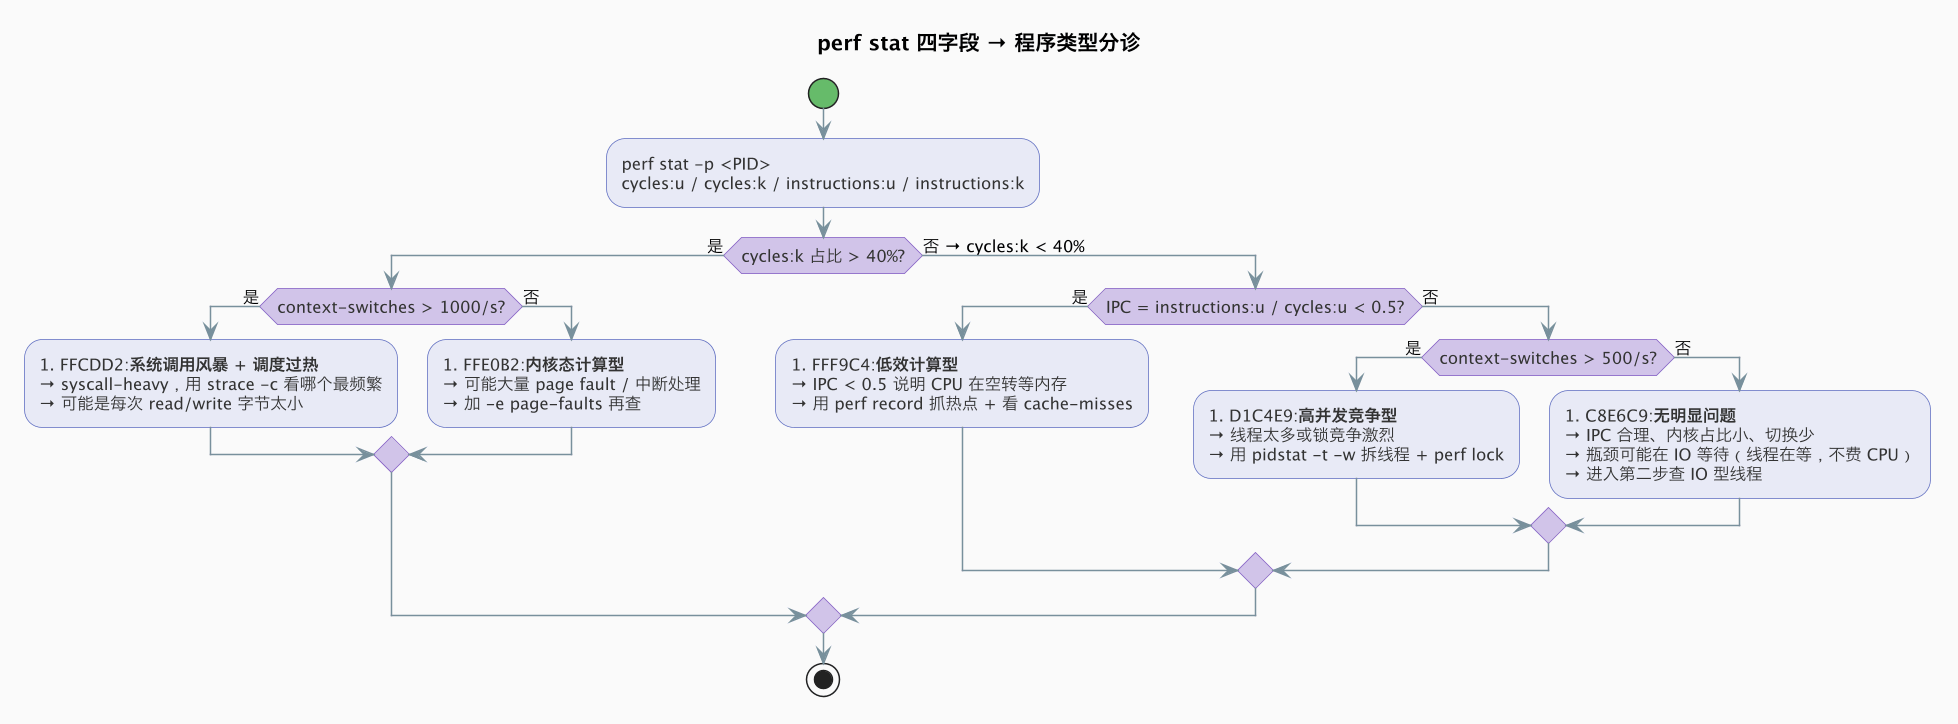
3.2 四字段快速分诊
拿到四字段数据后,对照下表判断程序类型:
3.3 扩展事件:进一步确认方向
如果四字段给出了大致方向,再加一组事件确认:
| 追加目的 | 追加事件 | 正常值 | 异常含义 |
|---|---|---|---|
| 确认是否内存瓶颈 | cache-misses, cache-references | miss 率 < 5% | > 10% → 数据布局差,内存子系瓶颈 |
| 确认是否流水线空转 | stalled-cycles-frontend, stalled-cycles-backend | — | frontend 高 → 取指瓶颈;backend 高 → 数据瓶颈 |
| 确认是否分支预测失败 | branch-misses, branches | miss 率 < 1% | > 5% → 代码有大量不可预测分支(数据依赖型 if/switch) |
| 区分自愿/非自愿切换 | pidstat -w 1 的 cswch/s / nvcswch/s | — | voluntary 高 → 主动睡眠(IO/锁等待);involuntary 高 → CPU 竞争 |
# 完整微观体检命令(一行到位,10 秒)
perf stat -p <PID> \
  -e task-clock,context-switches,cpu-migrations,page-faults \
  -e cycles:u,cycles:k,instructions:u,instructions:k \
  -e cache-misses,cache-references \
  -e branch-misses,branches \
  -e stalled-cycles-frontend,stalled-cycles-backend \
-- sleep 10这一步的定位价值:10 秒之内,你能判断程序的瓶颈在大方向上是"CPU 算不动"、"内存拖后腿"、"IO 在等"还是"线程在打架"。这决定了第二步的排查方向。
四、第二步:按线程拆分——谁是 CPU 型,谁是 IO 型
多线程程序的根本特征是线程异构。perf stat 给的是聚合数据,需要拆开看。
4.1 pidstat -t:逐线程体检
# -t: 显示线程  -u: CPU 使用率  -w: 上下文切换  -d: IO 延迟
pidstat -t -u -w -d -p <PID> 1
看每行的三列:
| 列 | 正常 | 异常 | 含义 |
|---|---|---|---|
%CPU | < 100 | 100 | 此线程吃满了一个核 |
%usr vs %system | 看比例 | %system > 30% | 此线程频繁进内核 |
cswch/s | < 100 | > 1000 | 此线程频繁主动放弃 CPU(IO 等待 / sleep / lock) |
nvcswch/s | < 10 | > 500 | 此线程频繁被抢占(CPU 竞争) |
iodelay(需 -d) | ≈ 0 | > 几十 ms | 此线程在等磁盘 |
快速分诊:
pidstat -t 每一行就是一个线程,快速扫一遍:
  某线程 %CPU ≈ 100, %usr 很高   →  CPU 型线程 → 用 perf record --tid <TID> 抓热点
  某线程 %CPU < 10, cswch/s > 1000 →  IO 型线程 → 用 strace -p <TID> 看阻塞在哪个 syscall
  某线程 cswch/s > 5000           →  锁竞争/条件变量 → 用 perf lock
  多个线程 %CPU ≈ 50, cswch/s 高   →  激烈 CPU 竞争 → 线程数 >> 核数
  某线程 %system > 50%            →  内核态占主导 → strace -c 看 syscall 频次
4.2 perf record --tid:按线程抓热点
找到 CPU 型线程的 TID 后,单独采样:
# 抓某个 CPU 型线程的调用栈(10 秒)
perf record -g -F 99 --tid <TID> -- sleep 10
# 生成报告
perf report --stdio | head -50
也可以用
perf top -p <PID>看实时热点分布——如果某个函数占了 30%+ 的采样点,它就是瓶颈。
4.3 IO 型线程:strace 看等在哪
# -T: 打印每个 syscall 的耗时(微秒)
# -c: 结束后出统计表
strace -T -c -p <TID> -o strace.log &
sleep 10
kill %1
cat strace.log
关注 % time 列和 seconds 列:
| 情况 | 含义 |
|---|---|
epoll_wait / poll 耗时 99% | 线程在等事件,正常(IO 线程就该等) |
read / write 耗时高 | IO 慢——可能 disk IO 或网络带宽不足 |
futex 耗时高 | 锁竞争——线程在等锁 |
nanosleep / clock_nanosleep | 代码里有显式 sleep,可能没必要 |
五、第三步:按异常模式深入
5.1 模式 A:"CPU 满载 + IPC 极低"——算不动
症状:多个线程 %CPU ≈ 100%,但 perf stat 显示 IPC < 0.5。
根因:CPU 在跑,但大量时间花在等内存(cache miss)或等流水线清空(分支预测失败)。
深入命令:
# 确认 cache miss 率
perf stat -e cache-misses,cache-references -p <PID> -- sleep 10
# 抓热点并做汇编级分析
perf record -g -F 99 -p <PID> -- sleep 10
perf annotate -d <热点函数名>
# 检查是否伪共享(多线程写相邻变量)
perf c2c record -p <PID> -- sleep 10
perf c2c report判断决策:
| IPC | 含义 | 行动 |
|---|---|---|
| > 2.0 | 计算非常高效 | 要加速只能换算法/加核 |
| 1.0~2.0 | 正常 | 热点函数可能是合理计算 |
| 0.5~1.0 | 有优化空间 | 看热点函数是否可算法优化 |
| < 0.5 | CPU 严重空转 | 必查 cache miss / 数据布局 / 伪共享 |
详见 案例一 §1.4.2,IPC 0.61 的深层分析。
5.2 模式 B:"所有线程 CPU 都在 30%~50%"——线程过多 / 锁竞争
症状:CPU 整体不低但没一个线程跑满,各线程 %CPU 都在 30%~60%。
根因:
- 线程数远大于 CPU 核数,调度器频繁切换(非自愿切换为主)
- 锁竞争严重,大量线程在等锁(自愿切换为主)
深入命令:
# 区分自愿 vs 非自愿切换
pidstat -t -w -p <PID> 1
# 非自愿切换高 → 线程太多
# 自愿切换高 → 可能有锁竞争 → 下一步
perf lock record -p <PID> -- sleep 10
perf lock report
# 看调度延迟(线程在 runqueue 等了多久)
perf sched record -p <PID> -- sleep 10
perf sched latency
线程数 vs CPU 核数速查:
# 看进程有多少线程
cat /proc/<PID>/status | grep Threads
# 看系统有多少核
nproc| 线程数 : 核数 | 判断 |
|---|---|
| ≤ 1.5:1 | 线程数合理 |
| 2:1 ~ 4:1 | 部分线程在等 IO,可以接受 |
| > 5:1 | 线程过多,调度开销大 |
5.3 模式 C:"context-switches > 1000/s + voluntary 为主"——IO 型线程在狂调 syscall
症状:perf stat 显示 context-switches 很高 → pidstat -w 显示 cswch/s(voluntary)占主导。
根因:每次 read/write/epoll_wait/sleep 都是一次系统调用,每个系统调用都可能触发调度。
深入命令:
# 看哪个 syscall 调用最频繁
strace -c -p <PID> -o strace.log &
sleep 10
kill %1
head -20 strace.log
# 看是哪个线程在频繁 syscall
pidstat -t -u -w -p <PID> 1
# 看内核态都花在哪了
perf record -e 'syscalls:sys_enter_*' -p <PID> -- sleep 10
perf report常见优化方向:
| 症状 | 方向 |
|---|---|
read(4096) 几万次/秒 | 增大 buffer 或改用 readv/splice |
write(少量字节) 极高频 | 用户态 buffer 攒一批再写,或用 sendmmsg |
futex 极高频 | 锁竞争 → 回到模式 B |
epoll_ctl 极高频 | 减少 epoll fd 的增删频率,或改用 io_uring |
5.4 模式 D:"内核态 cycles 占比 > 40%"——IO 或内核路径是瓶颈
症状:cycles:k / (cycles:u + cycles:k) > 0.4。
根因:
- 纯 syscall-heavy 场景(每个请求触发几次 syscall)
- page fault 频繁(mmap + 突然访问大量页)
- 中断处理过多(网卡收发包走软中断)
深入命令:
# 看内核态最热函数
perf record -g -p <PID> -- sleep 10
perf report --stdio | head -30  # 看带 [k] 标记的内核函数
# 看 page fault 是否异常
perf stat -e page-faults -p <PID> -- sleep 10
# 区分 minor vs major fault
pidstat -r -p <PID> 1 # 看 minflt/s 和 majflt/s判断:
| 情况 | 含义 |
|---|---|
cycles:k 高 + syscall 频次高 | 减少 syscall 次数(批量 IO、mmap、io_uring) |
cycles:k 高 + page-faults 急剧上升 | 内存映射/分配方式有问题 |
cycles:k 高 + %soft 高(mpstat) | 网卡中断集中在少数核 |
5.5 模式 E:"个别核跑满、其余核空闲"——单线程瓶颈 / 锁不均衡
症状:mpstat -P ALL 1 显示某几个核 100%,其余核 < 10%。
根因:热点线程没有分散,或者互斥锁保护了关键路径,其他线程都在等。
深入命令:
# 找跑满的单核上是谁
mpstat -P ALL 1  # 先看哪颗核满
ps -eo pid,tid,psr,comm | grep <PID>  # 看哪些线程在热核上
pidstat -t -u -p <PID> 1  # 确认哪个线程 CPU 高
# 看是不是锁在作祟
perf lock record -p <PID> -- sleep 10
perf lock report含义:如果跑满的核上只有一个关键线程,说明程序是单线程瓶颈——加速方向是减少关键线程的每单位工作量或拆分关键路径,加更多 worker 线程没用。
六、异常模式速查总表
| # | 症状组合 | 最可能原因 | 先跑这个命令 | 再看这个 |
|---|---|---|---|---|
| A | 多线程 100% CPU + IPC < 0.5 | 低效计算(cache miss / 伪共享 / 分支预测失败) | perf record -g → 火焰图 | perf annotate / perf c2c |
| B | 多线程 30%~50% CPU + 切换多 | 线程过多 或 锁竞争 | pidstat -t -w | perf lock / perf sched latency |
| C | 切换 > 1000/s + voluntary 为主 | 频繁 IO syscall / sleep | strace -c | pidstat -t 找具体线程 |
| D | cycles:k > 40% | syscall 风暴 / page fault / 中断 | perf record -g 看 [k] 函数 | pidstat -r 查 page fault |
| E | 个别核 100% + 其余核空闲 | 单线程瓶颈 / 锁集中在一条路径 | mpstat -P ALL + pidstat -t 找热线程 | perf lock 确认 |
| F | CPU 不饱和 + context-switches 低 | IO 等待(线程阻塞在磁盘/网络) | pidstat -t -d 看 iodelay | strace -p <TID> 看阻塞点 |
| G | CPU 100%、IPC 正常、吞吐仍低 | 算法本身复杂度高 | perf record -g 看热点函数 | 改算法 / 改数据结枟 |
| H | LLC miss 率 > 20% | 工作集溢出 L3 cache / NUMA 远程访存 | perf stat -e LLC-loads,LLC-misses | numastat / perf c2c |
七、完整分析脚本(15 分钟版本)
按以下顺序执行,每步 2-5 分钟,拿到全部基础数据后再分析:
# ═══ 准备工作 ═══
PID=<填入目标进程 PID>
OUTDIR=perf_analysis_$(date +%Y%m%d_%H%M%S)
mkdir -p $OUTDIR
# ═══ 1. 宏观体检 (2 min) ═══
perf stat -p $PID \
  -e task-clock,context-switches,cpu-migrations,page-faults \
  -e cycles:u,cycles:k,instructions:u,instructions:k \
  -e cache-misses,cache-references,branch-misses,branches \
  -e stalled-cycles-frontend,stalled-cycles-backend \
  -- sleep 10 2>&1 | tee $OUTDIR/01_perf_stat.txt
# ═══ 2. 按线程拆分 (2 min) ═══
pidstat -t -u -w -d -p $PID 1 5 2>&1 | tee $OUTDIR/02_pidstat.txt
# ═══ 3a. 抓热点函数 (若 CPU 型线程存在) (3 min) ═══
perf record -g -F 99 -p $PID -- sleep 10 2>&1
perf report --stdio --no-children | head -40 | tee $OUTDIR/03_perf_report.txt
# ═══ 3b. 看 syscall 频次 (若 IO 型线程存在) (2 min) ═══
timeout 10 strace -c -p $PID -o $OUTDIR/04_strace.txt 2>&1
# ═══ 3c. 锁竞争分析 (若切换高) (3 min) ═══
perf lock record -p $PID -- sleep 5 2>&1
perf lock report 2>&1 | tee $OUTDIR/05_perf_lock.txt
# ═══ 3d. NUMA/核分布 (1 min) ═══
mpstat -P ALL 1 3 2>&1 | tee $OUTDIR/06_mpstat.txt
# ═══ 全部数据在 $OUTDIR/ 下 ═══
echo "分析数据已保存到: $OUTDIR"
八、快速判断:程序有没有明显问题?
对着收集到的数据,回答 6 个问题——如果全部 "否",程序状态健康:
| # | 问题 | 看哪个数据 | 是 = 有问题 |
|---|---|---|---|
| 1 | 有没有线程空转 CPU 但 IPC < 0.5? | perf stat IPC + pidstat -t %CPU | 模式 A |
| 2 | 上下文切换 > 500/s/线程? | pidstat -t -w 的 cswch/s | 模式 C |
| 3 | 内核态 cycles > 40%? | cycles:k / (cycles:u+cycles:k) | 模式 D |
| 4 | 有核跑满、有核完全空闲(差 > 3×)? | mpstat -P ALL | 模式 E |
| 5 | LLC cache miss 率 > 10%? | perf stat -e LLC-loads,LLC-misses | 模式 H |
| 6 | 有线程 iodelay 持续 > 100ms? | pidstat -t -d | 模式 F |
评价:如果 6 项全部正常,说明程序在多线程调度和 IO 层面没有明显结构性问题。如果吞吐仍不达标,瓶颈在业务逻辑算法本身——用
perf record找到消耗最高的函数,从算法层面优化。
九、一句话总结
perf stat四字段定类型(CPU 型 / IO 型 / 混合型)→pidstat -t拆线程分 CPU/IO 两类 → 异常模式对照表选深入工具,15 分钟拿到多线程+IO 程序的完整诊断报告,6 个判断题决定有没有明显性能问题。
十、配套 demo
- mt-io-demo 配套实验——可运行程序说明 + 完整实验指南:参数一览、三步法诊断、四轮对比数据与分析结论