并发模型基准测试方法论:如何精准测量延迟与吞吐量
一、为什么并发基准测试这么难
1. 干扰源清单
| 干扰类型 | 影响量级 | 消除手段 |
|---|---|---|
| CPU 频率缩放 (DVFS) | 30-50% | cpupower frequency-set -g performance |
| SMT 兄弟线程竞争 | 15-30% | 绑核 + 关闭 SMT 或独占物理核 |
| NUMA 跨节点访问 | 30-100% | numactl --membind + --physcpubind |
| 中断 / 软中断抢占 | 1-5us/jitter | isolcpus + nohz_full + IRQ affinity |
| 调度器迁移 | 10-100us | 绑核 + SCHED_FIFO |
| 系统计时器 tick | 10-50us | nohz_full + rcu_nocbs |
| TLB shootdown | 1-10us | 大页 + 减少跨核页表修改 |
| 随机内存分配延迟 | 1-10ms | 预分配 + mlockall |
| 磁盘 IO / swap | ms 级 | ramdisk / tmpfs / 关闭 swap |
2. 预热(Warm-up)的必要性
- JIT 编译(Java/C#)→ 需要数分钟预热
- 分支预测器训练 → 数千次迭代
- 缓存升温 → 取决于数据大小
- C++ 模板和虚函数 → 无 JIT 但仍需 cache warming
3. 测量偏差
- Heisenberg 效应:测量工具本身改变行为(如 perf 采样开销)
- 尾延迟隐藏:只看平均值掩盖了最坏情况
- 调度欺骗:测试线程被抢占的间隙不计入测量
二、延迟测量方法
1. 时钟源选择
| 时钟源 | 精度 | 开销 | 适用场景 |
|---|---|---|---|
clock_gettime(CLOCK_MONOTONIC) | ~20ns | 中等 | 通用基准测试 |
rdtsc / __rdtsc() (x86) | ~10ns | 最低 | 微秒/纳秒级延迟 |
rdtscp (序列化) | ~25ns | 较高 | 确保指令顺序 |
std::chrono::steady_clock | ~20ns | 中等 | 可移植代码 |
perf_event_open + HW counter | ~100ns | 高 | 精确硬件计数 |
2. rdtsc 的正确使用
cpp
// 基础用法(非序列化)
uint64_t start = __rdtsc();
do_work();
uint64_t end = __rdtsc();
// 序列化用法(排除乱序影响)
uint64_t start = __rdtscp(&aux);
_mm_lfence();  // 或 cpuid
do_work();
_mm_lfence();
uint64_t end = __rdtscp(&aux);
// 转换为纳秒
double ns = (end - start) * 1000.0 / tsc_freq_mhz;  // 需要先校准 tsc_freq
3. 尾延迟聚焦采集法 (HdrHistogram)
- 线性桶 vs 对数桶
- HdrHistogram 的价值:P50/P95/P99/P99.9/P99.99 全部精确
- 长尾的"Whale Tail"图——可视化灾难
三、吞吐量测量方法
1. 正确计算吞吐量
bash
错误做法:用 wall clock 时间 ÷ 操作数(包含了预热和冷却)
正确做法:稳态期间的操作数 ÷ 精确计时
2. 受控并发测试
- 固定并发数 vs 最大化并发
- Little's Law:
Concurrency = Throughput × Latency - 排队论视角:M/M/1 vs M/D/1
3. 负载生成策略
- Open-loop:固定速率发送请求(泊松到达)
- Closed-loop:固定并发数,完成一个才发下一个
- 混合模式:控制请求速率的 bounded open-loop
四、基准测试框架设计
1. 通用框架结构
bash
[Pre-Test]
  - 配置 CPU Governor / isolcpus / IRQ affinity
  - 分配并预热内存
  - 创建线程,绑定到隔离的 CPU
  - 初始化被测数据结构
[Warm-up]
  - 运行直到吞吐量/延迟稳定(通常 5-30 秒)
[Measurement]
  - 固定时间窗口(e.g., 30s)或固定操作数(e.g., 10M)
  - 记录每次操作的延迟或累计吞吐量
[Post-Test]
  - 输出百分位数分布
  - 输出异常值(超过 3σ)
  - 输出 CPU 使用率、上下文切换次数
2. C++ 参考实现
cpp
class Benchmark {
std::vector<uint64_t> latencies_; // 或使用 HdrHistogram
std::atomic<bool> running_{false};
std::atomic<uint64_t> ops_{0};
// 绑核 + 实时优先级
void pin_and_rt(int cpu) {
cpu_set_t cpuset;
CPU_ZERO(&cpuset);
CPU_SET(cpu, &cpuset);
pthread_setaffinity_np(pthread_self(), sizeof(cpuset), &cpuset);
struct sched_param param = { .sched_priority = 99 };
pthread_setschedparam(pthread_self(), SCHED_FIFO, ¶m);
}
// 统计学输出
void report() {
std::sort(latencies_.begin(), latencies_.end());
size_t n = latencies_.size();
auto p = [&](double pct) { return latencies_[n * pct / 100]; };
printf("P50=%.1fns P95=%.1fns P99=%.1fns P99.9=%.1fns\n",
p(50), p(95), p(99), p(99.9));
}
};
五、可视化与统计分析
1. 分布图
- 延迟分布直方图:X = 延迟区间,Y = 频次
- HDR 直方图:对数 X 轴,看到从 ns 到 ms 的全范围
- 延迟随时间变化:检测升温、GC、周期性抖动
2. 关键统计量
| 指标 | 含义 | 何时关注 |
|---|---|---|
| Mean | 平均延迟 | 粗略比较,容易被长尾拉偏 |
| Median (P50) | 典型延迟 | 用户体验的"大多数" |
| P95 | 20 个请求中有 1 个超过 | SLA 常用阈值 |
| P99 | 100 个中有 1 个 | 开始关注异常 |
| P99.9 | 1000 个中有 1 个 | 高频交易级别 |
| P99.99 | 10000 个中有 1 个 | 对异常极度敏感 |
| Max | 最坏情况 | 硬实时系统必看 |
| StdDev | 抖动程度 | 检测周期性抖动源 |
六、并发模型对比基准测试示例
1. 测试清单
| 模型 | 需要记录的指标 |
|---|---|
| mutex + 临界区 | 锁获取时间、临界区时间、等待时间 |
| 无锁队列 | enqueue/dequeue 延迟,empty/full 率 |
| RCU | 更新端 synchronize_rcu 延迟 |
| channel/CSP | 通道容量 vs 吞吐量曲线 |
| actor model | mailbox 大小 vs 尾延迟 |
2. 可扩展性测试
bash
1 核 → 2 核 → 4 核 → 8 核 → 16 核(同 Socket)
跨 NUMA: 1 Socket → 2 Sockets
Ratio: 实际吞吐 / 线性扩展吞吐 = 扩展效率
3. 压力测试
- 逐步增大负载直到吞吐量不再增长(饱和点)
- 记录饱和时的 P99 延迟(客户看到的)
- "延迟-吞吐量"曲线是系统容量规划的黄金依据
七、推荐工具链
| 工具 | 用途 |
|---|---|
perf stat | IPC、缓存 miss、分支误预测 |
perf record/annotate | 热点函数定位 |
ftrace | 内核路径延迟(调度、中断、系统调用) |
| HdrHistogram (C/Java) | 高精度延迟分布 |
| Benchmark.js / Google Benchmark | 微基准测试框架 |
| wrk2 / siege | HTTP 负载生成 |
| prometheus + grafana | 持续监控 |
八、参考
- latency-measurement —— 延迟测量工具与 tsc/clock_gettime 对比
- perf-advanced —— perf 高级使用
- low-latency-patterns —— 低延时设计导读
- 《Systems Performance》Brendan Gregg
总结
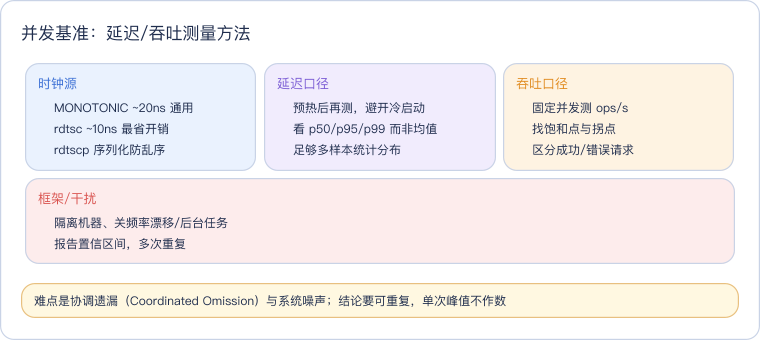
基准测试关键是时钟源(rdtsc/MONOTONIC)、预热、看分位数而非均值、隔离干扰并报置信区间;警惕协调遗漏,结论必须可重复。