CPU 微架构导读 —— 一颗核怎么从"一次一条"变到"一拍好几条"
仓库里 cache/ 下已经攒了好几篇讲"CPU 核内部怎么跑得快"的文档:pipelining-superscalar、cpu-out-of-order、branch-prediction。它们其实是同一条演进链上的环节,各自解决前一环留下的瓶颈。本篇是这条链的导读:先把"CPU 为提升单核性能,一步步加了哪些机制、每步解决什么、又引出什么新问题"串成一条主线,再路由到各专篇。
定位:这是单核微架构的导读("一颗核怎么跑得快")。它和另一条线——多核内存序(reordering-overview,"多核看得对不对")——是正交的两件事,别混(cpu-out-of-order 专门辨析过这个边界)。
一、一条主线:每一步都是"解决上一步的瓶颈"
CPU 提升单核性能,本质是不断提高 IPC×频率(每拍干更多活 × 每秒更多拍)。这条演进链环环相扣——每一层技术,都是为了填平上一层暴露的浪费或瓶颈:
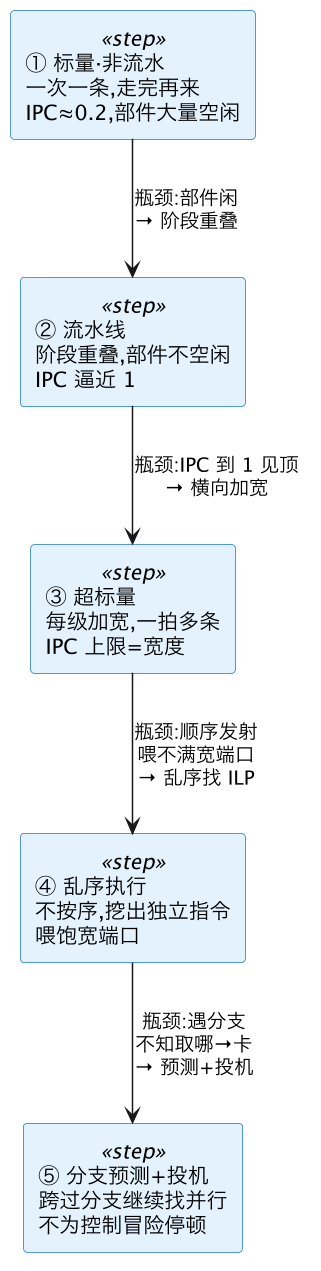
逐环解读(每环=上一环的瓶颈+这环的解法):
| 环节 | 上一步的瓶颈 | 这一步做什么 | 引出的新问题 |
|---|---|---|---|
| ① 标量非流水 | —(基线) | 一条指令走完再下一条 | 每个部件 N 拍只忙 1 拍,浪费 |
| ② 流水线 | 部件大量空闲 | 阶段重叠,每拍都有指令退休 | IPC 到 1 就见顶;且冒险(数据/控制)会打断 |
| ③ 超标量 | IPC≈1 是天花板 | 每级加宽,一拍处理多条 | 顺序发射时紧邻指令有依赖,喂不满 |
| ④ 乱序执行 | 宽端口喂不饱 | 从后面捞独立指令填空(找 ILP) | 遇分支不知取哪条,乱序会卡住 |
| ⑤ 分支预测+投机 | 控制冒险让乱序停摆 | 赌一个方向继续投机执行 | 猜错要清空流水线;投机留下缓存痕迹→Spectre |
一句话主线:部件闲→流水线;IPC 见顶→超标量加宽;宽了喂不饱→乱序找并行;乱序遇分支卡→预测跨过去。 每一步都在为上一步补窟窿——理解了这条因果链,各专篇就不是孤立知识点,而是同一个故事的章节。
二、两个正交的维度:别把这些机制混成一锅
这些机制常被笼统说成"CPU 优化",但它们分属不同维度,混在一起是理解的最大障碍。先划清:
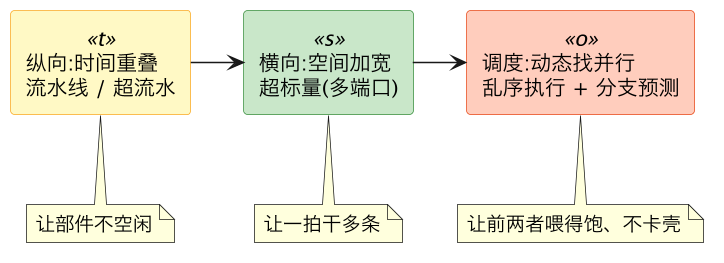
还有几个同层但不同类的并行手段,也常和上面混淆——一次划清(详见 pipelining-superscalar 的"极易混淆概念"节):
| 手段 | 并行的是什么 | 层次 |
|---|---|---|
| 流水线/超标量/乱序 | 指令级并行 ILP(单线程内多条指令) | 本导读主线 |
| SIMD(AVX 等) | 数据级并行 DLP(一条指令、多份数据) | 正交,可叠加 |
| 多核 / 超线程(SMT) | 线程级并行 TLP(多个线程) | 更高层,跨线程 |
| 超流水(superpipelining) | 不是加并行,是切更深提频率 | 纵向再细分 |
别搞混:超标量=一拍多条不同指令(ILP);SIMD=一条指令多份数据(DLP);多核/SMT=多个线程(TLP);超流水=同一条指令切更多级(提频率)。四者可同时存在于一颗核上。
三、路由:想深入哪一环,去哪篇
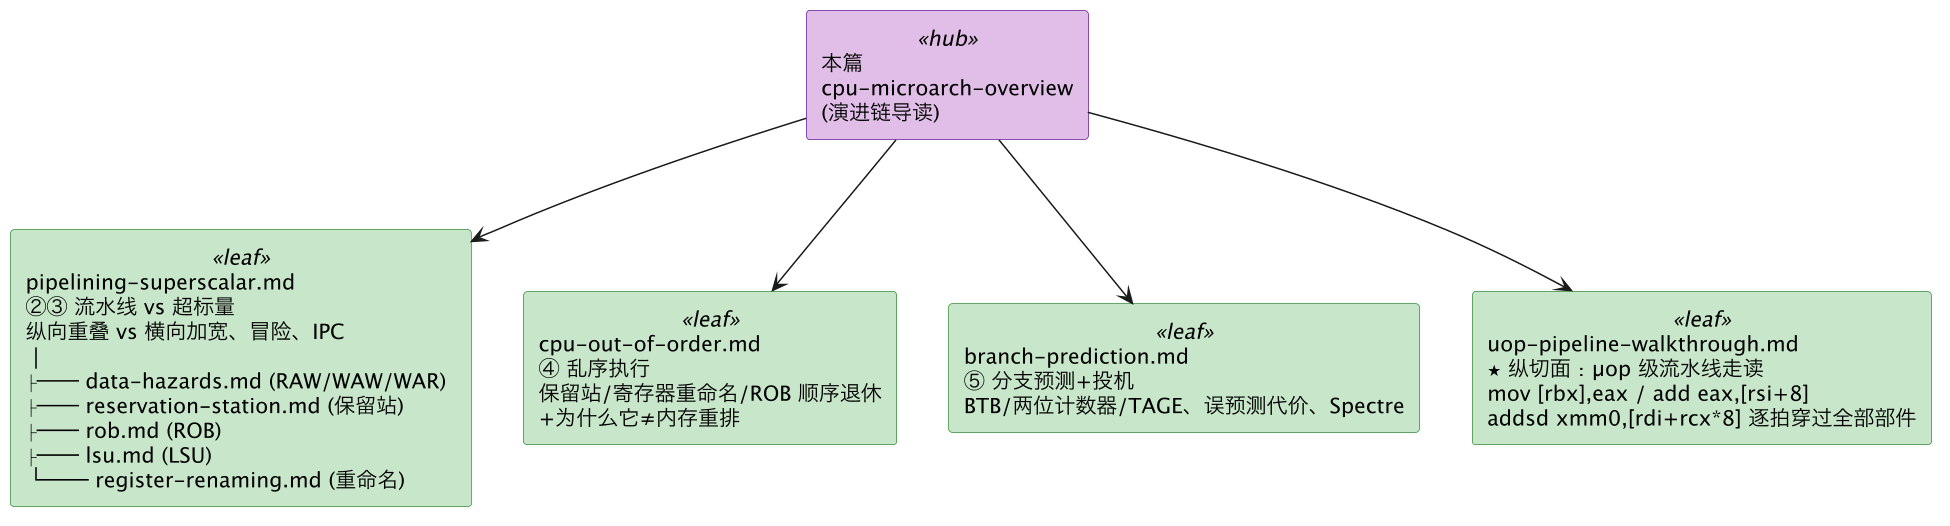
- 想搞清流水线和超标量的区别、冒险、IPC 上限 → pipelining-superscalar
- 想搞清RAW/WAW/WAR 三种数据冒险的本质、真假依赖、硬件解法 → data-hazards
- 想逐个搞清超标量的关键部件怎么工作 → reservation-station(保留站)、rob(ROB)、lsu(LSU)、register-renaming(寄存器重命名)
- 想搞清乱序执行怎么保证单核正确、它和内存重排的边界 → cpu-out-of-order
- 想搞清分支为什么要猜、怎么猜、猜错多贵 → branch-prediction
- 想把所有部件串起来,看一条指令逐拍穿过 IF→ID→REN→RS→EX→WB→RET → uop-pipeline-walkthrough
四、这条链的"账单":性能悬案往往是它没喂饱
这台又深又宽的机器,理论 IPC 能到 4~6。但实际程序常常远低于此——因为链条上任何一环卡住,整台机器就空转。这也是本仓库大量性能文档的共同主题:你的代码没喂饱 CPU,去查是哪一环卡了。
| IPC 掉下来的元凶 | 卡在哪一环 | 去哪篇 |
|---|---|---|
| cache miss(等内存几百拍) | 流水线后端停顿(backend stall) | cache-organization、mesi(伪共享) |
| TLB miss(page walk) | 同上,且更隐蔽 | tlb |
| 分支误预测 | 流水线被清空(⑤) | branch-prediction |
| 长依赖链(ILP 不足) | 超标量端口喂不满(③④) | cpu-out-of-order |
| I-cache miss / 前端喂不上 | 前端停顿(frontend stall) | perf |
统一的观测入口是 IPC(见 IPC 瓶颈篇观测节、perf):
perf stat ./app                                    # 看 insn per cycle
perf stat -e cycles,instructions,stalled-cycles-frontend,stalled-cycles-backend ./app
五、和另一条线的边界:微架构 ≠ 内存序
必须再强调一次(这是最大的混淆源):
- 本导读这条线(微架构) 回答"单核怎么跑得快"——流水线/超标量/乱序/预测,全是单核性能手段,架构层透明(单线程结果永远正确,见 ooo-renaming-retirement 的顺序退休)。
- 另一条线(内存序,reordering-overview) 回答"多核看得对不对"——编译器重排/内存重排/store buffer/屏障,是多核正确性问题。
两者只在"访存的投机重排"处擦一点边,且 x86 用 machine-clear 把这点擦边也抹平了——它们是正交的两件事。微架构再怎么乱序投机,单线程结果永远对;要担心"别的核看到什么顺序",那是内存序的事。
六、一句话总结
单核变快是一条环环相扣的演进链:标量非流水(部件闲)→流水线(阶段重叠,IPC→1)→超标量(横向加宽,IPC 破 1)→乱序执行(挖 ILP 喂饱宽端口)→分支预测+投机(跨过分支不停顿)。每一步都在补上一步的窟窿。这些全是"单核怎么跑得快"的手段、架构层透明,和"多核看得对不对"的内存序(reordering-overview)正交。综合成效看 IPC,它低了就沿链条查:cache/TLB miss、分支误预测、还是依赖链不足——这也是本仓库几乎所有 CPU 性能文档的共同落点。