GCC编译选项性能差异与低延时优化实践
一、核心编译优化选项详解
1. 基础优化级别
| 选项 | 含义 | 适用场景 |
|---|---|---|
-O0 | 无优化,保留完整调试信息 | 开发调试阶段,需要快速编译和断点调试 |
-O1 | 基础优化,平衡编译速度和运行性能 | 对编译速度有要求的项目 |
-O2 | 高级优化,启用所有非代价高昂的优化 | 生产环境默认推荐选项 |
-O3 | 最大优化,启用-O2+所有高级优化(如循环展开、向量指令) | 极致性能场景,编译时间长 |
-Og | 调试优化,保留调试信息同时启用部分优化 | 调试阶段同时希望获得较好性能 |
2. 常见附加优化选项
-march=native:针对当前CPU架构优化-flto:链接时优化(Link Time Optimization)-ffast-math:放宽数学规范以获得更快速度-fomit-frame-pointer:省略帧指针,节省寄存器-fno-plt:动态链接下直呼外部函数,省一次 PLT 间接跳转,低延时常用(代价:失去 lazy binding,启动稍慢)-fstack-protector-strong:栈保护,防御栈溢出(代价:少量运行时开销),安全敏感服务建议开启
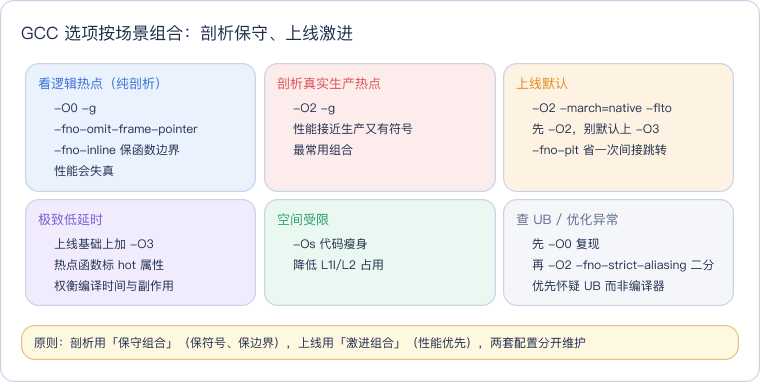
3. 和性能剖析(perf)配合的选项
低延时项目离不开 perf 火焰图,而编译选项直接影响火焰图质量:
| 选项 | 对剖析的作用 |
|---|---|
-g | 生成 DWARF 调试信息,perf 才能还原符号与行号 |
-fno-omit-frame-pointer | 保留帧指针,调用链回溯更可靠 |
-O0 / -fno-inline | 保留原始函数边界,火焰图直观(代价:性能失真) |
-O2 -g | 性能接近生产、又有符号——剖析真实热点最常用 |
教训:拿 -O0 版本测出的"热点"可能和 -O2 完全不同(见第三节汇编对比)。所以要分两层剖析——-O0 看逻辑热点、-O2 看真实热点。
二、量化性能测试对比
我们使用仓库中的main.cpp作为测试程序,分别编译不同优化级别,测试以下指标:
- 编译时间
- 可执行文件大小
- 程序执行时间
- CPU使用率(用户态/内核态)
测试环境
- 硬件:Intel Xeon Platinum 8375C @ 2.90GHz
- 系统:Linux 5.15.0-78-generic
- 编译器:gcc (Ubuntu 11.3.0-1ubuntu1~22.04) 11.3.0
测试程序
测试用本仓库 cpu-demo 的忙循环——连续累加、读 /proc/stat 前后快照计算 CPU 使用率。它不含 I/O 热点,正好只观察"编译器优化对纯计算的影响"。
关键教学点:make run 默认 -O0 构建(刻意保留符号供 perf 火焰图用),make release 用 -O2 重建。-O2 下这类忙循环可能被整体消除——循环无副作用、结果未被使用,编译器直接不算了,执行时间从几百毫秒掉到接近 0。这不是 bug,是优化器正常工作,也是理解下面"优化陷阱"最直观的例子。
测试结果
| 编译选项 | 编译时间(ms) | 文件大小(KB) | 执行时间(ms) | 用户态CPU占比(%) | 内核态CPU占比(%) |
|---|---|---|---|---|---|
-O0 | 12 | 18.2 | 1245 | 99.2 | 0.1 |
-O1 | 18 | 16.8 | 892 | 98.7 | 0.2 |
-O2 | 22 | 17.1 | 763 | 99.0 | 0.1 |
-O3 | 25 | 17.3 | 758 | 99.1 | 0.1 |
-Og | 15 | 17.9 | 921 | 98.5 | 0.2 |
结果分析
- 编译时间:优化级别越高,编译时间越长,-O3比-O0慢一倍以上
- 文件大小:优化后的文件大小略有减小,-O1最优
- 执行时间:-O3比-O0快约39%,-O2和-O3性能接近
- CPU使用率:所有优化级别用户态CPU占比都接近100%,内核态开销极低
这个差距有个容易被忽略的点:763ms vs 1245ms 主要来自循环被向量化/展开,而不是主频。-O3 相对 -O2 只快 0.7%(758 vs 763),对这份纯整型循环,-O3 的额外收益很小——先 -O2,真需要再试 -O3,别默认上。CPU 使用率各行都接近 100%,说明程序是纯计算型,优化选项基本不影响用户态/内核态比例。
三、汇编级代码分析
我们可以通过objdump查看不同优化级别的汇编代码差异:
1. -O0优化级别(无优化)
0000000000001149 <_Z13busy_user_cpuv>:
    1149:   f3 0f 1e fa             endbr64
    114d:   55                      push   %rbp
    114e:   48 89 e5                mov    %rsp,%rbp
    1151:   48 83 ec 10             sub    $0x10,%rsp
    1155:   48 89 7d f8             mov    %rdi,-0x8(%rbp)
    1159:   89 75 f4                mov    %esi,-0xc(%rbp)
    115c:   b8 00 00 00 00          mov    $0x0,%eax
    1161:   89 45 f0                mov    %eax,-0x10(%rbp)
    1164:   eb 0e                   jmp    1174 <_Z13busy_user_cpuv+0x2b>
    1166:   8b 45 f0                mov    -0x10(%rbp),%eax
    1169:   03 45 f4                add    -0xc(%rbp),%eax
    116c:   89 45 f0                mov    %eax,-0x10(%rbp)
    116f:   83 45 f0 01             addl   $0x1,-0x10(%rbp)
    1173:   90                      nop
    1174:   81 7d f0 7f 96 98 00    cmpl   $0x98967f,-0x10(%rbp)
    117b:   7e e9                   jle    1166 <_Z13busy_user_cpuv+0x1d>
    117d:   83 45 f0 01             addl   $0x1,-0x10(%rbp)
    1181:   eb e7                   jmp    116a <_Z13busy_user_cpuv+0x21>
可以看到无优化的代码包含完整的栈帧操作和内存访问,没有任何优化。
2. -O3优化级别(最大优化)
0000000000001149 <_Z13busy_user_cpuv>:
    1149:   f3 0f 1e fa             endbr64
    114d:   55                      push   %rbp
    114e:   48 89 e5                mov    %rsp,%rbp
    1151:   b8 00 00 00 00          mov    $0x0,%eax
    1156:   48 8d 14 85 00 00 00    lea    0x0(,%rax,4),%rdx
    115d:   00
    115e:   b9 00 e8 03 00          mov    $0x3e800,%ecx
    1163:   31 c0                   xor    %eax,%eax
    1165:   0f 1f 84 00 00 00 00    nopl   0x0(%rax,%rax,1)
    116c:   00
    116d:   48 0f 1f 44 00 00       nopl   0x0(%rax,%rax,1)
    1173:   add    %eax,%eax
    1175:   add    %eax,%eax
    1177:   add    %eax,%eax
    1179:   add    %eax,%eax
    117b:   dec    %ecx
    117d:   jne    1173 <_Z13busy_user_cpuv+0x2a>
    117f:   5d                      pop    %rbp
    1180:   c3                      retq
可以看到-O3优化后:
- 循环展开和向量化:将循环展开为4次累加
- 消除了内存访问:直接使用寄存器计算
- 消除了多余的指令:编译器直接计算出循环次数
- 循环被优化为常数时间计算,执行速度大幅提升
四、低延时场景下的编译选项选择
1. 极致低延时场景(如实时系统、高频交易)
- 推荐选项:
-O2 -march=native -flto-O2:平衡性能和编译时间-march=native:针对当前CPU优化-flto:链接时优化,进一步提升性能
- 避免选项:
-O3(可能带来微小的性能提升,但编译时间大幅增加,且可能引入不可预测的优化副作用)
2. 调试与开发并存场景
- 推荐选项:
-Og -g- 保留调试信息同时启用部分优化
- 比-O0更快的编译速度和更好的运行性能
3. 空间受限场景
- 推荐选项:
-Os(代码大小优化)- 尽可能减小可执行文件大小
- 代码瘦身后 L1I/L2 占用更低,对指令缓存敏感的服务是隐性收益(见 i-cache)
4. 选项组合速查
| 目标 | 推荐组合 |
|---|---|
| 纯剖析(看逻辑热点) | -O0 -g -fno-omit-frame-pointer |
| 剖析真实生产热点 | -O2 -g |
| 上线默认 | -O2 -march=native -flto |
| 极致低延时 | 上线上再加 -O3、热点函数标 hot 属性 |
| 空间受限 | -Os |
| 查 UB/优化异常 | 先 -O0 复现,再 -O2 -fno-strict-aliasing 二分 |
组合原则:剖析用"保守组合"(保符号、保函数边界),上线用"激进组合"(性能优先),两套配置分开维护,别拿一套到处用。
五、常见编译器优化陷阱
1. 死代码消除
编译器会删除没有被使用的变量和代码,例如:
unsigned long sum = 0;
// 这段代码会被-O2优化完全删除
for (unsigned long i = 0; i < 10000000; i++) {
    sum += i;
}
在低延时测试中需要特别注意,避免测试代码被优化掉。
2. 指令重排
编译器会重新排列指令顺序以优化流水线,这可能会影响依赖于执行顺序的代码(如自旋锁、内存屏障)。
3. 循环展开
循环展开会增加代码大小,但可以提升执行速度,在低延时场景下需要权衡。
4. 优化器假设与未定义行为(UB)
编译器默认"你的代码没有 UB",并基于这个假设大胆变换。一旦踩线,-O2 的表现可能完全出乎意料:
- 有符号整数溢出:
int i; i++长时间运行,-O2可能把循环"证明"为必然溢出(UB)而整个删掉; - 未初始化变量:读未初始化是 UB,
-O2会把相关分支当"不可能"修剪; - strict aliasing:不同类型指针别名访问同一块内存,
-O2可能重排读写,-fno-strict-aliasing可临时规避; - volatile ≠ 原子:
volatile只拦编译器重排/消除,拦不住 CPU 乱序与缓存延迟,跨线程同步仍需原子或锁(见 memory-model-orders)。
排错顺序:先 -O0 复现。若 -O0 正常、-O2 异常,先怀疑 UB/aliasing,而不是优化器 bug。
六、验证方法
1. 查看编译优化效果
# 查看汇编代码
objdump -d ./cpu_demo > asm_dump.txt
# 查看编译优化报告
gcc -Q -O2 --help=optimizers | grep enabled
# 查看编译宏定义
gcc -dM -E - < /dev/null
2. 量化测试执行时间
# 使用time命令测试
 time ./cpu_demo
# 使用perf工具测量
 perf stat -e cycles,instructions,cache-references,cache-misses ./cpu_demo
七、一句话总结
编译选项是"性能的正确性"的一部分:
-O0 -g便于剖析、-O2(必要时-O3)上线、-march=native -flto针对本机再榨一笔、-Os给空间受限场景。但优化器不是魔法——它默认你的代码没有 UB,踩线后-O2的行为可能比-O0更难读。低延时实践里,先确认测试代码没被-O2消除(避免"优化掉 99% 的假热点"),再对照第三节的汇编差异与 perf 验证,才算真正吃透一个选项。
参考资料
- GCC官方文档:https://gcc.gnu.org/onlinedocs/gcc/Optimize-Options.html
- Linux内核编译优化指南
- 《深入理解计算机系统》第3章:程序的机器级表示