CPU 系统架构观测与诊断工具:lstopo / lscpu / lspci / numactl / dmidecode
现代 CPU 的拓扑和总线非常复杂:多 Socket、多 Die、跨 CCD 的 L3、直连 vs Chipset PCIe、NUMA 节点距离……要理解一台机器的真实布局,不能只看
/proc/cpuinfo。本文把最常用的系统架构观测工具串起来,并给出典型性能问题的诊断路径。
关联:cpu-bus-architecture(导读)、cpu-physical-hierarchy(物理层次)、core-and-uncore(核心与 Uncore)、off-chip-buses(片外总线)、numa(NUMA 拓扑)
一、lstopo:最直观的 CPU 拓扑图
lstopo 来自 hwloc 包,可以图形化或文本化展示 CPU、缓存、NUMA 节点、PCIe 设备的层级关系。
1.1 基本用法
# 安装
sudo apt install hwloc  # Debian/Ubuntu
sudo yum install hwloc  # RHEL/CentOS
# 只看 CPU/缓存/NUMA 拓扑(文本)
lstopo --no-io
# 完整拓扑:含 PCIe 设备、网卡、GPU 等
lstopo
# 输出到图片(PNG/SVG/PDF)
lstopo --output-format png topology.png
lstopo --output-format svg topology.svg
1.2 典型输出解读
Machine (1024GB total)
  NUMANode L#0 (P#0 512GB)
    Package L#0
      L3 L#0 (32MB) + Core L#0...L#7
      L3 L#1 (32MB) + Core L#8...L#15
    HostBridge
      PCIDev: 0000:00:00.0 (Root Complex)
      PCIDev: 0000:00:02.0 (GPU)
      PCIDev: 0000:3b:00.0 (NVMe SSD)
  NUMANode L#1 (P#1 512GB)
...看这张图能知道什么:
- 有几个 Socket / NUMA 节点
- 每个 NUMA 节点有多少本地内存
- L3 是共享给哪些核心(Intel 统一 LLC 还是 AMD CCD 分片)
- PCIe 设备挂在哪个 NUMA 节点下(是否本地)
- 哪些设备是直连 CPU,哪些走 Chipset
二、lscpu:快速看核与 NUMA 的对应
lscpu 是最快的命令行方式,适合脚本和远程排查。
# 基本输出
lscpu
# 关键字段:
# Architecture:        x86_64
# CPU(s):              128                  # 逻辑核总数
# Thread(s) per core:  2                    # 是否开启超线程
# Core(s) per socket:  32                   # 每 Socket 物理核
# Socket(s):           2                    # 几个 Socket
# NUMA node(s):        2                    # 几个 NUMA 节点
# NUMA node0 CPU(s):   0-31,64-95           # 哪些逻辑核属于 NUMA 0
# NUMA node1 CPU(s):   32-63,96-127         # 哪些逻辑核属于 NUMA 1
# L1d/L1i/L2/L3 cache: 各级缓存大小
# Model name:          具体 CPU 型号
# 扩展:每个核的 Socket/Core/NUMA 对应表
lscpu --extended
# 输出示例:
# CPU NODE SOCKET CORE L1d:L1i:L2:L3 ONLINE    MAXMHZ   MINHZ
#   0    0      0    0 0:0:0:0       yes    3900.0000  800.0000
# 只看缓存信息
lscpu -C
lscpu --extended 最实用:做 CPU 绑定时,可以一眼看出某个逻辑核属于哪个 Socket、哪个物理核、哪个 NUMA 节点,避免绑错。
三、/sys 下的原始缓存信息
如果想精确知道 L1/L2/L3 的大小、共享范围、类型:
# 查看 CPU0 的各级缓存
for i in 0 1 2 3; do
  echo "=== L$i (cache index $i) ==="
  cat /sys/devices/system/cpu/cpu0/cache/index$i/level
  cat /sys/devices/system/cpu/cpu0/cache/index$i/type
  cat /sys/devices/system/cpu/cpu0/cache/index$i/size
  cat /sys/devices/system/cpu/cpu0/cache/index$i/shared_cpu_list
  cat /sys/devices/system/cpu/cpu0/cache/index$i/shared_cpu_map
  echo
done| 字段 | 含义 |
|---|---|
level | 1/2/3 |
| type | Data / Instruction / Unified |
size | 缓存大小 |
shared_cpu_list | 共享该缓存的 CPU 列表 |
shared_cpu_map | 共享该缓存的 CPU 位图 |
用例:如果
cpu0和cpu8共享 L3,说明它们很可能在同一个 AMD CCD 或 Intel L3 slice 内;如果跨很远才共享 L3,说明是跨 CCD 或跨 Socket。
四、lspci:PCIe 拓扑与链路协商
4.1 查看 PCIe 树
# 树形拓扑:Root Complex → Switch → Endpoint
lspci -t -vvv
# 只看某设备(例如 NVMe)
lspci -s 0000:3b:00.0 -vvv
4.2 看链路速度和宽度(关键)
lspci -vvv | grep -E "LnkSta|LnkCap"典型输出:
LnkCap: Port #0, Speed 16GT/s, Width x16  # 设备支持的最大能力
LnkSta: Speed 16GT/s, Width x16 # 当前实际协商结果关键检查:
LnkCap和LnkSta是否一致。如果LnkCap是 16GT/s ×16,但LnkSta只有 8GT/s ×8,说明链路降速了——可能是主板插槽、线缆、转接卡或 BIOS 设置问题。
4.3 看设备挂在 Root Complex 还是 Chipset 下
# 找到设备的上级总线
lspci -vvv -s <BDF> | grep -E "Bus:|Primary|Secondary|Subordinate"
# 或者看总线号:0000:00 是 CPU 根总线;
# 如果设备挂在 0000:01/02/... 等可能是 Root Complex 下直连;
# 如果挂在 0000:06/... 等更高总线号,可能经过 Chipset/Switch。
# 更直接:看 lstopo 的拓扑图,设备是否位于 CPU Package 下。实战:把 GPU 和 NVMe 插到直连 CPU 的槽位,而不是 Chipset 出来的槽位,能显著降低延迟并避免 DMI 带宽竞争。
lspci -t和lstopo结合看最清晰。
五、numactl / numastat:NUMA 距离与内存访问
5.1 numactl --hardware:看 NUMA 拓扑
numactl --hardware典型输出:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 ... 31 64 65 ... 95
node 0 size: 524288 MB
node 0 free: 489012 MB
node distances:
node   0   1
  0:  10  21
  1:  21  10
node distances 是 NUMA 距离矩阵:对角线 10 表示本地访问;21 表示远程访问大约慢 2.1 倍。>20 就要警惕跨 NUMA 访问了。
5.2 查看进程的 NUMA 内存分布
# 看某个进程在各 NUMA 节点的内存分配
numastat -p <pid>
# 或者看所有进程的简略统计
numastat
5.3 绑定进程到本地 NUMA
# 在 NUMA 0 上运行,并从 NUMA 0 分配内存
numactl --cpunodebind=0 --membind=0 ./app
# preferred:优先本地,本地不够时允许远程
numactl --cpunodebind=0 --preferred=0 ./app为什么绑定:如果线程在 Socket 0 跑,但内存都分配到 Socket 1,每次访问内存都要跨 UPI/GMI,性能可能直接打对折。
六、dmidecode:看内存、BIOS、系统信息
6.1 内存信息
# 看内存条类型、频率、容量、插槽位置
sudo dmidecode -t memory | grep -E "Locator:|Size:|Type:|Speed:|Configured Memory Speed:|Manufacturer:|Part Number:"
关键字段:
| 字段 | 含义 |
|---|---|
Locator | 物理插槽位置,如 P1-DIMMA1 |
Size | 单条容量 |
Type | DDR4 / DDR5 / LPDDR5 |
Speed | 内存标称频率 |
Configured Memory Speed | 实际运行频率(可能低于标称) |
Manufacturer / Part Number | 品牌型号 |
常见陷阱:
Speed标 4800 MT/s,但Configured Memory Speed只 4000 MT/s,说明 BIOS 里没开 XMP 或 JEDEC 默认配置,内存跑不满。
6.2 看系统/BIOS 信息
sudo dmidecode -t system   # 厂商、型号、序列号
sudo dmidecode -t bios     # BIOS 版本、日期
sudo dmidecode -t processor # CPU 规格
七、perf + uncore 计数器:看总线级瓶颈
7.1 常用 perf 事件
# 看跨 NUMA 内存访问
perf stat -e node-loads,node-load-misses,node-stores,node-store-misses ./app
# 看内存控制器吞吐(Intel 示例)
perf stat -e uncore_imc/cas_count_read/,uncore_imc/cas_count_write/ ./app
# 看 PCIe 带宽(需要具体型号的 uncore PMU 事件)
# 不同 CPU 的事件名不同,先用 perf list | grep pcie 查看
7.2 看 Uncore 频率
# 读取 Uncore 频率(Intel MSR)
rdmsr -p 0 0x620
# 或用 turbostat 看
turbostat --interval 1
Uncore 频率(Mesh/Ring 频率)对 IMC/PCIe 延迟都有影响。如果 Uncore 被功耗管理压低,内存访问和 PCIe 访问的延迟都会上升。
八、诊断路径速查表
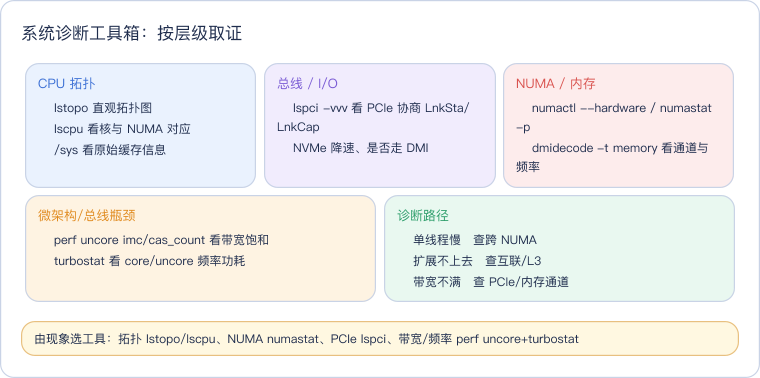
| 现象 | 可能原因 | 先用哪个工具 | 看什么 |
|---|---|---|---|
| 单线程性能低于预期 | 跨 CCD/跨 Socket 内存访问、远程 NUMA | lstopo / numactl --hardware | 线程和内存是否在同一 NUMA 节点 |
| 多线程扩展不上去 | 片内互联/Ring 带宽瓶颈、L3 竞争 | perf stat uncore 事件 | uncore_imc/cas_count_* 是否饱和 |
| NVMe 带宽跑不满 | PCIe 链路协商降速、挂 Chipset 共享 DMI | lspci -vvv / fio | LnkSta vs LnkCap;是否走 DMI |
| 跨 NUMA 性能波动 | 内存分配到远程节点 | numastat -p <pid> | local/remote 内存比例 |
| 游戏/实时程序卡顿 | CPU 频率被功耗墙限制、Uncore 降频 | turbostat | 查看 core/uncore 频率、功耗 |
| 内存带宽不足 | 通道未插满、频率未跑满 | dmidecode -t memory | Configured Memory Speed、通道数 |
九、一句话总结
系统架构优化不是玄学:先用
lstopo/lscpu看清拓扑,用 numactl 确认 NUMA 距离,用lspci检查 PCIe 链路,用dmidecode确认内存配置,用 perf 看 uncore 计数器——一套工具下来,CPU 忙不忙、内存远不远、PCIe 快不快、跨 NUMA 重不重,都会有明确答案。
关联:cpu-bus-architecture(导读)、cpu-physical-hierarchy(物理层次)、core-and-uncore(核心与 Uncore)、off-chip-buses(片外总线)、numa(NUMA 拓扑)