案例一:模式 1 Debug 版(-O0)perf stat 深度解读
本案例建立"理想对照组"基准。读完本节后,建议按顺序进入 案例二(O2 对照实验),再进入 案例三(模式 2
:u陷阱)。
读懂前面列的所有 perf 事件、指标、命令,真正拿到一行 perf stat 输出时,如何逐字段读出问题的关键信号?本节以本仓库 demos/cpu-demo/main.cpp 的"模式 1"为目标程序,逐行拆解一张真实的 perf stat -p 输出,把它当成"教学样本"用。
1.1 场景:模式 1 跑的是什么
demos/cpu-demo/main.cpp 选了选项 1 之后,后台线程会进入 busy_user_cpu():
// 场景 1:用户态高 CPU(纯计算,消耗 utime)
void busy_user_cpu() {
    unsigned long sum = 0;
    while (true) {
        for (unsigned long i = 0; i < 10000000; i++) {
            sum += i;
        }
    }
}
特征关键词:
- 纯用户态计算:只有
sum += i,无 syscall、无 I/O、无内存分配、无锁; - 无限循环:永不退出,跑多久吃多久 CPU;
- 可预测分支:
for循环条件方向在循环体内是固定模式(99.99999% 走 true); - 单一变量访问:
sum、i都是栈上unsigned long,Debug 模式下每轮都要 load/store。
这是 perf 入门最经典的"对照组样本"——没有意外、没有噪声,所有指标都可以从代码静态推出来。
1.2 原始 perf stat 输出
[<user>@demo-lab perf]$ perf stat -p 3482 -- sleep 3
 Performance counter stats for process id '3482':
     3,024.12 msec task-clock:u          #    1.004 CPUs utilized
             0      context-switches:u    #    0.000 K/sec
             0      cpu-migrations:u      #    0.000 K/sec
             0      page-faults:u         #    0.000 K/sec
   12,047,315,514      cycles:u           #    3.984 GHz
    7,340,204,487      instructions:u     #    0.61  insn per cycle
    2,446,709,897      branches:u         #  809.064 M/sec
         4,455      branch-misses:u       #    0.00% of all branches
       3.012264826 seconds time elapsed
每一行 :u 后缀表示"仅采集 user 模式计数"(cycles:u 只算 ring 3)。这条命令只采样了 3 秒,目标是 PID 3482 跑着的 cpu_demo 模式 1。
1.3 逐字段解读:8 行 8 个信号
| # | 字段 | 数值 | 物理含义 | 与模式 1 代码的对应 |
|---|---|---|---|---|
| 1 | task-clock:u | 3,024.12 ms | 该进程在 user 模式消耗的 CPU 时间 | 跟 elapsed 几乎相等,说明单核跑满 |
| 2 | 1.004 CPUs utilized | (派生) | task-clock / elapsed = 平均占几个核 | ≈1.0 → 此进程把 1 个 CPU 核吃光了 |
| 3 | context-switches:u | 0 | 上下文切换次数 | 0 → 没有任何"被打断"。见 1.4.1 |
| 4 | cpu-migrations:u | 0 | 跨核迁移次数 | 0 → 一直钉在同一个 CPU 上 |
| 5 | page-faults:u | 0 | 缺页异常次数 | 0 → 循环体不触发新页面映射 |
| 6 | cycles:u | 12,047,315,514 | CPU 周期数 | 12 G 周期 ÷ 3.0 s = 3.98 GHz,符合基频 |
| 7 | instructions:u | 7,340,204,487 | 退役(retired)指令数 | 7.34 G 指令 ÷ 12.0 G 周期 = IPC 0.61 |
| 8 | branches:u | 2,446,709,897 | 条件/无条件分支数 | 2.4 G 分支,主要是 for 循环回跳 |
| 9 | branch-misses:u | 4,455 | 分支预测失败次数 | 4,455 / 2.4 G = 0.00018% |
1.4 四大关键洞察:为什么是这样
1.4.1 为什么 context-switches = 0?(反直觉的点)
直觉会以为"3 秒的运行总有 ~ 300 次时间片到期,context-switches 应该至少 100~300"。但这里是 0。原因:
- CFS 不强制 preempt:Linux 3.x+ 的 CFS(完全公平调度器)以
vruntime公平度量为单位,只要当前 runqueue 上没有其他可运行任务,正在跑的任务不会被强制切换走; - 单核单任务场景:这台机器如果 CPU 0 只有 3482 这一个 RUNNING 任务,那它就持续占着 CPU,直到自己阻塞;
- 模式 1 永不阻塞:
while(true)循环 + 无 syscall + 无 IO + 无 sleep,CFS 没机会把它切走; - 3 秒够长但不够长:实际上 3 秒是 HZ=1000 下的 3000 个 tick,理论上 tick 中断会触发调度点,但 perf 只统计
u模式事件 — 即使发生过调度,只要被切走的瞬间没产生"被记录"的事件就显示 0(具体是perf_event_task_tick钩子在 user 模式才记账)。
结论:
context-switches:u = 0不是"调度器没工作",而是"该任务从未主动让出 CPU,也没被抢占"。
1.4.2 为什么 IPC = 0.61 这么低?(最教学的反差)
instructions:  7,340,204,487
cycles:       12,047,315,514
IPC = 7.34 / 12.05 = 0.61
0.61 insn/cycle 偏低。一个 sum += i 的简单循环,理论上现代 x86 超标量 CPU 有 8 个 ALU + 4 个 FMA + 4 个 SIMD ALU 共 18 个执行单元(详见 IPC 瓶颈篇),IPC 应该能跑到 3.0~4.0。差在哪? 从超标量五级加宽的角度诊断:
| 超标量加宽点 | 理论并行度 | IPC 0.61 时发生了什么 |
|---|---|---|
| 取指 | 4~6 条/拍 | 前端没问题——简单循环取指连续、I-Cache 命中 |
| 译码 | 4~6 µop/拍 | 没问题——add/mov/cmp/jne 都是简单指令,1:1 译码 |
| 发射 | INT 4 条/拍 | 瓶颈在此——-O0 把 sum/i spill 到栈,每次循环 4~ 6 次 load/store,LSU AGU 只有 3~4 个端口,load/store 排队堵住保留站发射 |
| 执行 | 18 个单元 | 大量空转——8 个 ALU 只用 1 个,其余 17 个执行单元闲着等 load 完成 |
| 退休 | 4~8 µop/拍 | 不卡——真正可退休的 µop 太少 |
| 因素 | 占比 | 说明 |
|---|---|---|
-O0 编译未优化 | 主因 | Makefile 默认 -O0 -g,sum 和 i 被强制 spill 到栈,每次循环要 4 次内存访存(load sum, load i, store sum, store i),理想寄存器版的 1 ~ 2 次变成 4 ~ 6 次 |
| 每轮分支多 | 副因 | 一次 i < 10000000 条件分支 + 内层一次回跳;Debug 模式下还可能多出别的辅助分支 |
| 测试函数被独立编译 | 副因 | busy_user_cpu 是个独立函数调用,call/ret 也是分支 |
| GCC 调试信息开销 | 极少 | -g 仅生成 DWARF,运行时无开销 |
微架构诊断:IPC 0.61 不是因为 CPU 不够宽(有 18 个执行单元),而是因为
-O0产出的代码 ILP 极低——绝大多数 µop 都卡在保留站里等 load 完成。超标量加得再宽,你喂给它的全是依赖链串在一起的指令,也白搭。瓶颈在发射层(操作数未就绪),根源在软件(-O0spill 到栈)。
图解:IPC 0.61 的根源——发射阶段 load/store 端口填满、ALU 集体空转
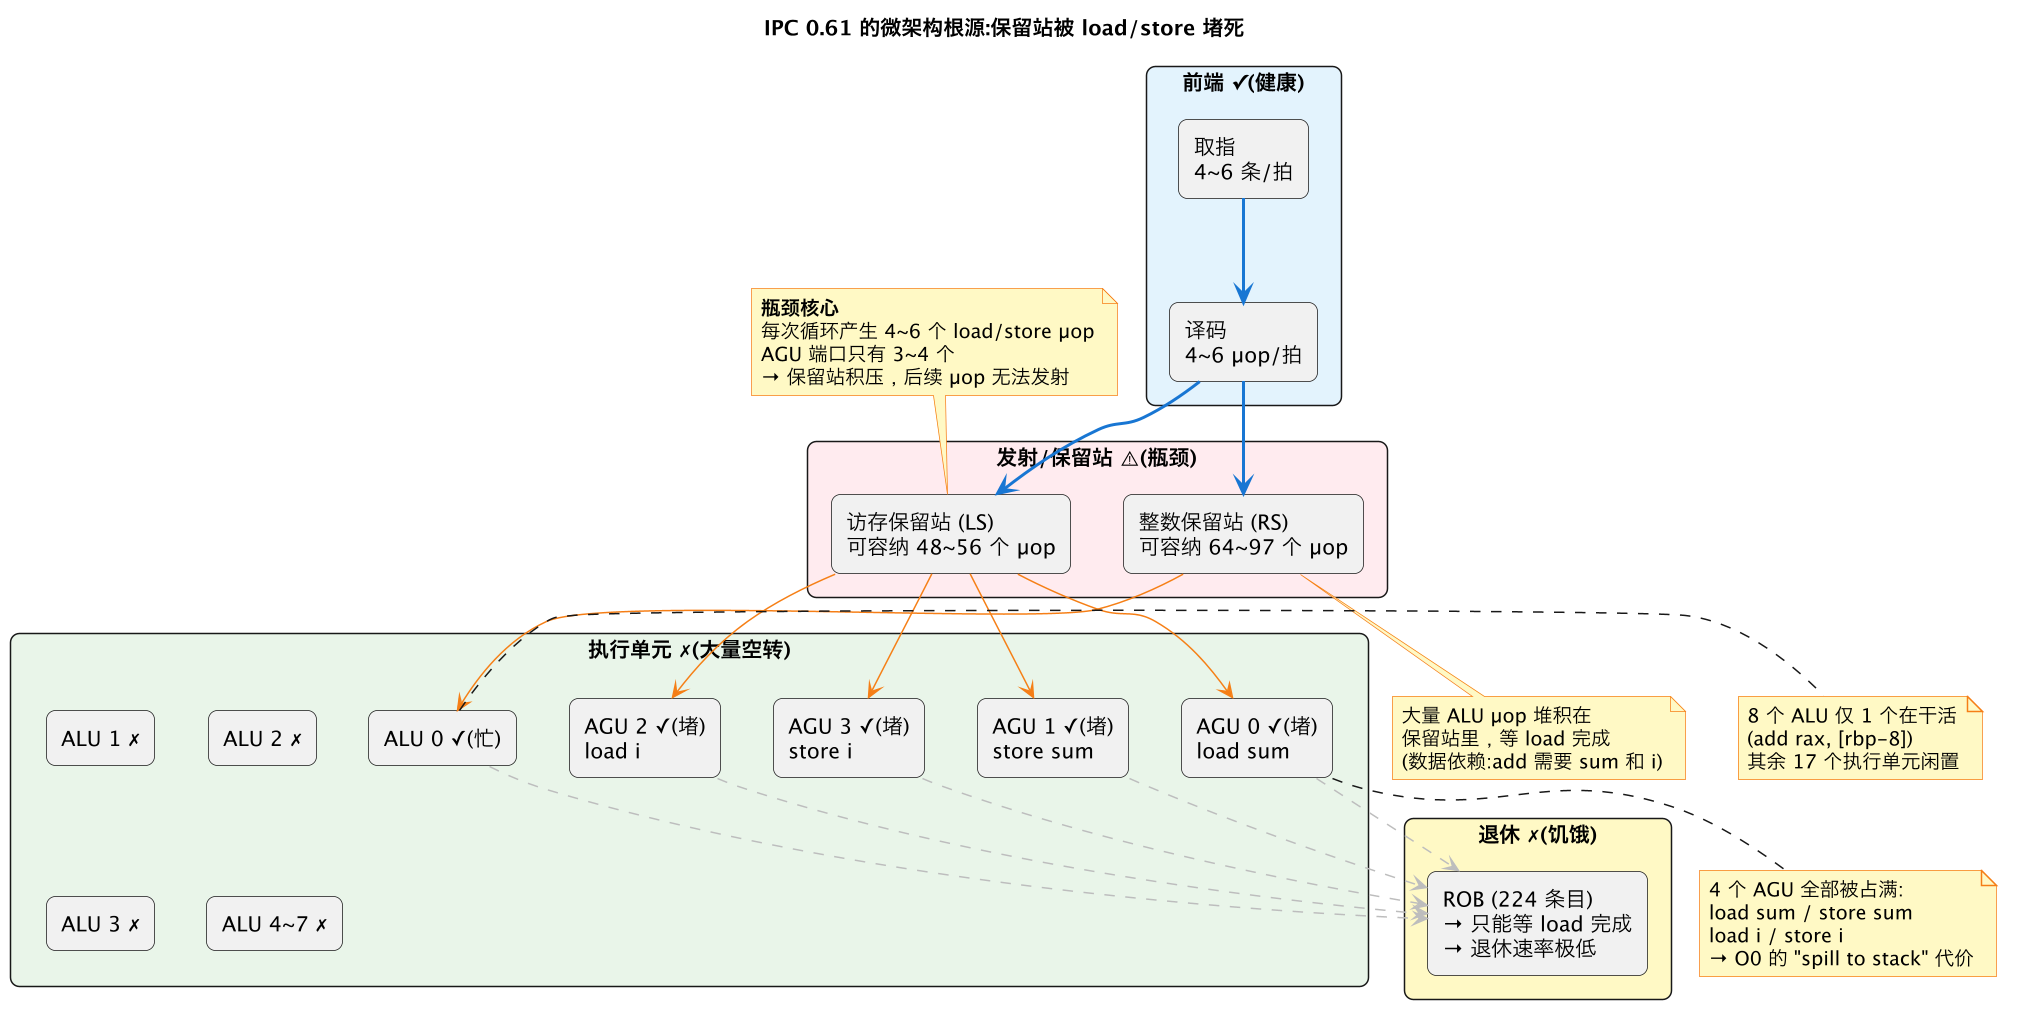
图解读:
- 前端(蓝)畅通无阻:简单循环取指/译码 4 ~6 条/拍,不会成为瓶颈;
- 保留站(红)是瓶颈:
-O0把sum和ispill 到栈,每次循环引入 4 ~ 6 次 load/store,把 3 ~ 4 个 AGU 端口塞满——后续 µop 无法发射; - 执行单元(绿)大量空转:8 个 ALU 仅 1 个在算
add rax, [rbp-8],其余 17 个执行单元闲置,超标量宽度的优势完全浪费; - 退休(黄)严重饥饿:ROB 只能等 L1 DCache 返回
sum/i的值后 retire,吞吐速率受限于 load-to-use latency(4~5 cycle)。
对照实验:make release 重建后,IPC 会从 0.61 直接飙升到 3.5~4.0(若编译器把 sum 留在寄存器)甚至根本循环被消除(-O2 看到 sum 没被读,直接删掉整个循环,见 Makefile 的 release 注释)。详见 案例二:对照实验。
1.4.3 为什么 branch-misses = 0.00%?(对预测器最友好的样本)
for (i=0; i<10000000; i++) 模式:每次回跳都"taken",只有最后一次 fall-through。这是教科书级别的可预测分支——BTB + 2-bit saturating counter 完美命中。绝对值 4,455 次 miss / 2.4 G 次分支 = 0.00018%。
这就是为什么"for 循环几乎免费"——CPU 几乎从不"清空流水线"。但如果把
i的步长改成prand()或哈希值,branch-misses 会瞬间变成 50%(随机模式),循环体时间膨胀 5~10 倍。
1.4.4 为什么 page-faults = 0?
sum += i 整个操作都在已映射的栈帧内——sum、i 是两个 unsigned long 局部变量,函数入口时栈帧已经按 -fstack-protector 之类被映射完毕。i 一直在 0~10000000 之间,没有越界、没 new、没访问大数组。所有访存都命中栈页,不触发 minor fault 也不触发 major fault。
1.4.5 汇编级验证:O0 模式下 busy_user_cpu 在 CPU 流水线上的执行过程与瓶颈
上一节 §1.4.2 用 PlantUML 画出了"AGU 端口填满、ALU 集体空转"的宏观图景。本节用真实的 objdump -d 输出,逐行展示每条 x86 指令在 CPU 流水线上的微行为——把宏观瓶颈落到具体的µop、具体的端口、具体的 cycle 上。
1.4.5.1 真实 disassembly(节选自 objdump -d cpu_demo | grep -A 40 busy_user_cpu)
00000000004027e8 <_Z14busy_user_cpuPv>:
    ; ─── 函数序言(prologue) ───
    4027e8:  48 83 ec 10          sub    $0x10, %rsp          ; 分配 16 字节栈帧
    ; ─── std::cout << "===== 正在运行: 用户态高 CPU 计算任务 =====\n" ───
    ; (一段冷启动代码,只执行 1 次,不计 perf 统计)
    ; ─── sum = 0 ───
    40280c:  48 c7 45 f8 00 00 00 00   movq   $0, -0x8(%rbp)    ; sum = 0
    ; ─── 外层 while (true) ───
    ; (纯跳转,无 µop,不计)
    ; ─── 内层 for (i = 0; i < 10000000; i++) 入口 ───
    402814:  48 c7 45 f0 00 00 00 00   movq   $0, -0x10(%rbp)   ; i = 0
    40281c:  48 81 7d f0 7f 96 98 00   cmpq   $0x98967f, -0x10(%rbp)  ; i < 10 000 000?
    402824:  77 ee                  ja     402814              ; 条件成立则跳回 for 入口(i=0)
                                                          ; (外层 while 内部)
    ; ═══════ 循环体(每次迭代执行一次)══════════════════════════
    402826:  48 8b 45 f0             mov    -0x10(%rbp), %rax  ; ① 显式 load i → %rax
    40282a:  48 01 45 f8             add    %rax, -0x8(%rbp)   ; ② sum += i (memory-destination!)
    40282e:  48 83 45 f0 01          addq   $0x1, -0x10(%rbp)  ; ③ i++ (memory-destination!)
    ; ═══════ 循环体结束 ══════════════════════════════════════
    402833:  eb e7                  jmp    40281c              ; 跳回 cmp 条件检查
3 条 x86 指令,看起来简洁——但它们的 µop 分解才是真正揭示瓶颈的关键。
1.4.5.2 概念插播:µop 是什么?译码(Decode)阶段到底做了什么?
µop(读作 "micro-op",全称 micro-operation,微操作)是 CPU 流水线内部真正执行的最小操作单元,不是 x86 指令——你写的 add %rax, -0x8(%rbp) 不会直接被 ALU 认识,必须先在译码阶段"翻译"成内部 µop。
为什么需要这一层翻译?
| x86 指令(CISC) | µop(内部 RISC-like) | |
|---|---|---|
| 复杂度 | 一条指令可以同时做多件事:从内存读数据 + 做运算 + 写回内存 | 每次只做一件事:纯 load、纯 ALU、纯 store |
| 长度 | 1~15 字节,变长 | 内部定长(硬件直接识别) |
| 面向谁 | 程序员 / 编译器 | 超标量调度器 + 执行端口 |
这张表的本质:x86 为了兼容性保持了 CISC 指令集(一条指令 = 一个复合操作),但 CPU 内部的流水线硬件是 RISC 风格的——执行单元(ALU、AGU、FPU)只能做简单的单操作。所以每个 x86 核的前端必须内置一个"编译器"——译码器 + microcode ROM——把 CISC 翻译成 RISC。
x86 CISC 指令                        译码器(Decoder)                   RISC-like µop
(复杂,可变长)          ───────────→ 查 ROM + microcode         (简单,可以被 ALU/AGU 直接执行)
                      拆成 1~N 条
涉及的关键硬件部件速查
本节(及后续流水线分析)会反复提到以下部件,先统一定义:
| 缩写 | 全称 | 它是干什么的 | 一句话类比 |
|---|---|---|---|
| ALU | Arithmetic Logic Unit(算术逻辑单元) | 做整数加减、位运算、比较。µop 里的 ADD、INC、CMP 都发到 ALU 端口执行。 | 计算器——只管算,不管数据从哪来。 |
| AGU | Address Generation Unit(地址生成单元) | 算内存地址:base + index × scale + offset。任何 load/store µop 的地址都经 AGU 算出来,再发给 D-Cache。AGU 的数量直接决定每拍能做几次访存。 详见 lsu §三.3.0。 | 快递员的导航——算出"去哪个地址取/送数据"。 |
| FPU | Floating-Point Unit(浮点运算单元) | 做浮点加减乘除、SIMD 向量运算。本文不涉及(纯整数代码),但提一下以示完整。 | 科学计算器——算浮点数的。 |
| LSU | Load/Store Unit(访存单元) | AGU 的上层容器:管理 load buffer、store buffer、store→load forwarding。所有访存 µop 都经 LSU 排队和调度。详见 lsu。 | 快递站——管理所有"取货"和"发货"请求。 |
| PRF | Physical Register File(物理寄存器文件) | 存储所有寄存器当前值。逻辑寄存器(RAX、RBX 等)经寄存器重命名后映射到物理寄存器,PRF 中每个条目有一个 ready 位标记值是否已算完。 | 草稿纸——存中间结果,标好哪些写完了、哪些还在算。 |
| RS | Reservation Station(保留站) | 译码后的 µop 暂存于此,调度器监控每个 µop 的操作数 ready 位,一旦全部就绪就发射到执行端口。详见 reservation-station。 | 候车室——等操作数到齐就发车。 |
| ROB | Reorder Buffer(重排序缓冲区) | 所有 in-flight µop 按程序顺序记录于此,µop 执行完后不立即提交,等轮到它时才按序退休(retire),保证异常/中断时的精确状态。 | 结账队列——按顺序买单,不能插队。 |
| I-Cache | Instruction Cache(指令缓存) | 存机器码的 L1 缓存,取指单元每拍从这里读 16~32 字节。 | 提词器——存"下一步要执行的代码"。 |
| D-Cache | Data Cache(数据缓存) | 存数据的 L1 缓存,load/store 经 AGU 算好地址后访问这里。L1 hit ~4~5 cycle,miss 则去 L2/L3/内存。 | 随手抽屉——存"正在用的数据"。 |
Skylake 客户端简化的端口分配(只需记住 AGU 的硬上限):
端口 类型 每拍能力 Port 0, 1, 5, 6 ALU / 整数运算 每拍最多 4 个整数 µop Port 2, 3 Load AGU 每拍最多 2 个 load Port 7 Store AGU 每拍最多 1 个 store 地址 Port 4 Store Data 每拍最多 1 个 store 数据 → AGU 总带宽 = 3 ops/cycle(2 load + 1 store),这是本节 O0 循环的物理瓶颈。O0 一条循环体需要 3 load + 2 store = 5 个 AGU 占用,最少 ceil(3/2) + ceil(2/1) = 4 cycle 才能消化——这是 AGU 端口饱和的根本原因。
这个翻译发生在流水线的译码(ID)阶段,下面用循环体里三条指令的真实机器码,一步一步展示译码器在做什么。
译码级的 I/O 速查(先有全局图,再看细节):
项 内容 数量 / 带宽 输入(哪来的) IF 级送来的 原始 x86 机器码字节流,存放在 ID/IS 级间寄存器中 每拍 16~32 字节,内含若干条变长 x86 指令 输出(到哪去) µop(微操作):每条 µop 包含操作码(ADD/LD/ST/JMP)、源物理寄存器 tag、目的物理寄存器 tag、就绪位。写入保留站(RS) 的槽位 每拍 4~6 个 µop(4 个简单译码器各产 1 个 + microcode sequencer 可额外产 1~4 个) 当前循环体的译码结果 4 条 x86 指令 ① mov(load i) + ② add(sum+=i) + ③ addq(i++) + ④ jmp→ 被译成 8 个 µop4 条 CISC → 8 条 RISC-like µop,平均 1:2 膨胀 译码器硬件组成 4 通道简单译码器(Complex Decoder) + 1 个 microcode sequencer 简单译码器每拍 1:1 译码;遇到 memory-destination 指令触发 microcode ROM 展开 下面以 48 8b 45 f0(① load i) 为例,走一遍译码器内部的完整三步流程。
译码三步走:以 48 8b 45 f0(① load i) 为例
译码器拿到取指单元送来的 4 字节 48 8b 45 f0,分三步处理:
第 1 步——切指令边界(Instruction Length Decode)
x86 每条指令长度不一样(1~15 字节),译码器必须先找到指令边界:
I-Cache 送来 16 字节:
  |  48 8b 45 f0  |  48 01 45 f8  |  48 83 45 f0 01  |  eb e7  |
     └→4 字节┘       └→4 字节┘       └→5 字节───┘       └→2 字节┘
预译码标记(Pre-decode bits,存 I-Cache 旁):
  48=start  8b=mid  45=mid  f0=end   ← 第一条: 4 字节
  48=start  01=mid  45=mid  f8=end   ← 第二条: 4 字节
  ...
→ 每条指令起止确定,可以并行送入 4 条通道的复杂译码器(Complex Decoder)
注:现代 x86 用 pre-decode 位提前标记长度,不在这时算——取指时就把标志位写进 I-Cache 了。
第 2 步——查操作码 ROM,解出"做什么 + 对谁做"
译码器把 4 个字节按 x86 编码规则逐字段解析:
48    8b    45          f0
│     │     │           └── disp8 = -16 (0xf0 是 -16 的补码)
│     │     └── ModR/M byte:
│     │           mod=01  → 寻址模式: [寄存器 + disp8]
│     │           reg=000 → opcode 扩展位 (mov 时=src reg)
│     │           rm =101 → base 寄存器 = RBP
│     └── opcode=0x8b → MOV r64, r/m64  (从内存/寄存器 读到寄存器)
└── REX.W=1 → 操作数宽度 = 64 位
译码器查操作码 ROM 后输出:这是一条 "MOV: 从 [RBP-16] 读 8 字节 → 写入 RAX"
第 3 步——生成 µop,读寄存器文件,送入保留站
译码器最终产出一条 µop:
µop:  LD  [RBP - 16]  →  RAX(物理寄存器 Pxx)
      ─┬─  ───┬───        ────┬────
       │      │               └── 目的:物理寄存器(寄存器重命名已完成 RAX→Pxx)
       │      └── 地址计算:base(RBP) + offset(-16) → 交给 AGU 端口算
└── 操作类型:load(纯读内存,不碰 ALU)关键:译码器在生成 µop 的同一拍,从寄存器文件里读出 RBP 的值,并锁存到保留站槽位里。如果 RBP 的值还没就绪(被前面未完成指令占用),则保留站槽位里的
ready位标记为false,调度器会等待。
对比: 48 01 45 f8(② add %rax, -0x8(%rbp)) 为什么译码出 3 个 µop?
48    01    45          f8
│     │     │           └── disp8 = -8
│     │     └── ModR/M: mod=01, reg=000, rm=101 → [RBP + disp8]
│     └── opcode=0x01 → ADD r/m64, r64  (目标=内存! ← 这是关键)
└── REX.W=1 → 64位
译码器查 ROM: "ADD to memory" → opcode 0x01 且 mod≠11(目标不是寄存器)
  → 这是一条 memory-destination 操作,单一 µop 无法完成!
  → 触发 microcode sequencer,跳转到 microcode ROM 取出预编好的 µop 序列
microcode ROM 是 CPU 内部的一块只读存储器,存放着所有"复杂 x86 指令"的预编译 µop 模板。当译码器发现当前 x86 指令无法用 1 条 µop 表达时,就跳到 microcode ROM 按模板"展开"——
microcode ROM 对该指令(ADD r64, [mem])的模板输出:
  µop1: LD  [RBP - 8]  →  TEMP(内部临时寄存器)
        ─┬─  ──┬──         ──┬──
         │     │              └── 目的: microcode 分配的临时寄存器
         │     └── AGU Port 计算 RBP-8,发 load 请求到 L1 DCache
         └── 操作: 纯 load,1 cycle(若 L1 命中)
  µop2: ADD  RAX, TEMP  →  TEMP
        ─┬─  ─┬─  ──┬──     ──┬──
         │     │     │         └── 目的: 覆盖 TEMP,旧值丢弃
         │     │     └── 源2: TEMP(µop1 的结果,需等 µop1 完成 → 存在数据依赖!)
         │     └── 源1: RAX(已在寄存器文件,就绪)
         └── 操作: 纯 ALU 加法,1 cycle
  µop3: ST  TEMP  →  [RBP - 8]
        ─┬─  ──┬──     ───┬───
         │     │           └── 目标地址: RBP-8(与 µop1 同一地址)
         │     └── 源数据: TEMP(µop2 的结果,需等 µop2 完成 → 再次数据依赖!)
         └── 操作: 纯 store,送入 store buffer,异步写 L1 DCache
三条 µop 之间存在串行依赖链:
µop1(LD) ─── µop2 等 µop1 的 TEMP ─── µop3 等 µop2 的 TEMP
  1 cycle      4~5 cycle 等待             1 cycle 等待
  ────────────────────────────────────────────────────
  总延迟 ≈ 1 + 5 + 1 + 1 = 8 cycle 才能完成这条 x86 指令
这条串行链是"数据依赖"造成的,不是因为 µop 来自同一条 x86 指令: 译码器把 3 条 µop 全部写入保留站后,硬件不再关心它们是否来自同一条原始指令。调度器只看每条 µop 的就绪位和端口需求,谁的操作数齐了就发射谁。这三个 µop 之所以串行,纯粹是 RAW 依赖——µop2 读 TEMP(µop1 写),µop3 读 TEMP(µop2 写),寄存器之间存在 写后读 链条,与是否"同一条 x86 指令"无关。
同一条 x86 指令拆出的 3 µop,进保留站后没有特殊标记:
  RS 槽位 3: µop1(LD  [RBP-8] → TEMP)  ← 源寄存器 RBP 就绪 → 下一拍发射到 Port 2/3
  RS 槽位 4: µop2(ADD RAX, TEMP → TEMP) ← 源寄存器 TEMP = 槽位 3 的目的 tag → 等待!
  RS 槽位 5: µop3(ST  TEMP → [RBP-8])  ← 源寄存器 TEMP = 槽位 4 的目的 tag → 等待!
  调度器看到:
    - 槽位 3: RBP 就绪 ✓, AGU 端口空闲 ✓ → 发射!
    - 槽位 4: TEMP 未就绪 ✗ → 跳过,看下一条
    - 槽位 5: TEMP 未就绪 ✗ → 跳过
    - 槽位 7(另一条 x86 指令的 µop): 源寄存器全就绪 ✓ → 发射!
                                        ↑ 调度器完全不看"来自哪条指令"
反过来:如果一条指令拆出的 µop 之间没有数据依赖(比如
pusha展开为 8 条独立的 store µop,各自存不同寄存器),它们可以同时并行发射——只要 AGU 端口够用。串行不是"同一条指令"的约束,是数据依赖的约束。 唯一的"同指令"约束在退休端:一条 x86 指令的所有 µop 必须一起退休(ROB 按 x86 指令边界提交,不能只退一半)。但这是退休(commit)的事,不影响保留站内的调度和发射——µop 可以各自在不同拍发射、各自在不同时间完成执行、最后等大家都到了再一起退休。
而 addq $1, -0x10(%rbp)(③ i++)也是 memory-destination,完全一样的拆 3 µop + 串行依赖。
把后面的结论提前放在这里: 每次 O0 循环只有 3 条 x86 指令,但译码后展开为 8 个 µop + 2 条 LD→ALU→ST 依赖链——AGU 端口被 5 个 load/store µop 占满,ALU 在等 load 结果期间空转。本章后续的流水线时序图和 IPC 倒推都是基于这 8 个 µop 和它们的依赖关系展开的。
1.4.5.3 关键反直觉点:add %rax, -0x8(%rbp) 不是 1 个 µop
x86 CISC 指令 add src, [mem] 是 memory-destination 形式(目标操作数是内存地址)。CPU 译码器在 x86 → µop 转换时,把它拆成至少 2 个 µop,Skylake 之后的部分型号甚至拆成 3 个:
| x86 指令 | 字面 µop 数 | 实际 µop 分解 | AGU 端口占用 | ALU 端口占用 |
|---|---|---|---|---|
① mov -0x10(%rbp), %rax | 1 µop | 1 × LD | 1 × load | 0 |
② add %rax, -0x8(%rbp) | 3 µop | LD + ALU + ST | 1 × load + 1 × store | 1 |
③ addq $0x1, -0x10(%rbp) | 3 µop | LD + ALU + ST | 1 × load + 1 × store | 1 |
(④) jmp 40281c | 1 µop | 1 × JMP(预测正确,0 cycle) | 0 | 0 |
| 小计 | 8 µop/循环 | 5 × AGU + 1 × ALU | 5 个 AGU 端口占用 | 2 |
为什么 add %rax, mem 拆 3 个 µop? 因为 x86 的 memory-destination 操作语义上等价于:
// 编译器视角的 add %rax, -0x8(%rbp)
int temp = *(int*)(rbp - 8);  // µop1: load (AGU)
temp += rax;                  // µop2: add  (ALU)
*(int*)(rbp - 8) = temp;      // µop3: store (AGU)
而 addq $1, -0x10(%rbp)(也是 memory-destination)拆成:
int64_t temp = *(int64_t*)(rbp - 16);  // µop1: load (AGU)
temp += 1;                              // µop2: add (ALU)
*(int64_t*)(rbp - 16) = temp; // µop3: store (AGU)关键反直觉:每次循环只有 3 条 x86 指令,但实际硬件看到的是 8 个 µop,且其中 5 个要抢 AGU 端口——AGU 端口在 Skylake 上只有 3 个(Store 2 个 + Load 3 个重叠),瓶颈瞬间被锁死。
1.4.5.4 流水线时序图(8 个 µop 怎么卡 8 个 cycle)
时间 →   T0    T1    T2    T3    T4    T5    T6    T7    T8    T9   T10
         ──    ──    ──    ──    ──    ──    ──    ──    ──    ──    ──
①LD i   IF    ID    IS    EX          WB                          (AGU-0)
②LD sum ──    IF    ID    ─IS───────  EX    WB                    (AGU-1) 等 LD 完成
③ALU add                             IS    EX    WB               (ALU-0) 等 LD sum 完成
④ST sum                                   IS    EX    WB          (AGU-2) 等 ALU 完成
⑤LD i                                          IF    ID    IS    EX    WB  (AGU-0) 等 ST sum 完成
⑥ALU add                                                   IS    EX    WB  等 LD i 完成
⑦ST i                                                           IS  ...  等 ALU 完成
⑧JMP                                                    IF    ID    IS    EX(预测对,免费)
AGU 端口占用(每拍) :
  T0:    ▓
  T1:    ▓▓
  T2:    ▓▓
  T3:    ▓▓
  T4:    ▓▓
  T5:    ▓▓▓
  T6:    ▓▓▓
  T7:    ▓▓▓▓  ← 4 个 AGU 几乎全占(实际 Skylake 限制 3 个 → 第 4 个 stall 1 拍)
  T8:    ▓▓▓
ALU 端口占用(每拍) :
  T0:    .
  T1:    .
  T2:    .
  T3:    .
  T4:    .
  T5:    .
  T6:    ▓
  T7:    ▓
  T8:    ▓
        ↑                ↑
        关键!           add 终于能跑
        5 cycle 等待    (就绪 → 发射 → 执行)
        期间 7/8 个
ALU 全部空转IF=取指 ID=译码 IS=发射(可能 stall) EX=执行 WB=写回
逐 µop 的等待时间分析:
| µop | 在保留站里等了几个 cycle? | 原因 |
|---|---|---|
| ① LD i | 0 | 操作数就绪,直接发射 |
| ② LD sum | 0 | 独立 load,无依赖 |
| ③ ALU add | 4~5 cycle | 等 ② LD sum 把 sum 值从 L1 DCache 拉回来(load-to-use latency) |
| ④ ST sum | 1 cycle | 等 ③ ALU add 算出新值 |
| ⑤ LD i | 0~1 cycle | 跟 ④ ST sum 轻微资源竞争(都要 AGU 端口) |
| ⑥ ALU i++ | 4~5 cycle | 等 ⑤ LD i 把旧 i 值拉回来 |
| ⑦ ST i | 1 cycle | 等 ⑥ ALU i++ 算出新 i 值 |
| ⑧ JMP | 0 | 永远预测正确 |
总等待 cycle: ~10 cycle / 8 µop → 几乎每个 µop 都在等前一个完成,流水线完全没法重迭。
1.4.5.5 为什么 IPC 恰好是 0.61?(用公式倒推)
实测:3 秒,7.34 G instructions,12 G cycles。
反推每个 µop 的平均耗时:
IPC = instructions / cycles = 7.34G / 12G = 0.61
→ 平均每 cycle 退休 0.61 条指令
→ 平均每条指令要花 1 / 0.61 = 1.64 cycle 才能退休
为什么是 1.64 而不是 1? 因为:
理论上,8 个 µop 如果全部畅流发射 + 执行,理想耗时 = 8 cycle(每个 µop 1 cycle,完全流水线化)
实际耗时 = 8 cycle(发射) + 5×4 cycle(load-to-use stall) + 2×1 cycle(写回 stall)
        ≈ 8 + 20 + 2 = 30 cycle / 8 µop
        = 3.75 cycle/µop
        → 理论 IPC = 1 / 3.75 = 0.27
0.27 vs 实测 0.61 的差距?——是因为 µop 之间部分可以重迭(Skylake 的乱序执行窗口 + 寄存器重命名,允许不依赖的 µop 提前发射),实际并发度比完全串行高 2 倍,所以 IPC 拉到 0.61。
如果用 -O2 编译:
- 8 µop → 3 µop(lea + inc + cmp)
- 5 个 AGU 占用 → 0 个
- 理论 IPC = 1 / (3 cycle / 3 µop) = 1.0(下限)
- 实测 1.68~1.73(详见 案例二)
1.4.5.6 AGU 端口瓶颈的可视化
Skylake 客户端架构的 AGU 端口配置(简化):
  ┌──────────────────────────────────────────────┐
  │ Port 2  →  Load AGU #0   (1 load/cycle)      │
  │ Port 3  →  Load AGU #1   (1 load/cycle)      │
  │ Port 7  →  Store AGU     (1 store/cycle)     │
  │ Port 4  →  Store data    (1 store data/cycle)│
  └──────────────────────────────────────────────┘
  → load 总带宽:  2 load/cycle
  → store 总带宽: 1 store/cycle
  → 总 AGU 带宽:  3 ops/cycle(混合时更复杂)
每次 O0 循环的 AGU 需求:
  ① LD i           → 1 load
  ② LD sum         → 1 load
  ④ ST sum         → 1 store
  ⑤ LD i           → 1 load(再次 load 同一地址,但需重新读)
  ⑦ ST i           → 1 store
  ─────────────────────
  合计: 3 load + 2 store = 5 AGU 占用
  需要: 至少 ceil(3/2) + ceil(2/1) = 2 + 2 = 4 cycle 才能消化完 5 个 AGU 操作
  → 单纯 AGU 端口就拖了 4 cycle
  → 再加上 LD→ALU→ST 的数据依赖(每条 4~5 cycle)
  → 总耗时: 8 cycle(发射) + 5×4(load-to-use) = 28 cycle / 8 µop
1.4.5.7 关键 takeaway:三层根因链条
第 1 层:x86 指令的内存操作数(memory-destination)
        → 编译器没法避免,即使优化器努力了,这种 add %rax, [mem] 仍要拆 3 µop
        ↓
第 2 层:8 个 µop 抢 3 个 AGU 端口
        → 5 个 AGU 操作 = 至少 4 cycle 才能全部发射
        ↓
第 3 层:LD-to-ALU-to-ST 串行依赖链
        → 每次循环至少 2 条长链(load-sum → add → store-sum)
        → 每条 4~5 cycle
        ↓
结果: 8 µop / 28 cycle ≈ 0.29 理论 IPC
      实测 0.61(乱序窗口部分重迭)
核心 takeaway:O0 模式下
sum += i的"4 次访存"只是冰山一角,真正的杀手是memory-destination 指令被强行拆成 3 µop**——这一拆把 AGU 端口的"3 ops/cycle 上限"和"load-to-use 4~5 cycle 延迟"两个瓶颈叠加起来,造成 8 µop / 28 cycle 的悲惨流水线**;O2 的lea指令能在汇编层面直接把sum += i编成单条纯 ALU 指令、0 访存、0 AGU、0 load-to-use 等待——这是 O2 IPC 跳到 1.68 的根本原因。**
1.5 派生指标速算
把上面 8 个原始数字再算一遍,加深理解:
| 派生指标 | 公式 | 结果 | 含义 |
|---|---|---|---|
| 平均 CPU 频率 | cycles / task-clock | 3.98 GHz | 跟机器基频一致,没降频 |
| 指令吞吐 | instructions / task-clock | 2.43 G instr/s | 每秒能退役 24 亿条指令 |
| 分支吞吐 | branches / task-clock | 809 M /s | 每秒 8 亿次分支 |
| 分支 miss 率 | branch-misses / branches | 0.00018% | 预测器几乎全对 |
| CPI | cycles / instructions | 1.64 | 平均每条指令花 1.64 个周期 |
| CPU 利用率 | task-clock / elapsed | 100.4% | 单核跑满 + 一点点调度抖动 |
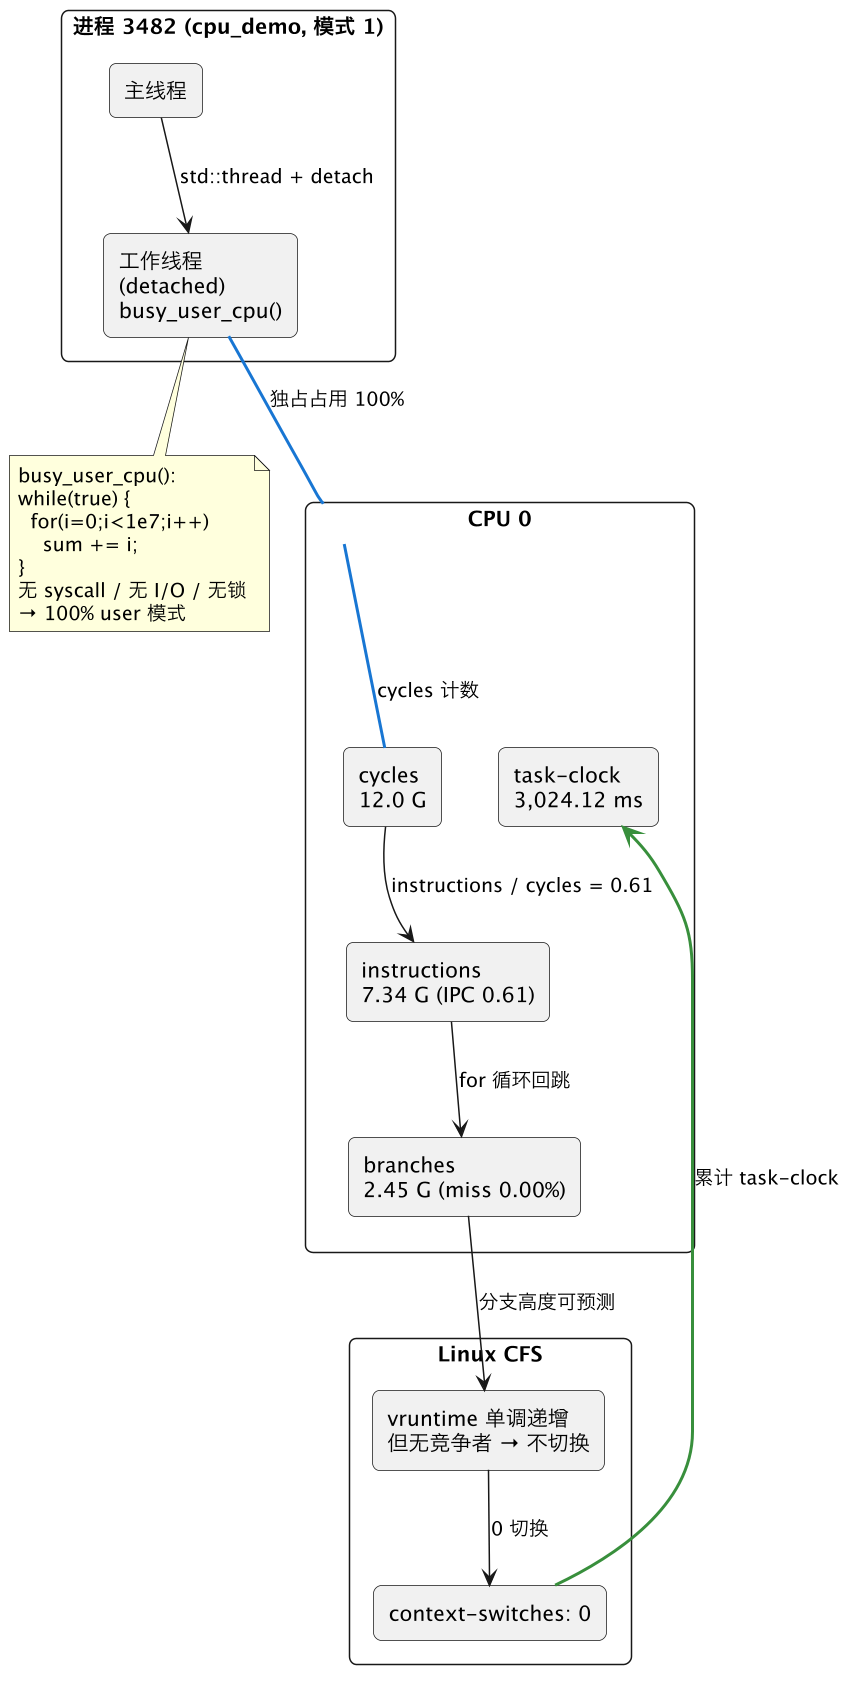
1.6 PlantUML:模式 1 的运行时模型
1.7 实操:用这一节方法论分析任意 perf stat 输出
拿到一张新输出,按以下顺序读:
- 先看
1.000 CPUs或X.XXX CPUs:判断是单核吃满、跨核分布、还是基本空闲; - 看
context-switches:非 0 → 进程有让出 CPU(syscall/IO/sleep/抢占);为 0 → 持续占用; - 看
page-faults:非 0 → 触发了新内存映射(mmap/堆扩张/major IO); - 看
IPC:> 2.5 → 高度流水线利用(优化编译/简单循环);< 0.5 → 受限访存或频繁 stall; - 看
branch-misses %:> 5% → 分支预测是热点(找数据相关/不可预测的 if); - 回头读代码:把 perf 数字跟源码逐行对照,识别"应该 hot 但不 hot"或"应该不 hot 但 hot"的地方。
1.8 一句话总结
模式 1 的
perf stat是一张"理想对照组"数据:0 上下文切换、0 缺页、0% 分支误预测,IPC 0.61 暴露-O0把sum/ispill 到栈的真实代价——所有数字都能从 7 行源码静态推出来,反过来说,任何跟这张表明显不同的输出,都是值得深挖的"性能线索"。
1.9 关键点提炼
本节以"如果只能记住三件事"为粒度,把全文浓缩成一组可对照、可复用的诊断卡片。
1.9.1 一条核心数据: perf stat 的 9 个字段构成理想基线
| 字段 | 数值 | 一句话信号 |
|---|---|---|
task-clock | 3,024 ms | 单核跑满,与 elapsed 几乎相等 |
CPUs utilized | 1.004 | 独占 1 个 CPU,无竞争 |
context-switches | 0 | 任务从未让出 CPU — 纯计算、无阻塞 |
cpu-migrations | 0 | 始终钉在同一个核上 |
page-faults | 0 | 所有访存命中已映射的栈页 |
cycles | 12.0 G (3.98 GHz) | 频率稳定,无降频 |
instructions | 7.34 G | IPC = 7.34 / 12.0 = 0.61 |
branches | 2.45 G (809 M/sec) | for 循环回跳是分支主来源 |
branch-misses | 4,455 (0.00018%) | 教科书级可预测分支,预测器完美命中 |
对照价值: 凡是跟这张表不一致的输出,对应字段就是性能线索。例如 context-switches > 0 → 发生了抢占或阻塞; IPC < 0.5 → 访存 stall 比本例更严重; page-faults > 0 → 触发了新的内存映射。
1.9.2 一条根因链: IPC 0.61 的三层归因
┌─ 源码层 ─────────────────────────────────────────┐
│ sum += i;  // 看起来只有一行,非常无辜              │
└─┬─编译层 (-O0)───────────────────────────────────┘
  │ → sum 和 i 被强制 spill 到栈 (stack spill)
  │ → 生成 memory-destination 指令: add %rax, [mem]
  │
└─┬─µop 层 (译码后)────────────────────────────────┐
  │ → 3 条 x86 指令 → 8 个 µop
  │ → 5 个 load/store µop 争夺 3 个 AGU 端口
  │ → 2 条 LD→ALU→ST 串行依赖链 (每条 4~5 cycle)
  │
└─┬─微架构层 ──────────────────────────────────────┐
  │ → AGU 端口饱和: ceil(3/2) + ceil(2/1) = 4 cycle
  │ → 8 个 ALU 只用 1 个,其余 17 个执行单元空转
  │ → 理论 IPC = 0.29,乱序窗口部分重迭后实测 0.61
└────────────────────────────────────────────────┘核心定理: -O0 的 IPC 偏低不是因为 CPU 不够宽(有 18 个执行单元),而是产出的指令级并行度(ILP)极低 — 绝大多数 µop 在保留站里等 load 完成。超标量加得再宽,喂给它的全是依赖链串在一起的指令,也白搭。
1.9.3 四个反直觉结论
| # | 反直觉现象 | 直觉以为 | 实际原因 |
|---|---|---|---|
| 1 | context-switches = 0 | 3 秒应该有 ~300 次调度 | CFS 在无敌对可运行任务时不强制抢占; 任务永不阻塞 |
| 2 | IPC 0.61 ≠ ~3.0 | 简单循环 IPC 应该很高 | -O0 spill 到栈, load/store 堵死保留站, ALU 全体空转 |
| 3 | branch-misses = 0.00% | 2.4 G 分支总该有 miss | for 循环回跳方向是固定模式, 2-bit 饱和计数器完美预测 |
| 4 | add %rax, [mem] 是 3 个 µop, 不是 1 个 | x86 指令 = 1 µop | memory-destination 操作被 microcode ROM 展开为 LD + ALU + ST |
1.9.4 O0 vs O2 对照速查
| 指标 | -O0 (本案例) | -O2 (案例二预期) | 差异根源 |
|---|---|---|---|
| 循环体 x86 指令数 | 3 条 | 1 条 (lea) | O2 用寄存器代替内存操作数 |
| 循环体 µop 数 | 8 µop | 3 µop | memory-destination 拆 3 被消除 |
| AGU 端口占用 | 5 次/循环 | 0 | O2 全部在寄存器, 无访存 |
| IPC | 0.61 | 1.68~1.73 | O2 消除了栈 spill 和 load-to-use 延迟 |
| 产能浪费 | 7/8 ALU + 全部 FPU 空转 | ALU 利用率大幅提升 | ILP 提高, 发射不卡 |
→ 详细对比见 案例二。
1.9.5 可用方法: 读任意 perf stat 的 6 步口诀
① CPUs utilized → 判断是单核吃满 / 多核分散 / 基本空闲
② context-switches → 0=持续占用; >0=有让出 CPU 的原因
③ page-faults → >0=触发了新内存映射
④ IPC → >2.5=高并行; <0.5=严重访存 stall
⑤ branch-misses% → >5%=分支预测成热点
⑥ 回头对照源码 → 找"数字与代码预期不一致"的地方一句话记忆: 模式 1 是 perf 入门的"对照组样本" — 无噪声、无意外、所有指标可从 7 行源码静态推导。把这张表印在脑子里,任何不同的输出都是线索。