保留站(Reservation Station)—— 解耦译码与执行,乱序发射的发生地
承 pipelining-basics §2.1 的流水线 IS 级和 cpu-out-of-order 的乱序执行五大部件(见 ooo-mechanism §二)。保留站是 Tomasulo 算法的核心发明——把"所有指令顺序排队等执行"变成"谁的操作数先齐了谁先走"。
一、保留站解决什么问题
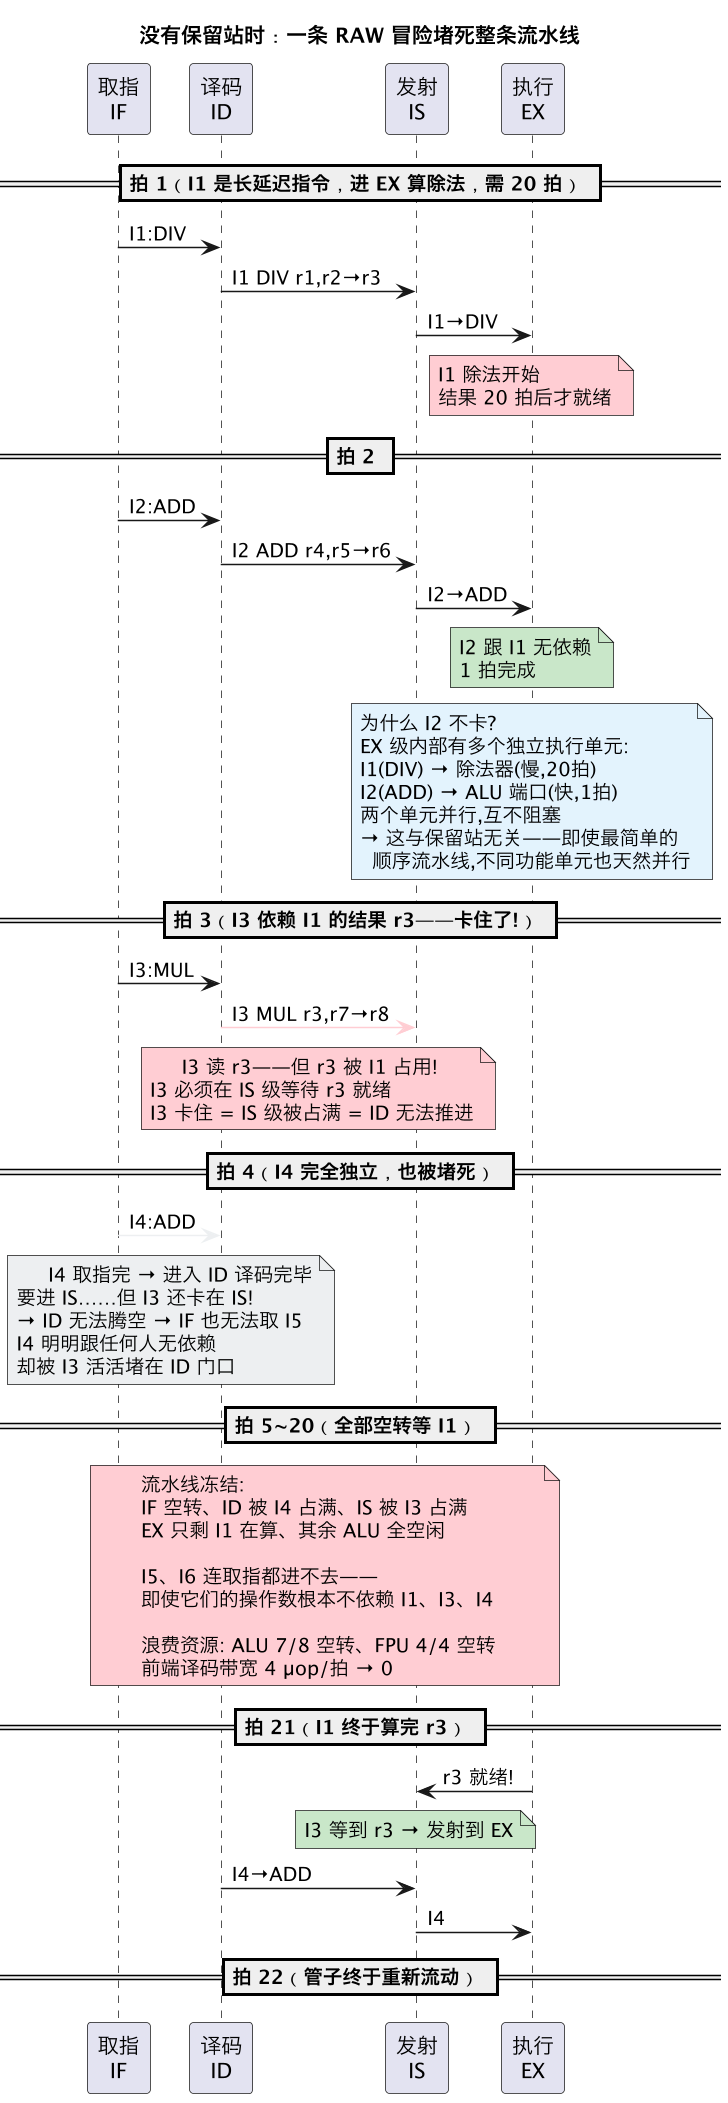
没有保留站时,指令从译码级直接进执行单元。一旦某条指令的操作数没就绪(比如 I3 的源寄存器正被 I1 占用,I1 还在算),I3 就卡在发射级。但译码级是顺序的——I3 卡住,I4、I5、I6 即使操作数全齐了、跟 I3 毫无依赖关系,也被堵在门外进不了发射级。
关于流水级与访存:下面的时序图只画了 IF→ID→IS→EX 四级,因为示例全是寄存器操作(DIV/ADD/MUL),不涉及访存。真实流水线中,load/store µop 也经过保留站,但它们走的流水级更长:
µop 类型 保留站→发射到 EX 级做了什么 之后发生了什么 ALU (ADD/MUL/DIV) ALU 端口(Port 0/1/5/6) 真正的算术/逻辑运算 结果直接送 MEM 级透传 → WB 写回 PRF Load (LD) AGU 端口(Port 2/3) 只算地址(base+index×scale+offset),不读内存 发射到 LSU → 向 D-Cache 发起读请求 → L1 hit ~4~5 cycle 后数据到达 → WB 写回 PRF。等 D-Cache 的这 5 cycle 期间,该 µop 已经离开 RS 了——RS 槽位已释放,被其他 µop 复用 Store (ST) AGU 端口(Port 7) 算地址 地址送入Store Buffer;数据从 PRF 读到 Store Data 端口(Port 4) → Store Buffer 合并 → 退休后异步写入 D-Cache。Store Buffer 也是 LSU 的一部分,与 RS 无关 所以你原来的理解没错:访存的"执行"分两步——AGU 算地址在 EX 级做(D-Cache 还没碰),真正读/写 D-Cache 是 MEM 级的事。两者的分界点就是保留站:µop 从 RS 发射那一拍脱离 RS 的控制,后续的 D-Cache 访问、写回等都走 LSU→MEM→WB 链,不再占用 RS 槽位。
保留站做的事很简单:在译码级和执行单元之间插入一个缓冲池。译码级不管后面卡不卡,µop 全部扔进池子。每条 µop 在池内独立监控自己的操作数——谁的操作数先齐,谁先发射到空闲执行单元。译码和执行的进度彻底解耦。
核心价值就两条:
- 解耦:译码不被执行卡住。即使 RET 堵在 ROB 头部等 L3 cache miss,前端照样取指→译码→往 RS 里塞 µop。
- 乱序发射:RS 内部每条 µop 只关心"我的操作数到了没"——到了就走,不管前面排了多少条还没就绪的。这就是"乱序"二字的物理实现。
二、功能拆解
保留站不是一个简单的 FIFO 队列,而是集成了三个功能:
| 功能 | 做什么 | 对应硬件 |
|---|---|---|
| 操作数监控 | 每条 µop 盯着自己的源操作数,等"就绪"信号 | tag 匹配电路——监听结果总线上的物理寄存器号,与自己的源 tag 比对 |
| 乱序挑选 | 每拍从所有就绪 µop 中选出若干条发射到空闲执行单元 | 仲裁/选择逻辑(pick logic),通常按 oldest-first 策略 |
| 缓冲池 | 容纳前端喂进来的 µop,吸收前端与后端的速率差 | SRAM 条目阵列,现代 CPU 通常 60~200 个 RS 条目 |
RS 只是一个"调度等待区"——它不存数据,只存 µop 的控制信息(操作码、源操作数的物理寄存器号/就绪位、目的物理寄存器号)。数据本身在物理寄存器文件里,RS 只是拿 tag 去监听。
三、运作机制:一条 µop 在保留站里的完整生命周期
阶段             做了什么                         关键动作
─────────────────────────────────────────────────────────────────
① 分配(allocate)  译码完成后,分配一个 RS 槽位      写入 µop 操作码、源寄存器 tag、
                  把源操作数的当前状态锁存进去       目的寄存器 tag
─────────────────────────────────────────────────────────────────
② 等待(wait)      µop 在槽位里监听结果总线          每拍检查源 tag 是否匹配
                  源 tag=0 表示寄存器就绪            结果总线上刚完成的物理寄存器号
─────────────────────────────────────────────────────────────────
③ 唤醒(wakeup)    所有源操作数都已就绪              就绪标志置位,进入候选池
                  µop 进入"可发射"状态
─────────────────────────────────────────────────────────────────
④ 挑选(pick)      调度器从候选池中选 µop 发射        按 oldest-first(先进入 RS 的优先)
                  受发射宽度限制                     避免新指令饿死老指令
─────────────────────────────────────────────────────────────────
⑤ 发射(dispatch)  µop 送入执行单元                  读取物理寄存器文件取操作数值
                  释放 RS 槽位                       开始执行
─────────────────────────────────────────────────────────────────
3.1 操作数监控:tag 匹配
每条 µop 记录了源操作数的 物理寄存器 tag。物理寄存器还没被写入时,它的 tag 非零。当某条指令执行完成、请求写入物理寄存器时,会向结果总线广播"我写的是 P37"。RS 里所有 µop 的源 tag 都与广播比对——命中则意味着"我的操作数就绪了"。
这就是 Tomasulo 算法的核心:结果直接通过总线 tag 广播,"一写多听",不需要 CPU 再逐条检查依赖。
3.2 挑选逻辑:oldest-first
RS 里同一拍可能有几十条 µop 都处于"就绪"状态,但发射宽度有限(INT 最多 4 条/拍,FP 最多 4 条/拍)。挑选逻辑按 oldest-first 策略:进入 RS 更早的 µop 优先发射。这避免了"新来的永远抢到、老的一直等"的饥饿问题。
3.3 解耦缓冲:吸收速率差
前端每拍最多产 4~6 µop,但后端可能因为 cache miss 等几拍甚至几百拍才消化一个 µop。RS 的几十到两百个槽位就是中间的弹性缓冲——前端先填满 RS,后端按自己能消化的速率挑 µop 执行。只要 RS 不满,前端就能继续取指译码。
四、限制与瓶颈
| 限制 | 说明 | 表现 |
|---|---|---|
| RAW 依赖链 | µop 的操作数来自前面未完成指令的结果,依赖链多长就得等多久 | RS 里堆满"就绪但等数据"的 µop,IPC 掉到接近 1 |
| 发射宽度 | INT 最多 4 条/拍,FP 最多 4 条/拍,再多的就绪 µop 也发不出去 | 8 个 ALU 有 6 个空闲、RS 里 30 条就绪 µop 排队 |
| RS 容量耗尽 | RS 满了,前端不能再发射 µop,取指/译码停止 | stalled-cycles-frontend 飙升,取指停摆 |
| 端口冲突 | 多条就绪 µop 都要用同一个执行端口(如全是 ADD),多出来的等下拍 | 编译器优化中的交错调度(-O2+)缓解此问题 |
RS 容量是最硬的物理限制。超标量架构把执行单元加到 18 个、退休宽度加到 8 条,但如果 RS 太小(比如只有 32 个槽位),前端灌满后就停摆,后面的宽执行单元全白加。所以 Intel Skylake 把 RS 扩到 97 个、Zen 4 扩到 68+68(INT+FP),Zhuque/Kunpeng 等服务器 CPU 也有 120+ 条目。
五、和周边部件的关系
译码 ──→ 寄存器重命名 ──→ 保留站 ──→ 执行单元 ──→ ROB
(消除假依赖) (乱序发射) (顺序退休)- 寄存器重命名是 RS 的前置——如果没有重命名消除 WAR/WAW 假依赖,RS 里很多 µop 明明操作数齐了,却被"伪冲突"拦着不能发射。详见 register-renaming。
- ROB 是 RS 的后置——RS 乱序发射让指令乱序执行、乱序完成,ROB 保证它们按序退休。详见 rob。
- 执行单元是 RS 的下游——RS 只负责"挑谁走",不负责执行。执行单元的并行度(端口数 × 每端口槽位数)决定了 RS 能多快消化积压。详见 superscalar-design §1.3。
- 数据冒险:data-hazards——RS 中 RAW 依赖的 µop 操作数未就绪时被阻塞在槽位里,调度器自动跳过它们选择其他就绪 µop 发射。
- 纵切面走读:uop-pipeline-walkthrough——RS 在完整流水线中接收重命名 µop 并发射到执行单元的全时序路径。
六、观测:保留站相关的 perf 事件
perf stat -e uops_executed.stall_cycles,resource_stalls.rs,resource_stalls.any ./app
# uops_executed.stall_cycles — RS 空闲(没有就绪 µop 可发射)的周期数
# resource_stalls.rs         — 因 RS 满导致前端停摆的周期数
# resource_stalls.any — 因任何后端资源不足(含 RS 满)导致的停顿resource_stalls.rs高 → RS 太小,前端填满了就停,考虑加 RS 容量(没法改硬件,但可检查是否依赖链太长导致 µop 堆积)。uops_executed.stall_cycles高 → RS 里没就绪 µop 可发,大概率是 load miss 拖住了保留站里的依赖指令。
七、一句话总结
保留站是译码和执行之间的弹性缓冲 + 乱序调度器——它最关键的洞察是把"译码被卡住的指令堵住"变成"卡住的指令在池子里等,别影响译码继续产 µop"。Tomasulo 的 tag 匹配广播机制让所有 µop 独立监听操作数,谁先齐谁先走,把超标量加宽的硬件真正喂饱。