五种 IO 模型 —— 从阻塞到 io_uring 的演进
导读说高并发要摊薄"每次 IO 的 CPU 账",而这笔账怎么付,取决于你用哪种 IO 模型。本篇讲清 Linux 下五种 IO 模型(阻塞 / 非阻塞 / IO 多路复用 / 信号驱动 / 异步)的本质区别,给出对比表,澄清"同步/异步"与"阻塞/非阻塞"这对常被混淆的正交概念,最后落到现代真异步 io_uring。多路复用是高并发主力,其内部机制细节放在 epoll。
一、先看一次网络读的两个阶段
理解五种 IO 模型,先把一次 read() 拆成两个阶段——这是全篇的锚:
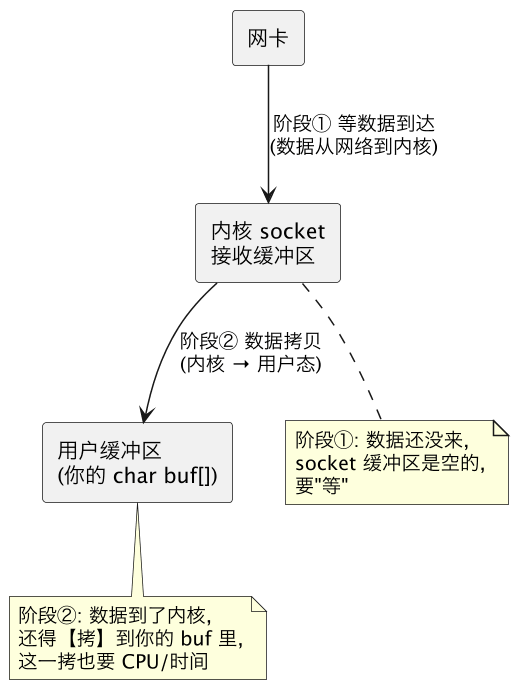
- 阶段①:等数据到达——数据从网卡进入内核的 socket 接收缓冲区。数据没来之前,这个阶段就是"等"。
- 阶段②:数据拷贝——数据到了内核缓冲区后,还要从内核态拷贝到用户态的
buf。这一拷是实打实的 CPU 开销(这也是零拷贝想省掉的)。
五种 IO 模型的全部区别,就在这两个阶段里:谁阻塞、谁不阻塞、谁来做拷贝、做完怎么通知你。 记住这句话,下面五个模型都是它的变体。
一句话:一次 read = 「等数据」+「拷数据」两个阶段,IO 模型的差异全在这两阶段的分工上。
二、五种 IO 模型逐个讲
2.1 阻塞 IO(blocking IO)
最朴素:调 read(),两个阶段都阻塞——数据没来一直睡,数据来了内核拷贝时也还在这条 read 里等,直到拷完才返回。
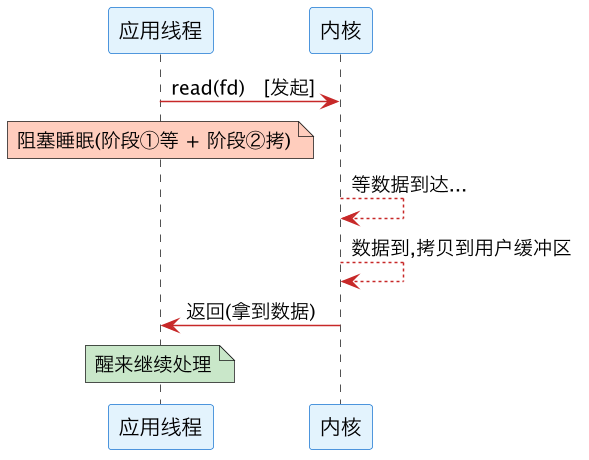
- 优点:编程最简单,逻辑顺序直白。
- 致命缺点:一个线程同一时刻只能等一个 fd。要服务 N 连接就得 N 线程——正是导读里 C10K 崩掉的老模型。线程一睡一醒还各摊一次上下文切换(自愿切换),连接一多切换开销就雪崩。
2.2 非阻塞 IO(non-blocking IO)
给 fd 设 O_NONBLOCK。read() 阶段①不再睡:数据没来立刻返回 EAGAIN/EWOULDBLOCK,数据来了才真正读(阶段②的拷贝仍在这条 read 里同步完成)。
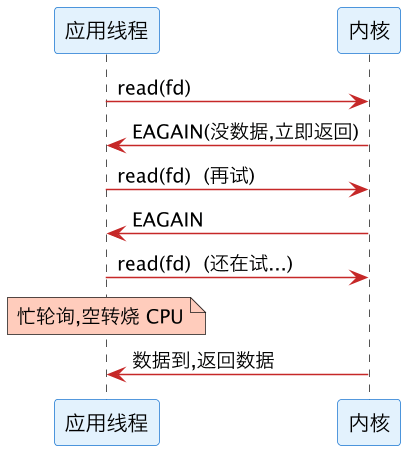
- 优点:不占着线程睡,理论上一个线程能轮着问多个 fd。
- 缺点:忙等(busy-poll)浪费 CPU——大部分轮询都是空手而归的
EAGAIN。很少单独用,通常作为多路复用的配套(epoll 边缘触发下 fd 必须设非阻塞)。
2.3 IO 多路复用(select / poll / epoll)—— 高并发主流
思路转变:不再自己一个个问 fd,而是把一堆 fd 交给内核,用 select/poll/epoll 一次性"帮我盯着这些 fd,哪个就绪了告诉我"。一个线程就能同时管成千上万个连接。
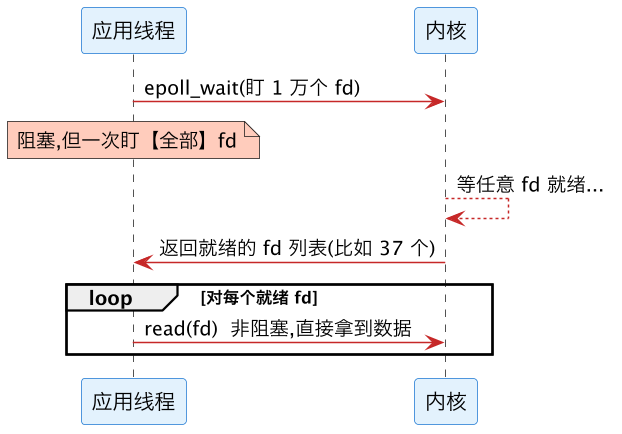
三种多路复用 API 的差异是面试/调优的高频点,这里给对比表(详细序列图对比和选型指南见 select/poll/epoll 深度对比,epoll 内部红黑树 + 就绪链表的机制细节见 epoll):
| 维度 | select | poll | epoll |
|---|---|---|---|
| fd 数量上限 | 1024(FD_SETSIZE 硬限制) | 无硬上限(用数组) | 无硬上限(受内存/ulimit) |
| 每次调用传参 | 每次把全部 fd 集合从用户态拷进内核 | 同样每次拷贝整个 fd 数组 | 一次 epoll_ctl 注册,之后 epoll_wait 不再重复传 |
| 找就绪 fd 的复杂度 | O(n) 线性扫描全部 fd | O(n) 线性扫描 | O(1) 就绪链表回调,只返回就绪的 |
| 返回结果 | 改写 fd 集合,需自己遍历判断 | 遍历数组查 revents | 只给就绪的那几个 fd |
| 适用场景 | 连接少、要跨平台移植 | 比 select 好点,仍不适合海量连接 | 海量连接、Linux 高并发首选 |
- select:老古董。三宗罪——1024 上限、每次拷贝全部 fd 集合、返回后 O(n) 扫描。
- poll:去掉了 1024 上限(用数组代替位图),但每次仍拷贝全部 + O(n) 扫描的老毛病还在。
- epoll:Linux 的答案。fd 注册一次常驻内核红黑树,就绪时靠回调进就绪链表,
epoll_wait只把就绪的 fd 拿回来——开销随"活跃连接"而非"总连接"增长。这正是导读说的 C10K→C10M 的关键。
注意:多路复用本身仍是同步的——
epoll_wait告诉你"就绪了",真正的read(阶段②拷贝)还是你自己同步调的。它省的是"等哪个 fd"的成本,不是"拷贝"的成本。
2.4 信号驱动 IO(SIGIO)
给 socket 装 SIGIO 信号处理函数,数据就绪时内核发个信号通知你,你再去 read。阶段①不阻塞(等信号),阶段②的拷贝仍同步。
- 实践中很少用:信号是异步打断,处理函数里能做的事极受限(异步信号安全),且在高并发下信号会丢失/合并、难以精确对应到哪个 fd。基本被 epoll 取代,了解即可。
2.5 异步 IO(AIO / io_uring)—— 真正的异步
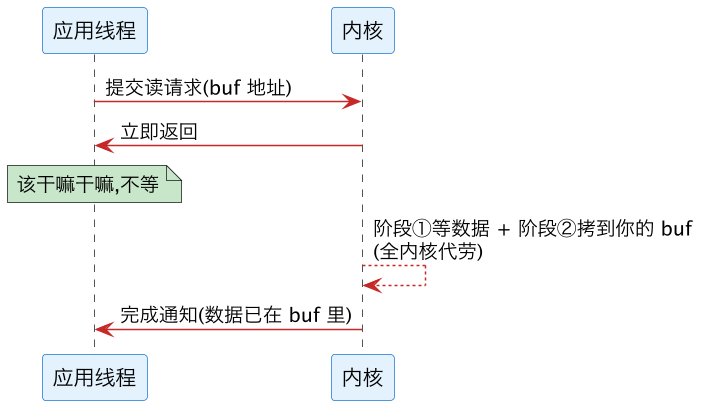
前面四种,阶段②的拷贝都是你自己同步做的(read 阻塞在拷贝上)。异步 IO 不一样:你提交一个"读请求"就返回去干别的,内核把两个阶段全干完(连拷贝都替你做完,数据已在你 buf 里),再通知你"好了"。 这才是真异步。
- Linux 原生 AIO(
libaio)的局限:只对O_DIRECT直接 IO 的文件有效,对网络 socket 基本没用、还常退化成同步;接口难用。所以"Linux 有 AIO 但等于没有真异步"是长期现实。 - io_uring 才是现代真异步:Linux 5.1+ 引入。核心思路——应用与内核共享两个环形队列(SQ 提交队列 / CQ 完成队列),应用把 IO 请求写进 SQ,内核处理完把结果写进 CQ:
- 批量提交:一次
io_uring_enter提交一批请求,甚至内核 SQPOLL 模式下连这个系统调用都省了——大幅削减系统调用次数(正是高并发瓶颈②要砍的税)。 - 共享内存环,无需拷贝提交/完成结构:请求和结果直接在共享环里传递。
- 这套"共享环形缓冲区 + 批量、少陷入内核"的思路,和 perf 的 mmap ring buffer 采样机制如出一辙——都是用共享内存环把"频繁的内核↔用户交互"批量化、去系统调用化。
- 批量提交:一次
一句话:前四种模型的拷贝都要你自己同步等;只有 AIO/io_uring 让内核把「等 + 拷」全做完再通知你,io_uring 靠共享环 + 批量提交把系统调用开销也一并砍掉。
三、五模型对比总表
| IO 模型 | 阶段① 等数据 | 阶段② 拷贝 | 同步/异步 | 典型 API |
|---|---|---|---|---|
| 阻塞 IO | 阻塞 | 阻塞 | 同步 | read()(默认) |
| 非阻塞 IO | 不阻塞(轮询 EAGAIN) | 阻塞(数据到才拷) | 同步 | read() + O_NONBLOCK |
| IO 多路复用 | 阻塞在 select/poll/epoll | 阻塞 | 同步 | select/poll/epoll_wait + read |
| 信号驱动 IO | 不阻塞(等 SIGIO) | 阻塞 | 同步 | SIGIO + read |
| 异步 IO | 不阻塞 | 不阻塞(内核代劳) | 异步 | io_uring / libaio |
关键观察:前四种阶段②都由应用自己同步拷 → 都是同步 IO;只有最后一种阶段②由内核代劳 → 才是异步 IO。 多路复用虽然强大,本质仍是"同步非阻塞"的范畴。
一句话:判断异步与否,只看阶段②的拷贝是不是内核替你做了——是,才叫异步。
四、正交关系澄清:同步/异步 ≠ 阻塞/非阻塞
这两对概念最容易混,因为它们描述的是两个不同阶段:
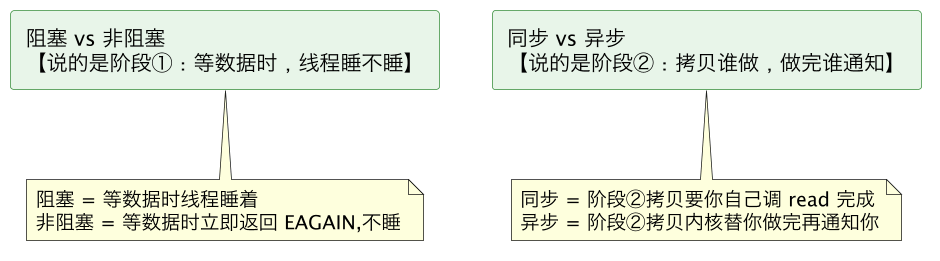
- 阻塞 / 非阻塞 说的是阶段①:等数据时,你的线程是睡着(阻塞)还是立即返回(非阻塞)。
- 同步 / 异步 说的是阶段②:数据的拷贝是你自己同步调
read完成(同步),还是内核全做完再通知你(异步)。
所以会出现"非阻塞 + 同步"(非阻塞 IO、多路复用都是)这种组合——阶段①不睡,但阶段②仍得自己拷。理解了两个阶段,这对概念就不再打架。
一句话:阻塞/非阻塞管「等」,同步/异步管「拷」,两把尺子量的是两个阶段,别混。
五、选型与链接
- 高并发首选:IO 多路复用(epoll),是绝大多数高性能服务端的基座——机制见 epoll。
- IO 模型要配线程模型:epoll 只解决"一个线程盯多少 fd",处理请求还得靠合适的并发模型(Reactor / 线程池 / 协程)——见 thread-models。
- 每次 IO 都是系统调用:
read/epoll_wait/io_uring_enter都要陷入内核,这笔固定开销正是 io_uring 批量化想省的——见 syscall。 - 想榨干拷贝开销:阶段②的拷贝可用零拷贝进一步消除。
- 先观测再选型:用
ss看连接状态与数量(ESTABLISHED/TIME_WAIT、Recv-Q/Send-Q积压),确认瓶颈确实在连接规模上,再决定要不要上多路复用。
总结
一次网络读 = 「等数据」+「拷数据」两阶段,五种 IO 模型就是这两阶段"谁阻塞、拷贝谁做"的不同组合:阻塞→非阻塞→多路复用(epoll,高并发主流)→信号驱动→异步(io_uring,唯一真异步);分清"阻塞/非阻塞管等、同步/异步管拷"这两把正交的尺子,选型就不会乱。