I-Cache 指令缓存 —— 代码是怎么喂进 CPU 流水线的
cache-organization 讲透了数据缓存(D-cache):物理地址拆三段、组相联查找、读写流程、逐级下探——全是站在"CPU 读/写一个数据"的视角。但 CPU 还有另一个同样高频的动作——取指令(instruction fetch)。取指也走缓存,而且它和数据访问走的不是同一条硬件通路,不是同一个缓存。
本篇补齐另一半:I-cache 为什么独立、取指路径、unified 的代价、代码膨胀/布局、iTLB、自修改代码与 perf 观测。
一、为什么 L1 要拆成 I-cache 和 D-cache(哈佛结构的缓存层体现)
1.1 背景:取指和访存是两个同时进行的动作
CPU 执行一条指令(如 add rax, [rdi]),在流水线里至少同时发生两件事:
- 取指(fetch):从内存地址
PC(程序计数器)处把指令字节读进来 → 送进译码器。 - 访存(memory access):从内存地址
[rdi]处读操作数。
两个动作地址来源不同(PC vs rdi)、区域不同(代码段 vs 数据段),且必须同一拍并行发生。
1.2 如果 L1 只有一套,取指和访存会互相阻塞
假想只有一块统一的 L1 缓存,取指和访存同时来了两个不同的地址:
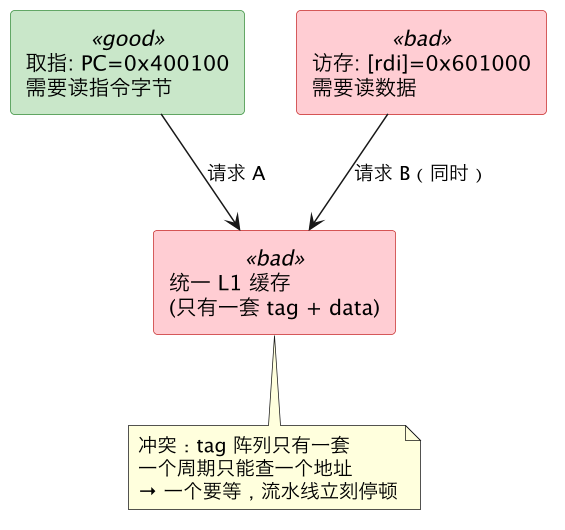
这就是哈佛结构的动机:取指和访存是不同阶段的同时需求,共用一套缓存就得每拍排队。
1.3 解法:I-cache 和 D-cache 物理分离
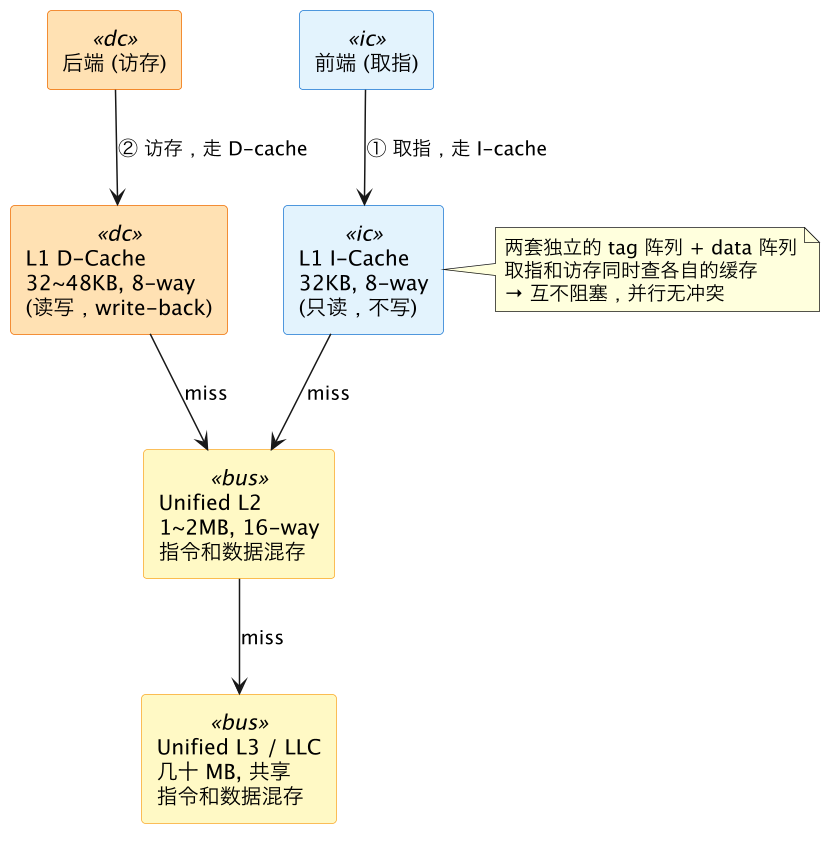
I-cache 和 D-cache 有各自独立的 tag 阵列、data 阵列和查找端口——取指和访存同一拍并行访问、互不阻塞。这就是哈佛结构在缓存层的体现:L1 保留"指令/数据分离",L2/L3 合并回 unified。
1.4 I-cache 的容量与组织结构
| 属性 | L1 I-cache | L1 D-cache |
|---|---|---|
| 典型容量 | 32 KB(几乎不变) | 32~48 KB |
| 访问模式 | 只读 | 读写 |
| dirty 位 | ❌ 不需要 | ✅ 需要(write-back) |
| MESI 状态 | ❌ 不参与 | ✅ M/E/S/I 状态位 |
| 存什么 | 原始指令字节(机器码) | 程序的业务数据 |
I-cache 的寻址原理(物理地址三段、组相联命中判定)和 D-cache 完全一样,cache-organization 里讲的东西在 I-cache 上同样成立。唯一的核心区别:I-cache 只读不写。
二、只读带来的结构简化
2.1 I-cache 一条 line 存什么
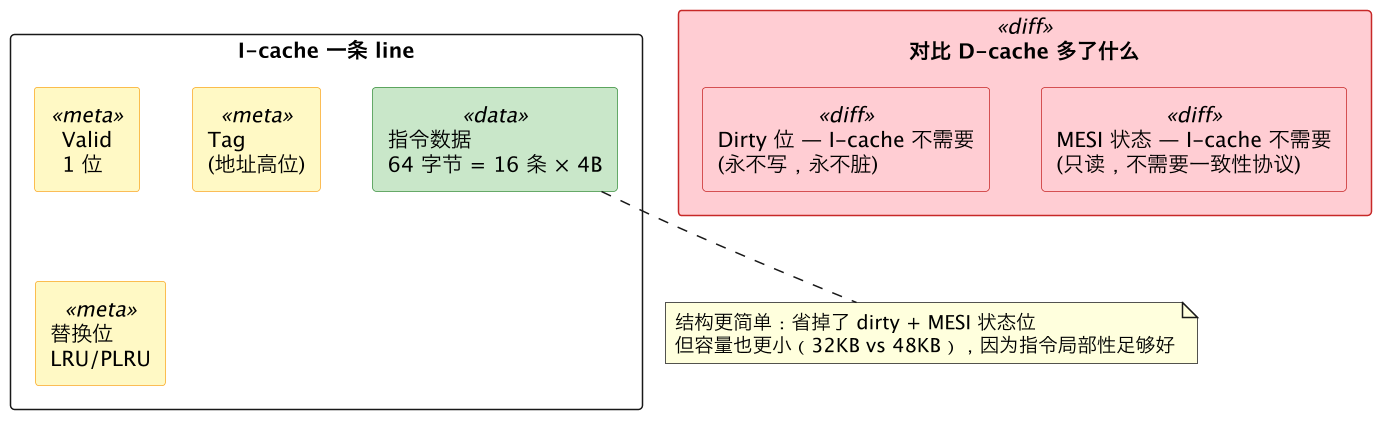
因为 I-cache 只读,省掉了 D-cache 必须有的两套状态:
| 省掉的东西 | 为什么不需要 |
|---|---|
| dirty 位 | 没有写操作,永远不需要写回。驱逐时直接丢弃即可,反正 L2 里有相同的副本 |
| MESI 状态位 | 一致性协议处理的是"多个核修改同一份数据",指令不会被修改 → I-cache 不参与 MESI |
2.2 I-cache miss 的处理流程(比 D-cache 简单)
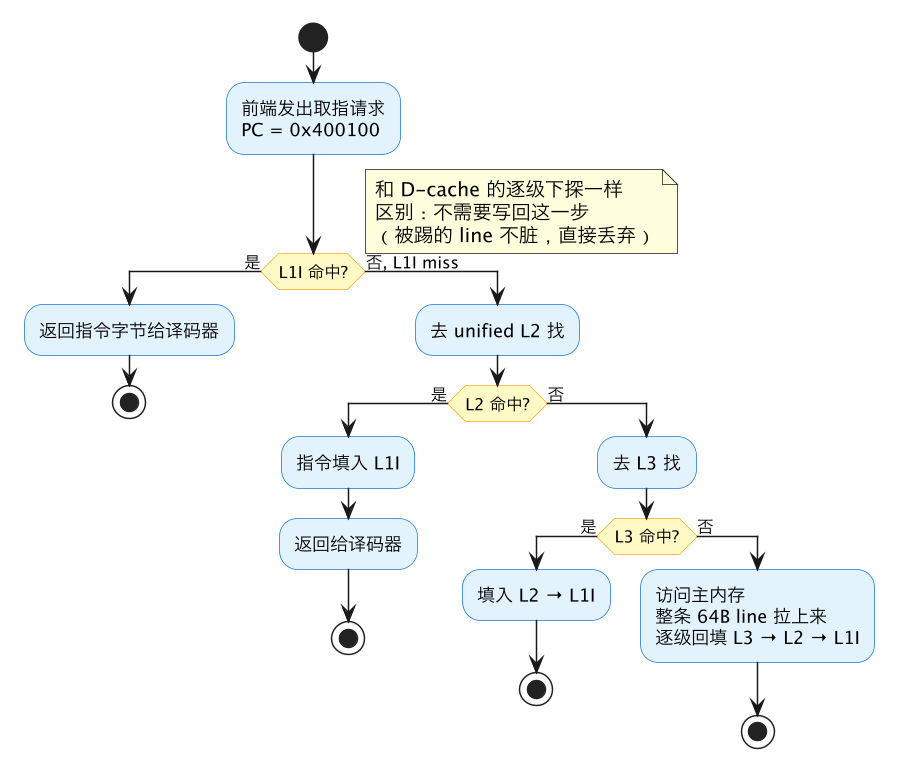
与 D-cache miss 的关键区别:miss 时被驱逐的 line 不需要写回(永远不脏),直接丢弃、用新指令覆盖即可。
三、指令取指路径:PC → 译码,中间发生了什么
3.1 完整链路
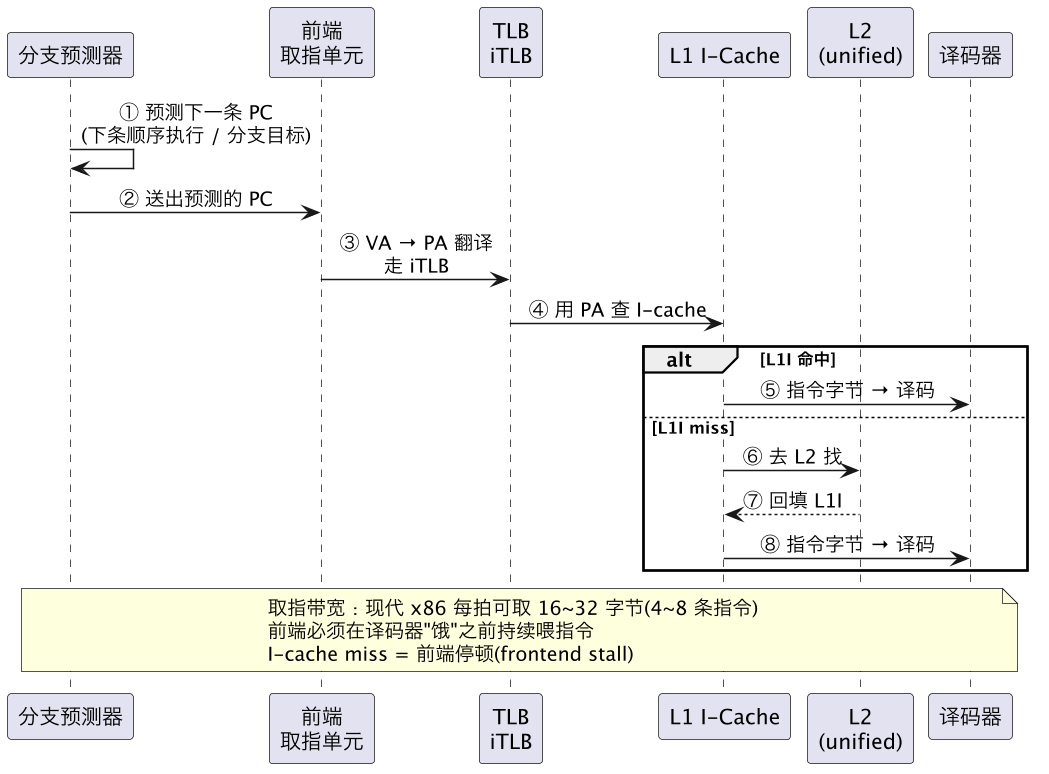
关键:
- 取指地址来自 PC(由分支预测器决定下一拍取哪),翻译走 iTLB(见第六节)。
- 取指带宽:现代 x86 每拍可取 16~32 字节(4~8 条),超额取是为应对分支气泡。
- I-cache miss = frontend stall:译码器等不到新指令,前端停顿。
3.2 取指也是按 64B cache line 整条拉
和 D-cache 一样,I-cache miss 取回的是整条 64 字节 cache line = 约 16 条 x86 指令。这意味着:
- 顺序执行时代价被摊薄:接下来 15 条指令若在同一条 line 里,不会再 miss;
- 代码乱跳时代价翻倍:每条 jump 飞向新 line 都可能 miss——指令局部性同样重要。
四、L2/L3 是 Unified 的 —— 代码和数据会互相踢
4.1 统一缓存意味着什么
L1I 和 L1D 虽分开,但下一级(L2、L3)是 unified 的——指令和数据混存,不区分专有区域。
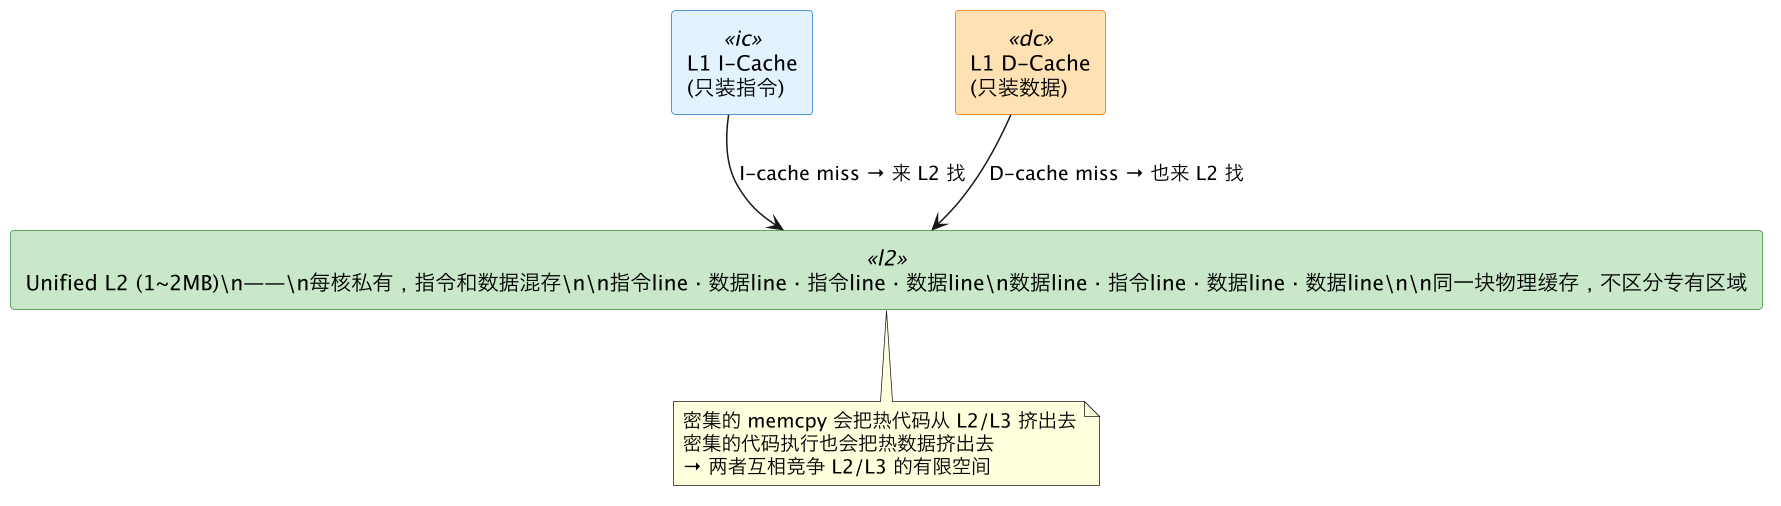
现实后果:
| 场景 | 发生了什么 |
|---|---|
密集 memcpy | 数据 line 冲进 L2/L3 把热代码挤出 → 取指 miss → frontend stall |
| 大代码路径(过度内联) | 指令占满 L2/L3 把热数据挤出 → 访存 miss → backend stall |
| 两者抢 L3 | 代码和数据竞逐有限的几十 MB → LLC miss 双双上升 |
这是 I-cache 视角下最重要的洞察:优化代码大小不只是省内存,更是为 L2/L3 留空间给热数据。一个过度内联膨胀的二进制,其指令会挤占 L2/L3 本该装热数据的容量。
4.2 L2/L3 的替换策略对谁更公平
大多数 L2/L3 用 LRU/近似 LRU 替换,不区分指令和数据。流式数据时间戳新、可能把热代码挤出;热代码反复命中又能保护自己——谁赢取决于访问频率。但膨胀的二进制必然占用更多 L2,降低整体有效利用率。
五、I-cache 特有的性能问题
5.1 代码膨胀(code bloat)—— 最容易被忽视的 I-cache 杀手
过度内联、模板展开、大函数体会让热路径指令总量膨胀,超出 L1I 的 32KB。

典型案例:
// ❌ 过度内联:每次调用都展开,调用点多了热路径指令总量爆炸
template<typename T>
inline void process(T& obj) {
    // 100 行模板逻辑,每行都可能在多个特化里展开
    obj.doA(); obj.doB(); /* ... 几十步 ... */
}
// ✅ 拆分:热点路径保持紧凑,冷逻辑提到外面非内联函数
inline void process_hotpath(T& obj) {
    obj.doA();                    // 只内联真正热的几步
    process_coldpath(obj);        // 冷的调到外面(非内联)
}诊断信号:perf stat 看 frontend_stall 占比高、L1-icache-load-misses 高(见第九节)。
5.2 代码布局(code layout)—— 热代码应相邻、冷代码应隔离
和 D-cache 的"顺序访问"同出一理:CPU 取指也是顺序的(沿 PC 递增),热路径的指令在内存里越连续,I-cache 利用率越高。
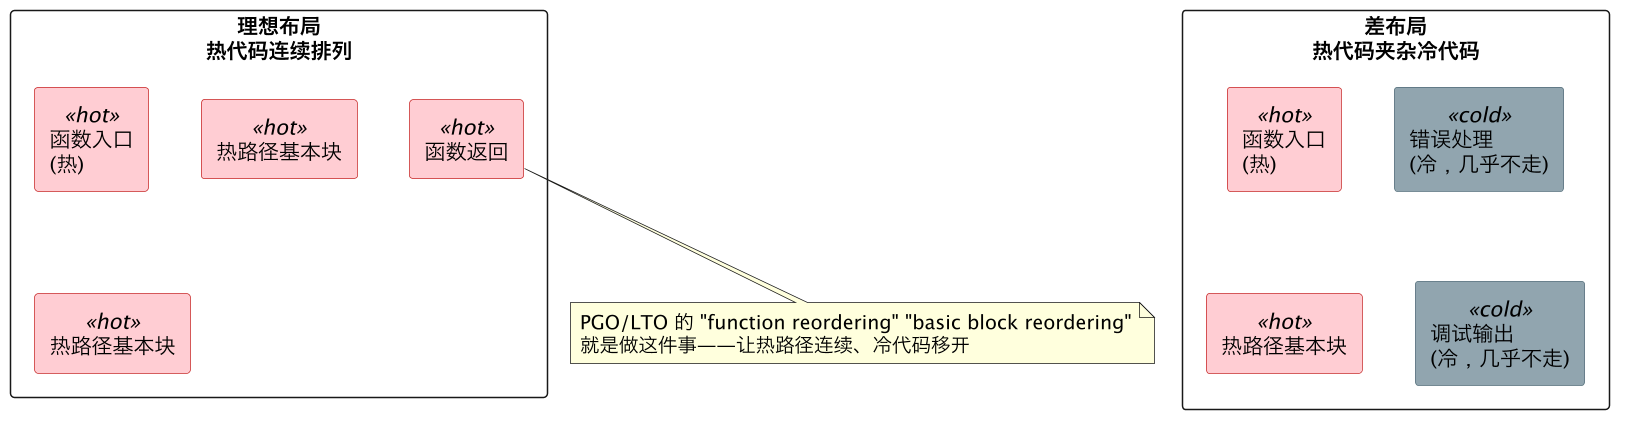
手段:
__builtin_expect/[[likely]]/[[unlikely]]:提示编译器哪条分支热,冷分支代码被移到函数末尾,热路径更紧凑(详见 branch-prediction)。- PGO:按真实运行 profile 重排代码布局;LTO:跨编译单元看全局,做更激进的重排与内联决策。
5.3 I-cache 与分支预测的交互
分支预测错误不只浪费已进入流水线的指令(它们被 flush 掉),还可能触发额外的 I-cache miss——这条链路是性能杀手:
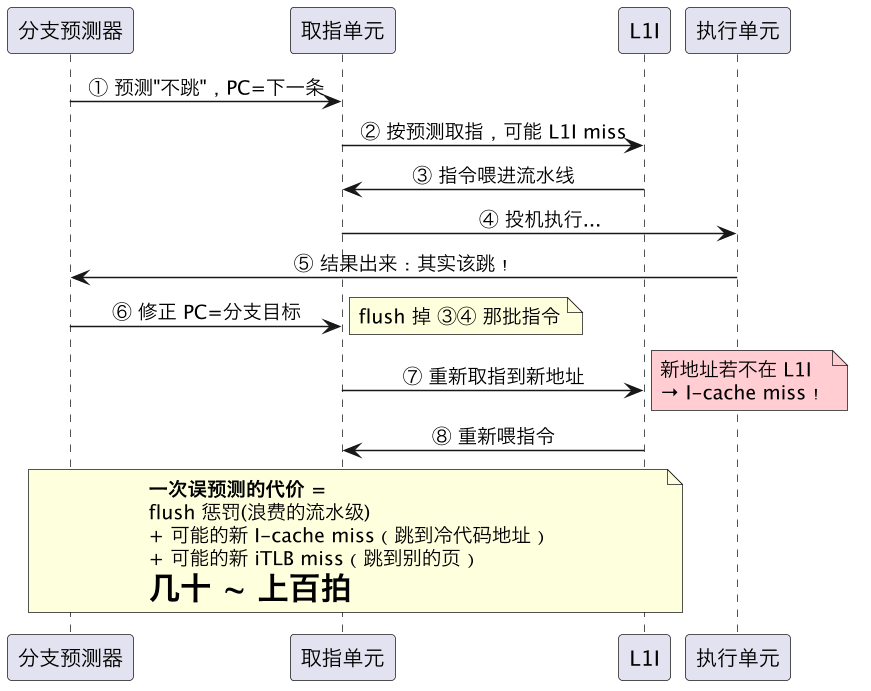
这就是分支预测准确率如此关键的原因——不只是 flush 浪费的那些拍,跳到新地址后,指令和翻译大概率不在缓存里。
六、iTLB —— 指令地址翻译的 TLB
6.1 I-TLB 和 D-TLB 是分开的
如同 L1I 和 L1D 分开,地址翻译的缓存也有两份——iTLB 和 dTLB。iTLB 缓存的是"指令地址(PC)的 VPN→PFN"映射,dTLB 缓存的是"数据地址的映射"。
tlb 全文聚焦 dTLB,"改步长性能暴跌"的实验也是数据访问视角。iTLB 有自己的容量和覆盖范围:
| iTLB(指令) | dTLB(数据) | |
|---|---|---|
| 典型 L1 条目 | 128 条目(dTLB 为 64,取指更规律所以更大) | |
| L2 (STLB) | 和 dTLB 共用同一个 STLB(~1536~2048 条目) | |
| 命中时 | 翻译 ≈ 0 拍 | 同 |
| miss 时 | page walk,代价同上 | 同 |
6.2 什么时候 iTLB 崩
大代码段——热路径分布在大量不同的 4KB 页上:一个 200MB 的二进制,热点散落在几百个函数、几百个页 → 128 条 L1 iTLB 装不下 → 频繁 miss → 每次 page walk 几十~上百拍。这是"大二进制 + 多模块动态链接"的典型问题。大页对代码段同样有效——2MB 大页覆盖 512 倍指令地址范围。
6.3 perf 怎么区分 iTLB 和 dTLB
# iTLB miss
perf stat -e iTLB-load-misses ./app
# dTLB miss(tlb.md 里用的)
perf stat -e dTLB-load-misses ./app
# 整体 STLB 统计
perf stat -e stlb_hit,stlb_miss ./app
七、自修改代码与 I-D 缓存一致性
7.1 问题:写代码和取代码走不同的缓存
JIT 编译器、动态代码生成器会在运行时"写一段新代码,然后跳过去执行":
1. 把新指令字节 store 到内存 → 数据进了 L1D(甚至还在 store buffer 里)
2. 跳过去执行 → CPU 去 L1I 取指 → 但 L1I 里可能还是旧的!
L1I 和 L1D 是两块物理独立的缓存,没有自动同步——你改了 L1D 里的副本,L1I 不会自动看到。
7.2 x86 的做法:硬件自动维护(但贵)
x86 在硬件层处理 I-D 一致性:store 修改某条 line 时,硬件自动使 L1I 中同地址的 line 失效,下次取指重新从 L2 加载(自修改代码 SMC 检测)。
代价:硬件维护本身有开销,且写了新代码 → L1I 被失效 → 下次取指 miss 重取——每次 JIT 编译完的第一次执行必有一次 I-cache miss。
7.3 ARM 的做法:显式指令,软件负责
ARM 架构不在硬件层维护 I-D 一致性,软件必须显式执行缓存维护指令:
// ARM 自修改代码的标准序列(简化)
DC CVAU, addr    // 1. 把 D-cache 里这个地址的脏数据刷到 unified L2(Point of Unification)
DSB ISH           // 2. 数据同步屏障,确保前面的 store 对所有人可见
IC IVAU, addr     // 3. 使 I-cache 里这个地址失效(下次取指去 L2 拿)
DSB ISH           // 4. 指令同步屏障
ISB               // 5. 刷新流水线,确保后续取指看到新指令
这是 ARM 上 JIT 编译器(如 V8 JavaScript 引擎的 ARM 后端)必须正确处理的序列。写错 = 执行的是旧代码 = 随机 crash 或安全漏洞。
7.4 不是 JIT 就没事?—— 动态库加载也是同类问题
dlopen 加载新的 .so 时,链接器把代码段 mmap 进进程地址空间。现代 Linux 默认开启 W^X(内存要么可写、要么可执行):先映射为可写做重定位,再 mprotect 切成只读+可执行。切权限时内核会做必要的缓存维护(x86 上触发 invlpg 等),代价是"加载后的第一次调用"必然经历一轮 I-cache/iTLB 冷启动。
相关:W^X 原理和
mprotect风险见 memory-layout。
八、I-cache 与缓存一致性协议的关系
简短答案:I-cache 不参与 MESI 协议。
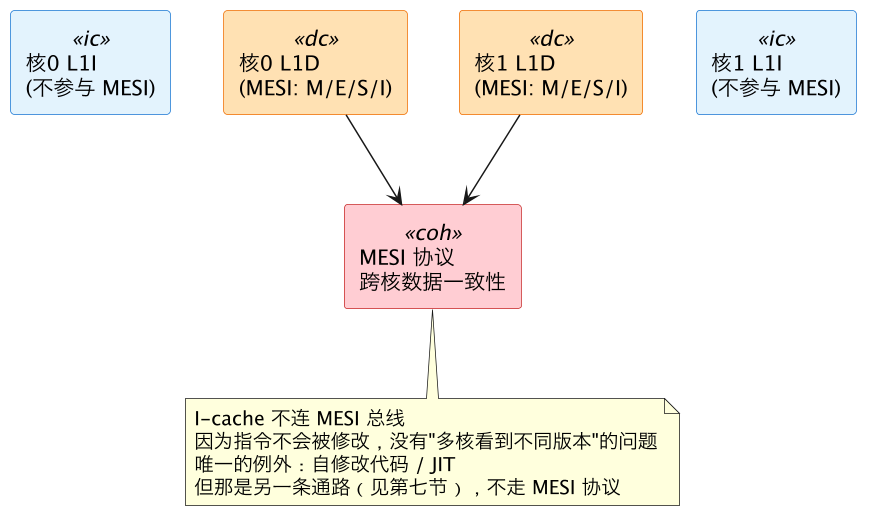
原因很简单:MESI 解决的是"多核修改同一份数据"的一致性问题。指令在运行时不会被修改(除非自修改代码/JIT),每个核拿到的指令副本永远一样,不存在谁新谁旧,自然不需要 M/E/S/I 状态。
这意味着:I-cache line 被驱逐时不需写回(不脏)、被 snoop 时不需响应,一致性总线与它无关——这也是 I-cache 更简单、更快的原因之一。
九、怎么用 perf 观测 I-cache
9.1 专用事件
# I-cache miss
perf stat -e L1-icache-load-misses ./app
# I-cache miss 率
perf stat -e L1-icache-loads,L1-icache-load-misses ./app
# iTLB miss
perf stat -e iTLB-load-misses ./app
# 前端停顿(frontend stall)—— 包含 I-cache/iTLB/分支误预测
perf stat -e stalled-cycles-frontend ./app
# 前端 vs 后端停顿对比
perf stat -e stalled-cycles-frontend,stalled-cycles-backend ./app
# 若 frontend stall 占比显著高 → I-cache/iTLB/分支预测有问题
# 若 backend stall 占比显著高 → D-cache miss/执行端口争用
# 综合诊断
perf stat -e cycles,instructions,\
L1-icache-loads,L1-icache-load-misses,\
iTLB-load-misses,\
stalled-cycles-frontend,stalled-cycles-backend ./app
9.2 判读
| 观测 | 含义 | 指向什么问题 |
|---|---|---|
L1-icache-load-misses 高 | I-cache 频繁 miss | 代码膨胀,热路径 > 32KB,或代码跳转模式差 |
iTLB-load-misses 高 | 指令地址翻译频繁 miss | 大二进制,热点函数跨越过多 4KB 页 |
stalled-cycles-frontend 高 | 前端喂不上指令 | 综合:I-cache miss + iTLB miss + 分支误预测;frontend 明显大于 backend 时优先排查代码大小、布局、iTLB |
9.3 只取某一个函数的统计(采样模式)
# 采样看哪个函数 I-cache miss 最集中
perf record -e L1-icache-load-misses ./app
perf report                        # 看 miss 集中在哪些函数
# 看前端停顿集中在哪里
perf record -e stalled-cycles-frontend ./app
perf report
十、和本仓库其他文档的关系
- 寻址原理与 D-cache 对照:cache-organization(Tag/Index/Offset 全适用;I-cache 不参与 MESI 见本文第八节)
- 前端停顿:cpu-microarch-overview 的 frontend stall,I-cache miss 是主因之一
- 分支预测:branch-prediction 误预测会连带触发 I-cache/iTLB miss
- TLB 另一半:tlb 聚焦 dTLB,iTLB 见本文第六节
- 数据侧局部性:cache-friendly-code(代码侧已在本篇覆盖)
- JIT/动态加载/上下文切换:memory-layout 的 W^X、valgrind 的 JIT 检测、context-switch 的 L1I 冷启动
- 观测:
perf stat -e L1-icache-load-misses/iTLB-load-misses/stalled-cycles-frontend
十一、一句话总结
CPU 不只从缓存读数据,也从缓存取指令——而且走的是另一条独立的硬件通路(L1I,哈佛结构)。I-cache 只读不写、不参与 MESI、结构更简单,但它有自己的坑:代码膨胀会让 L1I 装不下热指令、大二进制会让 iTLB 崩、分支误预测会连带触发 I-cache miss、JIT 需要处理 I-D 一致性。L2/L3 是 unified 的,意味着代码和数据会互相抢占容量。观测用
perf stat看L1-icache-load-misses和stalled-cycles-frontend。