编译器重排(Compiler Reordering)—— 编译期就发生的第一层乱序
reordering-overview 把"重排"拆成三层:编译器重排(编译期) / CPU 乱序执行(运行期·核内) / 内存重排(运行期·跨核)。第2层有 cpu-out-of-order、第3层有 memory-reordering,独缺第1层的专篇——本篇补上。
编译器重排常被忽略,因为它"太早"发生:在 CPU 还没跑之前,编译器就已经把你的代码顺序改了。它和硬件重排是完全独立的成因——关掉所有 CPU 乱序、换成最老实的顺序执行核,编译器重排照样能让你的多线程代码出错。本篇讲清:编译器为什么重排、具体做哪些、为什么单线程无感多线程出错、
volatile到底管不管用、以及怎么正确拦它。
一、根据 as-if 规则:编译器只保证"单线程结果不变"
C/C++ 标准给编译器一条核心授权——as-if 规则(as-if rule)。名字直译是"仿佛规则":编译器生成的程序只要表现得"仿佛"(as if)严格按源码一条条执行过就行,底下怎么改、改成什么样,标准一概不管。
as-if 规则:编译器可以对程序做任何变换(换序/合并/删除/缓存/并行化……),只要变换后的程序的**可观测行为(observable behavior)**和"抽象机严格按源码执行"时一致即可。
这条规则出自 C++ 标准 [intro.abstract](旧称 [intro.execution]),原文大意是:"符合标准的实现只需模拟抽象机的可观测行为"。C 标准 §5.1.2.3 有等价条款。换句话说,标准定义了一台"抽象机(abstract machine)"——它老老实实按你写的顺序执行;而真实编译器只要对外表现和这台抽象机一样,内部就是自由的。
"可观测行为"到底指哪些?——标准只认这三类
as-if 的全部约束,浓缩成"可观测行为"这个词。标准把它精确限定为下面三类,除此以外的一切都可被优化掉:
| 可观测行为(编译器必须保住) | 说明 |
|---|---|
① volatile 对象的访问 | 每次 volatile 读/写都必须真发生、且保持相互顺序(正是第四节 volatile 的语义来源) |
| ② 程序终止时写入文件/设备的数据 | 即 I/O:printf、写文件、网络发送等——最终产生的字节序列必须和抽象机一致 |
| ③ 交互设备的输入输出时序 | 提示信息必须在等待输入之前真的送达(所以带 I/O 的循环编译器不敢乱删/乱调) |
反过来读这张表最有用:凡是不属于这三类的东西——普通变量的中间值、局部计算、临时对象、甚至一段没有 I/O 的循环——编译器都有权改写或抹掉,只要最终的 ①②③ 对得上。这就是为什么
sum += i的纯计算热循环能被整段删除(见第六节)、为什么while(!flag)的空自旋能被优化没(第二、六节):它们不产生任何可观测行为。
C/C++ 标准给编译器一条核心授权——as-if 规则:
编译器可以对程序做任何变换,只要变换后的程序在单线程下的可观测行为和原程序一致。
"可观测行为"指:程序的最终输出、volatile 访问、I/O 这些。在这个约束内,编译器可以自由调换、合并、删除、缓存你的读写——只要单线程看不出区别。
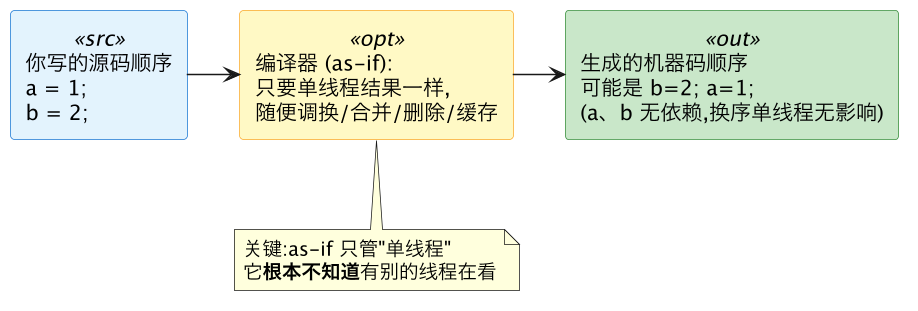
核心认知:as-if 是单线程契约。编译器优化时假设代码是单线程的——它看到
a、b之间没有数据依赖,就认为换序绝对安全。它意识不到另一个线程可能正盯着a和b的先后。 这就是编译器重排在多线程下闯祸的根源。
二、编译器具体做哪些"重排"
"编译器重排"是个统称,实际包含好几类变换。它们都在 as-if 授权内,单线程都无害:
| 类型 | 做什么 | 例子 |
|---|---|---|
| 语句换序(reordering) | 调换无依赖的独立读写 | a=1; b=2; → b=2; a=1; |
| 寄存器缓存(hoisting) | 把内存变量读进寄存器、循环里不再重读 | while(!flag){} → if(!flag) while(true){}(flag 只读一次!) |
| 死代码消除(DCE) | 删掉"没有可观测效果"的读写 | 写了从不读的变量 → 整条删掉 |
| 合并(coalescing) | 多次写合成一次 | x=1; x=2; → x=2;相邻小写合成宽写 |
| 提升/下沉(hoist/sink) | 把循环内不变的计算移到循环外 | 循环不变量外提 |
最危险、最常咬人的是寄存器缓存——看这个多线程等待循环:
bool flag = false;   // 普通变量,另一个线程会置 true
// 线程 A 等待:
while (!flag) { }    // 你以为:反复读内存里的 flag,直到别人改成 true
// 线程 B: flag = true;- 你的意图:每次循环重新读
flag,直到看到 true 就退出。 - 编译器怎么想:as-if 下它认定"这循环体里没人改
flag",于是把flag读进寄存器一次,循环里只看寄存器——生成的等价代码是:
if (!flag)           // 只读一次内存
while (true) { } // flag 在寄存器里永远是 false → 死循环!- 后果:哪怕线程 B 真把内存里的
flag改成了 true,线程 A 永远看不到——它在看一个缓存在寄存器里的旧值。死循环。 而且这完全不涉及 CPU 缓存或多核可见性,是编译器一家干的——关掉多核、单核跑也一样死。
用时序图看清"寄存器里的旧值和内存里的新值分道扬镳":
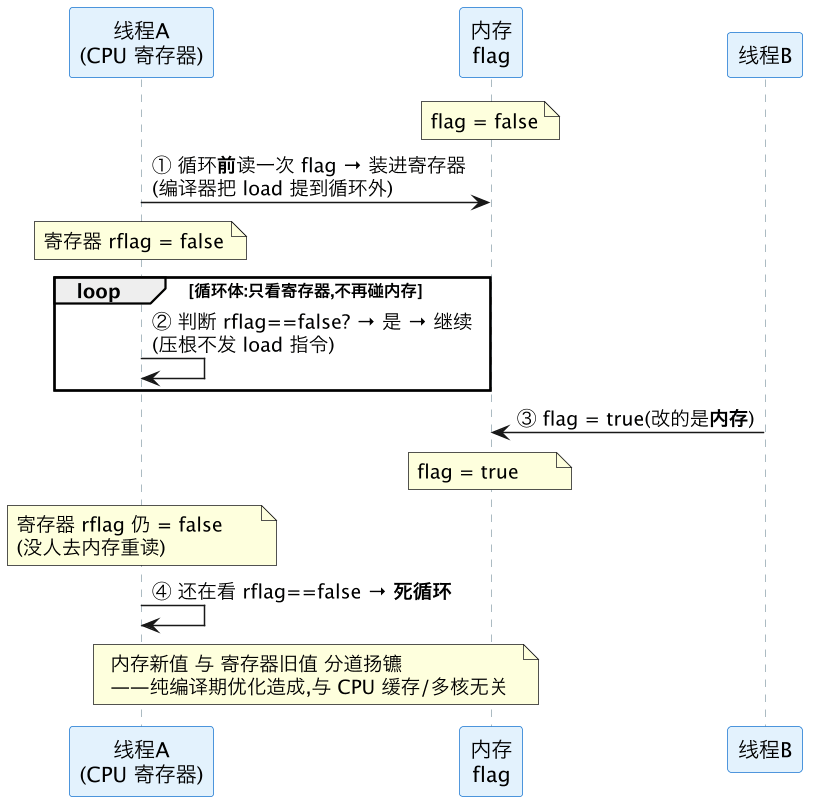
等等——缓存一致性协议(MESI)不是保证一致吗?为什么救不了?
这是最常见的困惑:既然有 MESI(mesi)保证多核缓存一致,线程B 改了 flag,线程A 不是该看到最新值吗? 关键在于——MESI 管不到寄存器,寄存器根本不在它的管辖范围内。
- MESI 保证的是"各核缓存副本 ↔ 内存"这一层的一致。它嗅探总线,让同一 cache line 的多份缓存副本对外像一份。但寄存器不是缓存——它是 CPU 核内的私有存储,MESI 嗅探时根本看不见"某个值被 load 进了寄存器",无从通知它更新,寄存器压根不参与一致性协议。
- 更要命的是:优化后线程A 的循环体根本不再发 load 指令了——
flag只在循环前被读进寄存器一次,之后每轮只看寄存器rflag,完全不碰缓存也不碰内存。MESI 再尽职,也需要你"去读缓存"这个动作才有机会保证一致;你不读,它无从发力。
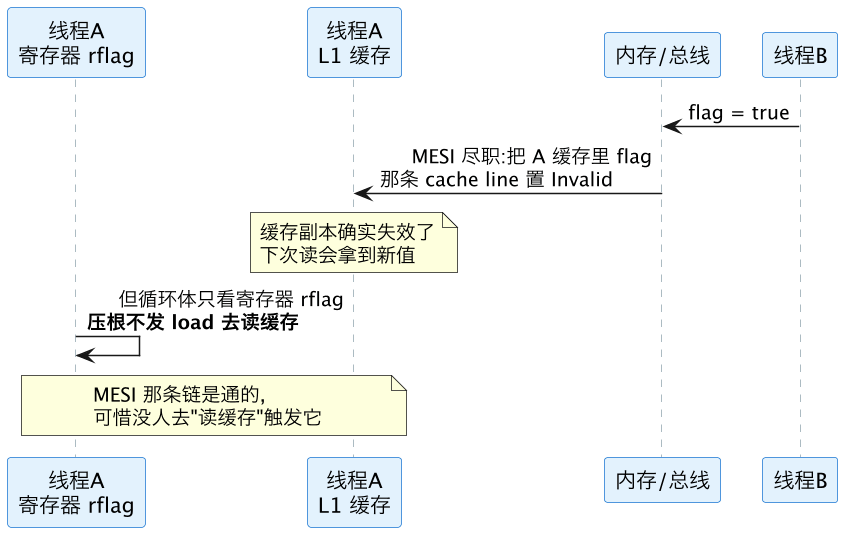
三层各归谁管,一眼看清 MESI 的边界:
| 层次 | 谁保证一致 | 本例里 |
|---|---|---|
| 各核缓存副本 ↔ 内存 | MESI(硬件) | ✅ 正常工作:flag 的 cache line 被正确失效 |
| 缓存 ↔ 寄存器 | 没有任何硬件协议——由编译器决定何时 load/store | ❌ 出事点:编译器只 load 一次,之后不再同步 |
一句话:MESI 保证的是"当你去读缓存时,读到的是最新值";但编译器优化把 load 提走后,线程A 根本不去读了。缓存一致性是"缓存/内存这一层"的事,寄存器高它一层、是编译器的地盘,硬件协议够不着。这也正是
volatile为什么能治它——volatile强制每次访问都真发 load 指令(绕开寄存器、去读缓存),一旦重新发 load,MESI 那条链就接上了,自然读到最新值(但volatile只补上"读寄存器→读缓存"这一环,多核间的乱序可见性它仍管不了,见第四节)。
这真的会发生吗?—— 会,而且很容易复现
不是理论假想。普通(非 volatile/非原子)全局变量 + 自旋等待循环,在 -O2 下几乎必然被这样优化——这正是历史上 volatile、如今 std::atomic 必须存在的经典理由。
- 怎么亲眼看到:把上面的代码在 Compiler Explorer 上用
gcc -O2编译,或本地g++ -O2 -S(见 objdump)。你会看到-O0版循环体里每轮都有一条mov(从内存读 flag),而-O2版把 load 提到循环外、循环体退化成一条无条件jmp .(原地死跳)——铁证。 - 触发条件:编译器要能"证明"循环体内没人改
flag。对一个循环体里不写flag、也没调用不透明函数(它看不穿的函数可能改全局)的循环,它就敢把 load 提出去。所以:- 很可能死循环:
while(!flag){}空循环体、或循环体只做与flag无关的纯计算。 - 可能"碰巧"不死:如果循环体里调了一个编译器看不见实现的函数(如
printf、跨编译单元的函数),编译器不敢假设flag没变,被迫每轮重读——于是碰巧"能跑对"。但这是运气,不是正确:换个编译器/开 LTO/内联展开后,保证立刻复活成死循环。
- 很可能死循环:
- 权威定性:这属于数据竞争(data race) ——两个线程无同步地访问同一非原子变量、且至少一个是写。C/C++ 标准规定数据竞争是未定义行为(UB),编译器没有义务让你"看到"另一个线程的写。死循环只是 UB 诸多合法后果里最常见的一种。
结论:会发生、能复现、且是标准明确允许的 UB 后果——不能靠"我测过能跑"来赌。正确写法是让编译器知道"这个变量会被异步改":用
std::atomic<bool>(见 memory-order),退一步用volatile(仅够治这个寄存器缓存问题、但不解决多核可见性,见第四节)。
三、为什么单线程永远无感、多线程才出错
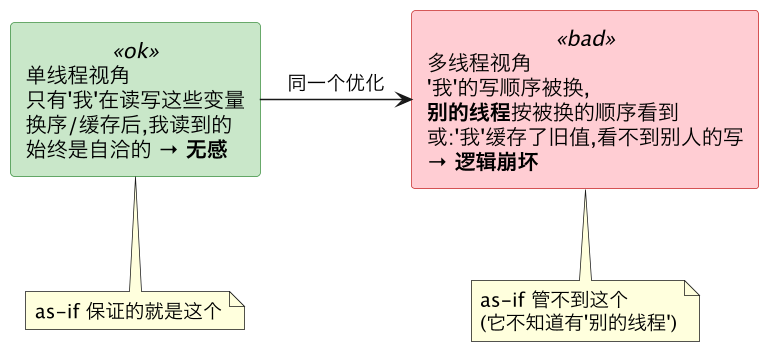
- 单线程:只有你自己读写这些变量,编译器换序/缓存后你读到的值始终自洽(它就是这么保证 as-if 的)——你永远发现不了它动过手脚。
- 多线程:另一个线程按被改过的顺序观察你的写(或者你缓存了旧值看不到别人的写),跨线程的约定就被破坏了——
flag死循环、"填好数据再抬标志"变成"标志先亮数据没到"。
这和 store-buffer 讲的硬件重排现象相似、成因完全不同:硬件重排是运行期 CPU/缓冲区造成的,编译器重排是编译期就把机器码顺序写死了。所以两者要分别用不同手段拦(见第五节)。
四、volatile:能治什么,不能治什么(最大误区)
很多人以为 volatile 是并发利器——大错。先说清它到底做什么。
volatile 对编译器的约束只有两条:
- 不缓存进寄存器:每次访问
volatile变量都真的生成一条 load/store 访存指令(治得了第二节的while(!flag)死循环)。 - 不删除、不合并
volatile访问,且多个volatile访问之间不互相重排(保持它们的相对顺序)。
精确一点:volatile 是"每次真发访存指令",不是"每次读内存"
这是最容易说错的一点。volatile 是编译器层的概念,它约束的是编译器发不发访存指令,管不到这条指令发出去之后数据从哪来:
volatile保证:每次访问都真生成mov reg,[addr]这样的 load/store(不许用寄存器里的旧值、不许省略)。- 但这条指令执行时,数据从 L1 命中就从 L1 拿、miss 才逐级到内存——这是 CPU 缓存硬件的事,
volatile完全管不着。所以绝大多数volatile读其实停在 cache 命中,根本到不了内存。
那为什么这样也能治死循环?因为只要重新发 load,就重新进入了缓存一致性(MESI)的管辖范围:线程B 改 flag → MESI 把线程A 缓存的那条 line 置 Invalid → volatile 强制发 load → miss → 取到最新值。volatile 补上的是"读寄存器→读缓存"这一环(把视线从寄存器拉回缓存),"缓存→拿到最新值"那一环是 MESI 自动保证的(见第三节)——两环接上就读到新值,不需要真走到内存。
三个"访问层次"对比,看清 volatile 到底停在哪:
| 概念 | 保证什么 | 数据到哪 |
|---|---|---|
| 普通变量(可优化) | 编译器可缓存进寄存器、甚至根本不访存 | 可能哪都不到(命中寄存器) |
volatile | 每次真发访存指令、绕开寄存器 | 到 cache(命中就停在 cache);miss 才到内存 |
| 真想绕过 cache 直达内存 | 需特殊手段:uncacheable 内存(如 MMIO 映射)、clflush/non-temporal 指令 | 内存 |
所以
volatile最初正是为 MMIO(设备寄存器) 设计的——那块地址被标成 uncacheable、访问天然不走 cache、每次必须真访问硬件。但对普通内存变量,volatile的访存照样走 cache,不强制到内存。记住:volatile= 每次真发访存指令(bypass 寄存器),≠ 每次读内存(bypass cache)。
volatile 做不到的(致命):
- ❌ 不保证原子性:
volatile long x; x++仍是"读-改-写"三步,多线程照样丢更新。 - ❌ 不是内存屏障:它只拦编译器这一层,完全管不住 CPU 乱序和 store buffer(第3层硬件重排)。
volatile写在别的核眼里照样可能延迟可见、乱序可见。 - ❌ volatile 访问和普通访问之间可以重排:它只保证 volatile 之间有序,普通变量能穿插进来。
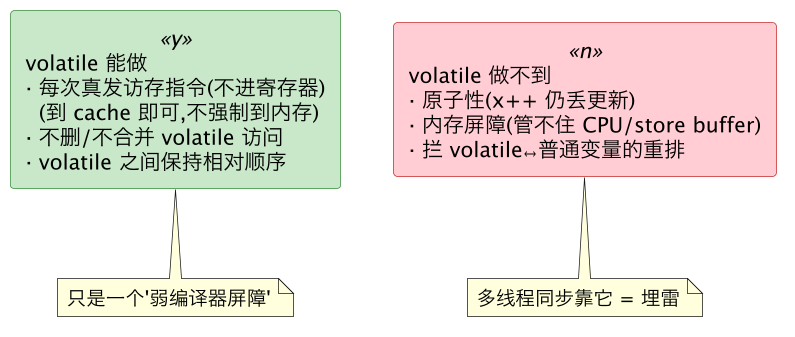
结论:
volatile是为内存映射 I/O(MMIO)、信号处理、setjmp场景设计的——那些"这块内存会被硬件/异步改,别给我缓存/优化掉"的需求。它不是并发同步工具。多线程共享数据的正确工具是std::atomic(它同时压住编译器重排 + 硬件重排,见 memory-order)。Java/C# 的volatile语义完全不同(带内存屏障),别把 C++ 的volatile当那个用——这是跨语言最大的坑之一。
五、怎么正确拦编译器重排
5.1 编译器屏障(compiler barrier)
最轻量的手段,告诉编译器"别跨这条线重排内存访问、别把内存值缓存在寄存器里":
asm volatile("" ::: "memory");   // GCC/Clang:空指令 + "memory" clobber
// C++11:
std::atomic_signal_fence(std::memory_order_seq_cst);  // 标准写法,同义
关键性质:
- 不生成任何机器指令(那个
asm是空的),运行期零开销。 - 它只是给编译器的一道"栅栏":栅栏前的内存写必须在栅栏前完成、栅栏后的读必须重新从内存读。
- 它只拦第1层(编译器)——挡不住 CPU 乱序和 store buffer(第3层)!这是最常见的误用。
5.2 编译器屏障 ≠ 内存屏障(核心区分)
| 编译器屏障 | 内存屏障(硬件) | |
|---|---|---|
| 写法 | asm volatile("":::"memory") / atomic_signal_fence | mfence/lock/dmb / atomic_thread_fence |
| 拦哪层 | 第1层:编译器重排 | 第3层:CPU/store buffer 硬件重排 |
| 有无机器指令 | 无,纯编译期约束 | 有,真指令 |
| 运行期开销 | 零 | 有(排空 store buffer 等) |
| 单独用够吗(多线程) | 不够——硬件照样乱序 | 也不够——编译器还能在它周围乱序 |
最常见的并发 bug 之一:加了
mfence却被编译器把读提到写前(只拦了硬件没拦编译器),或加了编译器屏障却被 store buffer 颠倒(只拦了编译器没拦硬件)。正确的并发原语要两层一起下——这正是std::atomic(默认seq_cst)替你做的:它同时发编译器屏障和内存屏障。所以并发同步别自己拼屏障,用std::atomic(见 memory-order)。
5.3 用 std::atomic(推荐)
std::atomic<bool> flag{false};
while (!flag.load(std::memory_order_acquire)) { }  // 编译器+硬件两层都被正确约束
std::atomic 的每个操作:①编译器不会缓存/乱序它 ②按你选的 memory_order 发相应硬件屏障。这才是多线程共享变量的正确工具,volatile 不是。
六、怎么"看见"编译器重排
编译器重排看反汇编最直接(见 objdump):
# 对比 -O0 和 -O2 生成的汇编,直接看到优化器动了哪些顺序、缓存了哪些变量
g++ -O0 -S test.cpp -o test_O0.s
g++ -O2 -S test.cpp -o test_O2.s
diff test_O0.s test_O2.s
# 或 Compiler Explorer(godbolt.org)在线对比,最直观
objdump -d -S ./app # 反汇编 + 源码混排,看某个函数的指令顺序(见 objdump.md)典型现象:-O0 里 while(!flag) 每轮都有一条 load 指令;-O2 里 load 被提到循环外、循环体变成纯 jmp(死循环)——这就是寄存器缓存优化的铁证。
6.1 一份完整可运行的例子:观察 data-race UB 的两种表现
📁 这一节的代码已做成可直接编译运行的子项目(跨 Linux/macOS):demos/compiler-reordering/ ——
make run一键对比正确的原子版和错误的普通版,make asm看反汇编坐实编译器动了手脚。
下面这份 reorder_demo.cpp 是自包含、可直接编译运行的。它开一个"等待线程"自旋在 while(!flag),主线程睡 1 秒后把 flag 置真。用宏 USE_ATOMIC 切换"普通变量版(错误)"和"原子变量版(正确)":
// reorder_demo.cpp
// 演示普通共享变量的 data-race UB,以及 std::atomic 的正确修复。
//   普通变量版:   g++ -O2 -pthread reorder_demo.cpp -o demo && ./demo
//                 → UB!等待线程根本没在等 flag(见下方"两种表现")
//   原子变量版:   g++ -O2 -DUSE_ATOMIC -pthread reorder_demo.cpp -o demo && ./demo
//                 → 正确:main 先 setting,waiter 才 saw,顺序永远对
#include <atomic>
#include <chrono>
#include <cstdio>
#include <thread>
#ifdef USE_ATOMIC
std::atomic<bool> flag{false};   // 正确:编译器不缓存进寄存器 + 带 acquire/release 语义
inline bool read_flag()  { return flag.load(std::memory_order_acquire); }
inline void write_flag() { flag.store(true, std::memory_order_release); }
#else
bool flag = false;               // 错误:普通变量,-O2 下 data race = UB
inline bool read_flag()  { return flag; }
inline void write_flag() { flag = true; }
#endif
int main() {
    std::thread waiter([] {
        std::puts("waiter: spinning on flag...");
        while (!read_flag()) {
            // 空循环体:编译器认定这里没人改 flag
        }
        std::puts("waiter: saw flag=true, exiting");
    });
    std::this_thread::sleep_for(std::chrono::seconds(1));
    std::puts("main:   setting flag=true");
    write_flag();
    waiter.join();
    std::puts("main:   joined, done");
    return 0;
}
普通变量版的"两种表现"——都是同一个 UB
data race 是未定义行为(UB),编译器没义务让你看到另一个线程的写。不同编译器/版本会选不同的合法后果,你可能看到下面任意一种:
表现 A —— 死循环卡住(经典寄存器缓存)
编译器把 flag 的 load 提到循环外,循环体退化成 jmp .,等待线程永远看不到 true → 卡死,要 Ctrl-C。
表现 B —— "秒退",且打印顺序颠倒(你截图里就是这个)
waiter: spinning on flag...
waiter: saw flag=true, exiting   ← waiter 在 main 之前就"看到"了 true
main:   setting flag=true         ← main 其实还没设置!
main:   joined, done
注意 waiter 的 "saw" 打在了 main 的 "setting" 之前——这不是"程序正常退出",恰恰是 bug:等待线程根本没在等
flag。成因是 C++ 的前进保证(forward progress):标准规定"无副作用的循环可被假定会终止",编译器于是直接把整个自旋循环删掉,让 waiter 不经等待径直往下走。删循环和死循环是同一 data-race UB 的两副面孔,取决于你的编译器怎么选。
用时序图看清"编译期删循环"如何让运行时的打印顺序与源码意图颠倒——左边是源码以为的顺序,右边是删循环后实际发生的:
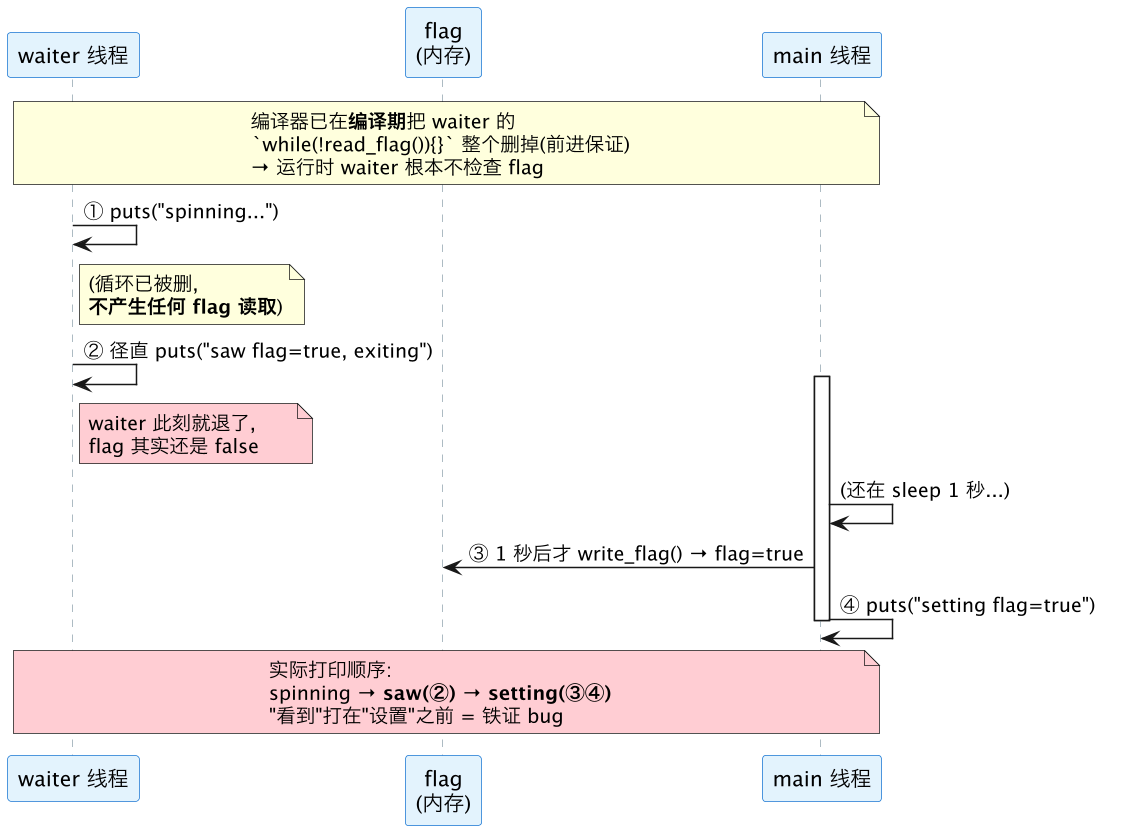
对照正确程序应有的顺序(原子变量版):spinning → setting → saw —— main 先设置、waiter 才看到。删循环把 ② 提到了 ③ 之前,顺序颠倒正是"waiter 压根没等"的外在证据。
判定是否为 bug 的铁律:正确程序里 main: setting 必定在 waiter: saw 之前。只要顺序反了、或根本卡死,就是 data race。换成原子变量版,顺序永远正确——这才是"程序真的在同步"。
想稳定复现"表现 A 死循环"
如果你的编译器选了"删循环"(表现 B),想稳定看到卡死,给循环体加一句有可观测副作用的语句,让编译器不敢删循环、但仍会把 flag 缓存进寄存器:
long spins = 0;
while (!read_flag()) {
    ++spins;                 // 有副作用 → 编译器不能删循环
    asm volatile("" :: "r"(spins) : );  // 阻止把 ++spins 也优化掉
}
std::printf("waiter: saw flag=true after %ld spins\n", spins);
此时 -O2 下编译器保留循环,但仍把 flag 读进寄存器只读一次 → 稳定死循环(spins 一直加、永不退出)。
用反汇编坐实"编译器动了手脚"
# 普通变量版:看 waiter 的自旋循环——load 被提出循环 / 循环被删
g++ -O0 -pthread -S reorder_demo.cpp -o plain_O0.s
g++ -O2 -pthread -S reorder_demo.cpp -o plain_O2.s
diff plain_O0.s plain_O2.s
#   -O0:循环体每轮都有 movzbl flag(%rip),%eax(每轮真读内存)
#   -O2:循环体里没有 flag 的 load —— 要么 jmp . 死跳(表现A),要么循环整段消失(表现B)
# 原子变量版:即使 -O2,循环体里仍每轮真发 load
g++ -O2 -DUSE_ATOMIC -pthread -S reorder_demo.cpp -o atomic_O2.s
# 循环体里稳定出现 movzbl flag(%rip),%eax —— 每轮从内存/缓存重读,MESI 那条链接得上对照结论:同一份自旋循环,
flag是普通变量时-O2把 load 提出循环(死循环)或干脆删掉循环(秒退且顺序颠倒)——两种都是 data-race UB,不是"能跑";换成std::atomic<bool>后-O2仍老实每轮发 load、打印顺序永远正确。这就是为什么并发共享变量必须用std::atomic而非裸变量(见第四、五节)。想只修编译器这一层做实验,也可把read_flag里的读改成先asm volatile("":::"memory");再读flag(编译器屏障,零开销),死循环/删循环同样消失——但那只拦住第1层,多核可见性仍要靠std::atomic。
呼应本仓库的教学点:
make release(-O2)会让main.cpp里sum += i的热循环被整个优化掉(死代码消除)——那也是编译器"as-if"授权下的合法删除(见CLAUDE.md的已知简化说明、compile-link-load)。
七、和本仓库其他文档的关系
- 导读:reordering-overview——三层重排框架,本篇是其"第1层"的展开(与第2层 cpu-out-of-order、第3层 memory-reordering 并列,三层各有一篇)。
- 正确工具:memory-order(
std::atomic+memory_order如何同时压住编译器和硬件两层)、atomic。 - 硬件层对照:store-buffer / memory-reordering——现象像、成因和拦法都不同(编译期 vs 运行期)。
- 观测工具:objdump(反汇编看重排)、compile-link-load(编译优化阶段)。
八、一句话总结
编译器重排是"重排"的第一层、发生在编译期:根据 as-if 规则,编译器只需保证单线程可观测结果不变,就能自由换序/寄存器缓存/删除/合并你的读写——它假设代码是单线程的,意识不到别的线程在看,于是多线程下闯祸(经典是
while(!flag)把 flag 缓存进寄存器成死循环)。它和硬件重排完全独立,单核也会发生。volatile只是个'弱编译器屏障'(不缓存/不删/volatile 间有序),但既不保证原子性、也不是内存屏障,绝不能当并发同步工具用。正确拦法:编译器屏障(asm volatile("":::"memory"),零开销但只拦这一层)——而多线程同步要编译器+硬件两层一起下,直接用std::atomic,别自己拼。