"重排"导读 —— 三个层次,别混成一件事
"重排(reorder)"是并发话题里被严重滥用的词。人们说"CPU 会重排指令""内存会重排""编译器重排",听起来像同一件事,其实是三个不同层次、不同性质、不同防御手段的机制。最常见的误解,就是把 CPU 乱序执行(out-of-order execution) 和 内存重排(memory reordering) 当成一回事——它们是正交的两件事。
本篇是"重排"家族的导读:先把三个层次一次性拆清、给出对照表,再路由到各细分篇。读完这篇再去看细分篇,就不会把"CPU 跑得快"的机制和"多核顺序对不对"的机制搅在一起。
一、先破一个误解:CPU 乱序执行 ≠ 内存重排
这是全篇最重要的一句话,先钉死:
| CPU 乱序执行(OoO) | 内存重排(memory reordering) | |
|---|---|---|
| 是什么 | 核内的性能引擎:不按程序序、按"操作数就绪"顺序执行指令,填满执行端口 | 多核下别人观察到的访存顺序≠ 本核程序序 |
| 作用对象 | 所有指令(算术、逻辑、分支、访存都乱序) | 只关乎访存(load/store)的对外可见顺序 |
| 关注点 | "单核怎么跑得快" | "多核下顺序看得对不对" |
| 单核可见吗 | 不可见——靠顺序退休(in-order retire)保证单核结果和顺序执行一样 | 单核也不可见(store forwarding 兜住),只有别的核能观察到 |
| 主要成因 | ROB / 保留站 / 寄存器重命名 / 投机执行 | store buffer / invalidate queue(不是 OoO!) |
| 归哪篇 | cpu-out-of-order | memory-reordering |
**两者的关系是"部分交集,而非等同" **:
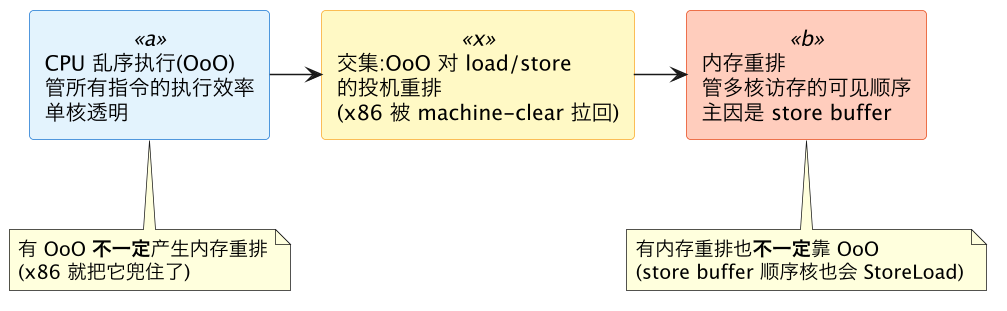
- 有 OoO 不一定有内存重排:x86 是深度乱序的,但它把 OoO 对访存的乱序用 machine-clear 拉回 TSO,最终暴露的内存重排几乎只剩 store buffer 造成的 StoreLoad。
- 有内存重排不一定靠 OoO:哪怕一个顺序执行(非乱序)的核,只要有 store buffer,就会有 StoreLoad 重排。内存重排的主因是缓冲区,不是乱序引擎。
一句话:OoO 是"怎么跑得快"(微架构,单核事),内存重排是"多核看得对不对"(内存模型,多核事)。它们在"访存的投机重排"上有一点交集,但绝不是同义词。 把这两件事分开,才是理解整个并发内存模型的第一步。
问题:这里要说明一下什么是OoO?
二、"重排"的三个层次:一张总图
把"源代码 → 别的核看到的效果"这条链路走一遍,中间有三道独立的重排关卡,分属编译期与运行期:
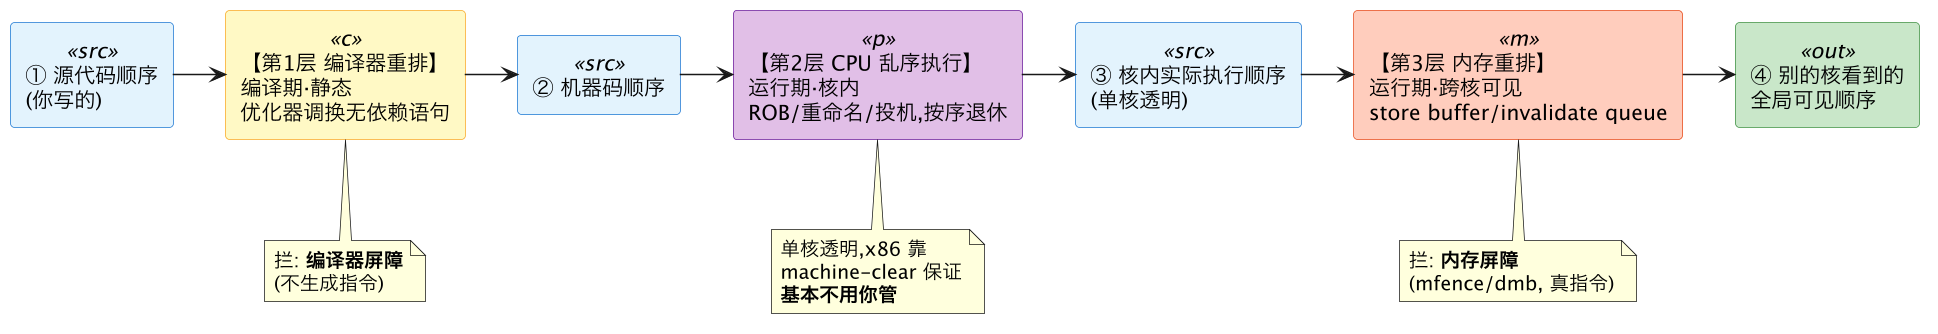
三层各是一件独立的事,防住一层不等于防住全部(详见第三节表):
- 编译器重排(编译期):优化器在单线程 as-if 语义下调换独立读写、把变量缓存进寄存器。纯静态,不生成任何机器指令。
- CPU 乱序执行(运行期·核内):这就是"CPU 重排",性能引擎。乱序执行但按序退休,单核完全透明;对访存的乱序在 x86 被 machine-clear 拉回。
- 内存重排(运行期·跨核):store buffer 让写延迟可见、invalidate queue 让失效延迟生效,导致别的核看到的访存顺序被打乱。
问题:这里好像没有看到流水线引起的乱序执行?x86流水线的乱序执行我们不需要care吗?
注意第 2 层和第 3 层都在运行期、都涉及硬件,最容易被合并成"CPU 重排"一说——但它们成因不同(乱序引擎 vs 缓冲区)、可见性不同(单核透明 vs 跨核可见)、防御不同(无需管 vs 内存屏障)。第一节那张交集图,讲的就是这两层的关系。
三、三层对照表:性质、可见性、怎么防
| 第1层 编译器重排 | 第2层 CPU 乱序执行 | 第3层 内存重排 | |
|---|---|---|---|
| 别名 | 编译期重排 | "CPU 重排"/OoO/乱序执行 | 内存序乱序/memory reordering |
| 谁干的 | 编译器优化器 | CPU 乱序引擎(ROB/保留站/重命名) | store buffer + invalidate queue |
| 时机 | 编译期,静态一次性 | 运行期,每次动态 | 运行期 |
| 作用对象 | 所有语句 | 所有指令 | 仅访存的对外可见顺序 |
| 单核可见 | 否(as-if) | 否(顺序退休) | 否(store forwarding) |
| 多核可见 | 是 | 间接(经第3层暴露) | 是(本质就是多核问题) |
| x86 上要不要管 | 要 | 基本不用(machine-clear 兜住) | 要(StoreLoad) |
| 怎么防 | 编译器屏障asm volatile("":::"memory") | 无需单独防 | 内存屏障mfence/lock/dmb |
| 有无机器指令 | 无 | —— | 有(且更贵) |
| 细分篇 | 本表即概览 | cpu-out-of-order | memory-reordering |
三个必须记住的结论:
- 编译器屏障 ≠ 内存屏障:前者只拦第1层、无指令、零开销、挡不住 store buffer;后者拦第3层、是真指令。一个正确的并发原语(
std::atomic默认序)两层都要下——这是最常见的 bug 来源。 - 第2层(OoO)在 x86 上不用你操心:乱序引擎投机重排 load,但违反 TSO 的会被 memory-ordering machine clear 清空重放(perf 的
machine_clears.memory_ordering)。它是性能机制,不是你拿屏障去防的东西。 - 三层相互独立、会叠加:关掉编译器优化,store buffer 照样制造 StoreLoad;没有 store buffer,编译器换序也能制造同样的错。所以要根除必须编译器屏障 + 内存屏障一起上。
四、路由:想深入哪一层,去哪篇
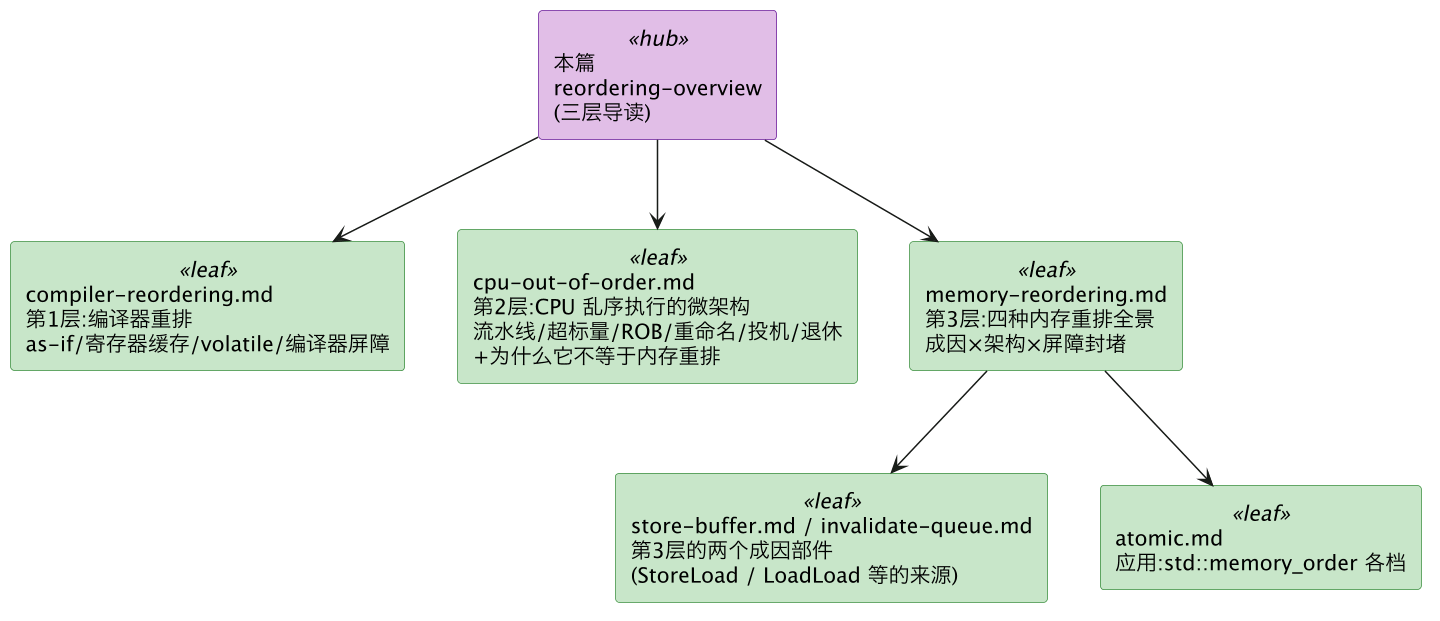
- 想搞清编译器为什么/怎么重排、volatile 管不管用、编译器屏障 → compiler-reordering
- 想搞清**"CPU 怎么乱序、为什么单核不出错、它和内存重排的边界"** → cpu-out-of-order
- 想搞清四种内存重排、哪种架构允许、用什么屏障 → memory-reordering
- 想搞清内存重排的硬件成因 → store-buffer、invalidate-queue
- 想搞清代码里怎么选内存序 → atomic
五、一句话总结
"重排"是三层独立机制的统称:编译器重排(编译期·静态·编译器屏障拦)、CPU 乱序执行(运行期·核内·单核透明·基本不用管)、内存重排(运行期·跨核可见·内存屏障拦)。其中最该分清的是——CPU 乱序执行是"单核怎么跑得快"的微架构引擎,内存重排是"多核看得对不对"的内存模型问题,两者只在"访存的投机重排"上有一点交集,绝非同一件事。防御要对层下药,编译器屏障和内存屏障各管一层、缺一不可。