线程亲和性(CPU Affinity)—— 把线程钉在指定 CPU 上:原理、实现与操作
默认情况下,线程跑在哪个 CPU 核由内核调度器决定,而且会随时被迁移到别的核。大多数程序不用管这个。但在追求低延迟、稳定尾延迟、高缓存命中的场景(交易系统、DPDK、数据库、实时任务),你会想把线程"钉"在固定的核上——这就是线程亲和性(CPU affinity / pinning)。
本篇从原理到操作逐层展开:调度器为什么会频繁迁移线程(sched_domain 层级、负载均衡触发条件)、亲和性在内核中如何实现(task_struct 存储、cgroup cpuset 交互、调度器强制检查点)、怎么绑(taskset / sched_setaffinity / pthread_setaffinity_np 三层工具)、绑核 vs 绑 NUMA 节点的区别、系统级核隔离的组合配方、以及绑错了反而更慢的坑。它和 scheduling(调度器内部如何选人)、numa(NUMA 远程访问代价)、cache-organization(缓存私有性)、tlb(TLB 冷了也要重新填)、mesi(多核缓存一致性/伪共享)都相关。
一、调度器为什么会让线程迁移——负载均衡的本质
要理解"为什么要绑核",首先要理解"调度器为什么要把线程搬来搬去"。
1.1 CFS/EEVDF 的设计目标与迁移的必然性
Linux 内核的完全公平调度器(CFS;v6.6+ 为 EEVDF)有两个核心目标:
- 公平性:每个可运行线程都应该获得"应有"的 CPU 时间(按 nice 权重分配)。如果一个线程长时间得不到运行,调度器必须主动把它放到能跑的核上。
- CPU 利用率:所有核应该尽量忙,不能出现"A 核有多个线程在排队等 CPU、B 核却空闲"的情况。
这两个目标天然会导致线程迁移——当一个核忙而另一个核闲时,调度器会把线程从忙碌核搬到空闲核。这称为负载均衡(load balancing)。
对吞吐型任务,迁移让所有核都充分利用——总体吞吐更高。但对延迟敏感任务,迁移的代价是被迁线程的所有缓存状态全部作废——这是"公平性/利用率"和"缓存局部性"之间的根本矛盾,调度器默认偏向前者。
1.2 sched_domain 层级——调度域决定了迁移的"代价认知"
调度器不是在所有核之间做无差别负载均衡。它按照 CPU 硬件拓扑构建层级化的调度域(sched_domain),每一级域对应一种共享资源:

| 调度域层级 | 标志位示例 | 共享资源 | 迁移代价 | 均衡策略 |
|---|---|---|---|---|
| SMT(超线程) | SD_SHARE_CPUCAPACITY | 同一物理核的 L1/L2、执行单元 | 最低——缓存全共享 | 优先在此域内均衡 |
| MC(多核) | SD_SHARE_PKG_RESOURCES | L3 cache(同一 socket) | 中等——L1/L2 冷,L3 热 | 仅当 SMT 域已均衡后才上升 |
| DIE(die 内) | — | 可能同一 socket(取决于拓扑) | 较大——L3 也可能冷 | MC 均衡后再上升 |
| NUMA(跨 socket) | SD_NUMA | 无共享缓存 | 最大——远程内存访问 | 频率最低,只在严重不均衡时触发 |
调度器的均衡策略是**"自底向上"**的:先在最细粒度域(SMT)内均衡 → 均衡不了才上升一级 → 直到 NUMA 域。这保证了"便宜的迁移优先做,贵的迁移尽量少做"——但"便宜"是相对于整个系统的吞吐而言的,对单个线程来说每次迁移都意味着缓存全冷。
1.3 负载均衡何时触发——三种触发时机
| 触发时机 | 函数入口 | 场景 | 行为 |
|---|---|---|---|
| 周期性均衡 | rebalance_domains() | 每个 CPU 的调度 tick(每 1~10ms,取决于 CONFIG_HZ) | 更新各 CPU 负载值,比较相邻 CPU 是否不均衡。如果一段时间窗口内持续不平衡,触发迁移 |
| 新空闲均衡 | newidle_balance() | 某 CPU 进入空闲(当前无可运行任务),即将 idle | 从最繁忙的 CPU 拉取任务来跑——"别的核忙不过来,我来帮忙"。最激进的均衡,可能跨多级域 |
| 唤醒均衡 | select_task_rq_fair() | 线程被唤醒时(数据到达、锁释放、定时器到期) | select_idle_sibling() 在唤醒者的 sched_domain 内找 idle CPU。优先同 SMT 兄弟 → 同 LLC(L3)域 → 最终才选当前 CPU |
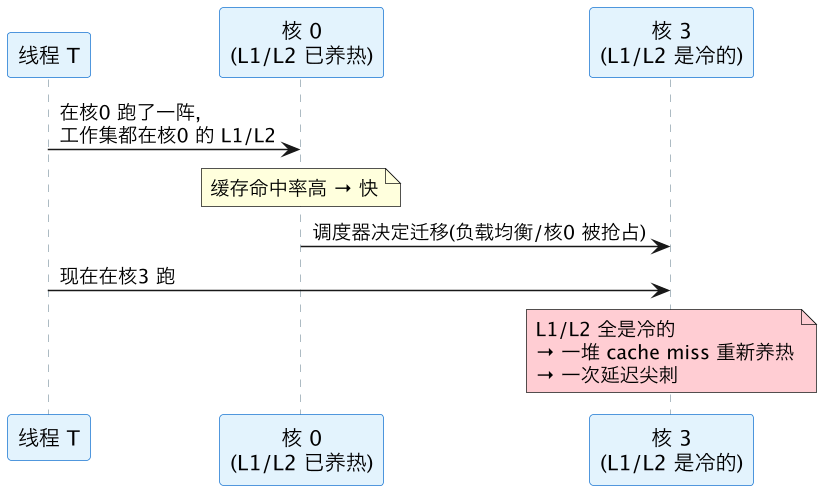
为什么在这种设计下迁移仍然高频发生——考虑一个典型场景:
场景:16 核服务器上跑 12 个计算密集型线程
1. 线程 A 在核 0 上跑了约 4ms
2. 调度 tick 到期 → 核 0 的内核定时器中断 → A 被抢占,入就绪队列
3. 核 0 接着跑内核代码(中断处理)+ 另一个线程
4. A 在就绪队列等了几百微秒后再次被唤醒
5. 此时核 0 还在忙 → select_idle_sibling() 在同一个 MC 域内找到核 4 是 idle
6. A 被放到核 4 运行 —— 一次迁移!
7. A 在核 0 养了 4ms 的 L1/L2 数据全部作废
关键矛盾:调度器做决策时认为"让 A 立即在核 4 上跑" > "让 A 在核 0 排队等"。
调度器优先保证"即时响应",而不是"缓存局部性"——因为调度器不知道 A 的缓存有多热。
每次单个决策都合理,但累积起来,线程可能在数秒内在不同物理核间跳跃数次——造成可观测的尾延迟抖动。
1.4 迁移的性能代价——量化分析
线程被迁到另一个核时的真实性能损耗:
| 资源 | 正常命中延迟(近似) | 迁移后首次访问 | 代价倍数 |
|---|---|---|---|
| L1 data cache | ~4-5 cycles | → L3(~40 cycles)或 → 内存(~100ns ≈ 300+ cycles) | 10x~50x |
| L2 cache | ~12-14 cycles | → L3 或内存 | 3x~30x |
| L1 instruction cache | ~4-5 cycles | → 下一级缓存或内存 | ~10x |
| L1 d-TLB | ~1 cycle | → page walk(5-20+ cycles) | 5x~20x |
| 分支预测器状态 | ~0 cycles | 状态全部丢失 → 间接跳转预测率暴跌 | 每次错误 ~15-20 cycles |
| 跨 NUMA 迁移 | — | 远节点内存延迟 ~1.5-2x,且不会随运行恢复 | 持续性退化 |
累计效应:一个线程迁移到新核后,前 1~10ms 的执行效率可能下降 30%~70%(取决于工作集大小和对缓存的敏感度),直到关键数据被重新加载到本地 L1/L2。这在延迟分布上表现为 p99/p999 出现明显尖刺——"平均延迟没问题,但 tail latency 炸了"。
亲和性的核心价值:把线程钉在固定核上,保住它的 L1/L2 缓存热度、TLB 条目、分支预测器状态,锁死 NUMA 本地内存访问,消除迁移带来的延迟不确定性和尖刺。代价是放弃调度器的自动负载均衡——这是"低延迟可控性"换"高吞吐灵活性"的权衡。理解调度器的设计动机,才能理解为什么这种"手动违反调度器意愿"的行为在特定场景中是正确且必要的。
二、亲和性的内核实现——比"位图"更深的机制
2.1 表象:一个位图掩码
每个线程有一个CPU 亲和性掩码(affinity mask)——一个 cpumask_t 类型的位图,标记它被允许在哪些 CPU 上运行。调度器在任何放置决策中,只会在掩码内的核中选择。
- 默认掩码 = 所有 online CPU(线程哪都能去)。
- 绑到单核 = 掩码只留一个 bit(线程只能在那个核跑)。
- 绑到一组核 = 掩码留若干 bit(线程可以在这几个核间被调度器自由放置,但绝不超出这个集合)。
CPU 编号使用逻辑 CPU 号(即 /proc/cpuinfo 的 processor 字段)。注意超线程:一个物理核的两个超线程是两个逻辑 CPU(例如核 0 = CPU 0 和 CPU 8),绑核前须确认物理核↔逻辑 CPU 的映射关系(lscpu -e 输出 CORE 列)。
2.2 内核中的存储——两级掩码结构
在 task_struct 中,亲和性由两个字段共同表达:
// include/linux/sched.h(简化)
struct task_struct {
    ...
    cpumask_t               cpus_mask;    // 用户态 set 的"预期"掩码
    const struct cpumask    *cpus_ptr;    // 调度器实际参考的"有效"掩码
    ...
};cpus_mask:用户通过sched_setaffinity()/pthread_setaffinity_np()设置的"理想"掩码。存储在线程的 task_struct 中,不因外部环境变动。cpus_ptr:调度器在每个决策点实际参考的掩码指针。它通常指向cpus_mask,但在某些场景会指向不同的掩码:- cgroup cpuset 施加了额外限制 →
cpus_ptr指向 cpuset 控制器算出的有效掩码(effective_cpus)。 - CPU 热插拔导致某 CPU offline → 调度器把该 CPU 从
cpus_ptr中移除(但cpus_mask保留原值,等 CPU 重新 online 后可恢复)。 - 极少见的
__migrate_task()过程中的临时修改。
- cgroup cpuset 施加了额外限制 →
两级设计的意义——与 cgroup cpuset 的交互:
例:用户把线程绑到 CPU 0-3,同时该线程所在的 cgroup cpuset 只分配了 CPU 0-1
  逻辑 CPU 编号:     0    1    2    3    4    5    6    7
  cpus_mask          1    1    1    1    0    0    0    0    ← 用户设的"我想要 0-3"
  cgroup cpuset      1    1    0    0    0    0    0    0    ← cgroup 限制"只能用 0-1"
  ───────────────────────────────────────────────
  cpus_ptr (有效)     1    1    0    0    0    0    0    0    ← 取交集:实际只能在 0、1
  结果:
  - 调度器看到 cpus_ptr → 线程被限制在 0、1
  - 用户态读取 cpus_mask → 仍然是 0-3(用户"意图"未丢失)
  - 如果 cgroup cpuset 以后放开限制,cpus_ptr 会回到 cpus_mask 的完整范围(0-3)
关键认知:
cpus_ptr是硬约束,不是优化建议。它不是"调度器优先考虑这些核",而是"调度器不能把这些核之外的核作为目标",违反该约束会导致调度器拒绝操作或在迁移路径上触发 BUG。
2.3 调度器如何在各决策路径上强制亲和性
| 调度路径 | 检查点(函数/宏) | 行为 |
|---|---|---|
| 负载均衡—推任务 | can_migrate_task() | cpumask_test_cpu(target_cpu, p->cpus_ptr) → 目标 CPU 不在允许集合内则拒绝迁移 |
| 负载均衡—拉任务 | detach_tasks() 内的 can_migrate_task() | 同上,从最繁忙 CPU 的队列中拉取任务前遍历确认 |
| 唤醒放置 | select_task_rq_fair() → 候选 CPU 列表 | 所有候选必须在 p->cpus_ptr 中;若集合为空或全忙,退回到 select_fallback_rq() |
| fork 放置 | wake_up_new_task() → select_task_rq_fair() | 新创建的子线程在父线程的 cpus_ptr 集合内找 idle CPU |
| 修改亲和性 | set_cpus_allowed_ptr() | 如果新掩码排除了线程当前所在 CPU → 立即触发迁移,调用 push_task_to_cpu() 把线程移到掩码内的某个 CPU |
| CPU hot-unplug | sched_cpu_deactivate() | 如果某 CPU 要下线而某线程的 cpus_ptr 只剩下这个 CPU → 强制把线程踢到 cpus_ptr 内的其他 CPU / fallback |
关键认知:绑到 CPU 2-5 意味着线程可以在 [2,3,4,5] 这四个核上被调度器自由放置——只是不会跑到 2-5 之外的核。亲和性本身不阻止集合内的迁移。如果想做到"线程只在一组核内跑,且调度器不在这组核内做负载均衡移动",需要配合系统级隔离(见 §五)。
2.4 亲和性 vs CPU 隔离——两个容易混淆的层次
| 亲和性(CPU affinity) | CPU 隔离(isolation) | |
|---|---|---|
| 控制什么 | 线程能用哪些核 | 谁不能用这些核 |
| 作用范围 | 单线程(task_struct 粒度) | 系统级(isolcpus= 启动参数)或 cgroup 级(cpuset) |
| 对系统中其他任务的影响 | 零——别人照样能用这些核 | 把普通任务/中断从这些核上赶走 |
| 生效方式 | 调度器在放置决策时跳过不允许的核 | 被隔离的核不参与默认负载均衡,调度 tick 可关闭 |
| 典型命令 | taskset -c / sched_setaffinity | isolcpus=2-5(启动参数)+ nohz_full=2-5 |
亲和性是拉的方向(让我的线程只能用这些核),隔离是推的方向(让其他东西别用这些核)。极致低延迟场景需要两个方向同时发力:用隔离把核清空,再用亲和性把关键线程独占放进去。
三、怎么绑:三个层次的工具
3.1 taskset —— 命令行,不改代码(最快上手)
# 启动时就绑:把新进程绑到 CPU 2(-c 指定十进制 CPU 号列表,比位掩码参数直观)
taskset -c 2 ./myapp
# 绑到一组核 CPU 2,3,4,5
taskset -c 2-5 ./myapp
# 改已运行进程的亲和性(-p 指定 PID)
taskset -c 2 -p <PID>
# 查看某进程当前亲和性
taskset -c -p <PID>- 优点:零代码改动、对整个进程(及其所有线程)生效。
- 局限:粒度是进程——绑的是"这个进程的所有线程都只能在这些核跑",无法给不同线程绑不同核(要那样得在进程内部用 §3.3 的 API)。
3.2 sched_setaffinity(2) —— 进程/线程级系统调用
taskset 底层调的就是它。C 代码中直接调用,能精确到单个线程(传 TID):
#define _GNU_SOURCE
#include <sched.h>
cpu_set_t set;
CPU_ZERO(&set);
CPU_SET(2, &set);          // 只允许 CPU 2
CPU_SET(3, &set);          // 也允许 CPU 3
// pid=0 表示当前线程;传具体 TID (gettid()) 可绑别的线程
sched_setaffinity(0, sizeof(set), &set);
// 查询当前亲和性
cpu_set_t got;
sched_getaffinity(0, sizeof(got), &got);
3.3 pthread_setaffinity_np —— 给具体线程绑(多线程程序标配)
多线程程序里给每个工作线程绑不同的核,用 pthread 接口最自然(np = non-portable,Linux 特有):
#define _GNU_SOURCE
#include <pthread.h>
cpu_set_t set;
CPU_ZERO(&set);
CPU_SET(cpu_id, &set);
// 绑当前线程:pthread_self();也可以传已创建的线程句柄
pthread_setaffinity_np(pthread_self(), sizeof(set), &set);典型用法——线程池里第 i 个工作线程独占第 i 个核:
void* worker(void* arg) {
    int cpu = (int)(intptr_t)arg;
    cpu_set_t set; CPU_ZERO(&set); CPU_SET(cpu, &set);
    pthread_setaffinity_np(pthread_self(), sizeof(set), &set);
    /* ... 这个线程从此只在 cpu 上跑 ... */
    return NULL;
}
// 创建时:pthread_create(&t[i], NULL, worker, (void*)(intptr_t)i);
四、绑核 vs 绑 NUMA 节点:别混
这是最容易搞混的一组概念——亲和性(绑 CPU)和 NUMA 绑定(绑内存)是两个正交的维度:
| CPU 亲和性(本篇) | NUMA 绑定(numactl) | |
|---|---|---|
| 绑的是 | 线程能在哪些 CPU 核上跑 | 内存从哪个 NUMA 节点分配 |
| 工具 | taskset / sched_setaffinity / pthread_setaffinity_np | numactl --cpunodebind / --membind / set_mempolicy |
| 解决问题 | 缓存热度、避免迁移抖动、消除 tail latency | 避免跨节点远程内存访问 |
| 粒度 | 精确到单个逻辑 CPU | 以 NUMA 节点为单位(一个节点含多个核) |
两者常配合使用:低延迟服务的标准配方是既绑核又绑内存到同一个 NUMA 节点——numactl --cpunodebind=0 --membind=0 一次搞定"线程只在节点 0 的核上跑 + 内存只从节点 0 分配",彻底本地化、零远程访问(详见 numa)。如果只绑核不绑内存,线程钉住了但内存可能在远节点——NUMA 远程访问带来的 50%~100% 额外延迟会吃掉所有绑核收益;如果只绑内存不绑核,线程可能被调度器迁到别节点的核,又变回远程访问。
一句话:绑核管"线程在哪算"、绑 NUMA 管"数据在哪存",低延迟要两个一起绑到同一节点。
numactl --cpunodebind本质上是设了"绑定某个 NUMA 节点对应的那组 CPU 核"(节点级亲和性),更细的"钉到某一个具体核"才用 taskset / pthread 接口。
五、系统级隔离:把核"让"给关键线程
绑核只是让你的线程能用某个核,但别人也能用——内核的其他任务、中断处理、甚至其他用户的进程还是会跑上来抢占。要真正独占,得从系统层把核隔离出来:
| 手段 | 作用 |
|---|---|
isolcpus=2-5(内核启动参数) | 把 CPU 2-5 从调度器的默认负载均衡里摘出去——普通任务不会被自动放上去,只有显式通过亲和性绑上来的线程才跑在这些核上。给关键线程留干净的核 |
nohz_full=2-5 | 让这些核在只有一个可运行任务时关掉调度时钟中断(tickless),减少周期性中断对关键线程的打扰——极致低延迟场景的关键配置 |
中断亲和性 /proc/irq/<n>/smp_affinity | 把网卡、磁盘等设备中断从关键核挪走,别让 IRQ handler 和 softirq 抢占关键线程的 CPU 时间(呼应 mpstat 中观测到的 %irq / %soft) |
| cgroup cpuset | 容器/cgroup 级别把一组核划给某组进程独占(Kubernetes CPU Manager static 策略的底层实现就是这个) |
完整的低延迟配方:
isolcpus隔出干净核 →nohz_full关掉调度 tick → 中断亲和性把 IRQ 挪走 → 应用用 pthread 亲和性把关键线程钉上去。层层把核清空,再把线程独占放进去。
六、常见坑:绑错了反而更慢
亲和性是一把双刃剑,帮倒忙比不绑更糟糕:
- 绑到超线程的同一物理核:CPU 0 和 CPU 8 若是同一物理核的两个超线程,把两个繁忙线程分别绑到它们 = 两个线程抢同一套 L1/L2 和执行单元,性能可能不如让它们跑在两个不同物理核上。绑之前用
lscpu -e或cat /proc/cpuinfo确认core id和逻辑 CPU 的映射关系。 - 绑核数 < 线程数:把 8 个繁忙线程绑到 4 个核,它们挤在一起互相抢占、频繁上下文切换,比不绑还慢。
- 绑了核却没绑 NUMA 内存:线程钉在节点 1 的核,内存却在节点 0——每次访存都远程,越绑越慢(见 §四)。
- 和调度器对着干:绑死后放弃了负载均衡——如果被绑的核上还残留重任务(没做
isolcpus隔离),你的线程反而饿死在那几个核上。 - 伪共享没解决:绑核让线程稳定在各自核上,但如果它们高频修改的变量落在同一条 cache line,绑核反而让跨核的 MESI 协议 ping-pong 更稳定地持续发生——伪共享要靠 cache line 对齐/填充来解决,不是绑核(见 mesi、memory-alignment)。
- 多线程进程只绑了主线程:用
taskset ./myapp只绑了初始线程,如果进程后续pthread_create出子线程——子线程继承父线程的亲和性掩码,所以多线程情况下它们是同命运的。但如果期望的是"主线程绑核 0、工作线程绑核 1-N",必须在每个线程内分别调用pthread_setaffinity_np,taskset做不到这一点。
准则:亲和性是低延迟/稳定性的优化,不是吞吐的银弹。绑之前先确认:物理核映射对不对、核够不够线程用、NUMA 内存有没有跟着绑、系统级隔离做没做。测量驱动——绑完对比
perf stat -e migrations,cache-misses和 p99 延迟,别凭感觉。
七、怎么观测
lscpu -e                          # 逻辑 CPU ↔ 物理核 ↔ NUMA 节点的映射(绑核前必看)
taskset -c -p <PID>               # 查进程当前亲和性
cat /proc/<PID>/status | grep Cpus_allowed_list   # 同上,看允许的 CPU 列表
# 看线程实际在哪个核跑(PSR 列 = 当前 CPU)
ps -o pid,tid,psr,comm -T -p <PID>
top -H                            # -H 展开线程,f 键加 P(Last used cpu)列看线程在哪个核
# 迁移次数 & 亲和性效果:perf 看上下文切换和 cache-miss
perf stat -e cs,migrations,cache-misses ./app
# 更详细的——看具体从哪迁移到哪
perf sched record ./app && perf sched latency判据:migrations(CPU 迁移次数)高 + 尾延迟抖动 → 亲和性可能有帮助;绑完再测一次,看 migrations 是否归零、p99 是否变稳、cache-misses 是否下降。
八、和本仓库其他文档的关系
| 相关主题 | 文档 | 关系 |
|---|---|---|
| 调度器内部算法 | scheduling | 调度器"怎么选人"(CFS/EEVDF、运行队列、抢占);本文讲"怎么限制选择范围" |
| 线程从哪来 | thread-creation | 每线程独立调度实体,亲和性就是给这个实体设 CPU 约束 |
| NUMA 为何重要 | numa | NUMA 远程访问代价量化;绑核必须和绑内存配合的理论依据 |
| NUMA 节点绑定操作 | numactl | --cpunodebind / --membind 的具体用法 |
| 缓存私有性 | cache-organization | L1/L2 为什么是 per-core 私有的——绑核保住它们的理论依据 |
| TLB 也怕冷 | tlb | 迁移后 TLB flush / page walk 的代价——绑核的第二个动机 |
| 别用绑核治伪共享 | mesi、memory-alignment | MESI 缓存一致性协议、伪共享的诊断和修复 |
| 中断抢核 | mpstat | %irq / %soft 指标——系统级隔离的要排除的东西 |
| 观测工具 | top(top -H)、perf(migrations/cache-misses) | 亲和性效果的观测手段 |
| 系统调用接口 | syscall | sched_setaffinity 是一个系统调用 |
九、一句话总结
线程亲和性 = 在 task_struct 中设一个
cpus_mask位图,通过cpus_ptr强制性约束调度器只能在指定 CPU 核集合内放置该线程。内核 CFS/EEVDF 调度器为公平性和 CPU 利用率会在 sched_domain 层级间做自底向上的负载均衡,导致线程在核间频繁迁移——每次迁移丢掉养热的 L1/L2 缓存、TLB 条目和分支预测器状态,表现在延迟分布上就是 p99/p999 尖刺。绑核(taskset / sched_setaffinity / pthread_setaffinity_np)配合 NUMA 内存绑定(numactl --membind)锁死数据本地性,再用 isolcpus / nohz_full / 中断亲和性层层隔离把核清空,是低延迟系统消除尾部抖动的标准配方。但绑核是低延迟优化而非吞吐银弹——绑错超线程、核不够、忘绑 NUMA、拿它治伪共享都会适得其反,必须测量驱动。