C/C++内存模型与原子操作
承 mesi(缓存一致性:多核副本怎么同步)与 atomic(原子操作 = 缓存锁:抢成 Modified 独占再读改写)。缓存一致性回答"最终一致",内存模型回答"什么顺序对另一个线程可见"——两者之间隔着编译器重排和 CPU 重排两道坎。
本篇是导读:三特性 + 三线速览 + 六序速查表。深入内容见两个拆分篇:原子操作与内存序(概述与 std::atomic 六序详解)、内存屏障与架构差异(屏障指令 + x86/ARM 对比 + 性能量化)。
一句话认知
多线程程序里,你以为的顺序执行,实际被两处"看不见的手"重排:编译器(按单线程视角优化)和 CPU(乱序 + store buffer/invalidate queue)。C++11 内存模型就是用"可见性 + 有序性 + 原子性"三特性把这团乱麻规范化:普通变量三样全不保证;std::atomic 保证原子性,并按所选内存序给出有序性/可见性承诺。
为什么普通代码会"看起来错乱":两个重排的具体样子
拿最经典的"生产-消费"看普通变量版本的翻车现场:
int data = 0;
bool ready = false;
// 线程 A
data = 42;
ready = true;
// 线程 B
while (!ready) { }
print(data); // 一定是 42 吗?不一定。三个问题可能单独或叠加出现:
- 可见性:编译器可能把
ready=true优化成寄存器操作,或 CPU 让data=42只写进了 L1 没刷到内存——线程 B 看到的ready是旧值false,一直空转;就算看到true,data也可能因 store buffer 未让位而读到旧值0。 - 有序性:编译器觉得
data和ready没有依赖,把两个 store 交换顺序(单线程结果不变);CPU 乱序执行也可能先提交ready再提交data——线程 B 看到ready==true时data=42还没"到位"。 - 原子性:如果
data是 8 字节的double且跨了 cache line(未对齐),读可能撕裂成两半,半个新值半个旧值。
C++11 内存模型要解决的就是这三件事:可见性(最终能不能看到)、有序性(按什么顺序看到)、原子性(会不会撕裂)。普通变量三者全不保证;std::atomic 保证原子性,并按所选内存序提供有序性/可见性承诺。
一个容易忽略的点:前两种重排都发生在"单线程视角下无害"的前提下——编译器按单线程语义优化,CPU 按单核一致性执行,它们各自都对,合在一起就错。所以多线程同步不能靠"我觉得编译器不会那么笨",必须显式用原子操作和内存序表态。
什么时候必须用原子操作
| 场景 | 是否必须原子 | 理由 |
|---|---|---|
| 跨线程传数据(标志位+载荷) | 必须 | 需要可见性+有序性,普通变量不保证 |
| 跨线程共享计数器 | 必须 | 读-改-写要原子,a++ 会撕裂 |
| 每线程私有计数器(最后合并) | 不必 | 无跨线程共享,普通变量即可 |
| 单线程内热点计数 | 不必 | 无并发,原子纯属浪费 |
| 只读共享配置 | 不必 | 只读无写竞争,但发布时的同步不能省 |
这张表是"原子开销"的决策入口:有共享写、无同步 → 必须原子;无共享写 → 普通变量即可。原子操作到底贵多少,见性能量化篇。
三线速览
① 原子操作与六种内存序 —— memory-model-orders:
- 两个重排来源(编译器 / CPU)+ 三特性(可见性、有序性、原子性)
std::atomic基础用法 + 操作一览(store/load/exchange/CAS/fetch_*)- 六种内存序三大类:seq_cst(默认,全局单序)· acquire/release(配对构成 happens-before,同步媒介是原子变量、传递的是"它之前的所有写")· relaxed(只保证原子性,纯计数用)
- 陷阱:relaxed 当标志位 → 可能读到旧值
② 内存屏障与架构差异 —— memory-model-fences-arch:
- 三类屏障指令:
lfence(压读)·sfence(压写)·mfence(全屏障) std::atomic_thread_fence显式屏障:载荷用普通变量 + 屏障钉在计数器两侧(生产-消费者)- x86 强序(只允许 Store-Load 重排,几乎免屏障)vs ARM 弱序(全类型可重排,必须
ldar/stlr/dmb ish) - 量化:
seq_cst比relaxed慢约 30%,ARM 原子操作整体比 x86 贵 1.6~1.9 倍
③ 最佳实践速览(来自原文第六节):
- 默认
seq_cst,确认语义后再降级; - 生产-消费者用 acquire/release 配对付最省;
- 仅在无依赖的计数场景用
relaxed; - 无锁数据结构用
compare_exchange_strong; - 跨平台记得 x86 验证过 ≠ ARM 正确。
六种内存序速查
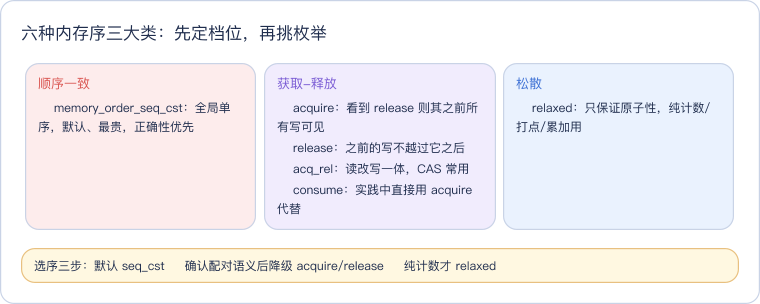
| 枚举 | 类别 | 强度 | 一句话 |
|---|---|---|---|
memory_order_seq_cst | 顺序一致 | ★★★ | 默认;全局存在一个所有线程一致的执行顺序,最贵 |
memory_order_acq_rel | 获取-释放 | ★★ | 读改写一体的 acquire+release(CAS 常用) |
memory_order_acquire | 获取-释放 | ★★ | 之后的读不重排到它之前;看到 store 则"之前所有写"可见 |
memory_order_release | 获取-释放 | ★★ | 之前的写不重排到它之后;与 acquire 配对成 happens-before |
memory_order_consume | 获取-释放 | ★~ | 依赖序,实践中建议用 acquire 代替 |
memory_order_relaxed | 松散 | ★ | 只保证原子性,无可见性/有序性,最省 |
表格自下而上就是一条强度轴:选序先定"需要哪一档"(全局单序 / 配对同步 / 只保原子),再在同档内挑具体枚举。三档的典型使用场景在原子操作与内存序篇逐一展开。
六种内存序怎么选(决策树)
六序的速查表在上,落地时通常只需三步:
- 默认
seq_cst:正确性优先,先跑起来; - 确认语义后用 acquire/release:生产-消费、发布-订阅、无锁队列头尾——凡是"一个线程发、一个线程收"的配对场景,acquire/release 与 seq_cst 语义等价但更便宜;
- 纯计数才
relaxed:统计、打点、per-thread 累加——不传递数据、不要求顺序。
consume 实践里建议直接用 acquire 代替(编译器普遍把 consume 降级为 acquire,语义复杂收益小);acq_rel 用于读-改-写操作(CAS/exchange),是 acquire 与 release 的合并。更细的逐序讲解见 原子操作与内存序篇。
三篇速览
| 文档 | 内容 |
|---|---|
| memory-model(本篇导读) | 三特性 + 三线速览 + 六序速查 + 关系导航 |
| memory-model-orders | 重排来源 + 三特性详解 + std::atomic 用法 + 六序三大类逐类讲(含生产-消费与陷阱示例) |
| memory-model-fences-arch | 三屏障指令 + atomic_thread_fence + x86/ARM 差异表 + 性能量化(实测数据)+ 跨平台提醒 |
关系导航
- 下层机制:reordering-overview(重排全景)· store-buffer / invalidate-queue(CPU 层重排来源)· mesi-protocol(原子操作的硬件基础:缓存锁)
- 同类概念:atomic(原子操作实现细节:lock 前缀/总线锁 vs 缓存锁/CAS)· memory-alignment(对齐影响单次访存原子性——未对齐可能跨 cache line)
- 语言对照:Go 内存模型(happens-before 同名概念,runtime 保证更强)
- 工程落地:cpp-mutex-types(mutex 之下就是 acquire/release)· lockfree-deep / rcu-internals(无锁依赖内存序正确性)
参考资料
- C++ 标准文档:N4868
- 《C++ Concurrency in Action》Anthony Williams
- Intel® 64 and IA-32 Architectures Software Developer Manual
- ARM Architecture Reference Manual
FAQ
Q: 内存模型和虚拟内存是一回事吗? A: 不是。内存模型(memory model)规范多线程下"一核的写何时对另一核可见";虚拟内存布局(代码段/堆/栈)见 segment-management。
Q: 为什么普通变量多线程读写会出问题? A: 三特性全不保证:可能读不到别人的写(可见性)、可能看到乱序的值(有序性)、a++ 的读-改-写可能被打断(原子性)。
Q: 默认用哪个内存序? A: seq_cst(std::atomic 默认),正确性最稳;确认语义后热路径可降级到 acquire/release(同步)或 relaxed(纯计数)。
Q: x86 上为什么很少写屏障? A: x86 是强序模型,硬件只允许 Store-Load 重排,编译器用普通 mov 就能满足 acquire/release;只有 seq_cst 的 store 需要额外 mfence。ARM 弱序则必须显式 ldar/stlr/dmb。
Q: relaxed 和原子性什么关系? A: relaxed 仍保证操作原子(不撕裂),只是不保证可见性/顺序。适合无同步需求的计数;不能用来跨线程传数据。
总结
多线程的「错乱」来自两处重排——编译器按单线程语义优化、CPU 乱序加 store buffer / invalidate queue;C++11 内存模型用可见性、有序性、原子性三特性把它规范化:普通变量三样全不保证,std::atomic 保原子并按内存序给出有序性/可见性承诺。选型三步:默认 seq_cst(全局单序、最贵),确认是一个线程发一个线程收的配对语义后降级 acquire/release(happens-before、最省),只有无依赖的纯计数才用 relaxed;acq_rel 给 CAS 等读改写,consume 直接用 acquire 代替。跨架构记住 x86 强序(仅允许 StoreLoad、几乎免屏障)验证过不代表 ARM 弱序正确。