性能工具定位对比:perf 与传统监控工具的互补关系
详尽版:逐工具深度对比、四层下钻排查法、8 场景组合速查 → 见 tool-perf-comprehensive-guide
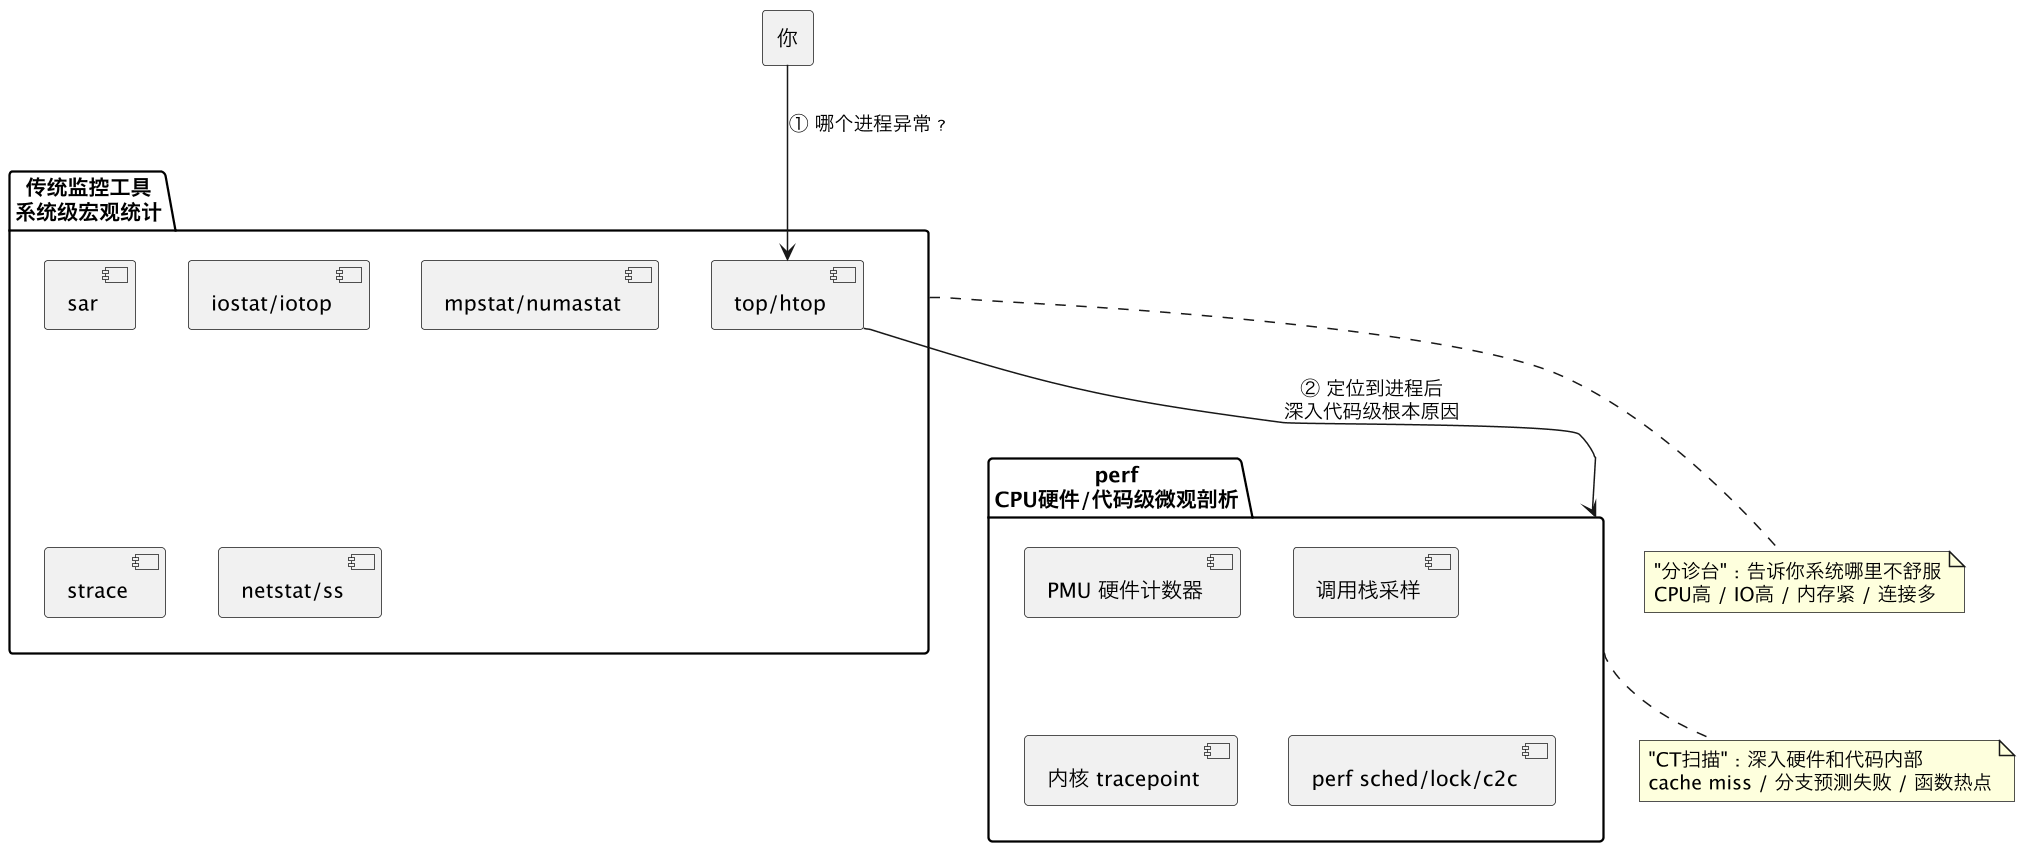
概述
Linux 性能工具分两类,定位维度完全不同,谁也不能替代谁:
| 类别 | 代表工具 | 看得见 | 看不见 |
|---|---|---|---|
| 宏观统计工具 | top, sar, iostat, mpstat, strace | 系统/进程级的聚合数值 | 哪行代码导致、CPU 内部在干什么 |
| 微观剖析工具 | perf | 函数/指令级耗时、CPU 硬件事件 | 长期历史趋势、连接状态、流量累计 |
核心认知:传统工具是分诊台,告诉你哪个科室有问题;perf 是 CT 扫描,告诉你细胞级病灶在哪。 没有分诊你不知道该扫谁,没有 CT 你只知道有名患者但不知道病因。
一、传统工具独有、perf 拿不到的指标
以下六类指标 perf 要么完全无法采集,要么采集成本过高、不适合持续监控。
1. 全局长期聚合统计(sar / vmstat)
perf 是基于采样的瞬时工具,不适合 7×24 后台常驻。sar 每 10 分钟自动归档一次,能回溯任意历史时间点的系统状态:
- 运行队列长度、阻塞任务数、进程创建速率
- swap 进出总量、脏页数量、页面回收速率
- 块设备整体吞吐量、IO 等待队列长度
- 网卡收发总量、丢包率
排查"昨天凌晨 3 点 CPU 飙高"只能翻 sar 历史日志,perf 无法回溯。
2. 块设备 IO 全局负载(iostat / iotop)
iotop 能按进程累计读写字节数;iostat 能看每个磁盘的 await、%util、队列深度。perf trace 能抓单次 read/write 调用,但:
- 无法按进程统计累计读写字节
- 无法直观判断磁盘是否已打满
3. NUMA/中断全局分布(mpstat / numastat)
mpstat -I 看每个 CPU 的硬中断/软中断分布;numastat 看每个 NUMA 节点的内存命中/未命中。 perf 能采样单次跨 NUMA 访问的开销,但无法给出"node 1 上 30% 内存访问是远程的"这类全局快照。
4. 系统调用完整路径与错误码(strace)
strace 是全事件记录:每次系统调用的参数、返回值、errno(EAGAIN/EINTR/ENOMEM)。perf trace 默认采样会丢事件,全事件模式开销远超 strace,且错误码展示不如 strace 直观。排查"为什么反复重试"这种逻辑问题,strace 不可替代。
5. 网络连接状态(ss / netstat)
perf 能采样内核协议栈函数调用,但看不到:
- TIME-WAIT/CLOSE-WAIT 连接堆积了多少
- listen 队列是否溢出
- 端口与进程的绑定关系
这些是连接层面的指标,与 CPU 性能无关,perf 完全采集不到。
二、perf 独有、传统工具全无的能力
这些是性能调优必须依赖 perf 的根本原因——top/sar/strace 全部盲区。
1. CPU 硬件性能计数器(PMU)
传统工具只知道"CPU 使用率高",不知道 CPU 内部在干什么。perf 能读出硬件计数器:
| 指标 | 含义 | 为什么重要 |
|---|---|---|
| L1/L2/L3 cache-misses | 各级缓存未命中次数 | CPU 100% 但 IPC 极低的根因 |
| branch-misses | 分支预测失败次数 | 预测失败浪费大量流水线周期 |
| stalled-cycles-frontend/backend | 前端/后端停顿周期 | 定位是取指瓶颈还是数据瓶颈 |
| IPC | 每周期执行指令数 | perf stat -e instructions,cycles,低 IPC = CPU 在空转等内存 |
2. 函数/指令级热点
top 只知道进程 CPU 高。进程内部哪个函数烧 CPU、哪条循环最耗时——只有 perf record + perf report(火焰图)能做到。
3. 内核内部开销(不通过系统调用体现)
很多耗时不在系统调用里:
- 中断处理、软中断(网络/IO)
- 缺页异常内核处理路径
- VFS 路径查找、调度器内部开销
strace 只记录系统调用边界,内核内部耗时它统计不到——perf 通过 tracepoint 可以。
4. 无系统调用的纯计算热点
密集循环、矩阵运算等纯用户态计算不触发任何系统调用。strace 完全空跑,top 只能告诉你 CPU 高,只有 perf 能采样定位具体函数。
5. 调度与锁竞争分析
perf sched latency:每个线程等待 CPU 的时间perf lock:哪个锁竞争最激烈、等待时间最长perf c2c:哪两个 CPU 在抢同一行 cache line(伪共享)
三、标准排查组合(工作流程)
组合 1:CPU 使用率高
top -H  → 定位高 CPU 进程/线程
  └─ perf record -p <PID> -g -- sleep 30
  └─ perf report / 火焰图  → 定位热点函数
top 负责筛选进程(perf 做不到快速扫全系统),perf 负责定位代码行。
组合 2:IO 等待高
iostat -x 1  → 确认磁盘是否真的忙
iotop -o     → 找出读写最多的进程
  └─ perf trace -p <PID>  → 看具体读写哪些文件
  └─ strace -p <PID> -e trace=read,write  → 看错误码和耗时
组合 3:系统响应慢但 CPU/IO 指标正常
唯一答案是硬件事件分析——此场景传统工具全部空白:
perf stat -e cycles,instructions,cache-misses,branch-misses -p <PID>
  → IPC 很低 + cache-misses 很高 → 数据布局问题
  → IPC 很低 + branch-misses 很高 → 分支密集代码
  → IPC 正常但吞吐低 → 可能是锁/调度问题,用 perf sched/lock
组合 4:系统调用频繁导致性能损耗
strace -c -p <PID>  → 统计每个系统调用的频次和耗时
  └─ perf record -e syscalls:sys_enter_* -p <PID>  → 看内核内部处理分布
strace 告诉你哪个 syscall 调得最多,perf 告诉你这个 syscall 在内核里哪个环节最慢。
组合 5:NUMA 远端访问导致延迟高
numastat  → 发现 node 间远程访问比例高
  └─ perf stat -e node-loads,node-load-misses -p <PID>  → 精确到指令的 NUMA 事件
  └─ numactl --membind=<node> --cpunodebind=<node> <cmd>  → 绑定修复
四、极简对照表
| 工具 | 独有长板 | 完全盲区 | 组合建议 |
|---|---|---|---|
| top/htop | 进程总览、快速筛选 | 函数级热点、硬件事件 | 找到进程后交给 perf |
| sar | 7×24 历史归档 | 代码级耗时 | 回溯历史峰值后 perf 定位 |
| iostat/iotop | IO 全局负载、进程 IO 流量 | 哪行代码在读写 | 确认 IO 压力后 perf trace/strace |
| strace | 系统调用频次/错误码 | 用户态纯计算、内核内部 | 找频繁调用后 perf 锁定内核路径 |
| mpstat/numastat | 中断分布、NUMA 全局统计 | 精确定位代码位置 | 发现异常后 perf stat/lock |
| perf | 硬件事件、调用栈、内核追踪 | 长期统计、连接状态、流量累计 | 先用传统工具缩小目标,再用 perf 深入 |
五、一句话总结
传统监控工具回答"系统哪里出问题了",perf 回答"这行代码为什么慢"。 前者做范围收敛(哪个进程 / 哪种资源),后者做根因定位(哪条指令 / 哪个硬件事件)。没有前者,perf 像大海捞针;没有后者,你永远只能猜测病因。