现代 CPU 内部架构与总线互联 —— 从核内到片外,数据怎么走
仓库里已经有两类文档:CPU 微架构(cpu-microarch-overview — 单核怎么跑得快,流水线/超标量/乱序/分支预测)和 外设总线(pcie — PCIe 怎么把设备挂上)。本篇填补的是二者之间的空白:现代 CPU 芯片内部长什么样、各部件之间用什么总线连起来、CPU 又怎么通过 IMC/PCIe/UPI 跟内存、外设、其他 CPU 通信。
前置概念
在展开之前,先把本篇反复出现的术语定清楚:
| 术语 | 定义 | 典型例子 |
|---|---|---|
| Socket | 物理 CPU 插槽——主板上的那个座 | 双路服务器 = 2 个 Socket |
| Die | 一片裸晶——封装内的单块硅片 | AMD EPYC 一个 Socket 可含多个 Die |
| Tile | Intel 的术语——等同于 Chiplet,用 EMIB/Foveros 拼装 | Meteor Lake:Compute/GPU/SoC/IO 四片 Tile |
| Chiplet | 拆成多颗小芯片、用高速互联拼在一起 | AMD Zen 4 CCD(计算)+ IOD(I/O) |
| Core Complex (CCX) | AMD 的术语——一组共享 L3 的核心 | Zen 3 CCX = 8 核心 + 32MB L3 |
| Core | 一个完整的处理器核 | Golden Cove(Intel)/ Zen 4(AMD) |
| Uncore / SA | 不属于任何核心但所有核心共享的片上部件 | L3、IMC、PCIe Root Complex |
| IMC | Integrated Memory Controller,集成内存控制器 | DDR5 PHY 控制器 |
| Root Complex | CPU 侧的 PCIe 根节点——PCIe 树的根 | 所有 PCIe 设备的祖先 |
| PHY | 物理层接口——把数字信号变成电信号 | DDR PHY、PCIe PHY |
| UPI | Ultra Path Interconnect,Intel 多路 CPU 间的高速互联 | 双路/四路 Xeon 的 socket 到 socket 链路 |
| Infinity Fabric | AMD 的统一互联架构——既在片内连 CCD/IOD,也在片间连多路 CPU | 片内 IFOP,片间 GMI |
| CXL | Compute Express Link——跑在 PCIe PHY 上的缓存一致性互联 | CXL 内存扩展、CXL 加速器 |
| UCIe | Universal Chiplet Interconnect Express——片间互联的行业标准 | 不同厂商 Chiplet 拼装 |
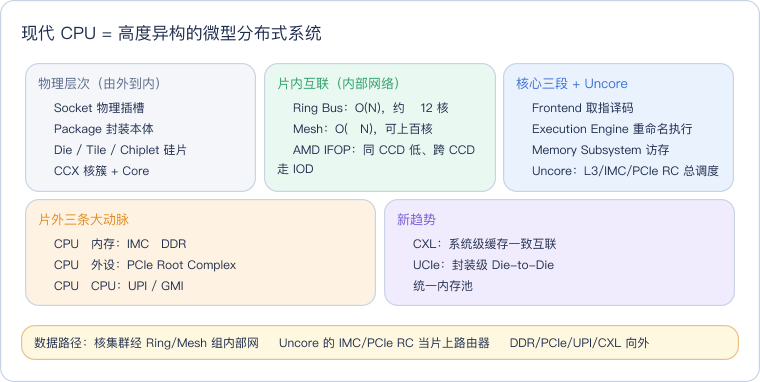
一句话预热:现代 CPU 不是"一片铁壳里有个核+缓存",而是高度异构的微型分布式系统——核集群通过 Ring/Mesh 互联,共享的 Uncore 里塞着 IMC 和 PCIe 根节点,通过 DDR/QPI/PCIe 三条大动脉连到内存、其他 CPU 和外设。
一、CPU 物理层次:从 Socket 到 Chiplet
现代 CPU 从主板到核心可以分成四个层次:
| 层次 | 是什么 | 关键问题 |
|---|---|---|
| Socket | 主板上的物理插槽 | 功耗、引脚预算、最大内存/PCIe 通道数 |
| Package | 封装后的 CPU 本体 | 能装多少 Die/Tile |
| Die / Tile / Chiplet | 封装内的单块硅片或切片 | 工艺选择、良率、跨片延迟 |
| Core Complex / CCD | 一组核心 + 共享 L3 | 核间共享范围、跨 CCD 延迟 |
| Core | 一个完整处理器核 | 单核性能来源 |
三条主流路线:
| 路线 | 代表 | 核心取舍 |
|---|---|---|
| Intel 单片/Tile | Raptor Lake → Meteor Lake | 低延迟 → 异构集成、可扩展 |
| AMD Chiplet | EPYC Genoa | 高良率、灵活扩展,但跨 CCD 内存延迟略高 |
| Apple 统一 SoC | M3/M4 | CPU/GPU/NPU 同片共享内存,零拷贝但不可扩展 |
详细拆解(层次定义、Chiplet 优势、三条路线深度对比)见独立文档:cpu-physical-hierarchy。
二、片内互联:核心之间怎么通信
所有核心共享 LLC 和 Uncore 资源,必须有一个内部网络让核心之间、核心与 L3、核心与 IMC 互相通信。三种主流拓扑:
| 拓扑 | 延迟增长 | 规模上限 | 代表 |
|---|---|---|---|
| Ring Bus | O(N) 正比核数 | ~12 核 | Intel 消费级 (Raptor Lake) |
| Mesh | O(√N) 正比根号核数 | 上百核 | Intel Xeon SP (Sapphire Rapids) |
| AMD IFOP | 同 CCD 低,跨 CCD 走 IOD | 12 CCD → 96 核 | AMD EPYC Genoa |
详细分析(延迟计算、带宽模型、观测工具)见独立专文:on-die-interconnect。下文 §四 Uncore 和 §五~§七 的各通路(DDR/PCIe/UPI)都建立在片内互联之上。
三、核心内部结构 + Uncore:计算区与总调度中心
一个现代核心内部宏观上分为三段:
| 段 | 作用 | 关键瓶颈 |
|---|---|---|
| Frontend | 分支预测 → 取指 → 译码 → μOP Cache | 分支预测命中率、μOP Cache 容量 |
| Execution Engine | 重命名 → 调度 → 执行端口 → ROB | 端口争用、ROB 容量、依赖链长度 |
| Memory Subsystem | L1/L2/Store Buffer/TLB → L3 | 缓存命中率、TLB 缺失、访存带宽 |
SMT 超线程:复制前端(寄存器/RIP),共享执行引擎和缓存。一个线程 stall 时另一个线程顶上,适合多线程、高缓存 miss 场景;对单线程满载场景几乎无帮助。
Uncore / System Agent:片上不属于任何核心、但所有核心共享的部件——包括 L3/LLC、IMC、PCIe Root Complex、CXL 控制器、IOMMU、PCU 等。它是 CPU 芯片与外部世界(DDR、PCIe、其他 CPU)的总调度中心。
详细机制(三段式深度拆解、SMT 共享/非共享表、Uncore 在不同架构中的位置)见独立文档:core-and-uncore。
四、片外总线:CPU 到内存、外设、其他 CPU
现代 CPU 芯片外有三条大动脉:
| 通路 | 关键部件 | 决定什么 |
|---|---|---|
| CPU → 内存 | IMC → DDR 通道 → Rank → Bank | 内存带宽、延迟、Bank 并行度 |
| CPU → 外设 | PCIe Root Complex → 直连 PCIe / DMI → Chipset | 外设延迟、带宽、是否共享 DMI |
| CPU → CPU | Intel UPI / AMD GMI (IFIS) | 多路系统扩展性、NUMA 远程访问惩罚 |
典型延迟/带宽量级:
| 路径 | 延迟量级(典型) |
|---|---|
| L1 命中 | ~4-5 cycles |
| L2 命中 | ~12-14 cycles |
| L3 命中(本地) | ~40-50 cycles |
| 本地 DDR | ~70-100ns (~250-400 cycles @4GHz) |
| 远程 DDR(跨 Socket) | ~140-200ns |
| 直连 PCIe 访问 | 几百 ns ~ 1μs |
| 跨 Socket UPI/GMI | ~50-90ns 额外延迟 |
片外总线详细拆解(IMC 演进、DDR 通道/Rank/Bank 层级、直连 vs Chipset PCIe、DMA 路径、UPI/GMI 对比、跨 Socket 缓存一致性)见独立文档:off-chip-buses。
八、现代总线架构新趋势
| 方向 | 关键点 | 深入 |
|---|---|---|
| CXL | PCIe PHY 上跑缓存一致性协议(CXL.io/cache/mem);三类设备;Type 3 内存扩展 OS 可见为 NUMA 节点 | cxl |
| UCIe | 封装级 Die-to-Die 标准化互联(与 CXL 互补——CXL 系统级、UCIe 封装级) | cxl §六 |
| 统一内存 | Apple M/MI300A/Grace Hopper — CPU+GPU 共享同一个缓存一致性内存池 | cxl §六 |
趋势本质:从"CPU 内存 + GPU 显存 + 之间搬运"走向"一个统一的、缓存一致的、共享的物理内存池"。CXL 是系统级实现,UCIe 是封装级实现。详细论述参见 cxl(含三大子协议拆解、版本演进、编程模型变化、numactl 实操)。
九、性能观测与诊断
理解系统架构不能只靠文档,必须用工具看真实机器的拓扑。常用工具及其作用:
| 工具 | 看什么 | 典型用法 |
|---|---|---|
lstopo | CPU/缓存/NUMA/PCIe 拓扑图 | lstopo --no-io |
lscpu | 核编号 → Socket/Core/NUMA 对应表 | lscpu --extended |
/sys/devices/system/cpu/.../cache/ | 各级缓存大小与共享范围 | cat .../index2/shared_cpu_list |
lspci | PCIe 树、链路速率/宽度 | lspci -vvv | grep -E "LnkSta|LnkCap" |
| numactl / numastat | NUMA 距离、进程内存分布 | numactl --hardware |
dmidecode | 内存类型/频率/插槽位置 | dmidecode -t memory |
perf / turbostat | 跨 NUMA 访问、IMC 吞吐、Uncore 频率 | perf stat -e node-loads,node-load-misses |
完整工具手册、诊断路径速查表、实战排查案例见独立文档:system-diagnosis-tools。
十、一句话总结
现代 CPU 不是一个简单的"核+缓存"单块芯片,而是一个高度异构的微型分布式系统:核集群通过 Ring/Mesh/IF 组成内部网络,Uncore 里的 IMC 和 PCIe Root Complex 充当"片上路由器",DDR/PCIe/UPI/CXL 是四条向外的大动脉——理解它们之间的拓扑和数据流,才能真正理解性能的数字从哪里来。
关联:cpu-physical-hierarchy(物理层次)、core-and-uncore(核心三段式 + Uncore)、on-die-interconnect(片内 Ring/Mesh/IFOP)、off-chip-buses(片外总线 DDR/PCIe/UPI)、cxl(CXL/UCIe/统一内存)、system-diagnosis-tools(观测工具)、cpu-microarch-overview(单核微架构)、pcie(PCIe 协议)、dma(DMA 数据流)、numa(NUMA 拓扑)