容器会带来性能损耗吗 —— 损耗从哪来、有多大、怎么优化
这是 overview(容器导读)的"性能"分支,承接 container-vs-vm §六留下的问题:既然容器"几乎无虚拟化层",那它到底有没有开销?本篇把答案拆开:容器本身(CPU/内存)近乎零开销,真正的损耗都在周边——网络、存储、cgroup 限流、观测。 底座机制(namespace/cgroup)见 namespaces-cgroups。
零、核心结论先行
容器进程就是宿主上的普通进程:它直接跑在宿主内核、直接用真实 CPU,没有 hypervisor、没有指令翻译、没有 guest 内核那一层——这和虚拟机(VM)是根本区别(见 container-vs-vm)。所以纯计算/纯内存负载,容器 ≈ 裸机。
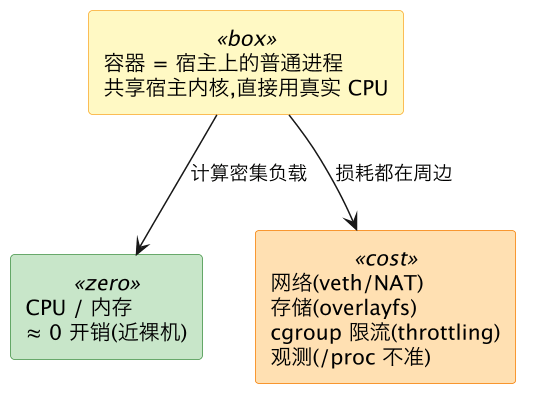
一句话:容器没有"虚拟化开销"(那是 VM 的事),它的性能损耗全来自周边设施——网络路径、存储层、资源限流和观测偏差。
一、CPU / 内存:接近零开销
容器进程和宿主普通进程走的是同一个内核、同一套调度器、同一块物理内存,没有任何中间翻译层。两处极小的开销:
- namespace 查询多一层视图映射:比如读 PID、看网卡,内核要按进程所属 namespace 做一次视图转换——几乎免费,纳秒级,与业务计算完全不在一个量级。
- cgroup 计量:每次 CPU 调度、内存分配,内核顺手在 cgroup 统计里累加计数——这是极小的常数开销,不影响吞吐。
对比 VM:VM 的 guest 内核要靠 VT-x/AMD-V 在特权指令处陷入宿主(VM-Exit,见 container-vs-vm §三),还要预留 guest 内核的内存;容器完全没有这些。
一句话:CPU、内存密集型负载在容器里跑,性能基本等于裸机——namespace 映射和 cgroup 计量的开销小到可忽略。
二、网络:主要开销(重点)
网络是容器最容易吃性能的地方。默认的 bridge 网络(Docker 默认、K8s 常见 CNI)让容器流量绕一大圈:容器的 eth0 是一对 veth pair 的一端,另一端插在宿主的网桥(如 docker0)上,出宿主还要过 iptables NAT 做地址转换,而 NAT/状态防火墙依赖 conntrack 连接跟踪表(见 kernel-tuning-net §六)。每一跳都有开销,高并发下尤其明显。
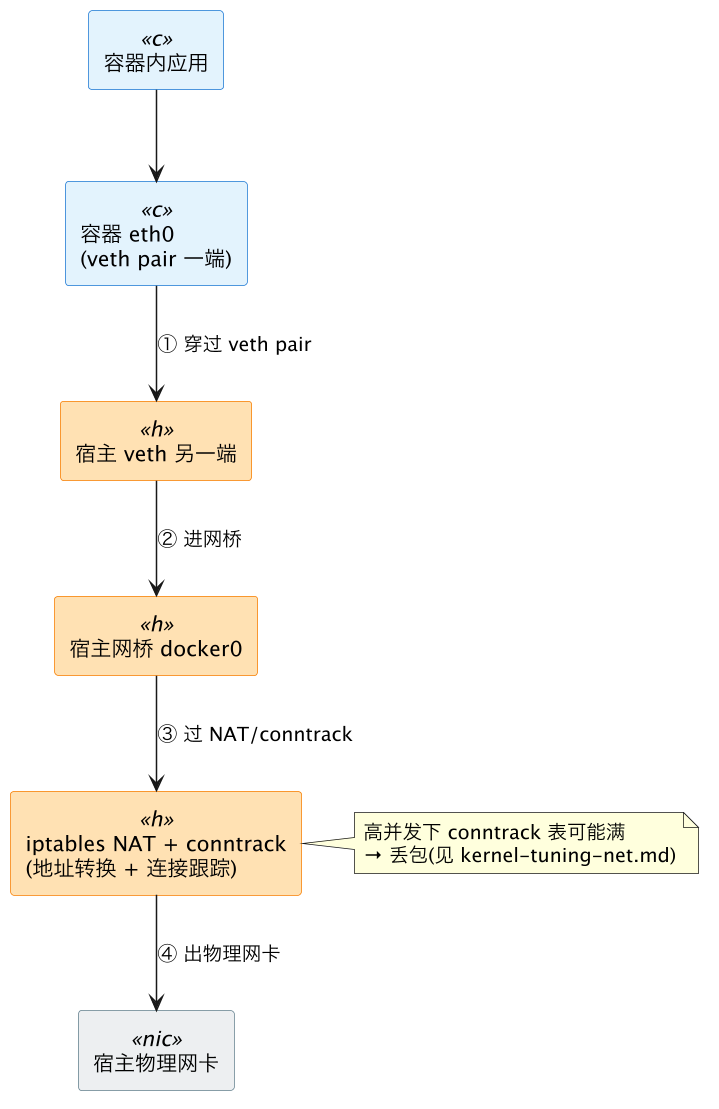
优化路径(隔离性递减、性能递增):
| 方案 | 做法 | 代价 |
|---|---|---|
| host 网络 | --network host,容器直接用宿主网络栈,零 veth/NAT 开销 | 无网络隔离,端口和宿主共用 |
| macvlan / ipvlan | 给容器分配独立 MAC/IP 直接挂物理网卡,绕开网桥和 NAT | 组网复杂,依赖底层网络配合 |
| eBPF(Cilium) | 用 eBPF 在内核里直接转发/做策略,绕开 iptables/conntrack 那套慢路径 | 需要较新内核、运维门槛高 |
一句话:容器网络的开销来自"veth → 网桥 → NAT/conntrack"这条默认长路径,高并发下最痛;要性能可选 host 网络(零开销无隔离)、macvlan/ipvlan(绕网桥)或 eBPF/Cilium(绕 iptables)。
三、存储:overlayfs 写放大
容器镜像是分层只读的,容器运行时在最上面叠一个可写层,用 overlayfs 合并成一个视图。它的性能坑主要两个:
- copy-up(写时复制):首次修改一个只读层里的文件,overlayfs 必须先把整个文件从只读层拷到可写层再改。大文件即使只改一个字节,也要整文件拷贝——随机写、频繁改大文件的负载会明显变慢。
- 层多查找慢:读一个文件要从上到下逐层找,镜像层数越多、查找越慢。
优化:用数据卷(volume)。把频繁读写的数据目录用 volume 或 bind mount 直接挂到宿主文件系统,数据读写走宿主的原生 fs,完全绕开 overlayfs——数据库、日志、大文件这类 IO 密集负载都应该走 volume,而不是留在容器可写层。
一句话:overlayfs 的 copy-up 会让"改只读层大文件"产生整文件拷贝的写放大,层多还拖慢查找;IO 密集数据放数据卷(bind mount 宿主目录)绕开 overlayfs 即可。
四、cgroup 限流:最经典的性能坑(重点)
这是容器场景里最反直觉、最容易踩的性能问题——它不是"实现开销",而是"设计行为":你给容器设了资源上限,内核就会严格执行,哪怕宿主此刻很空闲。
CPU:CFS 配额用完就被 throttle(限流)
K8s 的 CPU limit 底层是设 cgroup 的 cpu.max(v2)/ cpu.cfs_quota_us+cpu.cfs_period_us(v1),含义是"每个周期(默认 100ms)最多用多少 CPU 时间"。例如 cpu.max = 50000 100000 表示每 100ms 最多用 50ms CPU(即 0.5 核)。
关键机制:一旦容器在当前周期内把配额用完,即使宿主还有大把空闲 CPU,内核也会把这些线程强制暂停(throttling),直到下一个周期才放行。对于突发型、多线程的负载,这会直接表现为延迟尖刺——请求正跑到一半线程被冻结,要等到下个 100ms 才继续。这正是 K8s 里设了 CPU limit 导致 p99 抖动的经典问题。
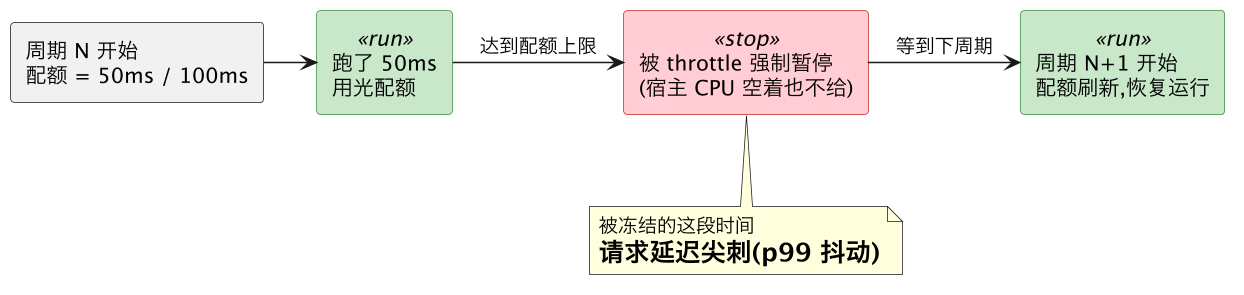
观测:读 cgroup 的 cpu.stat:
cat /sys/fs/cgroup/<path>/cpu.stat
#   nr_periods     经历了多少个周期
#   nr_throttled   其中有多少个周期发生了限流   ← 这个非 0 且持续增长就是被限流了
# throttled_usec 累计被限流(冻结)了多长时间 ← 直接对应延迟损失nr_throttled/throttled_time 持续增长,就说明 CPU limit 设小了或负载有突发——要么调大配额,要么(对延迟敏感服务)只设 request 不设 limit。
内存:超 limit 直接 OOM
内存 cgroup 的 memory.max(v2)/ memory.limit_in_bytes(v1)是硬上限,容器内存用量一旦超过它,内核的 OOM Killer 会直接杀掉容器里的进程(K8s 里表现为容器 OOMKilled 重启)。这不是"变慢",而是"被杀"。
一句话:cgroup 限流是设计行为不是 bug——CPU 配额用完会被 throttle 强制暂停到下周期(哪怕宿主空闲),造成 p99 延迟尖刺(读
cpu.stat的nr_throttled/throttled_usec观测);内存超memory.max则直接被 OOM Killer 杀;合理配额、对延迟敏感服务慎设 CPU limit 是关键。
五、观测容器性能的坑
容器内的很多"系统信息"其实是宿主的值,直接照搬会误判:
/proc/cpuinfo、/proc/meminfo显示的是宿主的核数和总内存,不是容器被 cgroup 限的额度(procfs 不感知 cgroup,见 namespaces-cgroups §四、procfs)。容器里以为自己有 64 核,实际 cgroup 只给了 1 核。- top/free 在容器里也不准,因为它们就是读那些宿主级的
/proc文件(见 top)。 - 看真实用量要读 cgroup 文件:CPU 看
cpu.stat(含限流)、内存看memory.current/memory.max;或者用 cAdvisor(K8s 生态标准容器指标采集)、lxcfs(把/proc/cpuinfo/meminfo矫正成 cgroup 视图,让容器内工具"看对")。
一句话:容器内
/proc(cpuinfo/meminfo)和 top/free 显示的是宿主值,判断容器真实用量要读 cgroup 文件(cpu.stat/memory.current)或用 cAdvisor/lxcfs。
六、安全容器的额外开销
普通容器隔离弱(共享内核),安全容器用不同方式补隔离,代价是额外性能开销(见 container-vs-vm §四):
- Kata Containers:每个容器/Pod 包一层轻量 VM,拿回硬件级隔离,代价是多一层 guest 内核的内存和启动开销。
- gVisor:在用户态实现应用内核(Sentry)拦截容器的系统调用,缩小攻击面,代价是每次 syscall 都要经用户态内核代理——syscall 密集负载明显变慢。
一句话:Kata(轻量 VM)/gVisor(用户态内核)用额外的内存或 syscall 拦截开销换来接近 VM 的隔离,比普通容器重,是"安全换性能"的取舍。
七、总表:损耗来源 → 大小 → 优化
| 损耗来源 | 大小 | 根因 | 优化 |
|---|---|---|---|
| CPU / 内存 | ≈ 0(近裸机) | 就是宿主普通进程,只多 namespace 映射 + cgroup 计量 | 无需优化 |
| 网络 | 中(高并发明显) | 默认 veth → 网桥 → NAT/conntrack 长路径 | host 网络、macvlan/ipvlan、eBPF(Cilium 绕 iptables) |
| 存储 | 中(写放大) | overlayfs copy-up 整文件拷贝、层多查找慢 | 数据卷 volume / bind mount 宿主目录绕开 overlayfs |
| cgroup 限流 | 可大(延迟尖刺) | CPU 配额用完被 throttle、内存超限被 OOM(设计行为) | 合理配额;延迟敏感服务慎设 CPU limit;cpu.stat 观测 |
| 观测偏差 | —(误判风险) | /proc 显示宿主值,top/free 不准 | 读 cgroup 文件(cpu.stat/memory.current)或 cAdvisor/lxcfs |
| 安全容器 | 大 | Kata guest 内核 / gVisor syscall 拦截 | 按隔离需求取舍,非必要不用 |
八、一句话总结
容器本身几乎没有性能损耗——它就是宿主上的普通进程,直接跑在宿主内核、直接用真实 CPU,没有 hypervisor/guest 内核那层,所以 CPU/内存密集负载 ≈ 裸机(这正是它区别于 VM 的根本)。真正的"损耗"全在周边:网络走 veth→网桥→NAT/conntrack 的长路径、高并发明显(优化用 host 网络/macvlan/eBPF-Cilium);存储的 overlayfs 有 copy-up 写放大(优化用数据卷绕开);cgroup 限流是最经典的坑——CPU 配额用完会被 throttle 强制暂停到下周期造成 p99 尖刺(读
cpu.stat的nr_throttled/throttled_usec观测)、内存超memory.max直接被 OOM;观测还有个坑——容器内 /proc 和 top/free 是宿主值,要读 cgroup 文件或用 cAdvisor/lxcfs;安全容器(Kata/gVisor)则用额外开销换隔离。一句话:容器不慢,慢的是没配好的网络、存储、限流和看错的监控。