原子操作的底层实现 —— 从汇编和 CPU 执行角度看
前面讲了缓存一致性(mesi)——原子操作正是建立在它之上的。本篇从汇编指令、CPU 执行、缓存一致性三个底层视角,讲清"一条
count++为什么不是原子的、std::atomic又是靠什么硬件机制变原子的",并对比原子 vs 非原子的执行差异。
一、问题:为什么 count++ 不是原子的
count++ 一行 C,编译成汇编是三条独立指令(读-改-写,RMW):
mov  rax, [count]   ; ① 从内存读到寄存器
add  rax, 1         ; ② 寄存器里加一
mov [count], rax ; ③ 写回内存单核单线程没问题。但多核并发时,两个核可能同时走到①,各读到同一个旧值,各自加一,各自写回——丢了一次更新:
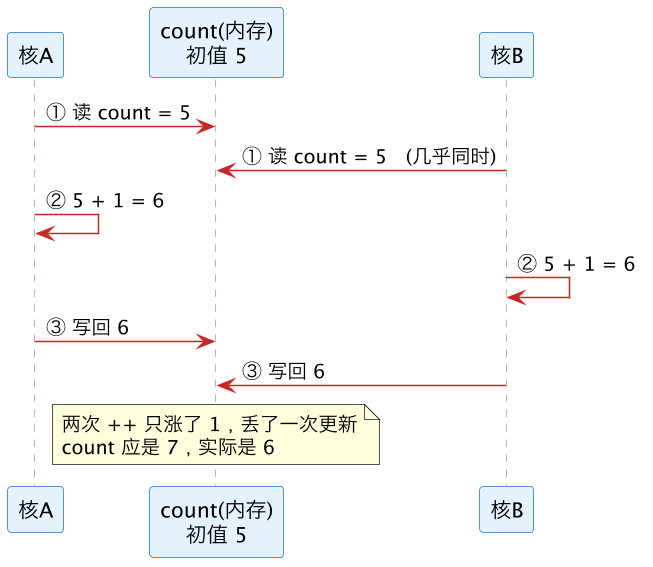
根因:读-改-写这三步中间能被别的核插入。要原子,必须让"读→改→写"不可分割——中间不允许任何核动这个地址。这正是硬件原子指令要保证的。
注意:即便是单条指令
add [count], 1(x86 允许内存操作数),在多核下也不是原子的——它内部仍是"读内存→加→写内存"的微操作序列,别的核照样能在中间插入。要原子必须显式加lock前缀(见下)。
二、硬件基石一:原子读-改-写指令
CPU 提供专门的原子 RMW 指令,硬件保证"读-改-写"作为一个不可分割的整体完成。x86 上通过 lock 前缀实现。
2.1 lock 前缀
x86 给一批内存操作指令加 lock 前缀,就变成原子:
lock add  [count], 1     ; 原子地 count += 1
lock xadd [count], rax   ; 原子地 fetch-and-add(返回旧值)
lock cmpxchg [ptr], rbx  ; 原子地 compare-and-swap(CAS)
lock xchg [ptr], rax     ; 原子交换(xchg 访存时自带 lock 语义,可省前缀)
lock 保证:这条指令执行期间,该地址被本核独占,其他核对它的读写被挡住,读-改-写一气呵成。count++ 用 lock xadd 或 lock add 后,上一节的丢更新就不可能发生。
2.2 lock 到底怎么实现的:总线锁 → 缓存锁
lock 的实现随硬件演进,从"粗暴"到"精细":
- 总线锁(老办法/回退方案):
lock时锁住整条内存总线,期间任何核对任何地址的访存都被阻塞。正确但代价极大——一个原子操作把整机访存卡住。现在只在特殊情况才用(见 2.3)。 - 缓存锁(现代主流):靠 MESI——CPU 先用 RFO(Read For Ownership)把目标 cache line 抢成 Modified 独占状态,独占期间别的核想访问这条 line 会被一致性协议挡住(它们的副本已被 invalidate)。于是"读-改-写"在本核缓存里安全完成,只锁一条 line,不牵连其他地址。这就是原子操作"建立在缓存一致性之上"的含义。
2.3 什么时候退化回总线锁(性能陷阱)
缓存锁的前提是"目标数据在一条 cache line 内"。若原子操作跨越两条 cache line(split lock,如未对齐的原子访问横跨 64B 边界),缓存锁搞不定,CPU 被迫退回总线锁——把整机访存卡住几百拍,是严重性能杀手。
- 现代内核会检测并惩罚 split lock(
split_lock_detect),甚至给触发的进程发 SIGBUS。 - 编程启示:原子变量务必自然对齐(
std::atomic<T>默认会对齐),别把原子量跨 cache line 摆放。
三、硬件基石二:CAS —— 无锁编程的核心
比"原子加"更通用的是 CAS(Compare-And-Swap),x86 上是 lock cmpxchg。语义(硬件原子地做完这一整段):
// 原子地执行:若 *ptr==expected 则写入 desired,返回是否成功
bool CAS(T* ptr, T expected, T desired) {
    if (*ptr == expected) { *ptr = desired; return true; }
    else                  { return false; }
}
几乎所有无锁数据结构和 std::atomic 的复杂操作都用 CAS + 重试循环实现。例如无锁地 count++:
T old = count.load();
while (!count.compare_exchange_weak(old, old + 1))
; // 失败说明有别的核插了队、old 已被更新为最新值,用新 old 重试- ABA 问题:CAS 只比对"值",若值从 A 变 B 又变回 A,CAS 会误判"没变过"。解决用带版本号的 CAS(
cmpxchg16b双字 CAS)或 hazard pointer。 - LL/SC(另一种流派):ARM/RISC-V 不用 CAS,而用 Load-Linked / Store-Conditional——
ldxr标记监视地址,stxr仅当期间无人写过该地址才成功。语义等价 CAS,但不受 ABA 困扰。
3.3 一次 fetch_add 在缓存里的完整旅程
把上面的机制串起来看 count.fetch_add(1) 落在一条已被其他核持有的 cache line 上会怎样(总线事务细节见 mesi-protocol):
- 本核发起 RFO(BusRdX):总线嗅探发现别核持 S 副本;
- 那些核收到"失效"、逐个回
Inv-Ack,本核等齐 ACK 才把 line 升为 M; - 然后才在本核缓存里做"读-改-写";
- 若有别的核随后读,走 Flush/转发把新值给出。
代价全在第 1~2 步的跨核往返上——这就是"原子操作贵在争用"的物理来源:line 常驻本核时这两步直接省略,几十拍搞定;高争用时反复 RFO+ACK,上百拍。
四、原子操作 ≠ 内存屏障(但常绑在一起)
原子性解决"这一个操作不可分割",但多核还有另一个问题:指令重排与可见性——编译器/CPU 会乱序执行、写缓冲区让别的核延迟看到你的写。这要靠内存屏障(memory barrier / fence) 解决:
| 概念 | 保证什么 |
|---|---|
| 原子性 | 一个读-改-写不可被打断 |
| 内存序/屏障 | 多个操作之间的顺序和可见性(别的核何时、以什么顺序看到) |
- x86 的
lock前缀指令自带全屏障(顺带保证顺序),所以 x86 上原子操作往往"免费"带了强内存序。 - 弱内存模型(ARM)需显式屏障指令(
dmb等)。 - C++ 里通过
std::memory_order控制:seq_cst(最强,默认)、acquire/release、relaxed(只要原子性、不要顺序保证,最快)。
std::atomic<int> count{0};
count.fetch_add(1, std::memory_order_relaxed);  // 只要计数对,不需顺序 → 编译成 lock xadd 但省屏障开销
seq_cst/acquire/release/relaxed各档到底"禁哪几种重排"、为什么只有seq_cst能压住 StoreLoad——见内存重排导读 memory-reordering 第五节。从 C++ happens-before 语义视角讲清每个 order 承诺什么、配可运行代码——见 memory-order。
五、原子 vs 非原子:执行层面的对比
| 维度 | 非原子(普通 count++) | 原子(lock xadd / std::atomic) |
|---|---|---|
| 汇编 | mov+add+mov 三条,可被打断 | lock add/lock xadd 一条,不可分割 |
| 多核正确性 | 丢更新(数据竞争,UB) | 正确 |
| 缓存行为 | 普通读写,命中 L1 就走 | 必须把 line 抢成 Modified 独占(RFO),可能触发其他核失效 |
| 内存序 | 可被编译器/CPU 乱序 | x86 lock 自带全屏障 |
| 开销 | L1 命中 ~4–5 拍 | 无争用时几十拍;有争用时这条 line 在多核间"乒乓",可达上百拍 |
| 争用下的表现 | —— | 变成伪共享式的 cache line 争抢,见 mesi-false-sharing |
关键性能认知:原子操作不是"慢一点的普通操作",它的代价高度依赖争用:

所以:能不用原子就别用(如线程本地累加最后合并);必须用时,避免多核狂抢同一个原子变量(分片计数器 sharded counter)、让原子量独占 cache line 防伪共享、不需要顺序时用
relaxed。
常见问答
- 原子操作比锁快吗? 不一定。锁本身也是用原子操作(+ 自旋)实现的;单线程下原子有固定开销,低争用时两者都还好,高争用时都会随核数恶化——分片计数器才是根治,而不是"换个更快的锁"。
relaxed什么时候安全? 只要"计数本身正确、不关心顺序"就安全:统计次数、幂等标记这类场景。跨线程传递数据指针或状态,必须 acquire/release 以上,否则别的核看到的"先写数据、后置标志"顺序可能反掉。- 为什么 x86 的
lock自带全屏障,ARM 不是? 历史包袱——x86 当年承诺强序,lock顺手把存储缓冲也串起来了;ARM 的原子指令默认不保证顺序,ldaxr/stlxr的a/l后缀才带 acquire/release(见 memory-model-fences-arch)。
六、结合本仓库观测
原子操作的争用开销和伪共享同源,都靠 perf 看:
# 原子操作密集/争用时,cache-miss 和一致性流量会飙升
perf stat -e cycles,instructions,cache-misses,mem_inst_retired.lock_loads ./app
# lock 前缀指令数(Intel 事件名因型号而异,先 perf list 查)
perf list | grep -i lock
# 定位是哪条 cache line 被多核争抢(原子量争用会以 HITM 出现)
perf c2c record ./app && perf c2c report
⚠️ 平台:
lock前缀是 x86 特有写法;ARM/RISC-V 用 LL/SC(ldxr/stxr、lr/sc)。但"原子 RMW 靠缓存一致性锁一条 line + 内存屏障管顺序"的原理跨平台一致。
相关:缓存一致性 mesi(原子操作的实现基础,机制见 mesi-protocol);伪共享与
perf c2cmesi-false-sharing;缓存寻址 cache-organization;协议家族 comparison。
总结
普通 count++ 编译成读-改-写三条指令,多核并发时中间能被插入、必然丢更新;原子操作靠 lock 前缀的原子 RMW 指令实现,现代硬件退化到缓存锁——先用 RFO 把目标行抢成 Modified 独占、在一条 cache line 内不可分割地完成修改,跨两行的 split lock 才退回代价极大的总线锁。原子性与内存屏障是两件事:前者保证一个操作不可打断,后者保证多个操作的顺序可见;而原子操作的真实代价高度取决于争用,无争用几十拍、高争用 cache line 在核间乒乓可达上百拍——能分片、能用 relaxed,就别让多核疯抢同一个变量。