DMA(直接内存访问)—— 数据搬运别让 CPU 亲自搬
你让 CPU 从磁盘读一块数据,最笨的办法是 CPU 一个字节一个字节地从磁盘控制器读到寄存器、再写到内存——这期间 CPU 什么都干不了,全耗在"搬砖"上。DMA(Direct Memory Access,直接内存访问) 就是为解决这个问题而生的:专门搞一个 DMA 引擎,CPU 只需告诉它"从哪搬到哪、搬多少",然后 CPU 就可以去干别的;DMA 引擎自己把活干完,完事后通过中断告诉 CPU。本篇讲清:没有 DMA 时 CPU 怎么搬数据(为什么慢)、DMA 的硬件模型和完整工作流、总线控制权(Bus Mastering)、SG-DMA(分散-聚集)等变体、以及为什么服务器访问 FPGA 要用 DMA——本质是让 FPGA 也能当"总线主设备"自己读写主机内存。
相关:DMA 完成后通过中断通知 CPU 见 interrupts,零拷贝中的 SG-DMA 见 zero-copy,PCIe 总线是 DMA 传输的物理通道见 pcie。
零、一句话认知:DMA = 让外设自己读写内存,CPU 只做指挥官不做搬运工
没有 DMA 时,外设和内存之间的数据传输有三种方式,都需要 CPU 亲自参与每一次数据搬运:
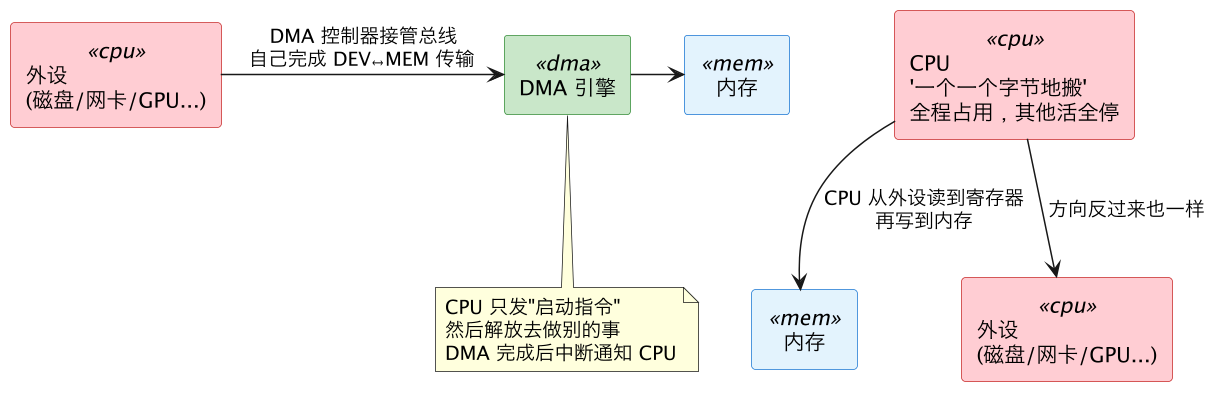
核心记忆:DMA 的本质是把 CPU 从数据搬运中解放出来。CPU 不再是搬运工,而是指挥官——"你去把那块数据从磁盘搬到内存 0x1234,搬完叫我"。
一、没有 DMA 的世界:三种 CPU 亲自搬数据的方式
在 DMA 出现之前,外设和内存之间传输数据全靠 CPU,有三种方式,一种比一种浪费 CPU:
1.1 轮询(Polling / PIO)
CPU 反复读外设的状态寄存器,等数据就绪后从外设的数据寄存器读一个字节/字,再写到内存。CPU 全程占着,不停轮询,其他什么都干不了。
while (设备没准备好) {
    等;  // CPU 空转,白白烧周期
}
data = 读设备数据寄存器;
写内存 = data;- 代价:CPU 100% 占用,哪怕数据还没到也在空转。
- 仅适合:极简单嵌入式场景、延迟要求极高的少量数据传输。
1.2 中断驱动 I/O
外设数据就绪后发中断,CPU 在中断 handler 里把数据从设备寄存器搬到内存。CPU 在等数据期间可以去干别的——比轮询好,但每次只搬少量数据(通常一个寄存器宽度),大量数据时中断次数爆炸。
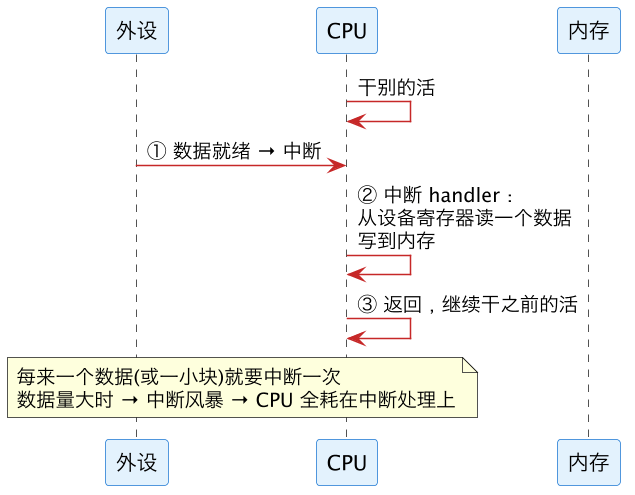
- 问题:传 1MB 数据,如果每次中断只搬 4 字节,需要 262144 次中断——CPU 光进出中断 handler 的开销就爆炸了。
1.3 对比
| 方式 | CPU 参与 | 数据量大时的表现 |
|---|---|---|
| 轮询(PIO) | CPU 亲自读、亲自写,100% 占用 | CPU 全程空转,无法做任何其他事 |
| 中断驱动 I/O | CPU 在中断 handler 里搬数据 | 中断次数太多,CPU 全耗在 handler 进出和少量搬运上 |
| DMA | CPU 只发启动命令和收完成中断 | CPU 几乎完全解放 |
二、DMA 的硬件模型:谁在搬、怎么搬
2.1 传统 DMA 控制器模型(老式 ISA 总线时代)
早期 PC 在主板上有一个独立的 DMA 控制器芯片(如 Intel 8237),它连接着 CPU、内存和外设。工作流程:
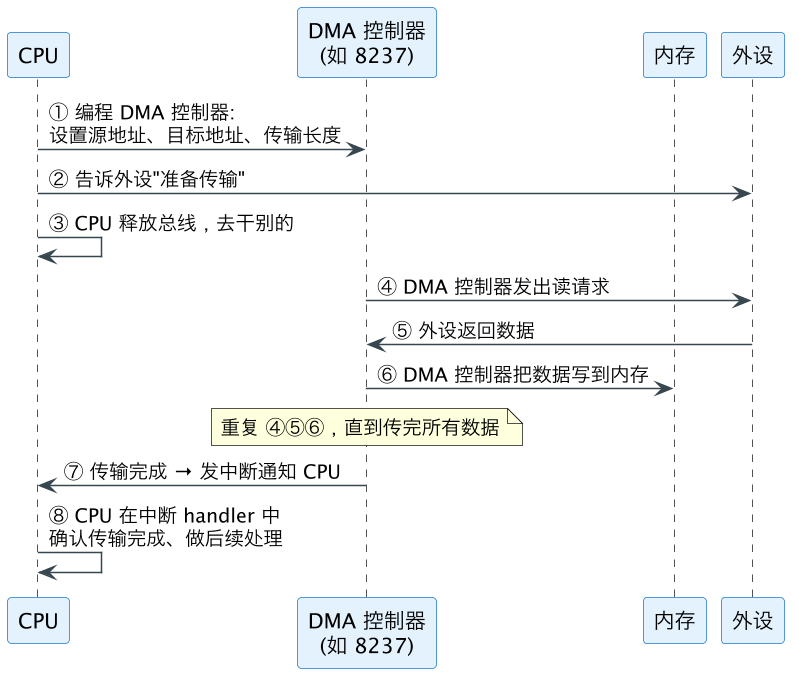
- 关键:CPU 只在第①步"编程控制器"和第⑦步"响应完成中断"时参与。中间的所有数据搬运由 DMA 控制器独立完成,CPU 全程被解放。
- 局限:老式 8237 只有 4 个通道、16 位地址线只能访问低 16MB 内存,速度慢,早已过时。
2.2 现代总线主设备(Bus Mastering)模型
现代系统(PCIe 时代)不再用独立 DMA 控制器,而是每个外设自己就是一个"总线主设备(Bus Master)"——外设自带 DMA 引擎,能主动发起对系统内存的读写:
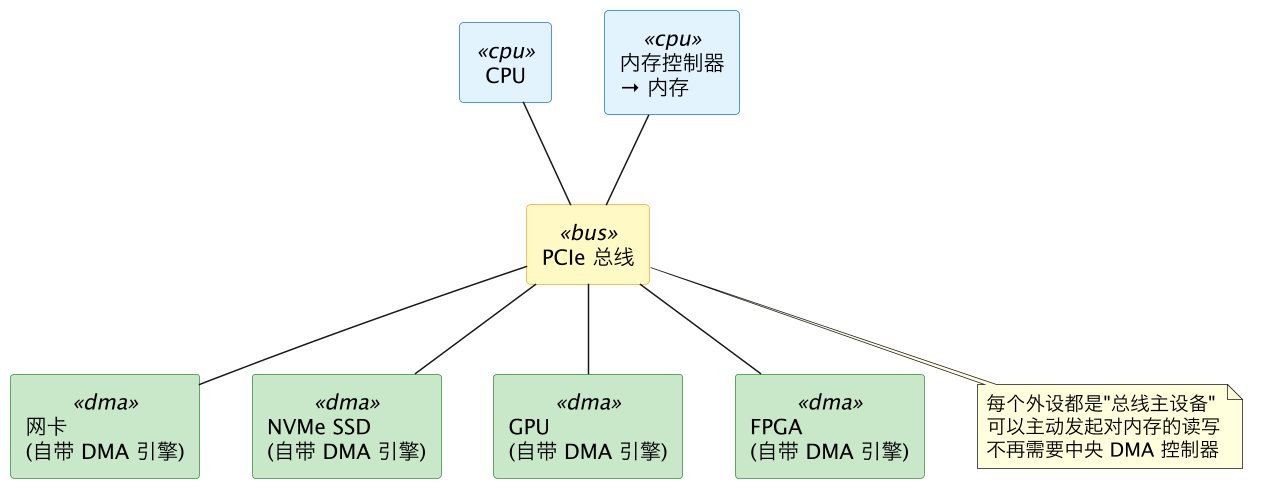
Bus Mastering DMA 的工作流程(以网卡收包为例):
- 驱动初始化:网卡驱动在内存中分配一段DMA 缓冲区(环形描述符队列),把缓冲区的物理地址告诉网卡。
- 数据到达:网卡收到网络包。
- 网卡自己发起 DMA 写:网卡(作为总线主设备)通过 PCIe 总线,直接把包数据写到步骤 1 分配好的内存缓冲区——CPU 全程不参与。
- 通知 CPU:数据写完,网卡发一个中断;CPU 在中断 handler 中处理这个包(走协议栈)。
- 驱动补充新缓冲区:CPU 把新的空缓冲区地址写入描述符队列,供网卡下次使用。
关键洞察:现代 DMA 的本质是"外设直接往内存写数据",就像外设是内存的另一个"写入者"。CPU 和网卡/磁盘/NVMe/GPU/FPGA 在总线上是对等的总线主设备——谁拿到了总线仲裁,谁就能发起传输。
三、DMA 与 CPU Cache 的一致性陷阱
DMA 把数据直接写进内存,但 CPU 可能已经把这部分内存缓存到了自己的 L1/L2/L3 cache 里——这就产生了一个经典问题:
DMA 写内存 ← → CPU cache 里有旧数据- DMA 写内存后:CPU cache 里的对应行是脏的/过时的。CPU 读这块内存时如果命中 cache,读到的就是旧数据。
- CPU 写内存后、DMA 读之前:CPU 的新数据可能还在 cache 里没写回内存,DMA 从内存读到的也是旧数据。
解决方案:
| 方法 | 原理 | 适用场景 |
|---|---|---|
| Cache Coherent Interconnect(如 ARM CCI/CCN、x86 的硬件一致性) | 硬件自动维护 DMA 和 cache 之间的一致性,DMA 写会 invalidate 对应 cache line | 现代 x86 服务器大多硬件一致,大部分场景不用管 |
| 显式 cache flush/invalidate | 软件在 DMA 前后手动调用 dma_map_single()/dma_unmap_single() 等 API,内核负责 flush/invalidate | 不保证硬件一致性的平台(某些 ARM/嵌入式) |
| DMA 一致性内存(DMA-coherent memory) | 分配内存时标记为"不使用 cache"或"硬件自动维护" | 频繁 DMA 的小块控制结构(如描述符环) |
Linux 内核的 DMA API(
include/linux/dma-mapping.h)封装了这些细节:驱动调用dma_map_*()建立映射、DMA 完成后调用dma_unmap_*()解除映射并确保 cache 一致性。驱动程序不需要关心底层是硬件一致性还是软件 flush。
四、DMA 的变体:SG-DMA 与 DDIO
4.1 SG-DMA(Scatter-Gather DMA,分散-聚集 DMA)— 与传统 DMA 的配置方式完全不同
普通 DMA(含 8237,见 dma-8237)的编程模型是寄存器直写:CPU 把源地址、目标地址、传输长度分别写入 DMA 控制器的寄存器,然后DMA 引擎开始搬连续的物理内存。但实际数据经常分散在多个不连续的物理页中——SG-DMA 的解法是把"要搬什么"和"怎么搬"描述成一份数据结构(描述符),DMA 引擎自己去读这份数据、自己执行。这不只是"多了一个链表"——它彻底改变了 CPU 和 DMA 引擎的协作方式。
4.1.1 两种模型的本质区别
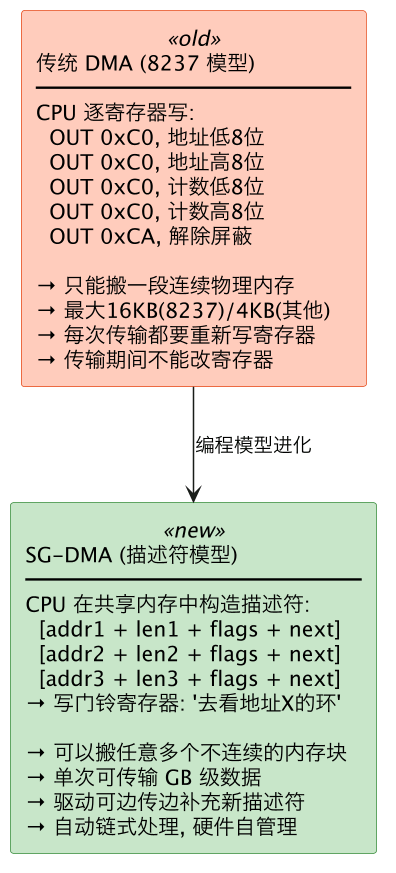
| 维度 | 传统 DMA(寄存器直写) | SG-DMA(描述符模型) |
|---|---|---|
| 配置方式 | CPU 写硬件寄存器(OUT/MMIO 写) | CPU 写共享内存中的描述符,再写门铃寄存器通知硬件 |
| 数据在哪 | 源/目标各一个连续物理地址 | 每个描述符指向一段物理地址,链表/环形串联 |
| 一次能搬多少 | 计数器上限(8237 是 64KB,其他平台类似) | 理论上无上限——描述符可以链任意多个 |
| 传输期间能改配置吗 | 不能——寄存器正在被 DMA 使用 | 可以——驱动在 Tail 指针前插入新描述符(环形模式) |
| 谁管理进度 | DMA 控制器内部计数器,软件读状态寄存器 | 硬件更新 Head 指针(已消费到哪),软件更新 Tail 指针(生产到哪) |
| 完成粒度 | 整次传输结束后一个中断 | 每个描述符完成后可发中断 + 写 completion 位 |
| 代表芯片 | Intel 8237 | NVMe 控制器、网卡 DMA 引擎、GPU DMA 引擎 |
核心区别:传统 DMA 的配置是对一组硬件寄存器的一次性写入——配置完 DMA 就开跑,跑完为止。SG-DMA 的配置是在共享内存中维护一份描述符表——驱动写描述符(生产者),DMA 引擎读描述符(消费者),通过 Head/Tail 指针实现无锁的异步协作。详见 dma-cpu-interaction。
4.1.2 描述符的硬件结构
一个 SG-DMA 描述符是内存中的一个结构体,由 DMA 引擎硬件直接解析。不同的硬件(NVMe、网卡、GPU)描述符略有不同,但核心字段不变:
┌─────────────────────────────────────────────┐
│  DMA 描述符 (典型 16~64 bytes)                │
├─────────────────────────────────────────────┤
│  Address[63:0]    源/目标物理地址              │  8 bytes
│  Length[31:0]     本段传输长度                  │  4 bytes
│  Flags[15:0]      标志位                        │  2 bytes
│    bit0:   EOP (End of Packet: 最后一个描述符)   │
│    bit1:   INTR (完成此描述符后发中断)            │
│    bit2:   RSVD (保留/硬件提供方自定义)           │
│    bit3:   WRITE (1=写设备→内存, 0=读内存→设备)  │
│    bit4-6: RSVD                                 │
│    bit7:   DONE (硬件完成标记, 写完置1)           │
│  Next[63:0]       下一个描述符的物理地址          │  8 bytes
│  (或有: 无 Next 指针——环形描述符表中靠地址推算)     │
└─────────────────────────────────────────────┘
Linux 内核中的 scatterlist(include/linux/scatterlist.h)是硬件无关的中间层:
struct scatterlist {
    unsigned long   page_link;   // 指向 struct page + 最后2bits编码链信息
    unsigned int    offset;      // 页内偏移
    unsigned int    length;      // 本段长度
    dma_addr_t      dma_address; // DMA 映射后的物理地址(驱动/IOMMU 翻译后)
    unsigned int    dma_length;  // DMA 映射后的长度
};
scatterlist通过sg_next()连接成链。驱动把scatterlist链交给dma_map_sg()映射后,硬件描述符的构造由驱动的 DMA 映射层完成——上层代码不直接操作硬件描述符。
4.1.3 初始化流程:驱动侧怎么准备一次 SG-DMA 传输
以 NVMe 读磁盘扇区为例——希望把 4KB+3KB+1KB 三个不连续的页拼成一个逻辑 IO:
Step 0: 块层分配了 3 个不连续的 page cache 页面 → scatterlist[3]
Step 1: 构造 scatterlist
  sg[0]: page=A, offset=0,    length=4096
  sg[1]: page=B, offset=2048, length=3072
  sg[2]: page=C, offset=0,    length=1024
Step 2: DMA 映射
  nents = dma_map_sg(dev, sg, 3, DMA_FROM_DEVICE);
  // 内核为每个 sg 条目分配 DMA 地址(IOMMU 翻译后的物理地址)
  // 返回值 nents = 合并后的物理连续段数(IOMMU 可能把相邻物理页合并)
Step 3: 构造硬件描述符(Tail 插入)
  从 NVMe SQ(Submission Queue) 的 PRP/SGL 描述符区域:
  描述符 0:  addr = sg_dma_address(&sg[0]),  len = 4096, EOP=0
  描述符 1:  addr = sg_dma_address(&sg[1]),  len = 3072, EOP=0
  描述符 2:  addr = sg_dma_address(&sg[2]),  len = 1024, EOP=1  ← 最后一个
Step 4: 更新 Tail 指针(写门铃)
  writel(tail + 3,  sq->doorbell);  // 告诉 NVMe 控制器"有 3 个新描述符"
Step 5: NVMe 硬件自动处理(详见 4.1.4)
Step 6: NVMe 完成后写 CQ(Completion Queue) → MSI-X 中断 → 驱动收 completion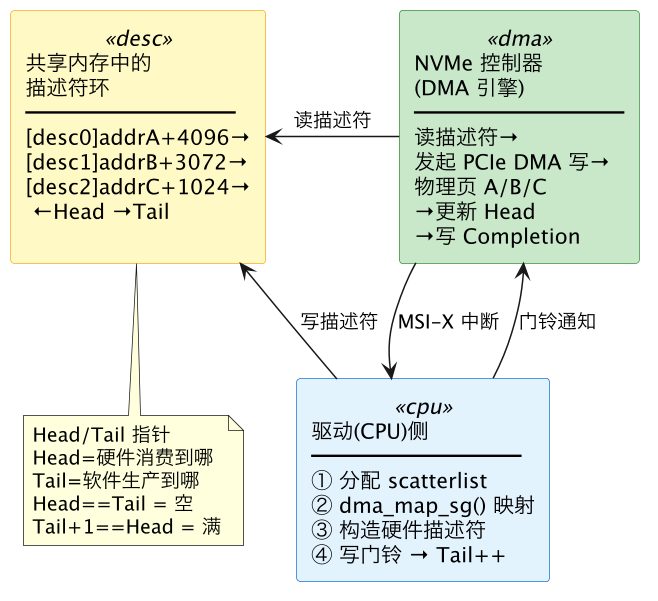
4.1.4 DMA 引擎硬件遍历流程
SG-DMA 引擎内部是一个小状态机,逐个处理描述符:
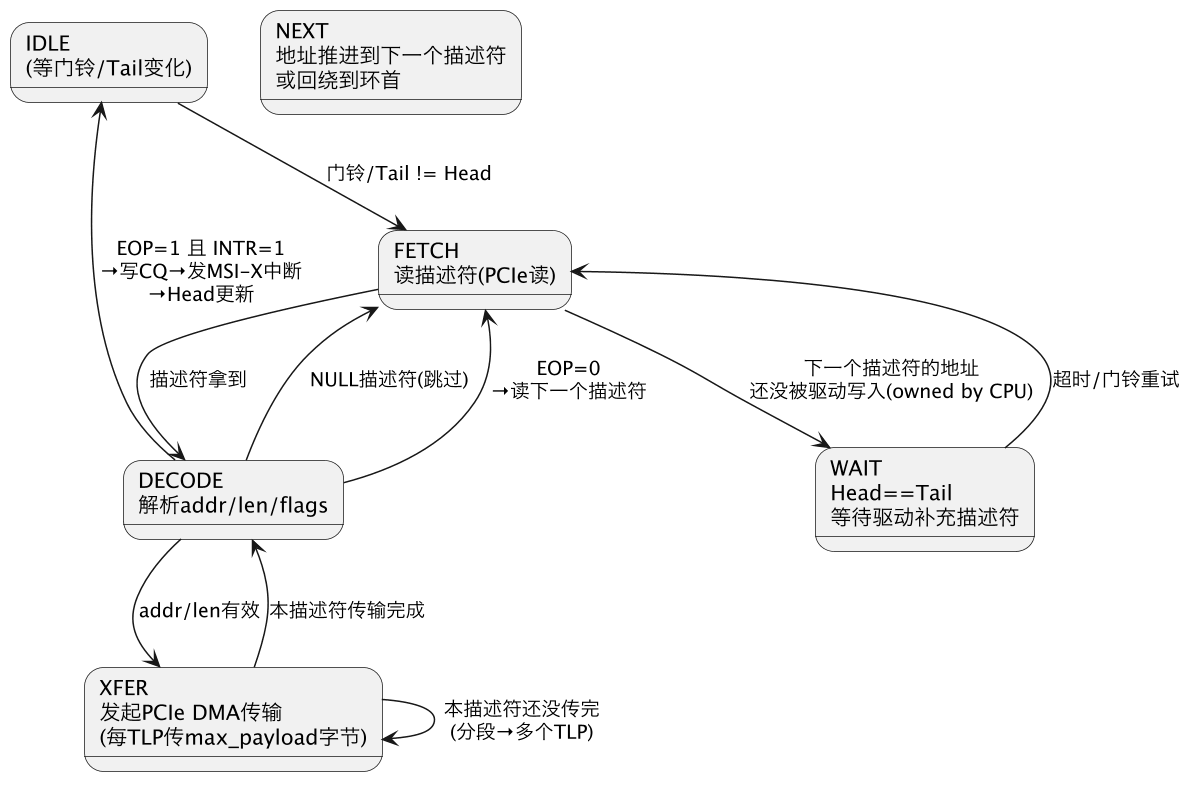
关键硬件细节:
| 细节 | 说明 |
|---|---|
| 描述符所有权 | 每个描述符的 flags 中有一个"owned by HW"位——HW 在开始处理前置 1,CPU 只有在这个位为 0 时才能回收/覆盖 |
| PCIe TLP 分段 | 描述符的 length 可能很大(如 512KB),但 PCIe Max Payload Size 通常是 128~256 字节。硬件自动把一个描述符拆成多个 TLP——一个 512KB 的描述符 ≈ 4000+ 个 PCIe 写 TLP |
| 乱序处理 | 高端 DMA 引擎可乱序处理多个描述符(不同 PCIe tag),只要完成顺序按描述符排序即可 |
| Head 更新时机 | 每个描述符处理完后硬件不立即写回 Head——通常攒够一批或传完后一次更新,减少 PCIe 写事务 |
4.1.5 环形描述符 vs 链式描述符
两种 SG-DMA 布局,各有适用场景:
【环形描述符 Ring】(NVMe、网卡多队列)
  ┌──┬──┬──┬──┬──┬──┬──┬──┐
  │D0│D1│D2│D3│D4│D5│D6│D7│  ← 固定大小(如 1024 条目)
  └──┴──┴──┴──┴──┴──┴──┴──┘
   ↑Head               ↑Tail
  驱动: 写完一轮回绕到 D0(需要确认 D0 已被 HW 消费)
  HW:   处理完 D7 后回绕到 D0
  优点: 无动态分配、cache 友好、预取简单
  缺点: 最大吞吐受环大小限制(描述符必须连续)
【链式描述符 Chain】(GPU DMA、FPGA DMA)
  [D0|next→D1] → [D1|next→D2] → [D2|next→NULL]
  驱动: 每次分配一个新描述符, 链上去
  HW:   沿 next 指针一直走到 NULL
  优点: 无上限、灵活
缺点: 每个描述符多 8 字节(next指针)、cache 不友好(每次 next 可能 cache miss)| 环形 | 链式 | |
|---|---|---|
| 内存布局 | 一段连续物理内存 | 描述符各自分配,next 指针串联 |
| 硬件实现复杂度 | 低(地址+长度推算) | 略高(需解析 next 指针) |
| 驱动复杂度 | 需管理回绕和"环满"检测 | 分配/释放管理 |
| 描述符上限 | 环大小固定 | 无上限 |
| 典型场景 | NVMe SQ/CQ、网卡 TX/RX ring | GPU 命令流、FPGA BD ring |
| Cache 友好度 | 更友好(连续访问) | 较差(next 指针可能导致 cache miss) |
4.1.6 与传统 DMA 的全面对比
| 维度 | 传统 DMA(8237 模型) | SG-DMA(现代模型) |
|---|---|---|
| 配置接口 | CPU 写 I/O 端口 → 硬件寄存器 | CPU 写共享内存 → 门铃寄存器 |
| 数据布局 | 单段连续物理内存 | 多段不连续物理页,描述符串联 |
| 单次最大传输 | 计数器上限(16bit→64KB) | 理论上无限(受描述符数量/环大小限制) |
| 传输期间参数可变吗 | 不可变(寄存器被 DMA 占用) | 可以——驱动在 Tail 前加新描述符 |
| CPU 参与度 | 每次传输都要重新编程(连续多次传输 = 多次写寄存器) | 一次初始化描述符环后, 驱动只需更新 Tail+补描述符 |
| 完成通知 | 一次传输一个中断(EOP#/TC) | 每描述符可触发中断 + completion 队列 |
| 错误处理 | 无——错了就错了 | 每描述符有 completion status,可精确定位哪个描述符出错 |
| 并发 | 单通道独占——多个外设不能同时用同一通道 | 多个队列/环可并发, 通道化到不同 CPU 核心 |
| IOMMU | 不支持(实地址) | 支持——描述符中的地址经过 IOMMU 翻译 |
| 典型代表 | Intel 8237、老式声卡 DMA | NVMe SGL、网卡 BD ring、GPU DMA engine |
4.1.7 零拷贝中的 SG-DMA 完整流程(sendfile)
这是 SG-DMA 最经典的应用——sendfile() 从磁盘发文件到网络, 数据不经过用户态缓冲区(详见 zero-copy)。SG-DMA 的角色:
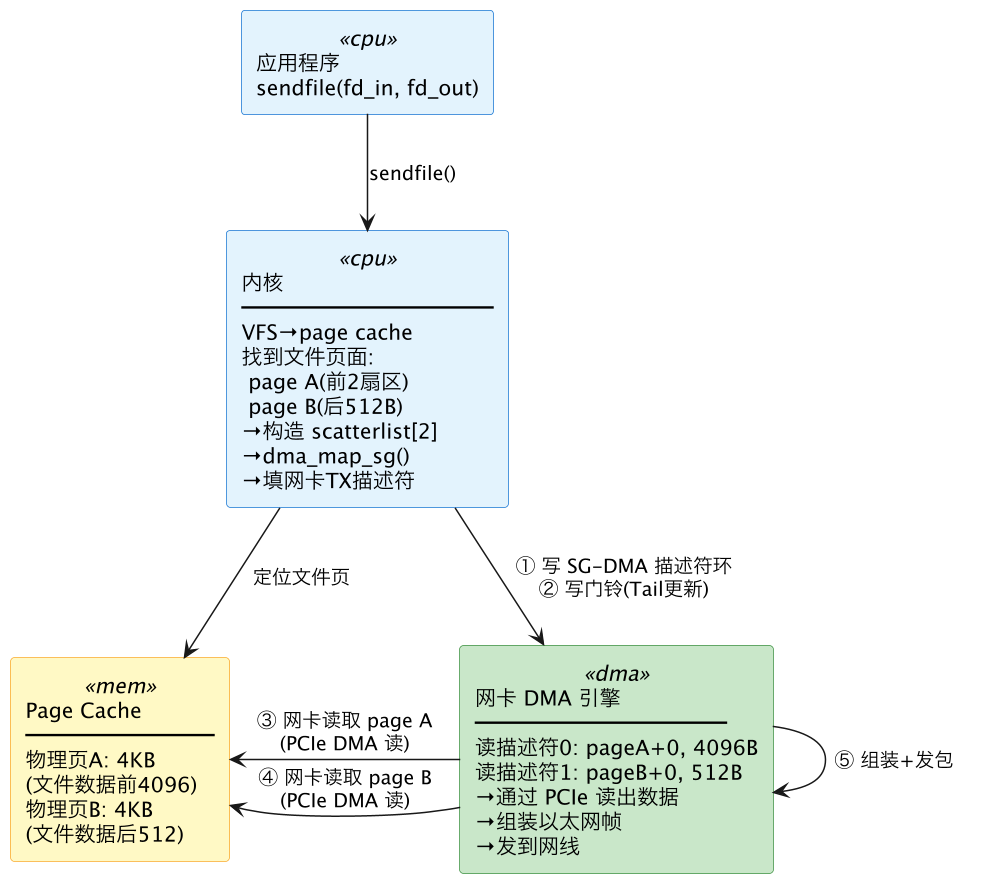
这里 SG-DMA 的价值:两个物理页在内存中不连续,普通 DMA 需要先把它们拷到一个连续缓冲区再传——这就是一次多余的 memcpy。SG-DMA 让网卡直接从分散的 page cache 页面中收集数据发送,跳过了中间拷贝。这就是"零拷贝"的硬件基础。
一句话:传统 DMA 的配置是一次性写硬件寄存器,SG-DMA 的配置是在共享内存中维护一份描述符表——驱动是生产者(写描述符 + 推进 Tail),DMA 引擎是消费者(读描述符 + 执行传输 + 推进 Head)。这不只是"能搬分散内存"的增量改进,而是把 CPU 和 DMA 引擎的协作从"同步寄存器写"彻底重构为"共享内存 + Head/Tail 指针"的无锁异步模型。
4.2 DDIO(Data Direct I/O,Intel)
Intel 高端至强处理器的特殊能力:网卡 DMA 写数据时不写内存,直接写进 CPU 的 L3 cache。这样 CPU 处理网络包时直接从 cache 读,延迟从 ~100ns(内存)降到 ~40ns(L3 cache),对高频交易、低延迟网络场景意义重大。
这是 DMA 方向的一次进化:从"写内存"到"写 cache"——让数据和 CPU 更近。
五、为什么服务器访问 FPGA 要用 DMA
一个典型问题:服务器通过 PCIe 插 FPGA 加速卡,FPGA 和主机之间怎么传数据?
如果不用 DMA:CPU 通过 MMIO(Memory-Mapped I/O) 方式,用 memcpy 之类的操作把数据写到 FPGA 映射的 PCIe BAR 空间,或者从 BAR 空间读到主机内存。问题是:
- CPU 全程参与每次读写——就像回到了"轮询/PIO 时代"。
- PCIe MMIO 写入延迟比普通内存高很多(~几百 ns),CPU 被 stall。
- 大量数据传输时,CPU 被完全占满,FPGA 加速省下的时间全被数据传输吃回去了。
用了 DMA 之后:FPGA 内部实现一个 DMA 引擎 IP 核,让它成为 PCIe 总线主设备:
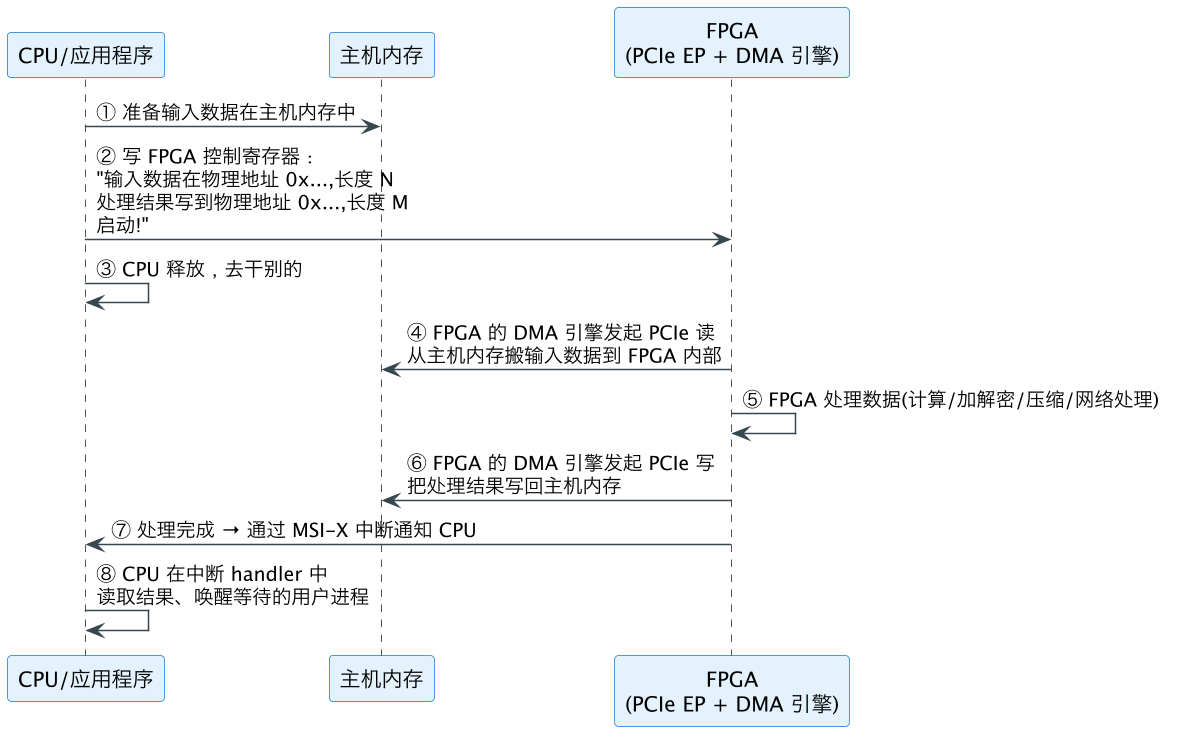
为什么必须用 DMA:
| 对比维度 | 不用 DMA(CPU PIO/MMIO) | 用 DMA(FPGA 自带 DMA 引擎) |
|---|---|---|
| CPU 占用 | 100%(CPU 全程搬数据) | ~0%(CPU 只发命令和收中断) |
| 吞吐量 | 受限于 CPU 搬数据的速度 | 可达 PCIe 线速(如 Gen4 x16 ~32GB/s) |
| 延迟 | CPU 被 stall,其他任务受影响 | CPU 同时处理其他请求 |
| 数据量 | 仅适合少量控制数据(KB 级) | 适合大数据流(GB 级) |
一句话:FPGA 加速卡插在 PCIe 上,要发挥它的算力,数据必须高速进出 FPGA——DMA 是唯一能让数据流以 PCIe 线速流动、同时不拖死 CPU 的方式。FPGA 必须实现 DMA 引擎成为总线主设备,才能自己主动读写主机内存。
六、DMA 的性能开销:不是完全免费
虽然 DMA 解放了 CPU,但它也有代价:
| 开销类型 | 说明 |
|---|---|
| 内存带宽争抢 | DMA 引擎直接读写内存,和 CPU 抢内存带宽。大量 DMA(如 NVMe 全速读写)会让 CPU 的可用内存带宽下降。 |
| Cache 污染 | 传统 DMA 写内存后,CPU 再次访问这块数据时会 cache miss(DMA 把数据写进了内存而不是 cache)。DDIO 试图解决这个问题。 |
| 中断开销 | 每次 DMA 完成触发中断,数据量小时中断频率高(类似中断驱动 I/O 的问题)。解决:中断合并(interrupt coalescing)——攒够 N 个包或等 T 微秒再发一次中断。 |
| IOMMU 开销 | 虚拟化环境中,DMA 地址需要经过 IOMMU 翻译(类似 CPU 的 MMU 页表翻译),增加延迟。 |
| DMA 映射/解映射开销 | 内核 DMA API 的 dma_map_*/dma_unmap_* 调用本身有开销(页表操作、cache flush)。 |
七、观测与排查
# 查看 DMA 相关中断
cat /proc/interrupts | grep -E "nvme|eth|DMA"
# 查看 IOMMU/DMA 映射相关内核日志
dmesg | grep -i -E "dma|iommu"
# 查看 PCIe 设备的 DMA 能力
lspci -vvv | grep -i -E "bus master|dma"
# 查看 DMA 缓冲区使用情况(以网卡为例)
ethtool -S eth0 | grep -i dma
# perf 观测 DMA 相关的 cache miss
perf stat -e cache-misses,cache-references dd if=/dev/nvme0n1 of=/dev/null bs=1M count=1024- DMA 映射失败(
swiotlb buffer is full):内核日志出现此信息表示 DMA bounce buffer 不够,可能需要在启动参数中加大swiotlb。 - DMA 超时:设备驱动中常见,可能是硬件故障或 PCIe 链路问题。
八、和本仓库其他文档的关系
- CPU 与 DMA 交互:dma-cpu-interaction——CPU 如何与 DMA 控制器交互:从发起请求到数据传输完成的完整过程,描述符队列、门铃机制、PCIe TLP 序列、IOMMU 地址翻译。
- 中断处理:interrupts——DMA 完成后通过中断通知 CPU,是中断的下半部(NET_RX softirq)处理 DMA 收到的数据。
- 零拷贝:zero-copy——SG-DMA 是零拷贝的终极形态,网卡用 SG-DMA 直接从 page cache 收集数据。
- PCIe 总线:pcie——现代 DMA 的物理传输通道,Bus Mastering 依赖 PCIe 的总线仲裁机制。§四.1 详述 BAR 与 DMA 的控制面/数据面关系。
- 容器性能:performance——IOMMU 对容器/虚拟机中 DMA 的性能影响。
- 中断合并:interrupts NAPI 部分——网络 DMA 收包后的中断合并策略。
九、一句话总结
DMA 是让外设(网卡/磁盘/NVMe/GPU/FPGA)自己读写内存、CPU 只发命令和收完成中断的机制,把 CPU 从数据搬运中彻底解放。现代系统用 Bus Mastering 模型:每个外设自带 DMA 引擎,通过 PCIe 总线成为"总线主设备"主动读写内存。SG-DMA 支持分散-聚集描述符链表,是零拷贝的硬件基础;DDIO 让 DMA 直接写进 L3 cache 进一步降低延迟。服务器访问 FPGA 必须用 DMA——让 FPGA 成为总线主设备以 PCIe 线速搬数据,否则 CPU 搬数据的时间远超 FPGA 加速省下的时间。DMA 不是完全免费,它会争抢内存带宽、引入 cache 一致性问题、产生中断开销,但相比 CPU 亲自搬数据,这些代价不值一提。