系统调用的执行过程及开销 —— stime 是怎么被"陷入内核"打高的
strace 教你数一个进程调了多少次 syscall、每次多慢,pidstat 的
%system告诉你内核态占了多少 CPU。但两者都没回答:一次系统调用内部到底发生了什么?为什么它比一次普通函数调用贵几个数量级? cpu_demo 场景2(每轮open/write/close)之所以能把stime打满,根子就在这里——本篇把这个"陷入内核再回来"的过程拆开看清楚。
一、系统调用是什么、为什么必须要有
用户程序想读文件、发网络包、申请内存映射、创建线程,这些动作都要操作硬件或内核管理的资源。但用户程序如果能直接碰这些资源,一个进程就能读别人的内存、乱写磁盘、瘫痪整机——所以 CPU 用 特权级(ring) 把权限分开:
| 级别 | x86 术语 | 谁在跑 | 能做什么 |
|---|---|---|---|
| 用户态 | ring 3 | 普通应用代码 | 只能算数、访问自己的内存,不能执行特权指令、不能直接碰硬件/内核数据 |
| 内核态 | ring 0 | 内核代码 | 可以执行特权指令(改页表、开关中断、访问全部物理内存、操作设备) |
用户态没有权限自己干这些事,只能向内核发一个受控的请求,让内核代劳——这个受控入口就是系统调用(system call)。它是用户态进入内核态的唯一合法主动通道(另两种进内核是被动的:硬件中断、异常/缺页)。
一句话定位:普通函数调用是"在自己的权限里跳一下";系统调用是"敲内核的门、请它替你干一件你没权限干的事"。门是有成本的,这就是开销的来源。
二、一次系统调用的完整执行过程
以 x86-64 Linux 调 write(fd, buf, len) 为例。约定俗成:系统调用号放 rax,参数依次放 rdi/rsi/rdx/r10/r8/r9(注意第 4 个参数用 r10 而不是普通函数调用的 rcx,因为 syscall 指令会占用 rcx)。
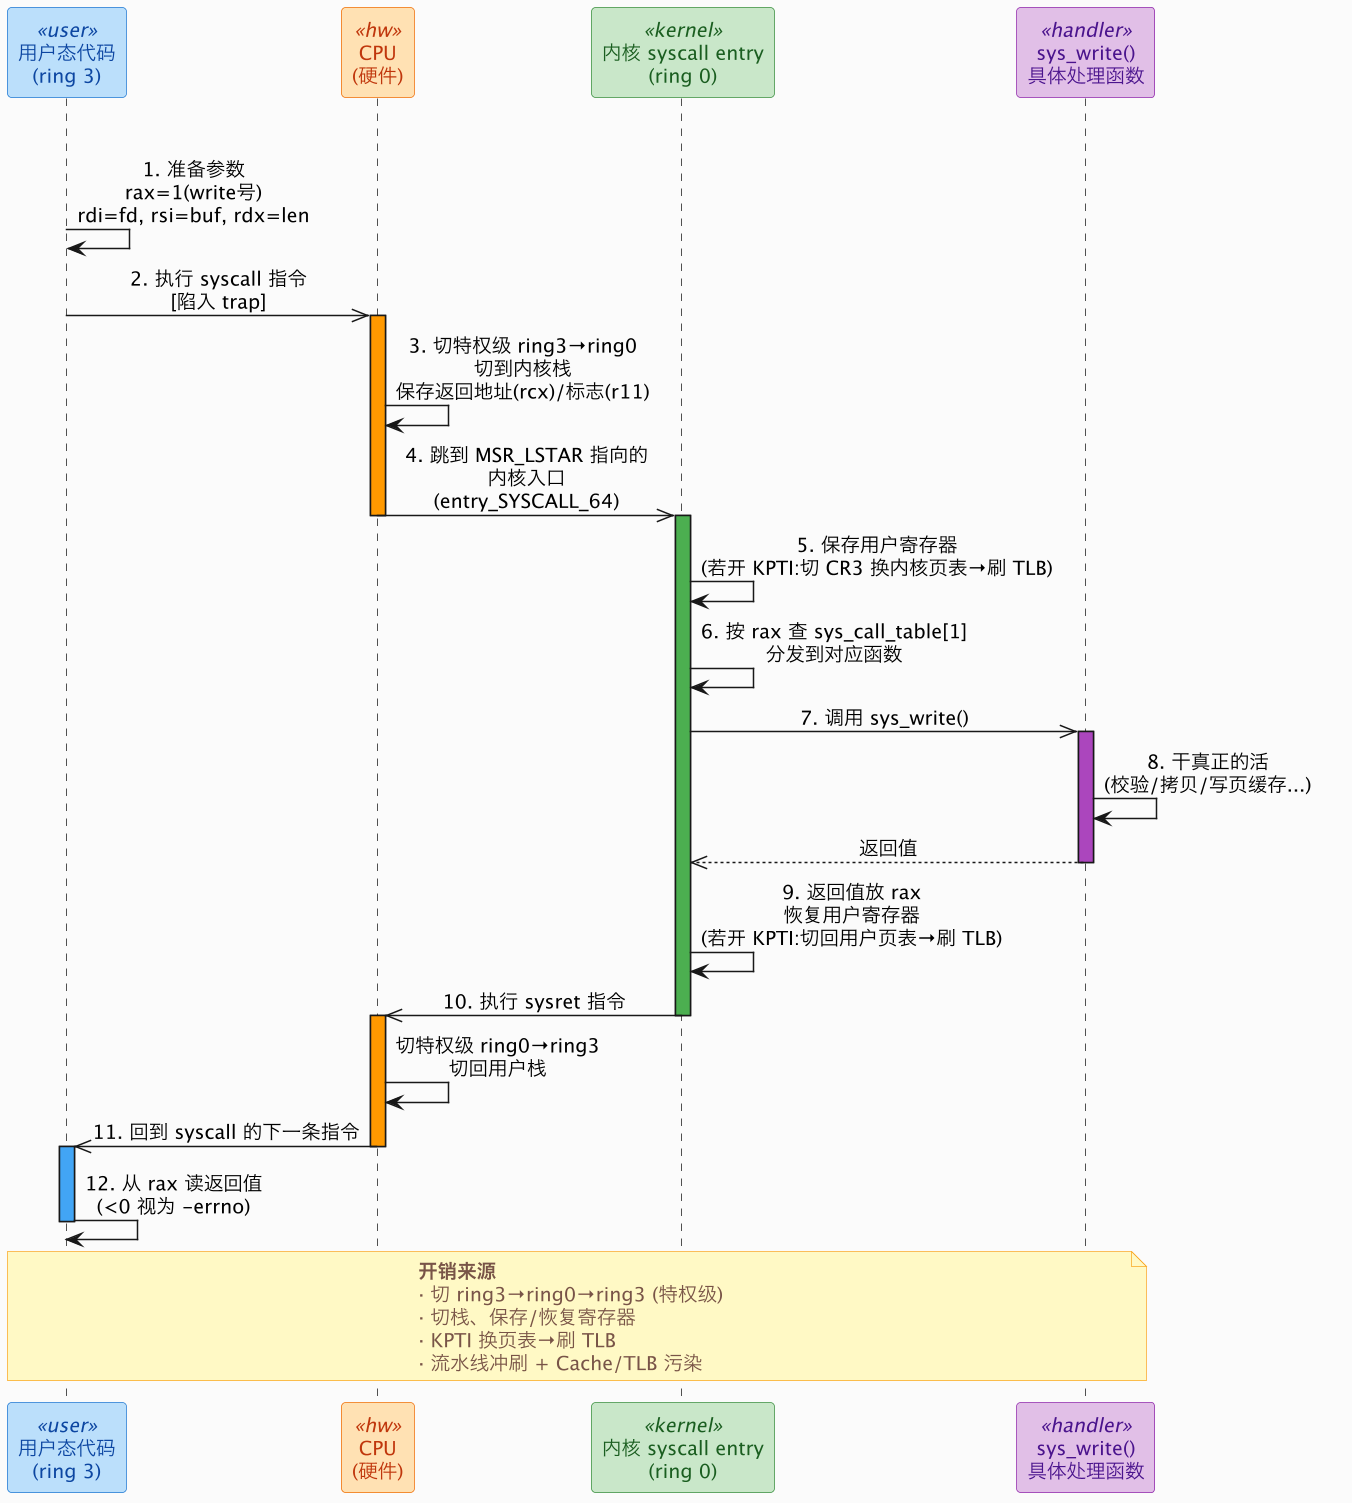
关键点说明:
- 陷入(trap)的本质:
syscall是一条会主动触发特权级切换的指令。它不像call跳到用户给的地址,而是跳到内核在开机时通过 MSR 寄存器(MSR_LSTAR)登记好的固定入口——用户无法指定跳哪,这保证了进内核只能从内核认可的门进。 - 分发靠调用号:内核不为每个 syscall 设一个入口,而是用一张
sys_call_table数组,rax里的号就是下标。所以调用号是用户态和内核约定的"菜单编号"。 - 老机制:x86-64 之前用软中断
int 0x80陷入,慢(走中断门、要查 IDT);现代用专门的syscall/sysret指令,快得多。32 位程序或老内核仍可能见到int 0x80。 - 返回约定:返回值统一放
rax。负值(如-2)表示错误,glibc 包装函数会把它翻成errno=ENOENT并返回-1——这就是为什么 strace 能看到openat(...) = -1 ENOENT。
三、开销从哪来(核心)
一次普通函数调用只需几个时钟周期(压栈/跳转/返回)。一次系统调用要几百到上千纳秒、上千个时钟周期,差 2~3 个数量级。开销分两块:
3.1 直接开销:特权级切换本身
这里的关键问题是:同样是指令,"切特权级"为什么比"切函数"贵这么多?
答案在寄存器文件(Register File)的实现里。现代 CPU 用寄存器重命名让 call 几乎免费,但特权切换要碰的寄存器不在重命名范围内。
call 为什么几乎免费
call target 在硬件上只做两件事:RIP 压栈 + 跳转。这两个操作都落在重命名引擎的覆盖范围里:
- RIP 在乱序核内部就是一个可重命名的寄存器,和 RAX/RBX 没有本质区别
- RSP 的修改被栈引擎(Stack Engine)拦截,
push不真的写内存,只是把 RSP 重命名到一个新的物理寄存器 - 目标地址交给分支预测器 + RAS(Return Address Stack)——返回地址进入 RAS 硬件栈,等
ret时直接弹出预测,零周期
所以 call 在译码后被展开成 1~2 个 uop,和其它 ALU 指令一样在流水线里流动,不阻塞、不序列化。
syscall 为什么贵——它要碰重命名范围之外的硬件状态
syscall 指令在硬件上实际执行的操作有:
- 读 MSR_LSTAR → 新 RIP。MSR(Model Specific Register)是控制寄存器,不在通用寄存器文件里,更不参与重命名。读 MSR 走的是独立的控制寄存器读通路,比读 GPR 慢得多,单个 MSR 读就可能要几拍。
- 读 MSR_STAR → 新 CS/SS 段选择子。又是 MSR 读。
- 加载新 CS 段寄存器。加载段寄存器不是简单的"写一个值"——CPU 必须去 GDT(全局描述符表)里查出对应的段描述符,验证 DPL(Descriptor Privilege Level)、检查段界限,然后把基址/限长/属性加载到段寄存器的隐藏描述符缓存中。这个过程在较老的微架构上要走微码 ROM,需要几十个 uop。即使在较新的 CPU 上优化过,依然比写一个 GPR 慢一个数量级。
- 更改 CPL(当前特权级)。CPL 存储在 CS 段寄存器的隐藏部分,是 CPU 做每一次内存访问时都要检查的硬件状态。修改 CPL 是一个序列化事件——CPU 必须确保比
syscall老的指令全部完成、比syscall新的指令还没有开始,才能改 CPL。这不是流水线冲刷(那是 3.2.1 的内容),而是硬件为了让安全性边界清晰而必须插入的序列化气泡。 - 读 MSR_KERNEL_GS_BASE → 切换 GS.base。内核用 GS 段访问 per-CPU 变量区,又是一次 MSR 读写 + 段描述符缓存重载。
- 切换 RSP。用户栈 RSP → 内核栈 RSP(从 TSS 或 MSR 读取)。RSP 本身虽然可重命名,但这里换的是值,不是重命名——栈引擎追踪的是一个连续的 RSP 变化序列(+8/-8),突然换到一个完全无关的值,栈引擎的所有历史状态全废。
把这些加起来,syscall 指令在译码后被展开成 15~30+ 个 uop(取决于微架构),包含慢速 MSR 读、段描述符加载、序列化屏障——而 call 只有 1~2 个普通 uop。这就是"同为硬件指令,差了一个数量级"的根本原因。
syscall指令本体约 10~30 拍(15~30 uop × 每拍发射 4~8 uop 的发射宽度),这还不算流水线冲刷带来的额外代价。而call是 1~2 拍。
3.2 间接开销:切换污染了 CPU 的"缓存态"(往往更大)
这部分不显示在"syscall 指令本身",却常常是大头,而且呼应本仓库缓存篇的所有主题:
3.2.1 流水线冲刷:深流水线被"清空重来"
现代 CPU 是深度流水线+超标量+乱序执行的。在用户态执行 syscall 之前,CPU 已经在推测执行(speculative execution)了几十到上百条后续指令——分支预测器猜方向、取指、译码、发射到执行单元,流水线是满的。
但 syscall 指令一执行,CPU 发现前面推测的全错了——流水线里的指令都是用户态指令,按用户态的页表取指、按用户态的权限跑,而现在必须切到内核态。CPU 的做法是:
- 冲刷整个前端流水线:取指队列、译码队列里尚在飞行的用户态指令全部丢弃。
- 冲刷 ROB(重排序缓冲):乱序执行中已发射但未退休的用户态指令全部作废,不提交架构状态。
- 保存当前上下文后,重新从内核入口
entry_SYSCALL_64取第一条内核指令——从 I-cache miss 开始重新填流水线。
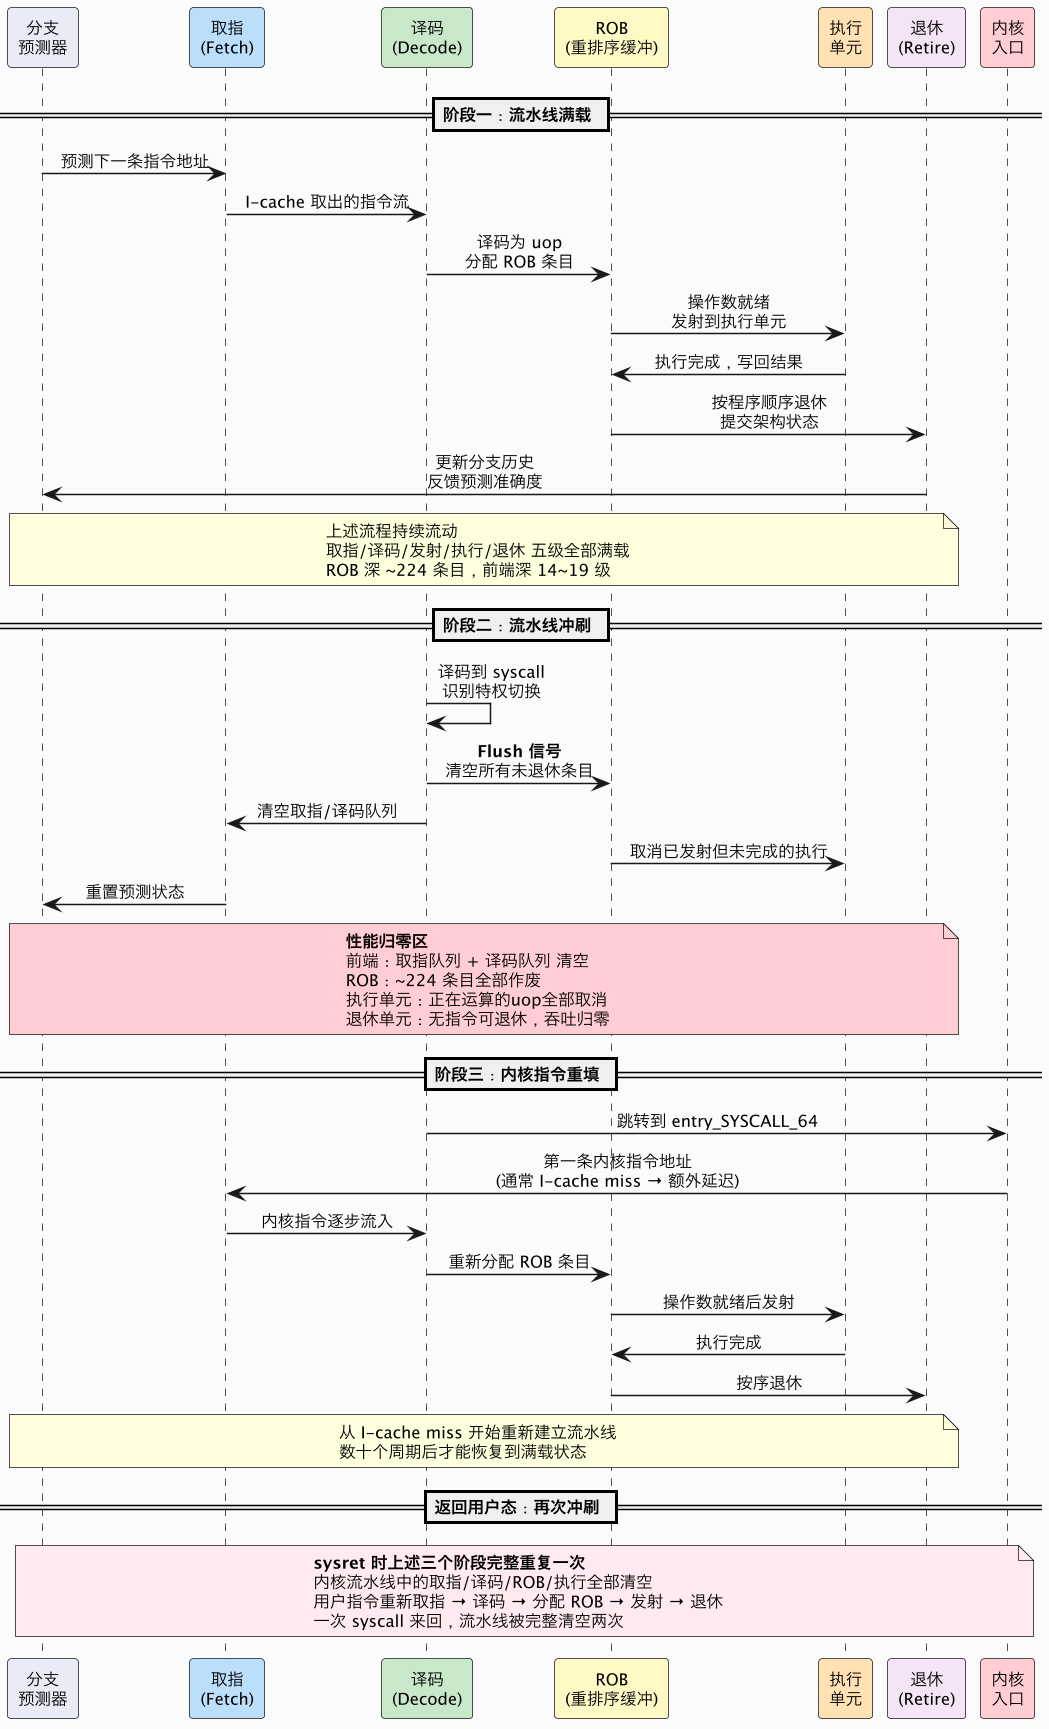
为什么 ROB 必须被清空?
ROB(Reorder Buffer,重排序缓冲)是现代乱序执行 CPU 中最核心的追踪结构。它的职责是确保"乱序执行,按序退休"——指令可以在执行单元中任意顺序完成,但对程序员可见的架构状态(寄存器、内存)必须按程序原来的顺序提交。每条指令在译码阶段分配一个 ROB 条目,条目中包含:
- 指令的类型和目标寄存器
- 操作数是否就绪的标记
- 执行结果值
- 异常/中断标志位
- 分支预测是否正确等信息
退休(Retire)过程是严格按 ROB 条目编号递增进行的:只有最老的那条、且已完成执行的指令才能退休,一退休就释放它的 ROB 条目。如果最老的指令还没执行完,后面所有指令即使结果已经算出来了也得在 ROB 里等着——这就是"按序退休"。
当译码单元识别到 syscall 指令时,ROB 中的状态是这样的:
ROB 条目号:  N-3    N-2    N-1     N(s)   N+1    N+2    ...
指令:      add    load   cmp    syscall  mov   add    jmp
状态:      ✓已退   ✓已退  □执行中  □译码  □取指  □取指  □预测
syscall 前面的指令(N-3, N-2)已经退休,架构状态已更新——这些不受影响。但 syscall 本身及其之后的所有条目(N-1, N, N+1, N+2...)必须全部作废,原因有三:
- 正确性。
syscall之后,CPU 应该执行的是内核代码(entry_SYSCALL_64),而非原来用户态的mov/add/jmp。如果不清空 ROB,退休单元会按编号顺序退休到这些用户态指令——相当于内核态下错误地执行了用户代码,程序行为完全不可预期。 - 安全性(KPTI 的根源)。即使我们"假装"让这些用户指令在内核态执行完,它们的访存依据的是用户态页表,而当前 CR3 已经指向内核页表。不清空 ROB 会直接导致 Meltdown 类型的侧信道攻击——用户代码的数据残留在微架构状态中,可被内核态观测。
- 无法部分清空。ROB 按程序顺序线性编号,指令之间通过 ROB 条目号关联(例如分支指令记录"如果预测错了,从哪个 ROB 条目之后冲刷")。不存在"只保留某些条目、丢弃另一些"的机制——ROB 只能从某个编号之后整段清空。既然
syscall之后的所有指令都不该被执行,整个尾段必须全部作废。
代价量化与 I-cache miss:现代 Intel/AMD CPU 前端 14~19 级深度,ROB~224 条目。而程序在发生 syscall 时,分支预测器早已沿着用户态代码路径推测了几十到上百条指令——这些全部被丢弃。随后从 entry_SYSCALL_64 重新取第一条内核指令,几乎一定是 I-cache miss,原因有四:
- L1 I-cache 只有 32KB。一个用户态热循环几十 KB,可以把 L1I 全部占满。内核入口的代码(
entry_SYSCALL_64~ 几百字节)在用户代码运行过程中早就被挤出了 L1I——容量竞争,谁跑谁占坑,用户代码不会"给内核留位置"。 - 两次 syscall 之间用户代码跑了太多指令。假设一个
write()循环,两次 syscall 之间是应用自己的数据处理逻辑——可能跑了几百到几千条指令。L1 I-cache 的替换策略(通常是 LRU 或其近似实现)在这段时间里早已把内核入口对应的 cache line 刷掉。时间局部性被打破——内核入口不是用户程序"经常访问"的地址。 - 内核和用户的虚拟地址完全不同。用户代码约在
0x00007f...,内核代码约在0xffffffff80...。虽然 L1 I-cache 是 VIPT(虚拟索引物理标记),低 12 位索引来自虚拟地址,但它们落在不同的 cache set 不是问题——真正的问题是 L1I 总共就 32KB 容量,用户代码满载后,内核入口根本没空间留驻。 - 内核入口本身不是一个点,而是一段路径。
entry_SYSCALL_64并非只有几条指令——它要做 CR3 切换、保存寄存器、切换内核栈、设置 GS.base、初始化 per-CPU 变量……这一整段初始化代码可能跨越多个 cache line。哪怕某些 line 侥幸在 L2 中,仍需从 L2 重新加载到 L1I,代价约 14 个周期起步。
综合来看,I-cache miss 带来的实际代价是 frontend stall(取指阻塞)× 数十周期。
"两次清空"是指什么?
一次 syscall 的完整生命周期包括进入内核和返回用户态两个方向,每个方向都需要一次完整的流水线冲刷:
| 方向 | 触发指令 | 冲刷内容 |
|---|---|---|
| 第一次:用户→内核 | syscall | 清空前端取指/译码队列 + 清空 ROB 中所有用户态未退休指令 + 取消执行单元中正在运算的用户 uop |
| 第二次:内核→用户 | sysret | 清空前端取指/译码队列 + 清空 ROB 中所有内核态未退休指令 + 取消执行单元中正在运算的内核 uop |
第一次冲刷后,流水线从零开始填充内核指令;等到内核工作完成、执行 sysret 时,流水线里满载的是内核代码——同样要全部丢弃,从零开始填充用户代码。总代价约为 2 × (前端深度 + ROB 重填时间),在 Intel Skylake/Ice Lake 上大约是 50~80 个周期只是流水线重建的开销,还不包括实际的系统调用逻辑(权限检查、文件系统、设备驱动等)。
对吞吐型代码(比如
write()一个字节的循环),流水线永远填不满,IPC(每周期指令数)暴跌——因为每次迭代都触发两次冲刷,CPU 大部分时间在空转重建流水线,而非执行有效指令。(流水线/乱序的详细机制见 cpu-out-of-order)
3.2.2 Cache 被污染:内核代码和数据挤走用户的热数据
L1 D-Cache(L1D)、L1 I-Cache(L1I)、L2 都是容量有限的硬件资源。一个典型的 Intel 核:
| 缓存 | 容量 | 被谁使用 |
|---|---|---|
| L1 I-Cache | 32 KB | 执行内核代码 → 替换掉用户的热指令 |
| L1 D-Cache | 32~48 KB | 内核读写数据结构(fd 表、inode、dentry、页缓存) → 替换掉用户的热数据 |
| L2(Unified) | 256KB~1MB | 内核代码+数据统一涌入 → 指令和数据同时挤占用户空间 |
内核代码本身并非"轻量级"——sys_write() 背后是:VFS 层找 inode→权限检查→ext4_file_write_iter()→找磁盘块→generic_perform_write()→操作 page cache→可能触发回写。这一整条调用链的指令和数据,远比用户程序的一个热循环大得多。
实际表现:回到用户态后,原本一个 L1 命中只需 4~5 周期的访存,突然变成 L2 命中(~14 周期)甚至 L3 命中(~40 周期)。如果你在用户代码中精细测量,会发现 syscall 之后的几十条指令比平时慢 3~10 倍——这不是用户代码写得不好,是缓存被内核"洗"了一遍。
同样的事也发生在 L1 I-Cache 上:内核的几十 KB 代码在执行过程中,会把用户程序热循环的指令从 L1I 挤出去。返回后取指也要从 L2 甚至内存重新加载。(详见 i-cache 第四节关于 unified L2/L3 中代码和数据互相抢占)
缓解思路:减少 syscall 频次(批量化)、让内核路径尽量短(比如 vDSO 免陷入),本质上是在减少"缓存被污染"的频率和程度。相关机制见 cache-organization 和 cache-friendly-code。
3.2.3 TLB 被污染/刷新:地址翻译的缓存也被打乱
TLB(Translation Lookaside Buffer)是虚拟地址→物理地址翻译的高速缓存,容量极小:
| TLB 层级 | 典型容量 | 覆盖范围(4KB 页) |
|---|---|---|
| L1 dTLB | 64 条目 | 256 KB |
| L1 iTLB | 128 条目 | 512 KB |
| L2 STLB(统一) | 1536 条目 | 6 MB |
用户程序执行时,TLB 里装的是用户地址空间的翻译条目(代码段、栈、堆、mmap 区)。一旦进入内核:
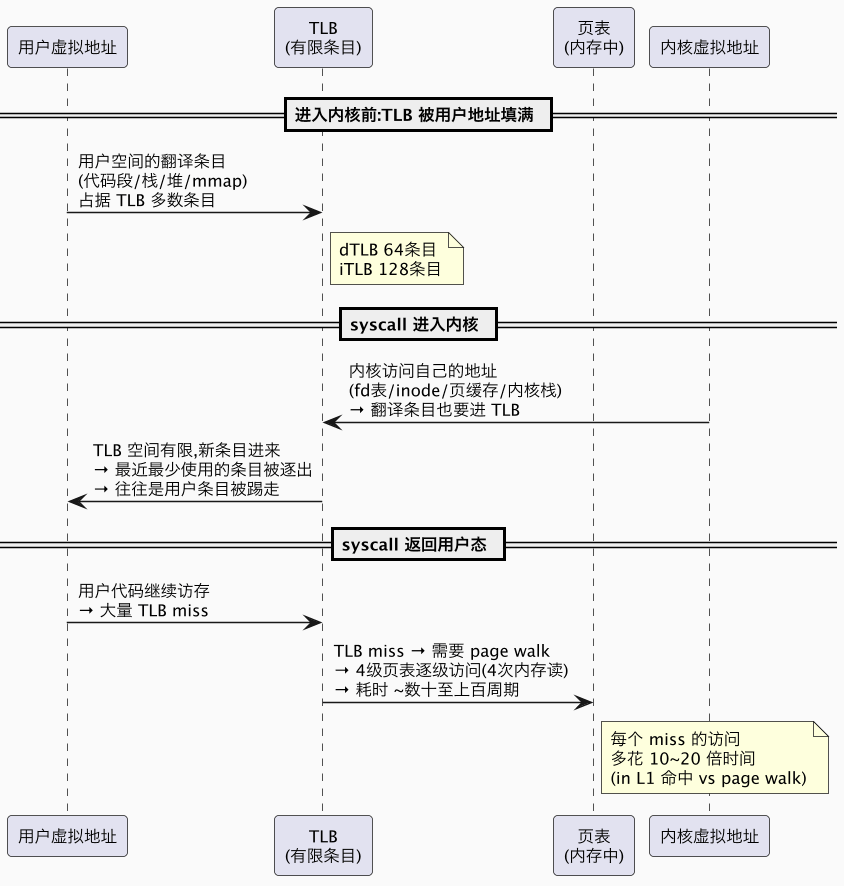
关键洞察:内核代码执行期间访问的数据结构(inode 缓存、dentry、page cache 的 struct page、task_struct 等)分布在物理内存的各个角落,每个新页面访问都可能在 TLB 中创建一个新条目,从而挤走一个用户条目。内核退出时,用户热路径上那些本应 TLB 命中的地址现在全是 miss——每次 miss 触发一次四级页表遍历(4 次内存访问),累计数十到上百周期。
大页(Huge Page,2MB/1GB)可以将 TLB 的有效覆盖范围扩大 512 倍/262144 倍,显著降低 TLB miss 概率——对 syscall 密集型负载同样有效。详见 tlb。
3.2.4 KPTI(内核页表隔离):每次 syscall 都要换"地图"
这是 2018 年 Meltdown 漏洞(CVE-2017-5754)之后的最大一笔额外税。背景是:Meltdown 利用 CPU 的推测执行,让用户态代码在 transient window(瞬时窗口)里读到内核态映射的数据,虽然在架构层面这条推测指令最终被丢弃,但它的副作用已经留在了 cache 中,可以通过旁路攻击还原。
KPTI(Kernel Page-Table Isolation,原名 KAISER)的对策:用户态和内核态不再共用一套页表。
时序对比:
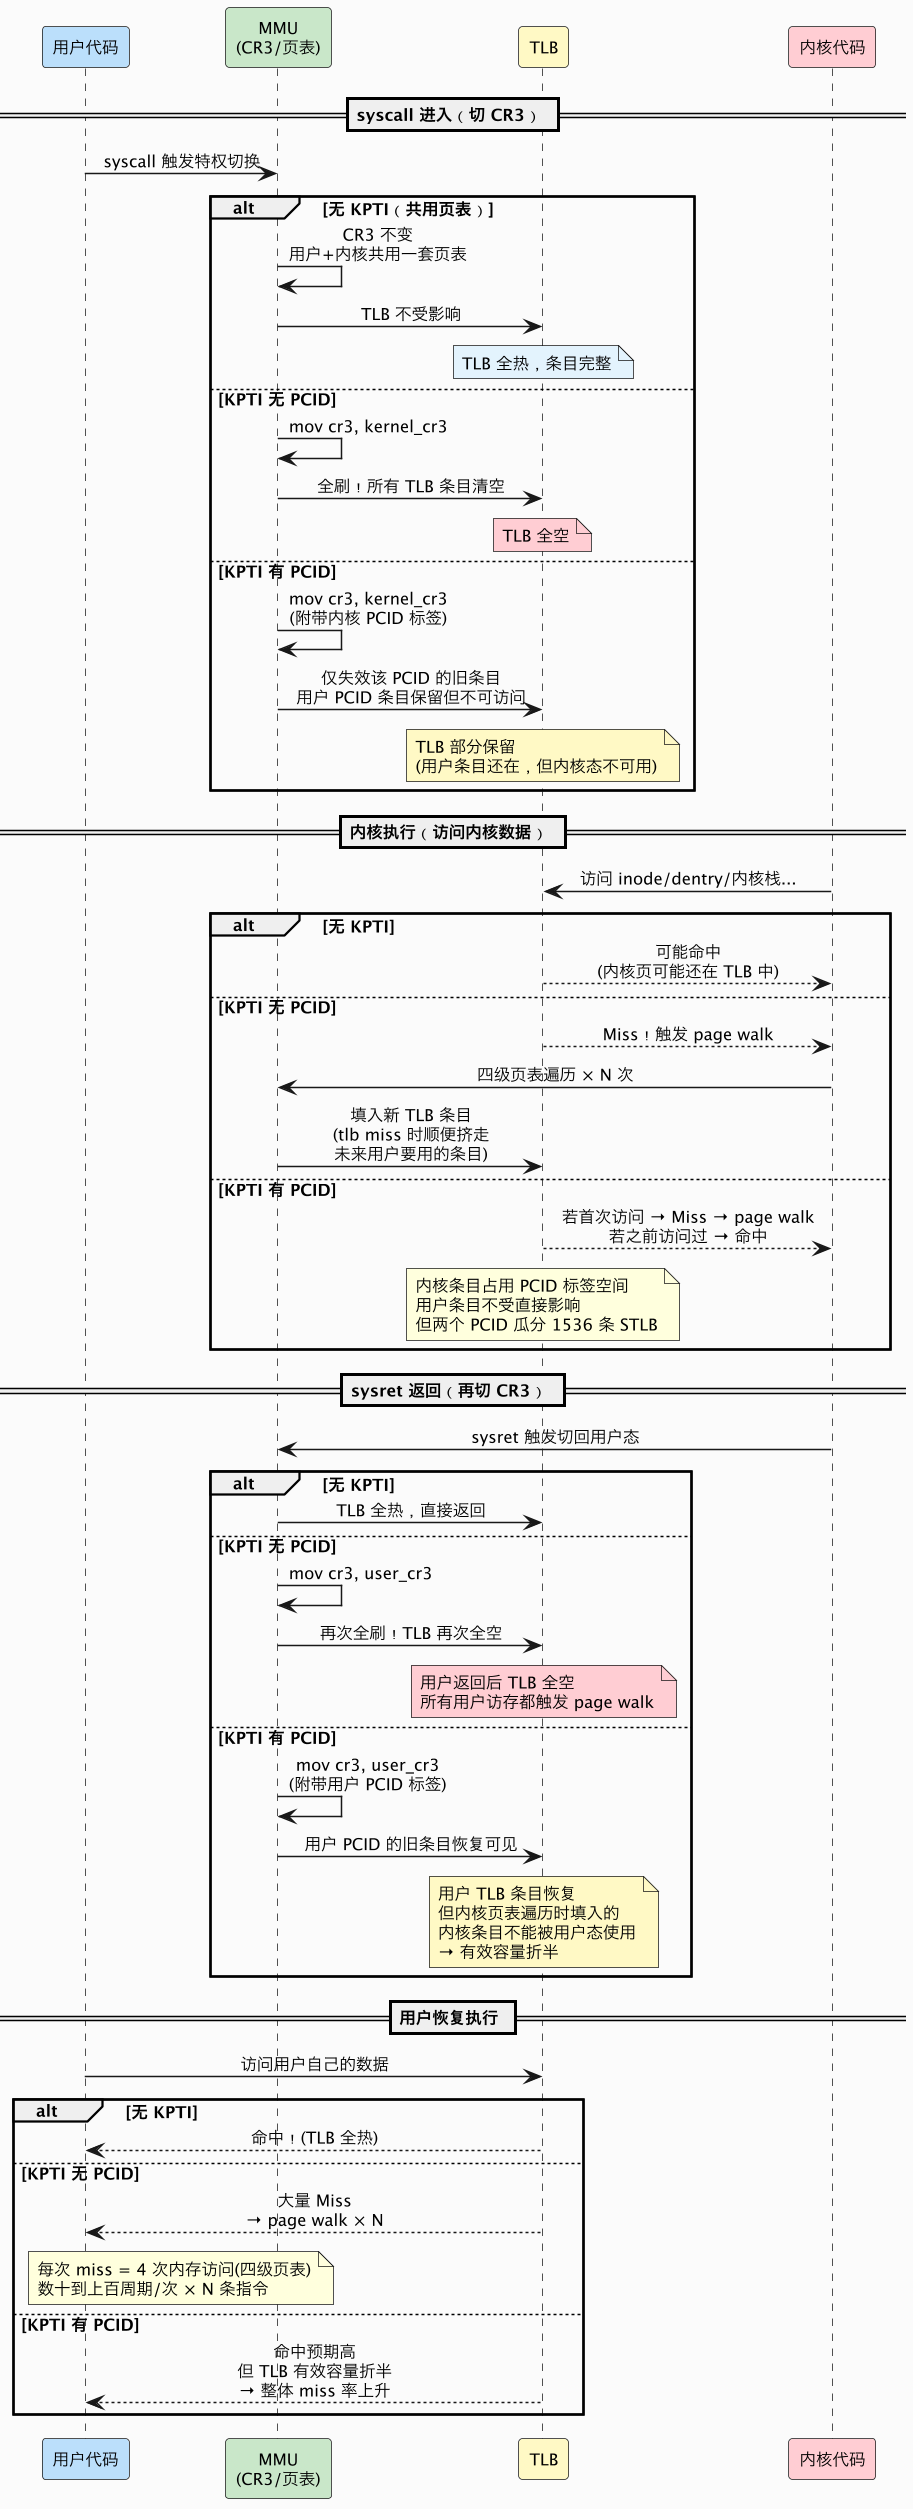
量化影响:
| 场景 | 每次 syscall 额外开销 | 原因 |
|---|---|---|
| 无 KPTI | 0 | 不切换 CR3 |
| KPTI + 无 PCID | +数百周期 | 两次全刷 TLB,返回后所有访存都要 page walk |
| KPTI + 有 PCID | +几十~上百周期 | CR3 切换本身不贵,但两套页表让 TLB 有效容量折半,miss 率上升 |
实际表现:KPTI 对"syscall 密集"的负载(如网络代理、数据库、消息队列)影响最大——如果每秒调几十万次 syscall,每次多花几百周期,总体 CPU 利用率可见上升 20~50%。但对"计算密集偶尔 syscall"的负载影响不明显。
验证:检查
/proc/cpuinfo的pcid和pti标志;内核启动参数pti=off可关闭(仅限测试环境)。相关安全背景见 branch-prediction 里推测执行的安全副作用。
3.3 量化对照
| 操作 | 量级 |
|---|---|
| 普通函数调用 | 几个时钟周期 |
| L1 cache 命中 | ~4 周期 |
| 一次系统调用(直接开销) | 数百 ns / ~1000+ 周期 |
| 系统调用 + cache/TLB 污染余震 | 更高,难以精确切分 |
| 开 KPTI 后 | 在此基础上再显著增加 |
结论:系统调用贵,不只贵在"切进切出那一下",更贵在它把 CPU 辛苦攒起来的流水线、cache、TLB 状态全打乱了。所以性能优化的铁律不是"让每次 syscall 更快",而是少调 syscall。
四、怎么减少系统调用开销
核心思路:减少陷入内核的次数(而非单次变快)。
- 批量化(一次调用干多件事):
readv/writev(scatter-gather):一次 syscall 读/写多段缓冲。io_uring:一次系统调用提交一批 IO 请求,内核异步完成,极大摊薄陷入成本,是现代高性能 IO 的方向。sendmmsg/recvmmsg:一次收发多个网络报文。
- 减少调用次数(用户态缓冲):典型是 stdio(
fwrite/fread)在用户态攒一个缓冲区,攒满才真正write一次。cpu_demo 场景2 每轮open+write+close是反面教材——改成打开一次、复用 fd、带缓冲写,syscall 次数(和%system)立降。 - 用 vDSO 免陷入:见第五节。
mmap代替read/write:把文件映射进地址空间后,读写变成普通内存访问,不再每次都 syscall(缺页时才陷入,且是被动的)。
五、vDSO 和 vsyscall —— 有些"系统调用"根本不陷入内核
有一类"系统调用"频率极高、但只是读一小块内核维护的只读数据(比如当前时间):gettimeofday、clock_gettime、getcpu 等。为它们每次都陷入内核太浪费。
内核的办法:把这些函数的实现和它们要读的数据(如内核每 tick 更新的时间戳)映射到每个进程的用户地址空间,这块区域叫 vDSO(virtual dynamic shared object)。用户态调用 clock_gettime 时,glibc 实际跳进 vDSO 里的代码,在用户态直接读那块共享内存算出结果,完全不执行 syscall 指令、不切特权级——零切换开销。
- 这解释了一个常见困惑:为什么 strace 里常常看不到
gettimeofday/clock_gettime——因为它们走 vDSO,压根没陷入内核,ptrace自然拦不到。 vsyscall是 vDSO 的前身:固定地址的一小段映射,因地址固定成了安全隐患(易被利用),现已被 vDSO 取代,仅为兼容保留(常处于 emulate 模式)。- 可用
ldd看到进程链接的linux-vdso.so.1(它没有对应磁盘文件,由内核注入)。
六、观测:怎么看到系统调用和它的开销
| 手段 | 看什么 | 链接 |
|---|---|---|
strace -c | 每个 syscall 的次数和累计耗时,一眼看出谁调太多 | strace |
pidstat 的 %system | 进程消耗的内核态 CPU 比例,syscall 密集则高 | pidstat |
/proc/<pid>/stat 的 stime | 进程累计的内核态时间(jiffies),cpu_demo 就是读这个字段自算 | ../../demos/cpu-demo/main.cpp |
perf trace / perf stat | 低开销地统计 syscall、看 context-switches、dTLB-misses 等 | perf |
对应 cpu_demo 场景2:程序在一个循环里反复 open/write/close,每轮 3 次陷入内核。运行后用 pidstat 会看到 %system 被打高(而场景1 的用户态死循环打高的是 %usr),用 strace -c 会看到 openat/write/close 各调了近十万次——这就是"内核态时间从哪来"的实证。详见根目录 ../../ 的场景2。
七、一句话总结
系统调用是用户态(ring 3)向内核态(ring 0)请求代劳的唯一主动合法入口:准备好调用号(rax)和参数,执行
syscall指令陷入内核,内核按号查sys_call_table分发、干活、把返回值放 rax、sysret回来。它比普通函数调用贵几个数量级,贵不只在特权级切换本身,更在切换冲刷了流水线、污染了 cache 和 TLB(KPTI 之后还要换页表刷 TLB),余震让返回后的用户代码一片 miss。所以优化不是"让 syscall 更快",而是"少陷入"——批量化(io_uring/writev)、用户态缓冲(stdio)、vDSO(gettimeofday 免陷入)、mmap 代替读写;而 cpu_demo 场景2 的反复 open/write/close,正是把 stime/%system打高的活教材。
八、深入阅读
- syscall-details —— 同一线程从用户态到内核态的完整过程:段寄存器切换(CS/SS/DS)、GDT 描述符与 DPL 权限检查、syscall/sysret 的硬件微操作序列、内核栈与 pt_regs、KPTI 页表切换与 PCID、为什么第 4 参数必须用 r10 而非 rcx。
- read-write-process —— 以 read/write 为实例,展示系统调用在真实 IO 链路中的完整过程。
- vfs-from-process —— 进程视角:从 syscall 陷入内核后,VFS 如何接管 fd →
struct file→f_op的五跳分发。