一、先分两大类:主动调度 VS 被动抢占(中断强制打断)
1、主动调度(你说的阻塞场景)
线程在用户态执行阻塞调用(read、mutex、sleep等),执行syscall陷入内核,内核发现资源不可用,线程主动调用schedule()放弃CPU,主动保存上下文,切换其他线程运行。
全程没有硬件打断,是执行流自己走到调度函数。
先把两大类调度的关键差异摆在一起对照,后面所有细节都挂在这张表上:
| 维度 | 主动调度(阻塞让出) | 被动抢占(中断踢下) |
|---|---|---|
| 触发原因 | 线程执行 read、mutex、sleep 等资源不可用 | 硬件时钟中断强制打断执行流 |
| 进入内核方式 | syscall 指令主动陷入 | 中断向量强制跳转 |
| 谁决定放弃 CPU | 线程自己调用 schedule() | 内核检查 TIF_NEED_RESCHED 后调度 |
| 现场保存动作 | CPU 硬件把寄存器压入内核栈 | 完全相同,也是 CPU 硬件压栈 |
两类调度看起来一个「自愿」一个「被踢」,但落到硬件层面,保存现场的动作一模一样——这个结论在本文后半段会反复用到。
二、被动抢占:时钟中断强行打断线程,分两大场景:
场景A:中断发生时,线程正在【用户态运行】(最容易抢占)
硬件时钟中断触发CPU:CPU强制打断用户态指令流,保存用户态寄存器现场,陷入内核中断入口。
完整步骤:
CPU收到定时器中断,强制打断正在执行的用户态指令,清空流水线、指令预取队列,保存用户态所有通用寄存器、栈指针到内核栈;
进入内核中断处理函数
scheduler_tick():检查当前线程运行时间,时间片耗尽,调用resched_curr(),设置线程标志位:TIF_NEED_RESCHED = 1(告诉内核:这个线程需要被换下CPU);中断处理全部执行完毕,内核准备返回用户态;
在返回用户态之前,内核汇编代码一定会检查:
TIF_NEED_RESCHED是否置位;标志位存在,不直接返回用户态,转而调用
schedule()执行线程上下文切换,切换到其他就绪线程;等新线程时间片到期,后续再次中断切换回来,恢复原来线程的用户态上下文,继续执行被打断的指令。
关键点:
用户态运行的线程,随时可以被时钟中断打断,且一定能被抢占,没有任何限制。只要设置了need_resched,在返回用户态那一刻必然发生调度。
把场景A的完整时序画出来,可以看清一个关键事实:中断处理本身并不切换线程,真正的切换发生在「返回用户态前的统一检查点」:
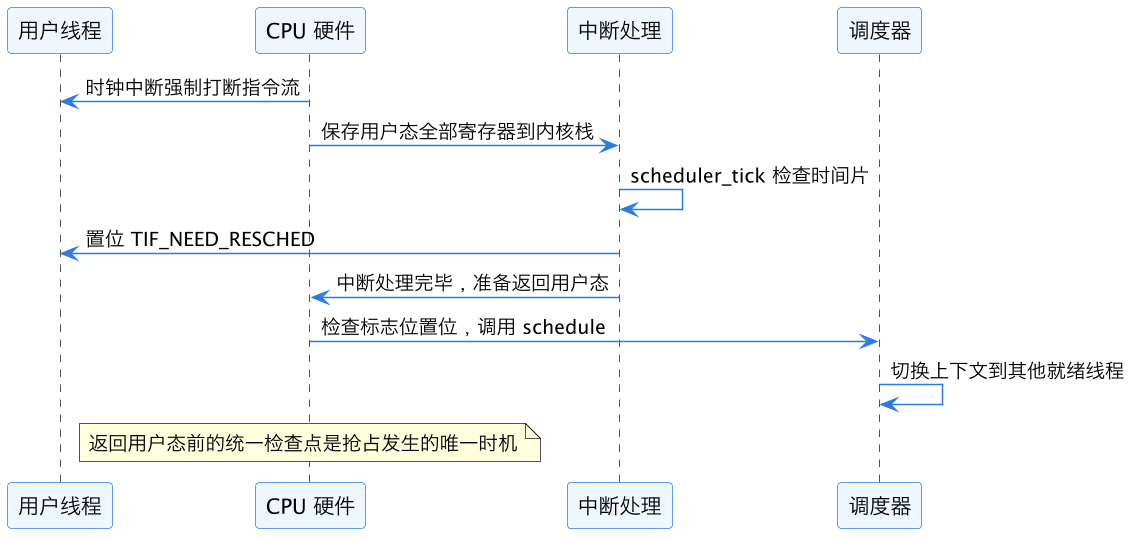
注意图中中断处理(scheduler_tick)只做「记账」:检查时间片、置标志位,然后就把CPU还给被打断的现场。真正换线程的是最后那个检查点——这也是为什么用户态抢占「必然发生」:任何返回用户态的路径都要过这一关。
场景B:中断发生时,线程正在【内核态运行】(系统调用执行中)
这个是重点,Linux分两种内核配置:不可抢占内核、可抢占内核(CONFIG_PREEMPT),服务器默认普通内核是非完全抢占内核。
B1:标准服务器内核(关闭内核抢占,绝大多数线上CentOS系统)
流程:
- 时钟中断打断正在内核态执行的线程,CPU保存内核态上下文,进入中断处理;
- 中断里依旧判断时间片用完,设置
TIF_NEED_RESCHED标志; - 中断处理完成,此时CPU还在内核空间,不会立刻调度!
普通内核规则:一旦进入内核态执行,除非主动调用schedule(),否则必须等这段内核代码执行完毕,返回到用户态的那一刻,才会检查标志、执行抢占切换线程。
也就是说:
线程在内核态跑系统调用,就算时间片用完,也只能标记一个待调度标志,内核会继续跑完当前系统调用全部逻辑,直到准备返回用户态之前,才做线程切换。
内核代码运行期间,不会中途被抢占踢下CPU。
B2:开启内核抢占 PREEMPT(实时内核/RT内核,量化低延迟系统常用)
内核允许在内核执行中途直接抢占,依靠两个东西:
TIF_NEED_RESCHED:时间片用完标记需要调度;preempt_count抢占计数器:线程在内核临界区(持有自旋锁、中断上下文)时计数器>0,禁止抢占;计数器等于0,内核代码可被打断。
完整打断流程:
时钟中断打断内核态运行的线程,设置need_resched标志;
中断退出时,内核判断两个条件:
preempt_count == 0 && TIF_NEED_RESCHED置位;条件满足:不用等到返回用户态,在内核上下文直接执行preempt_schedule_irq(),立即做线程上下文切换,把当前内核态线程换下CPU;
如果preempt_count>0(线程拿着自旋锁、处于中断处理中),则不能抢占,只能继续执行,等到临界区退出:解锁自旋锁时
preempt_enable(),计数器减到0,再主动检查标志、触发调度切换。
同样是「时钟中断打断内核态线程」,两种内核配置的分叉点就一个变量——preempt_count:
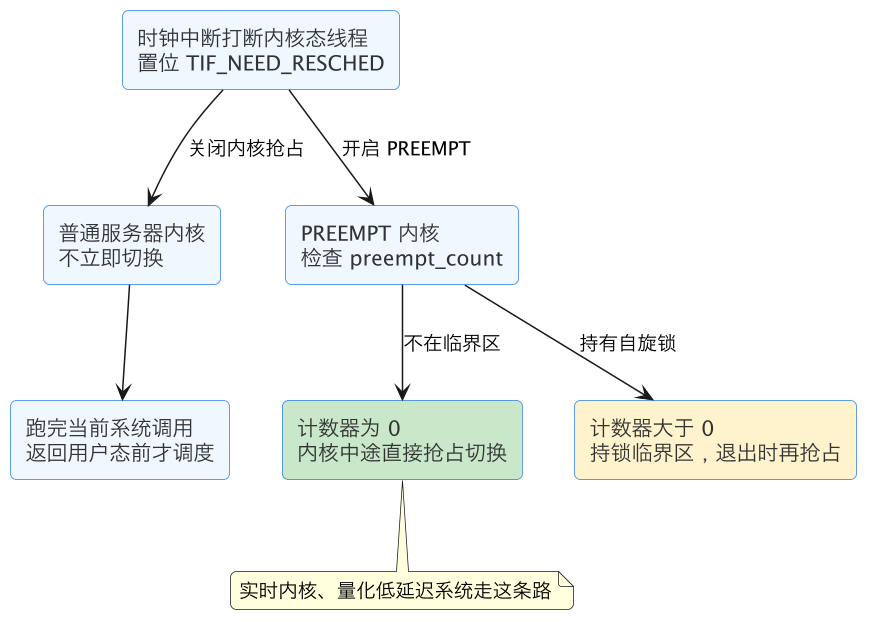
读这张图时抓住一条主线:TIF_NEED_RESCHED 只表达「该换了」,preempt_count 才决定「现在能不能换」。普通内核相当于把这个计数器永久当成大于 0 处理,所以内核路径上一律不抢。
三、总结两种状态下被打断的区别表格
| 线程运行状态 | 时钟中断到来 | 普通服务器内核(不可抢占内核) | PREEMPT可抢占内核 |
|---|---|---|---|
| 用户态执行 | 被硬件强行打断 | 中断返回用户态前必然触发调度切换线程 | 同样中断返回用户态前切换,逻辑一致 |
| 内核态执行(系统调用中) | 被硬件强行打断,仅设置TIF_NEED_RESCHED标志 | 不立即切换,等待内核代码执行完毕,返回用户态才调度 | preempt_count=0:内核中途直接抢占切换;preempt_count>0:等待临界区结束再抢占 |
四、核心几个关键点总结(结合你之前所有知识点)
- 所有被动抢占的源头只有一个:硬件中断(定时器中断为主),没有中断,CPU永远不会主动把正在运行的线程踢下来;
- 中断只会做两件事:①保存当前CPU现场;②设置need_resched标记;本身不做上下文切换;
- 用户抢占统一发生在:中断/系统调用返回用户空间的统一检查点;
- 内核态能不能中途被抢占,只看
preempt_count计数器,普通线上服务器内核默认不允许内核中途抢占,必须跑完内核路径回到用户态才切换; - 上下文切换保存的内容:用户态/内核态寄存器、栈指针、task_struct状态,I-cache/D-cache/TLB大部分保留,只有流水线、指令预取队列被清空。
如果你需要,我可以画一张PlantUML时序图:时钟中断→标记调度→用户态抢占/内核态抢占两条分支完整流程。
一、先给核心结论
不管是主动陷入内核(syscall阻塞调用schedule),还是时钟中断强行打断执行流:
CPU都会把完整的用户态执行现场(所有通用寄存器、指令指针RIP、栈指针RSP、全部调用上下文)完整保存到内核栈上。
线程切换时,保存的是内核栈里这份用户态快照;等线程再次被调度运行,内核先恢复内核栈内容,最后恢复整套用户态现场,回到原来被打断的位置继续执行,调用栈完全不变。
用户态调用序列一直存在于用户态虚拟地址栈空间里,从来没有移动过,CPU只是保存了指向它的指针。
二、拆分两种场景,现场保存位置一模一样
1. 用户栈本身不会动
你的函数调用栈、局部变量、返回地址,全部在进程私有用户虚拟地址空间的栈区域。
中断、系统调用都不会去拷贝这一大片内存,只是CPU把「当前执行位置、栈指针」这几十个寄存器保存起来。
场景1:主动陷入内核(阻塞调用,主动调用schedule)
- 用户态执行
read()系统调用,执行syscall指令; - CPU硬件自动把:RIP(下一条要执行的用户态指令地址)、RSP(用户栈栈指针)、所有通用寄存器,压入当前线程的内核栈;
- 进入内核,内核发现资源不可用,主动调用
schedule(); schedule()做上下文切换:把当前线程整个硬件上下文(内核栈里保存的用户态全套寄存器)记录到task_struct线程描述符中,切换页表、切换内核栈,切换到其他线程运行;- 后续重新调度到这个线程时:先恢复内核栈数据,再通过
sysret指令,从内核栈里取出之前保存的RIP、RSP、通用寄存器,恢复用户态执行,直接回到syscall之后的那条指令,用户栈、调用链路完全原样。
场景2:时钟中断强行打断(被动抢占,正在用户态运行)整个保存逻辑几乎一致
完整步骤:
CPU正在用户态执行普通指令,时钟中断触发,CPU硬件强制打断指令流;
CPU硬件自动执行动作(和syscall陷入几乎一样):
- 保存当前用户态RIP(被打断那一条指令的地址);
- 保存用户态RSP(用户栈栈顶指针,整个用户调用栈的入口);
- RAX~R15全部通用寄存器,依次压入当前线程的内核栈;
进入中断处理函数
scheduler_tick,设置TIF_NEED_RESCHED标记;中断处理完成,内核检查需要调度,调用
schedule()执行线程切换;schedule()保存当前线程全部硬件上下文到task_struct:内核栈里存放的整套用户态寄存器快照一并被保存;切换其他线程运行。
重点回答你的疑问:
用户态调用序列存在哪里?
- 用户函数调用栈(各级函数返回地址、局部变量):依然在用户地址空间的用户栈内存区域,原封不动,没有复制、没有移动。
- CPU只保存了指向这片用户栈的指针
RSP,以及指令断点地址RIP,这两个关键值存放在内核栈。
下次怎么恢复?
当线程再次被调度执行:
- 内核切换回来,先加载该线程的内核栈;
- 内核栈里存放着之前中断时刻保存的:RIP、RSP、所有通用寄存器;
- 内核执行iret/sysret指令,硬件自动恢复全部寄存器:RSP恢复成原来用户栈栈顶,RIP回到被打断的指令地址;
- CPU直接继续执行之前被中断打断的指令,用户态的整套调用上下文、栈数据完全没有变化,程序感知不到曾经被打断过。
把「打断 → 切换 → 恢复」这条闭环按时序展开,可以看到内核栈在其中扮演的中转站角色:
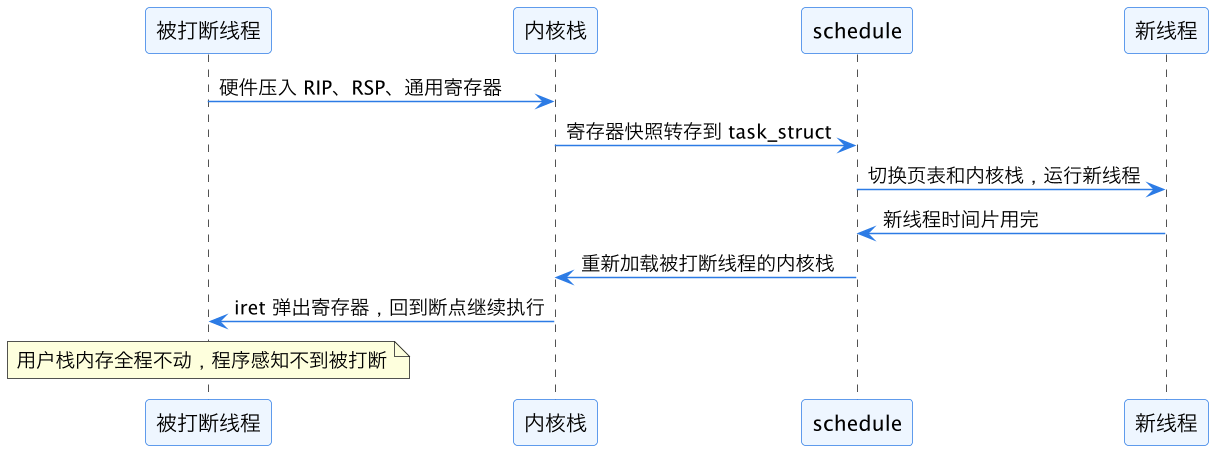
整条链路里只有两次真正的「搬运」:硬件压栈一次、iret 弹出一次;中间的 schedule 只是把指向这份快照的指针登记到 task_struct 里。用户栈那几 MB 数据从头到尾没被碰过。
三、特殊情况:中断发生时,线程正在内核态运行
- 此时CPU已经在内核空间,RSP指向内核栈,用户态RSP、RIP早就存在内核栈里面了(之前陷入内核的时候保存的);
- 时钟中断只会打断当前内核执行流,再次把内核态的寄存器现场压入内核栈内层;
- 内核标记需要调度,切换线程;
- 恢复的时候:先恢复内核态上下文,等内核代码执行完毕,准备返回用户态时,再取出最开始保存的用户态RSP、RIP,恢复用户调用栈执行。
也就是说:
内核栈是分层存放的:
内核栈顶层:中断时候保存的内核态现场
内核栈下层:系统调用陷入时保存的用户态完整现场(RIP/RSP/全部通用寄存器)
不管多少次中断嵌套,用户态那一份现场始终保存在内核栈固定位置,不会丢失。
把内核栈的分层结构画出来更直观——它就是一个严格的「后进先出」,恢复顺序和压栈顺序完全镜像:
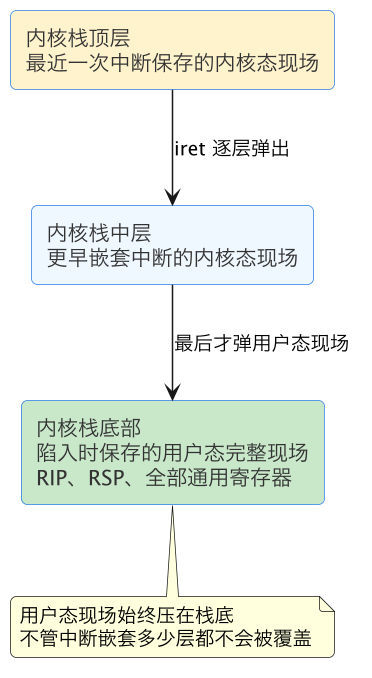
这也解释了为什么嵌套中断不会搞丢用户态现场:每一层中断只在自己那一格栈帧上读写,最底下的用户态快照从陷入那一刻起就没有人动过。
四、极易混淆的两个点
- 上下文切换保存的是寄存器快照,不是用户栈内存拷贝
用户栈很大几MB,不可能每次切换都拷贝。只保存RSP指针即可,用户栈位于进程虚拟地址空间,切换页表之后地址依然有效,数据不变。
- syscall主动陷入 和 硬件中断抢占,二者保存用户态现场的机制完全相同
唯一区别:主动陷入是线程自愿放弃CPU;中断是硬件强制抢占,但是现场保存、恢复的硬件流程一模一样,程序层面无差别。
五、极简总结
- 用户态调用栈、函数执行序列:常驻进程用户虚拟栈内存,全程不动;
- 中断强行打断CPU时,硬件把断点地址RIP、用户栈指针RSP、所有通用寄存器,存入当前线程内核栈;
- schedule切换线程时,把内核栈里这份寄存器快照存入task_struct;
- 线程重新调度:恢复内核栈 → 硬件指令恢复RIP+RSP,程序回到被打断位置,调用链路完整保留;
- 多次中断嵌套只会在内核栈叠加保存内核现场,底层保存的用户态现场一直保留不变。
如果你需要,我可以画一张PlantUML:中断打断用户态执行→内核栈保存现场→线程切换→恢复执行完整时序图。
完全正确,你总结得非常精准,两点全部命中:
1、陷入过程(syscall / 硬件中断打断用户态)
CPU硬件自动完成,不需要内核代码插手
CPU检测到中断/系统调用指令之后,硬件自动执行一套固定动作:
- 把用户态所有通用寄存器、RIP(断点指令地址)、RSP(用户栈指针)依次压入当前线程的内核栈;
- 切换RSP到内核栈栈顶;
- 切换特权级,跳转到内核预设的入口地址。
整个压栈动作是CPU电路硬逻辑,内核汇编入口只在这之后才开始执行。
2、返回过程(iret / sysret 指令)同样是CPU硬件自动完成弹出
内核最后执行 iretq 或者 sysret 指令,这条指令也是硬件指令:
CPU自动从当前内核栈顶部,依次弹出之前保存的:RIP、RSP、段寄存器、全部通用寄存器;
硬件自动恢复特权级回到用户态,指令指针跳转到保存的RIP地址,继续执行被打断的代码。
内核只负责调用这条指令,数据弹出的全过程依然是CPU硬件自动完成。
补充一个细节,区分两种场景的细微差别
1)时钟中断(iretq指令返回)
中断进入时CPU完整保存全部寄存器到内核栈;退出执行iretq,硬件严格按照压栈顺序全部弹出,现场完整还原。
2)syscall系统调用陷入(sysret/sysretq)
syscall指令是x86_64专门优化的快速指令,硬件保存的寄存器数量略少一些,但核心的RIP、RSP依然由硬件自动存入内核栈;返回sysret同样硬件自动恢复寄存器。
两条路径的差异浓缩成一张对照表:
| 维度 | 时钟中断(被动陷入) | syscall(主动陷入) |
|---|---|---|
| 触发方 | 硬件定时器强制打断 | 线程自愿执行 syscall 指令 |
| 现场保存位置 | 当前线程内核栈 | 当前线程内核栈 |
| 硬件保存寄存器数量 | 完整全套 | 略少(快速路径优化) |
| 返回指令 | iretq | sysret / sysretq |
| 压栈、弹出执行者 | CPU 硬件电路 | CPU 硬件电路 |
可以看到,除了「谁发起的」和「保存几个寄存器」,其余环节两条路径完全一致——都是硬件干重活。
再提炼一句核心:
内核栈上用户态现场的入栈、出栈,都是CPU硬件行为;
内核软件只负责:提供一块内核栈内存地址、最后触发一条返回指令而已。
线程被中断抢占之后能无缝恢复执行,本质就是CPU这套自动保存/恢复寄存器的硬件机制。
硬件和内核软件的分工边界,用一张图收个尾:
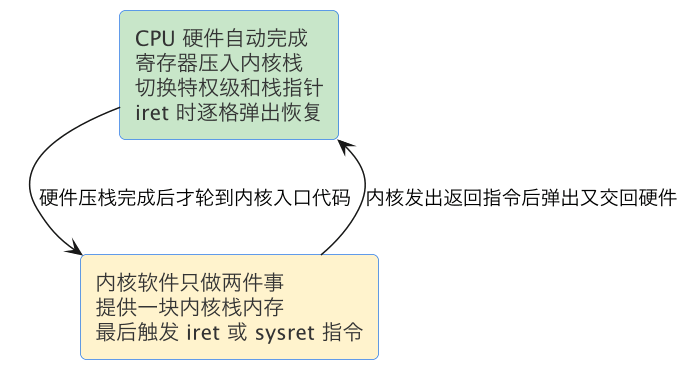
判断某一步归谁管,就看这张图:凡涉及「寄存器进栈出栈、特权级切换」的,全是硬件;内核在这件事上的全部职责只是备好内存、发一条指令。
额外一点:如果打断发生在内核态呢?
当CPU已经在内核栈运行时,再次来了中断:
CPU只会把当前内核态的寄存器现场压入内核栈(继续往下压栈);
而更早之前保存的那一份用户态RSP、RIP,还留在内核栈底部,不会被覆盖。
等所有中断处理完毕,一层层iret弹出内核现场,最后才会弹出最底层的用户态现场,回到用户程序。
参考文档
- context-switch:上下文切换总览
- interrupts:中断处理机制
- syscall-details:系统调用深入细节
总结
线程被中断/系统调用后能无缝恢复,本质是 CPU 硬件自动保存/恢复寄存器,内核软件只负责「提供一块内核栈 + 最后触发一条返回指令」:中断进入(iretq 返回)时硬件把全套寄存器压入内核栈、退出严格按序弹出;syscall(sysret 返回)是 x86_64 的快速路径,硬件保存的寄存器略少但 RIP/RSP 仍自动入栈。若中断发生在内核态,硬件只把当前内核态现场继续往下压,更早保存的用户态 RSP/RIP 留在栈底不被覆盖,等一层层 iret 弹出内核现场后,最后才弹出最底层的用户态现场回到用户程序——靠的就是这套硬件压栈/出栈机制保证现场完整。