CPU 乱序执行(Out-of-Order Execution)—— 核内怎么跑得快,以及它为什么不是内存重排
承 reordering-overview 的"第2层"。上一篇把"重排"拆成三层并反复强调:CPU 乱序执行 ≠ 内存重排。本篇是乱序执行这一层的导读:一句话定位 + 三线速览(为什么要乱序 / 怎么做到乱序又不出错 / 和内存重排的边界在哪)+ 三篇速览 + 关系导航。
一句话定位:乱序执行是"单核性能引擎",回答的是"CPU 怎么把执行端口喂满、别让一条慢指令堵死流水线";它不是"多核顺序对不对"的话题(那是 memory-reordering)。 前置最好先读 reordering-overview 建立三层框架。
本篇也是微架构演进链的"④乱序执行"环节(上游:流水线→超标量 加宽了硬件却喂不饱,才需要乱序找并行)——整条链的导读见 cpu-microarch-overview。
一句话认知
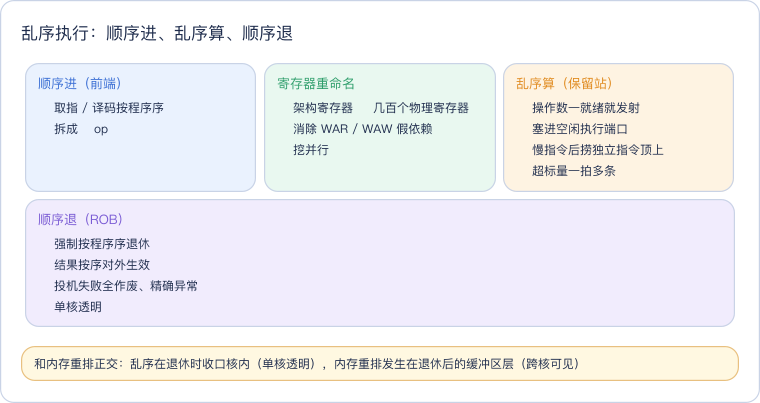
乱序执行 = 谁的操作数先就绪,谁就先执行,别让程序序绑死执行顺序——用"找出并行"掩盖"个别指令的长延迟"。 它的正确性靠"顺序进、乱序算、顺序退"的三明治结构保证:前端顺序取指译码、中间保留站按就绪竞争发射、后端 ROB 强制按程序序退休。乱序的乱序在退休时被收口在核内,所以单核完全透明;内存重排发生在退休之后的缓冲区层,跨核可见——两者是正交的两件事。
三线速览
线一:为什么要乱序(ooo-mechanism)
顺序执行(in-order)的致命问题:指令必须按程序序一条条来,前一条没完,后一条即使数据齐了也得干等。 一条 load miss 要等内存 200+ 拍,后面两条早已数据就绪的 add 却只能陪着干等——流水线被一条慢指令整个堵死。乱序执行就是为此而生:谁的操作数先就绪,谁就先执行,把"数据齐了的独立指令"不断从后面捞出来塞进空闲执行端口,把 IPC 顶上去。
线二:怎么做到乱序又不出错(ooo-mechanism 五大部件 / ooo-renaming-retirement)
乱序不是"随便乱跑",而是"顺序进、乱序算、顺序退"的三明治结构,五大部件各司其职:
| 部件 | 作用 | 关键点 |
|---|---|---|
| 取指/译码 | 按程序序取指令、拆 µop | 前端 in-order(顺序进) |
| 寄存器重命名 | 架构寄存器 → 几百个物理寄存器 | 消除假依赖(WAR/WAW)挖并行(register-renaming) |
| 保留站/调度器 | 操作数一就绪就发射到空闲端口 | 乱序的发生地(reservation-station) |
| 执行端口 | 多个 ALU、load/store 单元并行 | 超标量:一拍执行多条(lsu) |
| 重排序缓冲 ROB | 强制按程序序退休(commit) | 乱序的收口:结果按序对外生效(rob) |
两个关键细节:寄存器重命名把 ③ add rax, rcx 里那个和 ① 抢名字的 rax 映射到不同物理寄存器——假依赖消失、指令能并行;顺序退休保证算完的结果暂存 ROB、按程序原顺序对外生效,配合投机执行(猜错全作废)和精确异常(停在出错点),单核程序无论如何都察觉不到自己被乱序了。
线三:和内存重排的边界在哪(ooo-boundary)
这是本篇最想澄清的一点。乱序执行和内存重排只在"访存投机重排"处擦边:
- 纯核内乱序(左):算术/分支的乱序——永远单核透明,与内存序无关,是乱序的主体。
- 交集(中):乱序引擎把 load 提前执行(像 LoadLoad),但 x86 承诺 TSO——发现提前读的行被别核改了就触发 machine-clear 清空重放,程序员基本看不到。
- 纯内存重排(右):store buffer 的 StoreLoad——没有乱序引擎的顺序核也会有,证明主因是缓冲区、不是 OoO。
一句话边界:乱序执行的乱序在退休时被收口在核内(单核透明);内存重排发生在退休之后的缓冲区层(跨核可见)。把它们当同义词是根本性的概念混淆。
三篇速览
| 子篇 | 内容 | 外部引用锚点 |
|---|---|---|
| ooo-mechanism | 动机:load miss 堵死流水线 + 五大部件三明治结构"顺序进·乱序算·顺序退" | rob / reservation-station 的"五大部件"引用 |
| ooo-renaming-retirement | 寄存器重命名:假依赖例子 + 架构→物理寄存器映射 + 真/假依赖;顺序退休:序列图 + 投机执行 + 精确异常 + 单核透明 | register-renaming 的 §三、branch-prediction / cpu-microarch-overview 的"顺序退休"引用 |
| ooo-boundary | 三块交集图(纯核内/访存投机/纯内存重排)+ 判断表 + perf 四指标观测 | — |
和本仓库其他文档的关系
- 导读:reordering-overview——三层重排框架,本篇是其"第2层"的展开。
- 正交话题:memory-reordering(第3层:四种内存重排)、store-buffer/invalidate-queue(内存重排的成因部件)——本篇反复强调它们和乱序执行不是一回事。
- 延迟数据:cache-organization 第十一节 的周期表(乱序要掩盖的正是那些几百拍的 miss 延迟)。
- 应用:atomic(原子操作的开销与争用)。
- 数据冒险:data-hazards——乱序执行是数据冒险的主要硬件解法:RS 绕过阻塞的 µop 发射其他就绪的,L1 miss 窗口内靠 MLP 并行发出多条 miss。
- 纵切面走读:uop-pipeline-walkthrough——乱序执行从取指到退休的完整 µop 级走读,涵盖 RS/ROB/PRF 的协作时序。
- 微架构演进链:cpu-microarch-overview——本篇是"④乱序执行"环节;上游 pipelining-superscalar(加宽喂不饱)、下游 branch-prediction(投机执行的方向盘)。
总结
CPU 乱序执行是单核性能引擎:前端顺序取指、中间靠寄存器重命名消假依赖+保留站按就绪乱序发射、后端靠 ROB 顺序退休——"顺序进、乱序算、顺序退",配合投机执行掩盖长延迟,让 IPC 冲高。关键在"顺序退休"把乱序收口在核内,所以单核完全透明。它和内存重排只在"访存投机重排"处擦边,且 x86 用 machine-clear 把这点擦边也抹平了——乱序执行管"跑得快"、内存重排管"多核对不对",是正交的两件事,别混。三个子篇各讲一条线:为什么乱序(ooo-mechanism)、怎么不出错(ooo-renaming-retirement)、边界在哪怎么看(ooo-boundary)。