perf 的原理 —— 从 PMU 采样到数据落盘,以及 libperf
这篇文档是做什么的
perf 讲 perf 怎么用(命令、火焰图、常见坑)。本篇讲它怎么工作:
perf_events内核子系统的结构、PMU 硬件怎么采样、采样数据经由一个共享内存环形缓冲区从内核流到用户态、perf record又怎么把它写进perf.data,以及用 libperf 直接编程操作这套机制。
一句话定位:perf 不是一个"轮询读计数器"的工具,而是"内核 PMU 采样 → mmap 环形缓冲区 → 用户态搬运落盘"的一条流水线。 看懂这条流水线,才理解为什么 perf 开销低、为什么会丢样本(LOST records)、为什么要调
-m缓冲区大小。
可以回答什么问题
| 问题 | 答案在哪 |
|---|---|
| perf 为什么开销比 strace 低那么多? | §一、§三——基于 PMU 中断采样 + mmap 零拷贝,不像 ptrace 每个 syscall 两次上下文切换 |
perf record 里数据怎么从内核传到用户态? | §三——mmap 环形缓冲区,内核写、用户读,共享内存零拷贝 |
为什么 perf record 会丢样本(LOST records)? | §三——环形缓冲区满了而用户态来不及读,调大 -m |
perf.data 文件里存了什么格式? | §四——文件头和采样记录的二进制结构 |
| 怎么在自己的程序里嵌入 perf 能力? | §五——libperf API 编程:perf_evsel/perf_evlist/perf_mmap |
perf stat 和 perf record 的实现有什么不同? | §二——计数模式 vs 采样模式,前者只读 PMU 计数器值 |
一、全景:三个角色,一条数据流
perf 的核心是内核的 perf_events(也叫 perf subsystem)。一次 perf record 涉及三个角色:
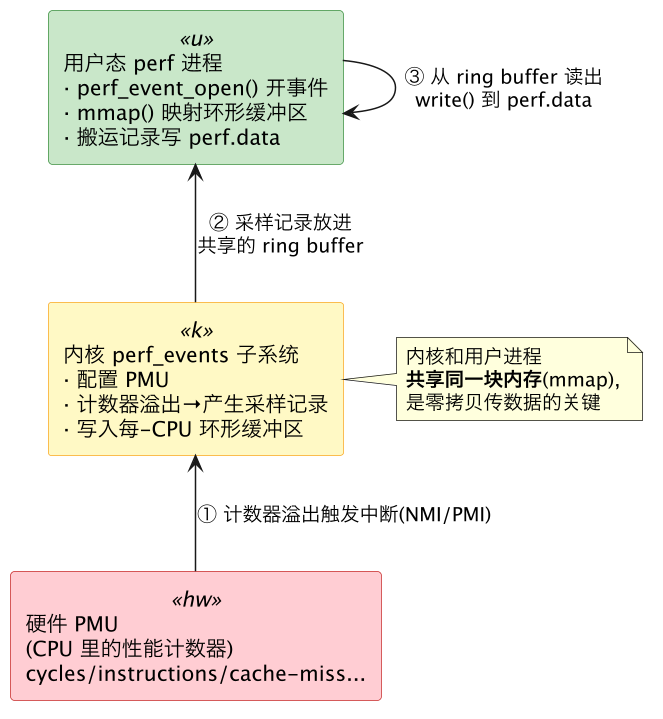
- 硬件 PMU:CPU 芯片里的一组特殊寄存器,能计数 cycles、instructions、cache-miss、branch-miss 等微架构事件(见 cpu-microarch-overview)。
- 内核
perf_events:配置 PMU、在计数器溢出时抓一份现场(指令指针、调用栈、时间戳……)、写进环形缓冲区。 - 用户态 perf:通过
perf_event_open开事件、mmap映射缓冲区、把记录搬到perf.data。
二、入口:perf_event_open(2) 这一个系统调用
整套机制的唯一内核入口是 perf_event_open(2)——perf 命令、libperf、任何自研工具,最终都调它:
int perf_event_open(struct perf_event_attr *attr,  // 事件配置:什么事件、采样周期、记录哪些字段
                    pid_t pid,    // 监控哪个进程(-1=不限,配合 cpu 用于全系统)
                    int cpu,      // 监控哪个 CPU(-1=跟着进程跑到哪算哪)
                    int group_fd, // 事件分组(多个事件同步采样)
                    unsigned long flags);
// 返回一个 fd —— 之后所有操作(mmap/read/ioctl/poll)都针对这个 fd
关键在 struct perf_event_attr,它决定了这个事件是什么、怎么采:
| 字段 | 作用 |
|---|---|
type / config | 事件类型(PERF_TYPE_HARDWARE/SOFTWARE/TRACEPOINT…)和具体事件(cycles/instructions…) |
sample_period / sample_freq | 采样触发条件:每 N 个事件采一次(period),或每秒采 F 次(freq,perf -F) |
sample_type | 每份样本记录哪些字段:IP(指令指针)、TID、TIME、CALLCHAIN(调用栈)、ADDR… |
read_format | read() 读计数值时的格式 |
| 各种 bit | disabled(先关着等 enable)、exclude_kernel/user、mmap(记录内存映射,事后解析符号用)… |
perf stat(只读计数,不采样)和perf record(采样落盘)的区别,本质就是perf_event_attr配不配sample_period——stat 是"结束时read()读累计值",record 是"溢出就抓一份样本"。
三、两种模式:计数(counting) vs 采样(sampling)
perf_events 对每个事件有两种工作方式,理解它俩的分野是理解 perf 的关键:
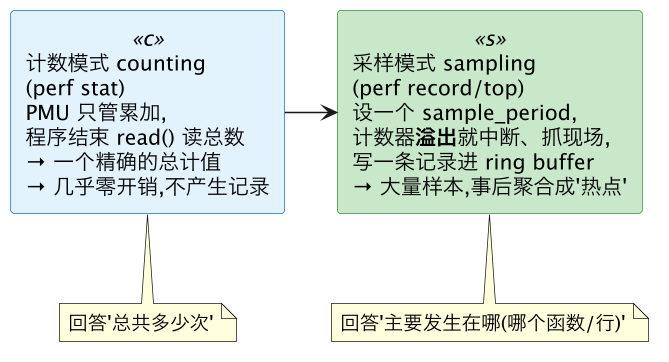
- 计数模式(
perf stat):PMU 计数器一路累加,程序结束时用read(fd)读出总数。不产生任何样本记录,开销极低,给的是精确总计(IPC、cache-miss 总数)。 - 采样模式(
perf record/perf top):给计数器设一个初值,每发生一个事件递减(或递增到阈值),溢出时触发一次中断(PMI,Performance Monitoring Interrupt,走 NMI),内核在中断里抓一份现场(当前 IP、调用栈、时间戳等),组成一条记录(record) 写进环形缓冲区。事后按记录聚合出热点。
采样的两种触发口径(对应 perf -c 和 perf -F):
sample_period = N:每 N 个事件采一次(如每 100 万条 cycles 采一次)。sample_freq = F:内核动态调整 period,让实际采样率≈每秒 F 次(-F 999)——更直观,perf 默认用这个。
四、核心机制:mmap 环形缓冲区(内核↔用户零拷贝)
这是整个 perf 最精妙的部分,也是"抓数据"的核心。内核不能每采一个样本就系统调用通知用户态——那太慢。解法是共享内存环形缓冲区:
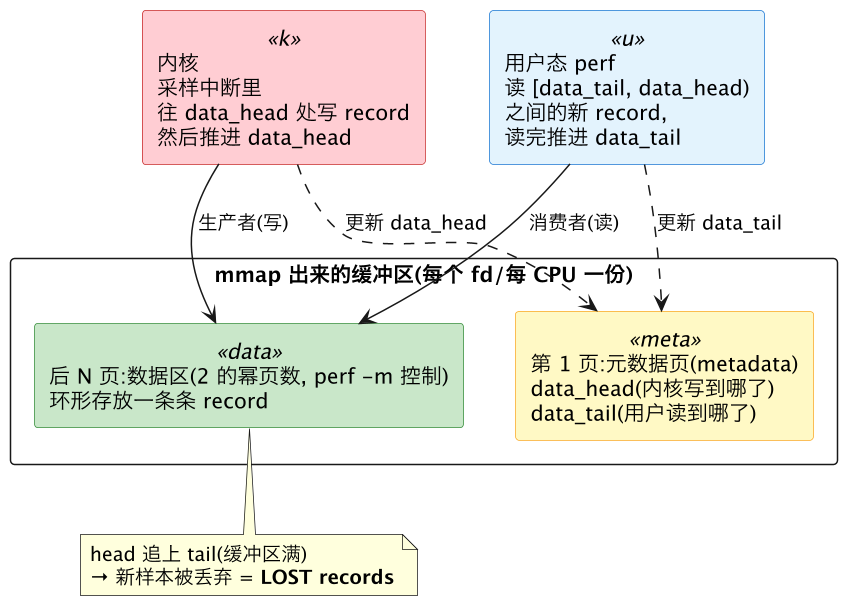
工作原理:
- 用户态
mmap(fd, ...)把内核为这个事件分配的缓冲区映射进自己地址空间——内核和用户进程从此共享同一块物理内存。 - 缓冲区第一页是元数据页,含两个关键指针:
data_head(内核已写到的位置,只增)、data_tail(用户已读到的位置)。 - 内核是生产者:采样中断里,把新 record 写在
data_head处,推进data_head。全程不做系统调用、不拷贝——直接写共享内存。 - 用户态是消费者:perf 读
[data_tail, data_head)之间的新记录,读完把data_tail推上去,腾出空间。 - 环形:写到缓冲区末尾就绕回开头。若内核写得太快、
data_head追上还没读的data_tail(缓冲区满)——新样本直接丢弃,产生一条LOST记录。
这解释了 perf 的几个现象:① 为什么开销低——采样期间内核只写共享内存,用户态批量搬运,没有逐样本的系统调用;② 为什么会 丢样本(
perf report里的LOST警告)——缓冲区满了;③ 为什么perf record -m(--mmap-pages)调大缓冲区能减少丢样本(代价是占更多内存)。
五、数据怎么写到磁盘:perf record 的落盘流程
perf record 就是那个"消费者",它把 ring buffer 里的记录搬到 perf.data 文件。完整流程:
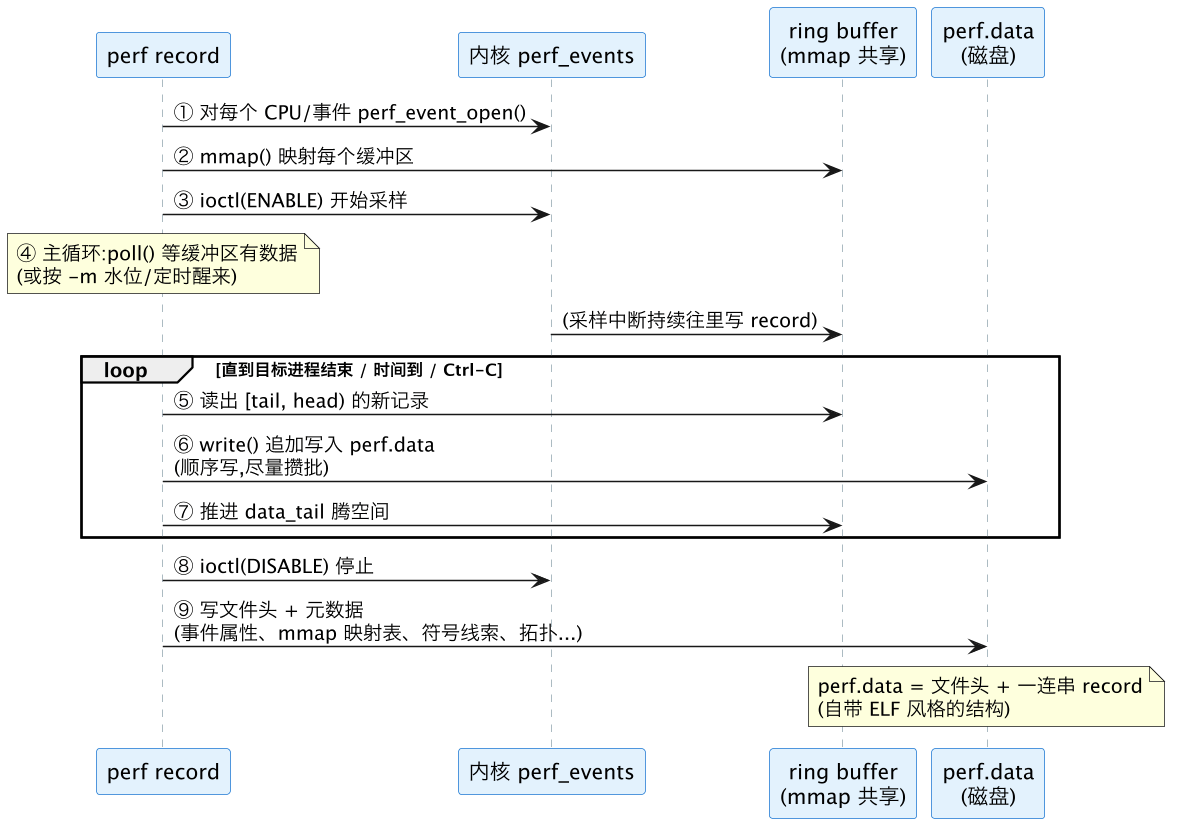
几个要点:
- 每个 CPU 一个缓冲区:全系统采样(
-a)时,perf 为每个 CPU 各开一份事件+缓冲区,用一个线程/poll 循环轮着搬——避免跨 CPU 争抢。 - 顺序追加写:perf.data 是顺序写的日志式文件,perf 尽量攒批
write()(减少系统调用),所以采样期磁盘是顺序 IO(见 ../disk/iostat)。 perf.data里有什么:文件头 + 一连串 record。record 不只有采样样本(PERF_RECORD_SAMPLE),还有PERF_RECORD_MMAP(进程加载了哪些 .so 到哪个地址——事后把 IP 翻译成"哪个库的哪个函数"全靠它,见 memory-layout)、PERF_RECORD_COMM(进程名)、PERF_RECORD_FORK/EXIT、PERF_RECORD_LOST(丢了多少样本)等。- 符号解析是事后的:采样时只存地址(省开销);
perf report时才拿MMAP记录 + 磁盘上的 ELF/debuginfo,把地址翻译成函数名和行号(见 perf 的-g/DWARF 坑、nm)。这就是为什么采样对象在 report 前不能被删/重编译,否则符号对不上。
低开销落盘的进阶:perf record 的 --aio / Zstd 压缩 / perf.data.d 分目录——大数据量或高频采样时,perf 支持异步 IO 和压缩,进一步降低搬运对被测程序的干扰。
六、libperf:直接编程操作这套机制
perf_event_open 是裸系统调用,直接用很繁琐(要自己管 attr、mmap、ring buffer 指针、record 解析)。libperf 是内核源码树里提供的一个 C 库(tools/lib/perf/),把这些封装成对象,让你在自己的程序里做采样/计数。
核心对象模型:
| libperf 对象 | 对应概念 |
|---|---|
struct perf_evsel | 一个事件(event selector)——封装 perf_event_attr + 各 CPU/线程的 fd |
struct perf_evlist | 一组事件的列表 + 统一的 mmap 缓冲区管理、poll 循环 |
struct perf_cpu_map | 要监控的 CPU 集合 |
struct perf_thread_map | 要监控的线程集合 |
struct perf_mmap | 封装那个环形缓冲区,提供 perf_mmap__read_event() 迭代读记录 |
计数模式(最简,类似 perf stat)骨架:
#include <perf/evsel.h>
#include <perf/cpumap.h>
#include <linux/perf_event.h>
struct perf_event_attr attr = {
    .type   = PERF_TYPE_HARDWARE,
    .config = PERF_COUNT_HW_INSTRUCTIONS,   // 数指令数
};
struct perf_cpu_map *cpus = perf_cpu_map__new(NULL);   // 所有 CPU
struct perf_evsel *evsel  = perf_evsel__new(&attr);
perf_evsel__open(evsel, cpus, NULL);   // 底层就是 perf_event_open()
perf_evsel__enable(evsel);             // ioctl(ENABLE)
/* ... 让被测负载跑一会儿 ... */
perf_evsel__disable(evsel);
struct perf_counts_values counts;
perf_evsel__read(evsel, 0, 0, &counts);  // read(fd)
printf("instructions = %llu\n", counts.val);
perf_evsel__close(evsel);
perf_evsel__delete(evsel);
perf_cpu_map__put(cpus);采样模式则多了 perf_evlist__mmap()(映射环形缓冲区)+ 轮询读记录:
// 采样骨架(伪代码,省错误处理)
struct perf_evlist *evlist = perf_evlist__new();
perf_evlist__add(evlist, evsel);
perf_evlist__set_maps(evlist, cpus, threads);
perf_evlist__open(evlist);
perf_evlist__mmap(evlist, 4);          // 每缓冲区 4 页,对应 perf record -m 4
perf_evlist__enable(evlist);
// 轮询:遍历每个 mmap 缓冲区,把 record 一条条读出来
struct perf_mmap *map;
perf_evlist__for_each_mmap(evlist, map, false) {
    if (perf_mmap__read_init(map) < 0) continue;
    union perf_event *event;
    while ((event = perf_mmap__read_event(map)) != NULL) {
        // event->header.type == PERF_RECORD_SAMPLE ...
        // 这里你自己决定:落盘?实时聚合?——perf record 就是在这写 perf.data
        perf_mmap__consume(map);       // 推进 data_tail
    }
    perf_mmap__read_done(map);
}
perf record本质就是上面这段循环 + 把 recordwrite()到 perf.data。 用 libperf 你可以改成"实时聚合成直方图""喂给自己的可视化""只在某条件下落盘"——这也是 BCC/bpftrace 之外做自定义性能工具的一条路。编译时链接内核源码树里 build 出的libperf.a/libperf.so(make -C tools/lib/perf)。
七、通过 perf 可观测的关键微架构指标
| 指标 | 英文 | perf stat 事件 | 含义 |
|---|---|---|---|
| 每周期指令数 | IPC | instructions,cycles | IPC < 0.5 → 流水线停滞严重 |
| 前端 stall | Frontend Stalls | stalled-cycles-frontend | 指令获取瓶颈(分支预测失败/ICache miss) |
| 后端 stall | Backend Stalls | stalled-cycles-backend | 数据/内存瓶颈(等待数据) |
| 缓存未命中率 | Cache Miss Rate | cache-misses,cache-references | Miss > 3% → 数据布局/局部性问题 |
| L1 数据缓存 | L1D Cache | L1-dcache-loads,L1-dcache-load-misses | L1 miss → 数据太大或步长太大 |
| 最后一级缓存 | LLC | LLC-loads,LLC-load-misses | LLC miss → 内存访问无法缓存 |
| 分支预测失败率 | Branch Miss | branch-misses,branches | > 1% → 分支太随机 |
| TLB 未命中 | dTLB Miss | dTLB-loads,dTLB-load-misses | 工作集分散 → 大页降 TLB miss |
| 上下文切换 | Context Switches | context-switches | 多 → 线程过多/频繁阻塞 |
| 核间迁移 | CPU Migrations | migrations | 多 → 调度器频繁搬 task |
| 缺页 | Page Faults | page-faults(major/minor) | major 多 → swap/mmap 磁盘 IO |
八、和本仓库其他文档的关系
- 用法:perf(record/report/stat/火焰图/常见坑)——本篇是它的"原理版",遇到"为什么丢样本、为什么要 -m、为什么符号对不上"回本篇。
- PMU 数的是什么:cpu-microarch-overview(cycles/IPC)、branch-prediction(branch-misses)、tlb(dTLB miss)、mesi(cache-miss/c2c)——perf 采的就是这些事件。
- 符号解析:memory-layout(IP→哪个段/库)、nm(符号表)、elf-format——
PERF_RECORD_MMAP+ ELF 才能把地址翻译成函数。 - 落盘 IO:iostat(perf.data 是顺序写)。
- 权限:
kernel.perf_event_paranoid、容器 capability——见 perf 的坑。
八、一句话总结
perf 的原理是一条流水线:唯一入口
perf_event_open(2)配置硬件 PMU;计数模式(perf stat)只累加、结束 read() 读总数;采样模式(perf record)给计数器设周期、溢出触发 PMI 中断抓现场(IP/调用栈/时间戳)写成 record。核心是内核与用户态 mmap 共享的每-CPU 环形缓冲区——内核当生产者往 data_head 写、perf 当消费者从 data_tail 读,零拷贝、无逐样本系统调用(所以开销低);缓冲区满就丢样本(LOST,靠 -m 调大缓解)。perf record 就是那个消费者:poll 循环把 record 顺序 write() 进 perf.data(内含采样样本 + MMAP 映射表等,符号事后靠 ELF 解析)。libperf 把 evsel/evlist/mmap 封装成对象,让你用几十行 C 复刻 perf stat/record 或做自定义性能工具。