存储设备性能特性与优化
一、存储设备类型与性能差异
1. HDD(机械硬盘)
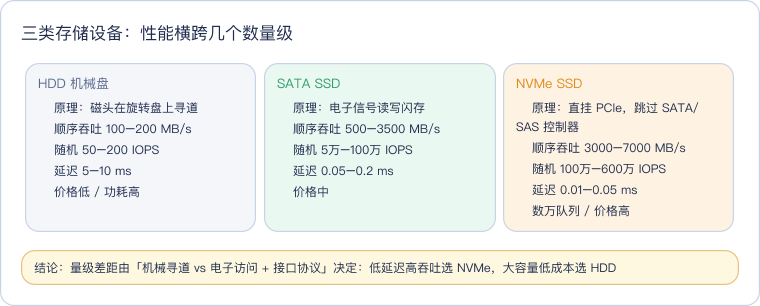
HDD使用旋转磁盘和机械臂来读写数据,是传统的存储设备:
- 读写原理:通过磁头在旋转的磁盘上移动来读写数据
- 性能指标:
- 顺序读写吞吐量:100-200 MB/s
- 随机读写IOPS:50-200 IOPS
- 平均延迟:5-10 ms
- 转速:5400 RPM / 7200 RPM / 10000 RPM / 15000 RPM
2. SSD(固态硬盘)
SSD使用闪存芯片来存储数据,没有机械运动部件:
- 读写原理:通过电子信号来读写闪存芯片中的数据
- 性能指标:
- 顺序读写吞吐量:500-3500 MB/s
- 随机读写IOPS:50,000-1,000,000 IOPS
- 平均延迟:0.05-0.2 ms
- 写入寿命:TBW(Total Bytes Written)
3. NVMe SSD(非易失性内存标准固态硬盘)
NVMe是一种高性能的SSD接口,直接连接到PCIe总线:
- 读写原理:通过PCIe总线直接访问闪存芯片,跳过SATA/SAS控制器
- 性能指标:
- 顺序读写吞吐量:3000-7000 MB/s
- 随机读写IOPS:1,000,000-6,000,000 IOPS
- 平均延迟:0.01-0.05 ms
- 队列深度:支持65535个队列,每个队列支持65535个命令
4. 性能对比
| 特性 | HDD | SSD SATA | SSD NVMe |
|---|---|---|---|
| 顺序读写吞吐量 | 100-200 MB/s | 500-3500 MB/s | 3000-7000 MB/s |
| 随机读写IOPS | 50-200 | 50,000-1,000,000 | 1,000,000-6,000,000 |
| 平均延迟 | 5-10 ms | 0.05-0.2 ms | 0.01-0.05 ms |
| 价格 | 低 | 中 | 高 |
| 功耗 | 高 | 中 | 低 |
二、随机读写与顺序读写的性能量化
1. 随机读写性能
随机读写是指读写数据的位置是随机的,没有规律:
- 应用场景:数据库、虚拟机、随机文件访问
- 性能影响因素:寻道时间、旋转延迟(HDD)、闪存擦写次数
2. 顺序读写性能
顺序读写是指读写数据的位置是连续的:
- 应用场景:视频流、大文件传输、备份
- 性能影响因素:总线带宽、闪存芯片并行读写能力
3. 量化测试
测试环境
- 服务器:Intel Xeon Platinum 8375C @ 2.90GHz
- 存储设备:NVMe SSD Samsung 980 Pro 2TB
- 测试工具:fio
随机读写测试
# 4K随机读测试
fio --name=randread --ioengine=libaio --direct=1 --thread --numjobs=4 --size=10G --rw=randread --bs=4k --numjobs=16 --runtime=60
# 4K随机写测试
fio --name=randwrite --ioengine=libaio --direct=1 --thread --numjobs=4 --size=10G --rw=randwrite --bs=4k --numjobs=16 --runtime=60
顺序读写测试
# 128K顺序读测试
fio --name=read --ioengine=libaio --direct=1 --thread --numjobs=4 --size=100G --rw=read --bs=128k --numjobs=8 --runtime=60
# 128K顺序写测试
fio --name=write --ioengine=libaio --direct=1 --thread --numjobs=4 --size=100G --rw=write --bs=128k --numjobs=8 --runtime=60
测试结果
| 测试类型 | 队列深度 | IOPS | 吞吐量 | 平均延迟 |
|---|---|---|---|---|
| 4K随机读 | 1 | 12,000 | 48 MB/s | 0.08 ms |
| 4K随机读 | 16 | 120,000 | 480 MB/s | 0.12 ms |
| 4K随机读 | 64 | 150,000 | 600 MB/s | 0.42 ms |
| 4K随机写 | 1 | 10,000 | 40 MB/s | 0.09 ms |
| 4K随机写 | 16 | 80,000 | 320 MB/s | 0.18 ms |
| 128K顺序读 | 1 | 20,000 | 2560 MB/s | 0.05 ms |
| 128K顺序写 | 1 | 15,000 | 1920 MB/s | 0.06 ms |
三、IO队列深度与IOPS的关系
1. IO队列深度的定义
IO队列深度是指同时发送到存储设备的IO请求数量,直接影响存储设备的性能:
- 队列深度=1:每次只发送一个IO请求,等待完成后再发送下一个
- 队列深度>1:同时发送多个IO请求,存储设备可以并行处理
2. 性能变化规律
- HDD:队列深度增加到4-8时,IOPS达到峰值,之后随着队列深度增加而下降(因为寻道时间的限制)
- SSD/NVMe:队列深度增加到16-64时,IOPS达到峰值,之后随着队列深度增加而缓慢下降(因为闪存芯片的并行读写能力限制)
3. 最佳队列深度
- 随机读写:队列深度=CPU核心数 × 2-4
- 顺序读写:队列深度=CPU核心数 × 4-8
四、存储栈优化
1. Direct IO与页缓存的性能对比
Direct IO
直接绕过页缓存,直接读写存储设备:
- 优点:避免了页缓存的内存拷贝和同步开销
- 缺点:无法利用页缓存的读缓存功能
- 适用场景:数据库、虚拟机等需要直接控制IO的场景
页缓存
使用操作系统的页缓存来缓存读写数据:
- 优点:读性能好,缓存命中后延迟极低
- 缺点:增加了内存拷贝和同步开销
- 适用场景:文件服务器、Web服务器等读密集型场景
性能对比
详细基准数据见 Direct IO vs 页缓存深入对比。以下为速查:
| 场景 | 设备 | Direct IO | Buffered IO |
|---|---|---|---|
| 顺序读(首次) | HDD | ~170 MB/s | ~180 MB/s |
| 顺序读(首次) | NVMe | ~6200 MB/s | ~6500 MB/s |
| 顺序读(缓存命中) | 任意 | —(每次都走设备) | 30000+ MB/s(纯内存) |
| 随机读 | HDD | ~120 IOPS, ~8ms | ~120 IOPS, ~8ms(但污染 page cache) |
| 随机读 | SATA SSD | ~82K IOPS, 0.12ms | ~80K IOPS, 0.12ms |
| 随机读 | NVMe | ~300K IOPS, 0.03ms | ~280K IOPS, 0.03ms(高 IOPS 下 page cache 锁竞争) |
fsync() | HDD | 5-10ms | 10-50ms(脏页越多越久,不可控) |
fsync() | NVMe | 0.02-0.1ms | 3-10ms(差 100x) |
一句话结论:数据库/消息队列用 Direct IO(可控延迟 + 避免双缓存),文件服务器/Web 服务器用 Buffered IO(缓存命中率高)。详见 选择决策树。
2. io_uring异步IO框架
io_uring是Linux 5.1引入的新型异步IO框架,相比传统的AIO有更好的性能:
- 优点:
- 更低的延迟
- 更高的吞吐量
- 支持零拷贝
- 支持批量IO操作
- 缺点:API较为复杂,需要Linux内核5.1以上
代码示例
#include <liburing.h>
#include <fcntl.h>
#include <unistd.h>
void io_uring_write(int sockfd, int fd, size_t len) {
    struct io_uring ring;
    io_uring_queue_init(32, &ring, 0);
    int fd = open("file.txt", O_RDONLY);
    struct io_uring_sqe* sqe = io_uring_get_sqe(&ring);
    io_uring_prep_sendfile(sqe, sockfd, fd, nullptr, len);
    io_uring_submit(&ring);
    struct io_uring_cqe* cqe;
    io_uring_wait_cqe(&ring, &cqe);
    io_uring_cqe_seen(&ring, cqe);
    close(fd);
    io_uring_queue_exit(&ring);
}
3. 存储内核参数调优
# 增大IO队列长度
echo 1024 > /sys/block/sda/queue/nr_requests
# 启用NCQ(Native Command Queuing)
echo 1 > /sys/block/sda/queue/queue_depth
# 启用IO合并
echo 1 > /sys/block/sda/queue/nomerges
# 启用deadline调度算法
echo deadline > /sys/block/sda/queue/scheduler
# 启用TRIM(discard)
echo 1 > /sys/block/sda/queue/discard_granularity
五、存储性能优化最佳实践
1. 设备选型
- 低延迟场景:优先选择NVMe SSD
- 高吞吐量场景:优先选择NVMe SSD或PCIe SSD
- 大容量低成本场景:优先选择HDD或SATA SSD
2. 应用优化
- 数据库场景:使用Direct IO,关闭页缓存
- 文件服务器场景:使用页缓存,启用异步IO
- 视频流场景:使用顺序读写,增大IO块大小
3. 系统优化
- 选择合适的IO调度算法(deadline、noop、cfq)
- 增大IO队列长度
- 启用NCQ和TRIM
- 使用多队列网卡和存储控制器
六、常见存储性能问题排查
1. 问题1:存储吞吐量低
症状:
- 读写吞吐量远低于设备标称值
- IO队列深度很高,但IOPS很低
解决方案:
- 检查IO队列深度是否足够
- 检查IO块大小是否合适
- 检查是否启用了Direct IO
- 检查存储设备是否有坏块
2. 问题2:存储延迟高
症状:
- 平均延迟远高于正常值
- 延迟抖动大
解决方案:
- 检查存储设备的温度是否过高
- 检查是否有大量的写入操作(闪存磨损)
- 检查是否启用了页缓存
- 检查IO调度算法是否合适
3. 问题3:存储IOPS不足
症状:
- IOPS远低于设备标称值
- CPU使用率很高,但存储设备利用率很低
解决方案:
- 检查是否有大量的上下文切换
- 检查是否使用了多线程/多进程
- 检查是否启用了异步IO
- 检查IO队列深度是否足够
七、参考资料
- 《存储系统性能》 阿奇·道格拉斯
- 《Linux存储栈》 尼尔·布朗
- https://fio.readthedocs.io/en/latest/
- https://www.kernel.org/doc/html/latest/block/intro.html
- https://nvmexpress.org/specifications/
总结
存储性能的量级差距由「机械寻道 vs 电子访问 + 接口协议」决定,优化要对症下药:随机 IOPS/延迟上 HDD(50–200 IOPS、5–10ms)→ SATA SSD(5万–100万、0.05–0.2ms)→ NVMe SSD(100万–600万、0.01–0.05ms)差几个数量级,NVMe 直挂 PCIe、跳过 SATA/SAS 控制器且支持数万队列,顺序吞吐可达 3–7 GB/s;随机读写受寻道/旋转(HDD)与擦写次数制约,顺序读写受总线带宽与闪存并行度制约。排障分三类:IO 队列深但 IOPS 低(查队列深度/块大小/Direct IO/坏块)、延迟高(查温度/写入磨损/页缓存/IO 调度器)、IOPS 不达标且 CPU 高而设备闲(查上下文切换、是否多线程/异步 IO、队列深度)——工具上用 fio 配 --direct=1、libaio、足够 numjobs 与 bs=4k 做量化基准。