内存对齐对性能的影响 —— 为什么"地址是几的倍数"能决定快慢
cache-organization 讲了缓存以 64 字节 cache line 为单位搬运,mesi §5 讲了多核下变量挤在同一行的伪共享。本篇讲一个更基础、单线程也逃不掉的问题:数据放在什么地址(是不是 2/4/8/… 的倍数),直接影响访存要几次、会不会撕裂、能不能原子、SIMD 跑不跑得动。
"对齐"听起来是编译器的小事,实则贯穿性能与正确性:对齐的访问一次搞定,未对齐的访问可能拆成两次、甚至跨 cache line、甚至让原子操作失效。 本篇讲清对齐是什么、不对齐代价多大、结构体 padding 怎么来的、以及怎么用对齐提性能。
一、什么是对齐:地址必须是类型大小的整数倍
自然对齐(natural alignment):一个大小为 N 字节的类型,它的地址应当是 N 的整数倍。
| 类型 | 大小 | 要求地址是…的倍数 |
|---|---|---|
char | 1 | 1(任意地址都行) |
short | 2 | 2 |
int / float | 4 | 4 |
long / double / 指针(64位) | 8 | 8 |
SIMD __m128(SSE) | 16 | 16 |
SIMD __m256(AVX) | 32 | 32 |
- 一个
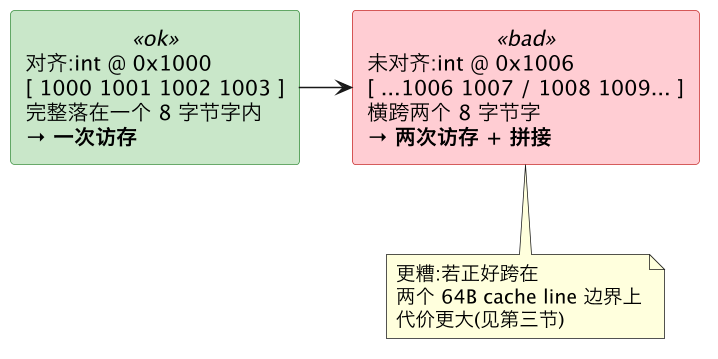
int放在地址0x1000(4 的倍数)= 对齐;放在0x1001= 未对齐(misaligned)。 - 为什么硬件想要对齐:内存/缓存是按固定宽度的块访问的(比如按 8 字节字、按 64B cache line)。一个对齐的 N 字节数据保证落在单个访问块内,一次取到;未对齐的则可能横跨两个块,得取两次再拼。
二、未对齐访问的代价:从"慢一点"到"直接崩"
未对齐访问的后果,取决于架构,分三档:
| 架构 | 未对齐访问的后果 |
|---|---|
| x86 / x86-64 | 允许,但慢:硬件自动拆成多次访存再拼,多花几拍;跨 cache line 时更明显 |
| 老 ARM / MIPS / SPARC | 直接崩:触发对齐错误异常(SIGBUS)——很多"移植到 ARM 就崩"的 bug 源于此 |
| 现代 ARMv8 | 普通访问大多允许,但特定指令(如 ldxr 独占、部分 SIMD)仍要求对齐 |
即便在最宽容的 x86 上,未对齐也不是免费的:
- 拆分访问:未对齐的读要发两次内存事务、再把两半拼起来,延迟和带宽都翻倍。
- 跨 cache line 撕裂(cache line split):最坏情况——数据正好跨在两条 64B cache line 的边界上,一次访问要碰两条 line,两条都可能各自 miss。这是未对齐里最贵的,有专门的性能计数器(第六节)。
- 跨页:更极端地跨在两个 4KB 页边界上,可能触发两次地址翻译(两次 TLB 查询,见 tlb),甚至一次 TLB miss。
一句话:x86 上未对齐"能跑但慢",跨 cache line/跨页时慢得明显;很多非 x86 架构上未对齐直接 SIGBUS。对齐的本质,是保证一次访存只碰一个访问块/一条 cache line。
三、对齐与原子性:未对齐会让原子操作失效
这是对齐最容易被忽视的正确性后果(不只是性能):
- 原子操作要求数据对齐。一个跨 cache line 的变量,硬件无法用一条指令原子地读写它(要碰两条 line,中间可能被别的核插入)——
std::atomic依赖对齐来保证原子性。 - x86 上,
lock前缀对对齐的数据走高效的缓存锁(锁一条 line);一旦数据跨 cache line,退化成古老而极慢的总线锁(bus lock)——锁住整条内存总线、几百上千拍,全核卡顿(见 atomic)。 - 所以
std::atomic<T>会自动保证 T 对齐;但你若手动用未对齐地址做原子操作、或#pragma pack压扁了原子成员,就可能踩到"原子性丢失"或"总线锁灾难"。
记住:对齐不仅是快慢问题,还是原子操作能否成立的前提。 跨 cache line 的原子操作在 x86 上会触发全核卡顿的总线锁,在别的架构上可能直接不原子。
四、结构体里的对齐:padding 是怎么冒出来的
编译器为了让每个成员都自然对齐,会在成员间插入填充字节(padding)。这就是"结构体大小 ≠ 成员大小之和"的原因:
struct Bad {
    char  a;    // 1 字节, 偏移 0
    // 3 字节 padding ← 为了让 int b 落在 4 的倍数
    int   b;    // 4 字节, 偏移 4
    char  c;    // 1 字节, 偏移 8
    // 7 字节 padding ← 为了让 double d 落在 8 的倍数
    double d;   // 8 字节, 偏移 16
};  // sizeof = 24(成员实际只用 14 字节,浪费 10 字节!)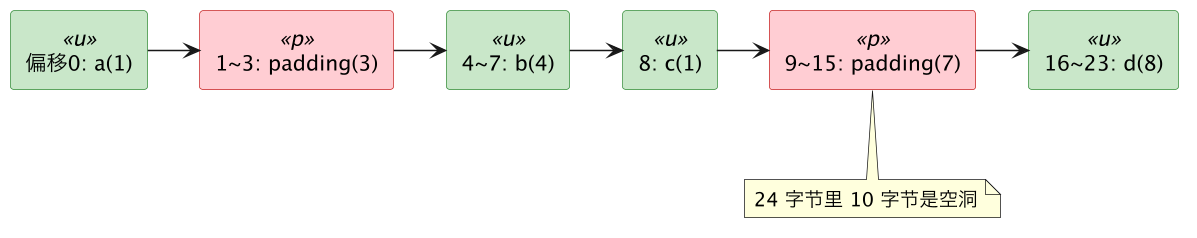
优化:按大小降序排列成员,把 padding 挤掉:
struct Good {
    double d;   // 8, 偏移 0
    int    b;   // 4, 偏移 8
    char   a;   // 1, 偏移 12
    char   c;   // 1, 偏移 13
    // 2 字节尾部 padding(让数组里下一个也对齐)
}; // sizeof = 16(省了 8 字节)为什么这对性能重要:
- 更小的结构体 = 更多能塞进一条 cache line = 更少 cache miss。一个数组里遍历
Good比Bad每条 cache line 能多装 50% 的元素。 - 热数据紧凑排布(把常一起访问的字段放一起、冷字段拆出去)能显著减少访存。这是 data-oriented design 的核心。
准则:结构体成员按大小从大到小排,能自然消掉大部分中间 padding。用
pahole工具能直接看结构体的空洞。
五、两种对齐目标:别和伪共享搞混
"对齐"在性能语境下其实有两个方向相反的目标,容易混:
| 目标 | 手段 | 场景 | |
|---|---|---|---|
| 紧凑对齐 | 让结构体更小、塞进更少 cache line | 成员按大小排序、消 padding | 单线程遍历大数组、省 cache/内存带宽 |
| cache line 隔离 | 让热点变量独占一行、别和别的挤一起 | alignas(64) 撑大、填充到 64B | 多核下防伪共享(见 mesi §5) |
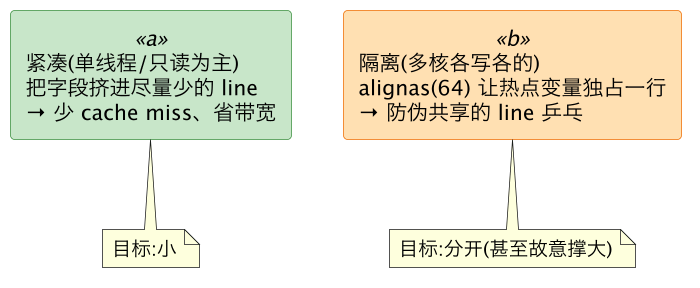
别用错方向:单线程遍历图省 cache 就要紧凑;多核各写各的热点变量就要隔离(撑大到独占 line)。同一个"对齐",两个相反的手法——判断依据是"这数据是单线程遍历、还是多核并发写"。多核伪共享的隔离手法详见 mesi §5,本篇不重复。
六、SIMD 对齐:向量化的硬门槛
SIMD(AVX/SSE,一条指令处理多份数据)对对齐尤其敏感:
- 对齐的加载/存储指令(
movaps/vmovaps)要求地址是 16/32/64 字节对齐,未对齐直接崩(GP fault)。 - 未对齐版本(
movups/vmovups)能跑但历史上更慢(现代 CPU 差距已小,但跨 cache line 仍有惩罚)。 - 想让编译器自动向量化你的循环,数据对齐是重要前提——
alignas(32) float buf[N];加对齐提示能让编译器放心用对齐指令。
数值计算/图像/ML 的热循环里,把数组对齐到 32/64 字节,是让 SIMD 满速的基本操作。
七、怎么观测和控制
控制对齐
alignas(64) int x;                    // C++11: 强制 x 对齐到 64
struct alignas(64) CacheLineAligned { long v; };  // 结构体对齐
_Alignas(16) float buf[4];            // C11
#pragma pack(1)   // ⚠️ 强制紧凑、取消 padding —— 慎用!
struct Packed { char a; int b; };     // sizeof=5,但 b 未对齐,访问变慢/在某些架构崩
#pragma pack()alignas是加对齐(提性能/满足 SIMD/防伪共享)。#pragma pack/__attribute__((packed))是取消对齐(省空间,如网络协议包、文件格式)——代价是未对齐访问,只在"省空间比速度重要"且"确定架构容忍未对齐"时用。
观测
# 看结构体的 padding 空洞(需要 -g 调试信息)
pahole ./cpu_demo | less           # 直接列出每个结构体的成员偏移和 padding
# perf 看跨 cache line 的未对齐访问惩罚(事件名因型号而异)
perf stat -e mem_inst_retired.split_loads,mem_inst_retired.split_stores ./app
#   split_loads/stores = 跨 cache line 被拆分的访存次数,高=有未对齐热点
perf list | grep -i "split\|misalign\|unalign"判据:split_loads/split_stores 高,说明有热点数据未对齐或跨 cache line,去查是不是 #pragma pack 压扁了、或数组元素大小不是 2 的幂导致错位。
八、和本仓库其他文档的关系
- 前置:cache-organization(cache line 64B、访存以行为单位——对齐的意义全从这来)。
- 多核伪共享:mesi §5(cache line 隔离防伪共享)——本篇第五节讲的"隔离"方向就指向它;本篇主讲单次访存的对齐代价 + 结构体布局,两者互补。
- 原子性:atomic(对齐是原子操作的前提;跨 line 触发总线锁)。
- 地址翻译:tlb(未对齐跨页 → 多次 TLB 查询)。
- 结构体在内存里的样子:memory-layout(数据段布局)。
- 观测:perf(split_loads 等事件)、
pahole。
九、一句话总结
内存对齐 = 让 N 字节数据落在 N 的倍数地址上,本质是保证"一次访存只碰一个块/一条 cache line"。未对齐的代价:x86 上拆成多次访存(跨 cache line/跨页更贵)、很多非 x86 架构直接 SIGBUS、还会让跨 line 的原子操作退化成全核卡顿的总线锁(正确性问题)。结构体里编译器插 padding 保证成员对齐,把成员按大小降序排能挤掉空洞、让结构体更小塞进更少 cache line。注意"对齐"有两个相反方向:单线程遍历要紧凑(省 cache)、多核并发写要隔离(alignas(64) 防伪共享)。SIMD 对齐是向量化硬门槛。用 alignas 加对齐、pahole 看空洞、perf 的 split_loads 抓未对齐热点。