ELF 格式详解 —— 可执行文件/库/core 的统一格式
ELF(Executable and Linkable Format)是 Linux 下可执行文件、目标文件(.o)、动态库(.so)、core dump 的统一格式。前面用到的 perf 读符号、gdb 解析 core、
strip/objcopy分离调试信息,底层都在操作 ELF 结构。吃透 ELF,符号问题、链接问题、core 分析才不会停留在"背命令"。
一、四种 ELF 文件类型
readelf -h 的 Type 字段区分:
| 类型 | 说明 | 例子 |
|---|---|---|
REL(ET_REL) | 可重定位目标文件 | .o、.a 里的成员,编译产物、还没链接 |
EXEC(ET_EXEC) | 传统可执行文件 | 固定加载地址的可执行程序 |
DYN(ET_DYN) | 共享库 / PIE 可执行文件 | .so;现代发行版默认 PIE,可执行文件也是 DYN |
CORE(ET_CORE) | 核心转储 | 崩溃产生的 core 文件 |
现代
gcc默认开 PIE(位置无关可执行),所以你的可执行文件readelf -h常看到Type: DYN而不是EXEC——这是正常的,不是编成了库。
二、整体布局:两种视角(ELF 最关键的概念)
理解 ELF,最容易卡住的地方就是:同一个文件,为什么有 Section 和 Segment 两套东西? 答案是——它们是同一份字节数据的两种"分组方式",服务于两个完全不同的场景:
- Section(节):给链接器和调试器用的。编译器/链接器需要把代码、数据、符号表、重定位信息、调试信息分门别类地精细管理,于是切成很多个用途单一的小块——
.text(代码)、.data(初始化数据)、.bss、.symtab(符号)、.debug_info(调试)…… 每块干一件事。 - Segment(段):给内核加载器和动态链接器用的。程序要跑起来时,内核不关心"这是符号表还是重定位表",它只关心一块连续内存应该有什么权限(可读?可写?可执行?)。于是把多个权限相同、需要一起加载的 Section 打包成一个 Segment,一次
mmap映射进内存。
下面这张概念卡把「同一份字节数据、两种分组方式」的分工一图收束:左半是 Section 按用途细切、服务链接与调试,右半是 Segment 按权限粗框、服务加载与运行,底部点出哪些内容只躺在文件里、不进内存。
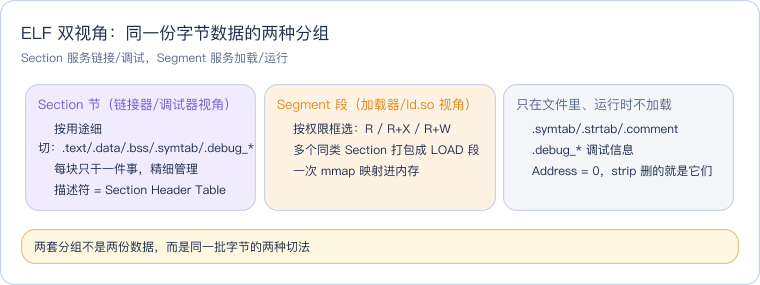
一张图看懂"同一份数据,两种分组"(基于本机真实数据)
下图用本仓库 cpu_demo 在 CentOS 7 上 readelf -S 的真实地址/偏移画出(非-PIE,基址 0x400000)。从上往下 = 文件偏移/地址递增;左列是 Section 视角怎么切,右列是 Segment 视角怎么按权限重新框选、映射进内存:
  文件Offset   ① Section 视角(按“用途”细切 37 块)      ② Segment 视角(按“权限”粗框选 → mmap 进内存)
 ───────────  ─────────────────────────────────────    ─────────────────────────────────────────────
              ┌───────────────────────────────────┐   ┐
  0x000238    │ .interp        动态链接器路径      │   │
  0x0002e8    │ .dynsym .dynstr .gnu.hash          │   │
  0x001068    │ .rela.dyn .rela.plt   重定位       │   │
  0x001608    │ .init .plt            启动/跳板     │   ├─►  LOAD #1   R + X (只读 + 可执行)
  0x0019a0    │ .text          ★你的代码            │   │     VirtAddr 0x400000
  0x004900    │ .rodata        常量/字符串         │   │     FileSiz == MemSiz (文件多大,内存多大)
  0x004ea0    │ .eh_frame(_hdr) .gcc_except_table  │   │
              └───────────────────────────────────┘   ┘
                         ┋ 地址从 0x406xxx 猛跳到 0x607xxx(约 2MB):权限不同必须换内存页 → 页对齐留空 ┋
              ┌───────────────────────────────────┐   ┐
  0x007dc8    │ .init_array .fini_array .jcr        │   │
  0x007de8    │ .dynamic       动态链接清单        │   │
  0x007ff8    │ .got .got.plt  全局偏移表(GOT)      │   ├─►  LOAD #2   R + W (可读写)
  0x0081c8    │ .data          初始化全局量        │   │     VirtAddr 0x607dc8
  0x0081cc    │ .bss (NOBITS)  未初始化全局量      │   │     MemSiz  >  FileSiz
              └───────────────────────────────────┘   ┘        └─ 差值 = .bss(0x430),加载时清零,文件里不占字节
              ╔═══════════════════════════════════╗
  0x0081cc    ║ .comment                          ║       (Address = 0x0,无 A 标志)
  0x0081f9    ║ .debug_aranges/info/abbrev/line…  ║   ✗   不属于任何 LOAD 段 → 运行时根本不映射进内存
  0x029d00    ║ .symtab .strtab   完整符号表      ║       只躺在文件里,供 ld 链接 / gdb 调试;strip 删的就是这些
  0x032b04    ║ .shstrtab        节名字符串表     ║
              ╚═══════════════════════════════════╝
 ───────────  ─────────────────────────────────────
  0x032c70    Section Header Table(37 个节头,本身也在文件里,描述上面每一块)
图例:
┌ ┐实线框 = 会被加载进内存的节(带A标志);╔ ╗双线框 =Address=0x0、运行时不加载的节。左侧数字是各节在文件里的真实 Offset。
逐块对照(图里的每一块对应真实输出)
| 文件里的节(Section 视角) | 真实 Address | 真实 Offset | 归入哪个 Segment | 运行时 |
|---|---|---|---|---|
.interp/.dynsym/.rela.plt/.init/.plt/.text/.rodata/.eh_frame | 0x400238~0x406fc5 | 0x238~0x6fc5 | LOAD #1 (R+X) | 映射,只读可执行 |
.init_array/.dynamic/.got/.got.plt/.data/.bss | 0x607dc8~0x608610 | 0x7dc8~ | LOAD #2 (R+W) | 映射,可写 |
.comment/.debug_*/.symtab/.strtab/.shstrtab | 0x0 | 0x81cc~文件尾 | 不属于任何 LOAD | 不映射 |
三个能在你这份输出里亲眼核对的事实:
- 代码区结尾 → 数据区开头,地址猛跳 2MB:
.gcc_except_table的Address=0x406e8c,下一个.init_array的Address=0x607dc8——从0x40xxxx跳到0x60xxxx。这不是浪费,是页对齐:LOAD #1 是R+X、LOAD #2 是R+W,权限不同就不能共用同一物理页,只能各自占独立的页范围,中间自然留出空档。 .bss让 LOAD #2 的MemSiz > FileSiz:.bss类型是NOBITS,文件里零长度(它的Offset 0x81cc和后面.comment的Offset完全相同),但Size=0x430要在内存里占 1072 字节。所以 LOAD #2 加载时,内核按FileSiz从文件读入.data等,再把多出来的MemSiz-FileSiz(正好是.bss)在内存里补零。Address=0x0的节永不进内存:.symtab/.debug_*/.comment的Address全是 0、没有A(alloc)标志——它们在文件里有内容(Offset从0x81cc排到文件尾),但不落在任何 LOAD 段的地址范围内,内核加载时直接跳过。这就是strip删掉它们、程序照跑的根本原因。
关键结论:
- Section 更细,Segment 更粗——一个 Segment 通常打包多个用途相近、权限相同的 Section(上图 LOAD #1 就吞下了从
.interp到.eh_frame十几个节)。 - 不是所有 Section 都进 Segment——
.symtab、.debug_*、.comment这些只在链接/调试时有用的节,不属于任何 LOAD 段,所以运行时根本不加载进内存(这也是strip删掉它们不影响程序运行的原因)。 .bss是特例——它在文件里不占空间(NOBITS,只记大小),但在 Segment 里要占内存(加载时清零)。所以 LOAD 段的MemSiz(内存大小) >FileSiz(文件大小),差的就是.bss。
对照表
| Section(节) | Segment(段) | |
|---|---|---|
| 中文 | 节 | 段 |
| 服务场景 | 链接期 + 调试期(静态,程序没在跑) | 加载期 + 运行期(动态,程序要跑/在跑) |
| 谁在用 | 链接器 ld、gdb、objdump、nm、strip | 内核 ELF 加载器、动态链接器 ld.so |
| 关心什么 | 用途:这块是代码?符号?调试信息? | 权限 + 加载:这段内存可读/写/执行?映射到哪? |
| 粒度 | 细,几十个(.text/.data/.bss/.rodata/.symtab/.debug_*…) | 粗,通常不到十个(几个 LOAD + INTERP/DYNAMIC/NOTE…) |
| 描述表 | Section Header Table(Start of section headers) | Program Header Table(Start of program headers) |
| 查看命令 | readelf -S(大写) | readelf -l(小写 L) |
| 缺了它能跑吗 | 能:strip 掉 .symtab/.debug_* 照样运行(只是没法调试) | 不能:Segment 是内核加载的依据,缺了程序起不来 |
两张表的连接点:Section → Segment 映射
readelf -l 输出的底部会列出"哪些 Section 被归进了哪个 Segment",这就是两种视角的桥梁:
 Section to Segment mapping:
  段节...
   00     .interp
   02     .interp .note.gnu.build-id .note.ABI-tag .dynsym .dynstr ... .text .rodata ...   ← 一个 R+X 的 LOAD 段打包了这么多节
   03     .init_array .fini_array .dynamic .got .data .bss                                  ← 一个 R+W 的 LOAD 段
   ...
看这张映射就明白:编译/链接时你面对的是几十个有名字的 Section;程序一旦要运行,它们就被按权限重新打包成几个 Segment 交给内核。同一份 .text 字节,在 Section 视角叫 .text,在 Segment 视角是"某个 R+X 的 LOAD 段"的一部分。
一句话记忆
Section = 按"用途"切细,给链接器/调试器看;Segment = 按"权限"打粗包,给内核加载用。链接看 Section,运行看 Segment,
readelf -l底部的映射把两者对起来。
(后面 第九节实操 会让你用 readelf -S 和 readelf -l 在 cpu_demo 上亲眼对照这两种视角;第五节(节视角)带你逐行读懂 readelf -S 真实输出,第六节讲 Segment 视角的概念、命令走查见 readelf 第四节。)
三、ELF Header 与两张头表(Section / Program Header Table)
3.1 ELF Header(文件总入口)
readelf -h ./cpu_demo(本机真实输出,非-PIE 可执行文件):
ELF Header:
  Magic:   7f 45 4c 46 02 01 01 00 00 00 00 00 00 00 00 00
  Class:                             ELF64
  Data:                              2's complement, little endian
  Type:                              EXEC (Executable file)
  Machine:                           Advanced Micro Devices X86-64
  Entry point address:               0x4019a0
  Start of program headers:          64 (bytes into file)
  Start of section headers:          207984 (bytes into file)
  Size of this header:               64 (bytes)
  Size of program headers:           56 (bytes)
  Number of program headers:         9
  Size of section headers:           64 (bytes)
  Number of section headers:         37
Section header string table index: 36| 字段 | 本例值 | 含义 |
|---|---|---|
Magic | 7f 45 4c 46 … | 前 4 字节 \x7f+"ELF" 识别标志;第 5 字节 02=64位(01=32位) |
Class | ELF64 | ELF32 / ELF64 |
Data | little endian | 大端/小端(x86 小端) |
Type | EXEC | 见第一节四种类型(这台 CentOS 默认非-PIE,故是 EXEC 不是 DYN) |
Machine | X86-64 | 目标架构 |
Entry point | 0x4019a0 | 程序入口(_start,不是 main) |
Start of section headers | 207984 | 节头表(SHT) 在文件的偏移 |
Size of section headers | 64 | 每个节头表项字节数 |
Number of section headers | 37 | 节头个数 |
Section header string table index | 36 | .shstrtab(节名字符串表)是第几个节 |
Start of program headers | 64 | 程序头表(PHT) 的偏移(紧跟 64 字节 Header) |
Size of program headers | 56 | 每个程序头表项字节数 |
Number of program headers | 9 | 程序头个数 |
ELF Header 就是一张"藏宝图":它本身不含代码/数据,只用上面几组字段指向两张表——
Start/Size/Number of section headers(+字符串表索引) 指向节头表;Start/Size/Number of program headers指向程序头表。下面 3.2a / 3.3a 分别用本例的数字走一遍"怎么顺着这些字段找到全部 section / 完成段加载"。
file ./cpu_demo一行就能读出大部分:ELF 64-bit LSB pie executable, x86-64, dynamically linked, ...。
先记住分工:Start/Size/Number of section headers(+字符串表索引) 指向 Section Header Table(节头表,描述"有哪些节",链接/调试视角);Start/Size/Number of program headers 指向 Program Header Table(程序头表,描述"怎么把文件变成内存段",加载/运行视角)。二者是同一份数据的两张"目录"。
3.2 Section Header Table(节头表,SHT)
它是一个数组,每个元素(section header)描述一个节的元信息——注意:节头表里存的不是节的内容,而是每个节"叫什么、在文件哪、多大、什么类型、什么权限"的描述。C 结构是 Elf64_Shdr:
字段(Elf64_Shdr) | readelf -S 里对应列 | 含义 |
|---|---|---|
sh_name | Name | 节名(如 .text);实际存的是到 .shstrtab 的偏移,readelf 帮你解析成字符串 |
sh_type | Type | 节类型:PROGBITS(有内容) / NOBITS(.bss,不占文件) / SYMTAB / STRTAB / RELA / DYNAMIC … |
sh_flags | Flags | 属性:A(alloc,加载进内存) / X(可执行) / W(可写) / M(可合并) … |
sh_addr | Address | 运行时虚拟地址;为 0 = 运行时不加载(如调试节) |
sh_offset | Offset | 该节在文件里的偏移 |
sh_size | Size | 节大小 |
sh_link / sh_info | Link / Info | 到另一节的交叉引用(如 .symtab.sh_link 指向其字符串表 .strtab) |
sh_addralign | Align | 对齐要求 |
sh_entsize | EntSize | 若是"表"节,每个表项大小(Size ÷ EntSize = 条目数) |
几个要点:
- 第 0 项(
[Nr] 0)恒为全 NULL,是占位的哨兵项,不描述任何真实节——所以你在readelf -S里总看到一个空的[ 0]行。 - 有一个特殊节
.shstrtab(节名字符串表)专门存所有节的名字;sh_name是到它的偏移。ELF Header 里还有个e_shstrndx字段记录".shstrtab是第几个节",readelf 靠它才能把sh_name翻译成.text这种可读名。 - SHT 对"运行"不是必需的:内核加载程序根本不看节头表(它只认 Program Header)。把 SHT 连同调试/符号节一起
strip掉,程序照跑——只是 gdb/objdump 没法按节解析了。这也解释了为什么恶意/加壳程序常故意破坏 SHT 来对抗静态分析。 - 用
readelf -S(大写)查看,详细字段解读和真实输出见 第五节。
3.2a 如何找到"所有的 section"(用本机数据走一遍)
定位全部 section 只是 ELF Header 里那几个字段的算术。以本例(Start of section headers=207984、Size=64、Number=37、字符串表索引 36)为例:
① 定位并遍历节头表
SHT 起点 = Start of section headers   = 207984 (0x32c70)
每项大小 = Size of section headers    = 64 字节
项数     = Number of section headers  = 37
→ 第 i 个节头 @ 文件偏移 207984 + i × 64
    [0] @207984  ← 恒为全 NULL 哨兵项(所以 readelf -S 的 [ 0] 行总是空的)
    [1] @208048
    ...
    [36]@210288
每个 64 字节的 Elf64_Shdr 就给出该节的 sh_offset(在文件哪) / sh_size(多大) / sh_type / sh_flags / sh_addr——节的内容位置全在这。
② 把 sh_name(数字)翻译成节名——这就是 Section header string table index: 36 的用处:
先读第 36 个节头(.shstrtab)拿到它的 sh_offset(节名字符串表在文件哪)
每个节的 sh_name = "到 .shstrtab 起点的偏移"
→ 从 .shstrtab[sh_name] 读一个 \0 结尾的字符串,就是 ".text"/".data" 等可读名
没有第 36 号这个索引,你能读出 37 个节的位置和大小,但全是无名的——readelf 正是靠它打印出节名。
完整链路:
Start+Size×Number遍历整张节头表 → 每项给出节的位置/大小/类型 → 借字符串表索引指向的.shstrtab把sh_name译成节名。这也说明为何清零/破坏这几个字段能让readelf -S、gdb 失效(找不到节了),但程序照跑——运行只认下面的段。
3.3 Program Header Table(程序头表 / 段表,PHT)
它也是一个数组,每个元素(program header)描述一个段(Segment)——即"运行时怎么处理这段字节"。C 结构是 Elf64_Phdr:
字段(Elf64_Phdr) | readelf -l 里对应列 | 含义 |
|---|---|---|
p_type | Type | 段类型 = 给运行时的指令:LOAD(映射进内存) / INTERP(指定动态链接器) / DYNAMIC / NOTE / GNU_STACK / GNU_RELRO … |
p_offset | Offset | 段在文件里的起始偏移 |
p_vaddr | VirtAddr | 映射到内存的虚拟地址 |
p_paddr | PhysAddr | 物理地址(普通程序不用管,一般同 vaddr) |
p_filesz | FileSiz | 从文件读多少字节 |
p_memsz | MemSiz | 在内存占多少字节(MemSiz > FileSiz 的差额就是 .bss,加载时补零) |
p_flags | Flg | 权限:R 读 / W 写 / E 执行 |
p_align | Align | 对齐(LOAD 段常 0x1000 或 0x200000,决定两个 LOAD 段地址错开多远) |
几个要点:
- 真正决定"哪些字节进内存、什么权限"的只有
LOAD段;其余段类型(INTERP/DYNAMIC/NOTE/GNU_STACK/GNU_RELRO)是给内核/ld.so的附加指令或索引(去哪找解释器、动态信息在哪、栈能否执行、哪段事后设只读)——这正是 Segment 语义比"一堆节打包"丰富的地方。 - PHT 对"运行"是必需的:内核
execve加载程序时只读这张表,逐个LOAD段mmap进内存、按p_flags设权限。缺了它,程序根本起不来。 .o目标文件没有 PHT:readelf -l main.o会显示There are no program headers——因为目标文件还没到"运行"阶段,段是链接器在生成可执行文件的最后一步才产出的运行视图。- 用
readelf -l(小写 L)查看,字段解读、9 个段的语义、以及底部 Section→Segment 映射的真实输出,见 readelf 第四节。
3.3a Segment 加载:字段算术与两条链路对照
运行 ./cpu_demo 时,内核完全不看节头表,只用 Header 里三个字段找到程序头表(本例 Start of program headers=64、Size=56、Number=9),从偏移 64 起按 56 字节/项读 9 个 Elf64_Phdr,再逐个 PT_LOAD 按 p_offset/p_filesz 从文件 mmap 到 p_vaddr、权限按 p_flags(本例两个 LOAD:0x400000 R E 代码、0x607dc8 RW 数据,后者 MemSiz>FileSiz 的差额即 .bss 在内存补零),最后跳到 Entry point 0x4019a0(_start)。
完整运行时故事(execve→mmap LOAD→ld.so 加载
.so→重定位填 GOT→_start→main)见 compile-link-load 第四节,那里从"敲下./cpu_demo"到进main逐步讲透。这里只强调:全程只用Start/Size/Number of program headers+Entry point,一次都没碰节头表——这就是"strip 掉节信息程序照跑"的原因。
两条独立链路对照(都出自同一份 ELF Header,各用一组字段):
| 找到所有 section(静态/工具) | 完成段加载(运行/内核) | |
|---|---|---|
| 用哪组字段 | Start/Size/Number of section headers + 字符串表索引 | Start/Size/Number of program headers + Entry point |
| 遍历什么 | 节头表(SHT) 的 37 个 Elf64_Shdr | 程序头表(PHT) 的 9 个 Elf64_Phdr |
| 额外一步 | 借 .shstrtab 把 sh_name 译成节名 | 遇 PT_INTERP 加载 ld.so、PT_DYNAMIC 做重定位 |
| 谁在用 | readelf/gdb/objdump/nm | 内核 execve + ld.so |
3.4 两张表对照
| Section Header Table (SHT) | Program Header Table (PHT) | |
|---|---|---|
| 表项结构 | Elf64_Shdr | Elf64_Phdr |
| 描述什么 | 有哪些节、各在文件哪、什么类型 | 有哪些段、怎么映射进内存、什么权限 |
| 服务谁 | 链接器 ld / gdb / objdump / nm | 内核加载器 / 动态链接器 ld.so |
| 运行是否必需 | 否(strip 掉照跑) | 是(缺了起不来) |
.o 里有吗 | 有 | 无(还没到运行阶段) |
| ELF Header 入口 | Start of section headers | Start of program headers |
| 查看命令 | readelf -S(大写) | readelf -l(小写 L) |
记忆:SHT = 链接/调试的目录,PHT = 加载/运行的目录。两张表可以同时存在(可执行文件、
.so),也可以只有一张(.o只有 SHT)。它们通过"文件偏移/地址范围"隐式关联——readelf -l底部的 Section→Segment 映射就是 readelf 遍历比对两张表算出来的。
3.5 完整文件布局:从头到尾一张图
前面第二节的图从 .interp(0x238) 开始,略过了文件最开头。把 ELF Header、两张头表和节数据按文件偏移从 0 到末尾完整摆出来,才看得清整个 .o/可执行文件在磁盘上到底长什么样。下图用本仓库 cpu_demo(非-PIE)的真实偏移:
 文件Offset                         磁盘上的 ELF 文件(从 0 到末尾)
 ──────────  ────────────────────────────────────────────────────────────────
 0x000000    ┌──────────────────────────────────────────────────────────┐
             │ ELF Header (64 字节)                                       │  ← 文件总入口
             │  Magic/Class/Type/Machine/Entry=0x4019a0                   │     指路两张头表↓
             │  e_phoff=64  e_phnum=9   ── 指向 Program Header Table       │
             │  e_shoff=207984 e_shnum=37 e_shstrndx=36 ── 指向 SHT        │
 0x000040    ├──────────────────────────────────────────────────────────┤
             │ Program Header Table (PHT)  9 项 × 56B                     │  ← 加载视角的“目录”
             │  PHDR / INTERP / LOAD×2 / DYNAMIC / NOTE / GNU_STACK …      │     内核 execve 只读这张
 0x000238    ├──────────────────────────────────────────────────────────┤
             │ ═══ 节数据区(各 section 的实际内容)═══                    │
             │  .interp .note .dynsym .dynstr .rela.* .init .plt          │  ┐ 会被 LOAD 段映射
             │  .text(你的代码).rodata .eh_frame …                      │  │ 进内存(带 A 标志)
             │  .init_array .dynamic .got .got.plt .data                  │  ┘
             │  .bss —— NOBITS,文件里 0 字节,只在 SHT 里记大小           │  ← 不占文件
             │  .comment .debug_* .symtab .strtab .shstrtab               │  ✗ 不加载,仅链接/调试用
 0x032c70    ├──────────────────────────────────────────────────────────┤
             │ Section Header Table (SHT)  37 项 × 64B                    │  ← 链接/调试视角的“目录”
             │  每项 Elf64_Shdr 描述一个节: name/type/addr/offset/size…    │     ld/gdb/readelf -S 读它
 文件末尾     └──────────────────────────────────────────────────────────┘
这张图把三件事讲全了:
- ELF Header 在文件最前(offset 0),像目录页——它用
e_phoff=64指向 PHT、e_shoff=207984指向 SHT。给你任意一个 ELF 文件,都是先读这 64 字节,再顺藤摸瓜找到两张表。 - 两张头表一头一尾夹着"节数据区" :PHT 紧跟 Header(offset 64),SHT 在文件末尾(207984)。中间一大段是各 section 的真实内容(代码、数据、符号、调试信息)。
- 两张表都只是"描述",不含数据本身:PHT 的每个
Elf64_Phdr、SHT 的每个Elf64_Shdr都只记录"某段/某节在文件哪、多大、什么属性",真正的字节在中间的节数据区。.bss是特例——它连数据区都不占(NOBITS),只在 SHT 里留个"要多大"的记录。
对照 readelf -h 的字段就能验证这张图(见 3.1):Start of program headers: 64、Start of section headers: 207984、Size of section headers: 64、Number of section headers: 37 —— 头表位置 + 每项大小 × 项数,正好框定两张表在文件里的范围。
三种 ELF 文件的布局差异:
.o(可重定位) 有 Header + 节数据 + SHT,但没有 PHT(还没到运行阶段,见 compile-link-load);可执行文件/.so三者俱全(如上图);core dump 主要靠 PHT 描述内存段快照、几乎不用 SHT。
四、常见 Section(节)
readelf -S ./cpu_demo 列全部;重点认识这些。每个专题都有独立深入文档:
| Section | 内容 | 特点 | 深入文档 |
|---|---|---|---|
.text / .rodata / .data / .bss | 代码、只读常量、已初始化/未初始化全局变量 | .bss 是 NOBITS,文件不占空间 | text-data-bss |
.symtab / .strtab | 符号表 / 符号名字符串 | 函数/变量名 → 地址;被 strip 删除 | symbol-table |
.dynsym / .dynstr | 动态符号表 | 动态链接需要的符号;strip 也不能删 | symbol-table |
.init / .fini / .init_array / .fini_array | 初始化与终止 | main 前后的构造/析构钩子 | init-fini |
.plt / .got | 过程链接表 / 全局偏移表 | 调用动态库函数的跳板(延迟绑定) | plt-got |
.rela.text / .rela.dyn / .rela.plt | 重定位信息 | 链接/加载时修正地址 | relocation |
.eh_frame / .gcc_except_table | 异常处理帧 | 零成本异常处理 + 栈回溯 | eh-frame |
.comment / .note.* / .shstrtab / .gnu_debuglink | 元数据与调试辅助 | 编译器版本、ABI 标签、Build ID、符号分离指针 | meta-sections |
.debug_* | DWARF 调试信息 | -g 产生;gdb 看源码/行号靠它 | symbol-table §六 |
.data vs .bss 的经典区别
int  a[1000] = {1};   // 有初值 → .data,占文件 4000 字节
int  b[1000];         // 无初值 → .bss,文件里只记"要 4000 字节",不占体积
用 size 命令能直接看到 text/data/bss 三段大小对比(见 misc)。这解释了"为什么加个大数组可执行文件没变大"——进了 .bss。
五、读懂真实的 readelf -S 输出(实例逐层解析)
上面是概念,这里拿一份真实输出(CentOS 7 上 readelf -S ./cpu_demo)走一遍,把前面"两种视角"的理论对上号。
5.1 先看表头,判断文件类型
There are 37 section headers, starting at offset 0x32c7037 个 section,section header table 在文件偏移 0x32c70(接近文件尾——section 表通常在文件最后)。
关键判断:这是个非-PIE 的传统可执行文件(Type: EXEC)。 证据是各节的 Address 是 0x400238 这种固定的大地址(基址 0x400000),而不是 PIE 那样从小偏移开始。CentOS 7 的 gcc 默认就编出非-PIE——和"现代发行版默认 PIE(DYN)"正好是一组对照,取决于工具链默认值。
5.2 每列的含义
  [Nr] Name              Type             Address           Offset
Size EntSize Flags Link Info Align| 列 | 含义 |
|---|---|
Address | 运行时虚拟地址(VMA)——加载进内存后在哪。为 0 = 运行时不加载 |
Offset | 在文件里的字节偏移——文件里在哪 |
Size | 该节大小 |
EntSize | 若是"表"类节,每个表项的字节大小(Size ÷ EntSize = 条目数) |
Flags | 属性:A=alloc(加载进内存)、X=可执行、W=可写、M=可合并、S=字符串、I=含 info |
Link/Info | 指向另一个节的交叉引用 |
5.3 最关键的一列:看 Address 是不是 0
这份输出把"两种视角"钉死了。按 Address 分成两类:
① Address 非 0 + 带 A 标志 → 会被加载进内存(属于某个 LOAD 段)
[ 1] .interp    Address 0x400238   A     动态链接器路径
[13] .text      Address 0x4019a0   AX    你的代码(可执行)
[15] .rodata    Address 0x404900   A     只读常量
[25] .data      Address 0x6081c8   WA    初始化全局量(可写)
[26] .bss       Address 0x6081e0   WA    未初始化全局量
② Address 全是 0x00000000 + 没有 A 标志 → 运行时根本不加载进内存
[27] .comment       Address 0x0    (无 A)   编译器版本
[29] .debug_info    Address 0x0    (无 A)   DWARF 调试信息
[34] .symtab        Address 0x0    (无 A)   符号表
[35] .strtab Address 0x0 (无 A) 符号名字符串这就是前面"不是所有 Section 都进 Segment"的铁证:调试信息、符号表、编译器注释运行时用不到,内核不给它们分配虚拟地址(0x0)。
strip删的正是这几个,删了程序照跑——因为它们本就不进内存。
5.4 .bss 特例被这份输出抓了个正着
看 .bss 和它后一个节的 Offset:
[25] .data     Type PROGBITS   Offset 0x81c8   Size 0x4
[26] .bss      Type NOBITS     Offset 0x81cc   Size 0x430
[27] .comment  Type PROGBITS   Offset 0x81cc   Size 0x2d      ← 和 .bss 同一个 Offset!
.bss 类型是 NOBITS(不占文件字节),所以它在文件里"零长度",下一个节 .comment 紧接着同一偏移 0x81cc 开始。但 .bss 的 Size 是 0x430(内存里要占 1072 字节,加载时清零)。
这正是"文件里不占空间、内存里占空间"→ LOAD 段
MemSiz > FileSiz的来源(见第二节.bss特例)。
5.5 用 EntSize 算条目数
带 EntSize 的节是"表",Size ÷ EntSize = 条目数:
.dynsym:0x5a0 ÷ 0x18(24)= 60 个动态符号.symtab:0x2988 ÷ 0x18= 约 442 个符号(带-g编译,符号很多).rela.plt:0x510 ÷ 0x18= 54 个 PLT 重定位项(要绑定 54 个库函数)
Link/Info 是交叉引用:.dynsym 的 Link=6 指向 [6] .dynstr,意思"我的符号名字符串在 6 号节里"。
5.6 从 Address 跳变看到 Segment 边界
节的 Address 在中间有个大跳变:
[18] .gcc_except_table  Address 0x406e8c   ← 代码/只读区结尾
[19] .init_array        Address 0x607dc8   ← 可写区开头
从 0x406e8c 跳到 0x607dc8,差了约 2MB(0x200000)。这就是两个 LOAD 段的分界:前面是 R+X(代码+只读数据),后面是 R+W(数据)。中间空出 2MB 是页对齐——不同权限的段不能共享同一内存页,必须错开到不同页。用 readelf -l 能看到这两个 LOAD 段分别把上下这些节圈进去,这就是两视角的连接点。
5.7 按用途归类这 37 个节(Section 视角的本质 = 按用途分)
| 组(按 Flags/用途) | 代表节 | 运行时 |
|---|---|---|
动态链接元数据(A) | .interp .dynsym .dynstr .gnu.hash .rela.dyn .rela.plt .gnu.version* | 加载,给 ld.so 用 |
代码(AX) | .init .plt .text(你的代码) .fini | 加载,只读可执行 |
只读数据(A) | .rodata .eh_frame* .gcc_except_table | 加载,只读 |
可读写数据(WA) | .init_array .dynamic .got .got.plt .data .bss | 加载,可写 |
调试/符号(Address=0) | .comment .debug_* .symtab .strtab .shstrtab | 不加载,只给链接/调试用 |
一句话总结这份输出:它是"按用途细分的 37 个 section";带 A/真实地址的会被打包进 LOAD 段加载运行,Address=0 的(调试/符号/注释)只躺在文件里给链接器和 gdb 用、运行时不加载。这份输出本身就是"Section 视角 + 谁会/不会进 Segment"的活教材。
六、Segment 视角的意义(概念)与实操出处
第五节从 readelf -S 讲透了 Section(节)视角;对应的 Segment(段)视角要抓住三个概念,它们是本文档 §二、§3.3 的落点:
- 只有
LOAD段真正决定"哪些字节进内存、什么权限";其余段类型(INTERP/DYNAMIC/NOTE/GNU_STACK/GNU_RELRO)都是给内核/ld.so的附加指令或索引(去哪找解释器、动态信息在哪、栈能否执行、哪段事后设只读)——这正是 Segment 语义比"一堆节打包"丰富的地方。 - 段按权限框选、允许重叠:一个节可同时落在多个段里(如
.dynamic同属 LOAD#2、DYNAMIC、GNU_RELRO)。段不是"瓜分"节,而是各自按用途框选。 - 不是所有节都进段:
Address=0x0的.symtab/.debug_*/.comment不属于任何段、运行时不加载——这与第五节"哪些节带A标志"完全对上。
命令走查看 readelf 第四节:那里用同一个
cpu_demo的readelf -l真实输出,逐行讲 9 个段的语义、Entry point/两个 LOAD 隔 2MB/MemSiz>FileSiz三件事的核对,以及底部 Section→Segment 映射如何把两视角对起来。本文档教概念,readelf.md 展示命令输出。
对照口诀:
readelf -S(第五节)看全部节(含不加载的调试/符号);readelf -l(readelf.md 第四节)看段 + 映射(只涉及会加载或有运行时用途的节)。合起来,ELF 的静态/运行双视角就完全打通了。
七、符号与 strip 的关系(串起 core dump 那套)
- 符号表(
.symtab)记录每个函数/全局变量的名字→地址映射。gdb 的bt能显示函数名、perf 火焰图能显示函数名,都靠它。 strip删掉.symtab/.debug_*,二进制变小,但bt就只剩地址(问号)。- 生产环境两全其美的做法是分离调试符号(
objcopy --only-keep-debug→strip→objcopy --add-gnu-debuglink):线上二进制小、又能事后完整分析 core。原理是 gdb 读到.gnu_debuglink节就自动去找对应.debug文件补全符号。完整三步配方、build-id 匹配与版本归档见 symbol-separation。
八、静态链接 vs 动态链接(ELF 结构差异)
从 ELF 结构看,两者的区别集中在是否有动态节:
- 动态链接(默认):有
.interp(存动态链接器路径/lib64/ld-linux-x86-64.so.2)、.dynamic、.plt、.got;readelf -l能看到INTERP段[Requesting program interpreter: ...]——内核先把控制权交给动态链接器,由它加载.so再跳到程序入口。file 显示dynamically linked。 - 静态链接(
-static):库代码打进可执行文件,无.interp/.dynamic等动态节;file 显示statically linked。
两者的体积/升级/部署权衡、以及链接阶段各自怎么走,见 compile-link-load 第二节。这里只关注 ELF 结构层面的差异。
九、本仓库实操
make                          # 生成 ./cpu_demo
file ./cpu_demo               # 一眼看类型:ELF 64-bit LSB pie executable, dynamically linked, with debug_info
readelf -h ./cpu_demo         # ELF Header
readelf -S ./cpu_demo         # 所有 section,找 .text/.debug_info(-g 编的所以有调试节)
readelf -l ./cpu_demo         # program header(段)+ section→segment 映射
size ./cpu_demo               # text/data/bss 大小
make release                  # -O2 重编,对比 .text 是否变小(优化后热循环被消除)
strip ./cpu_demo && readelf -S ./cpu_demo # 观察 .symtab/.debug_* 消失(别在需要调试时这么做)对比实验:readelf -S 看 -O0 -g 版有一堆 .debug_* 节;strip 后再看,.debug_* 和 .symtab 没了、文件变小——这就是线上发布二进制的做法。
十、工具速查(详见各文档)
| 工具 | 用途 | 文档 |
|---|---|---|
readelf | 解析 ELF 各结构(header/section/segment/符号/动态节) | readelf |
objdump | 反汇编、查看段内容、混排源码 | objdump |
nm | 列符号表(定位 undefined symbol、符号类型) | nm |
ldd | 查看动态库依赖 | ldd |
file/size/strings/strip/objcopy/addr2line/c++filt | ELF 相关小工具合集 | misc |
readelf vs objdump 的分工:readelf 专注"解析 ELF 结构"(更懂 ELF 本身、输出更规整);objdump 专注"反汇编和内容"(更懂机器指令、能混排源码)。查结构用 readelf,看代码用 objdump。