片内互联 —— Ring/Mesh/IFOP:多核之间怎么通信
16 个核心共享 L3 Cache 和 IMC,它们之间怎么互相通信?L1 miss 后数据怎么从另一个核心的 L2 传过来?答案是片内互联(On-Die Interconnect)——CPU 芯片内部的通信网络。本篇讲清三种主流拓扑(Ring Bus、Mesh、IFOP)怎么跑、为什么不同规模选不同方案、以及延迟和带宽的实际数量。
相关:CPU 物理层次全景见 cpu-bus-architecture §一,核心内部结构见 cpu-microarch-overview,DMA 数据流路径见 off-chip-buses §二,NUMA 拓扑见 numa。
零、一句话结论
| 拓扑 | 延迟增长 | 规模上限 | 代表 | 一句话 |
|---|---|---|---|---|
| Ring Bus | O(N) 正比核数 | ~12 核 | Intel 消费级 (Raptor Lake) | 核少最快,多了撑不住 |
| Mesh | O(√N) 正比根号核数 | 上百核 | Intel Xeon SP (Sapphire Rapids) | 高核数扩展性好 |
| AMD IFOP | 同 CCD 低,跨 CCD 走 IOD | 12 CCD → 96 核 | AMD EPYC Genoa | Chiplet 架构,IOD 是中心交换机 |
一、Ring Bus(环形总线)—— 消费级的最优解
1.1 拓扑与传输
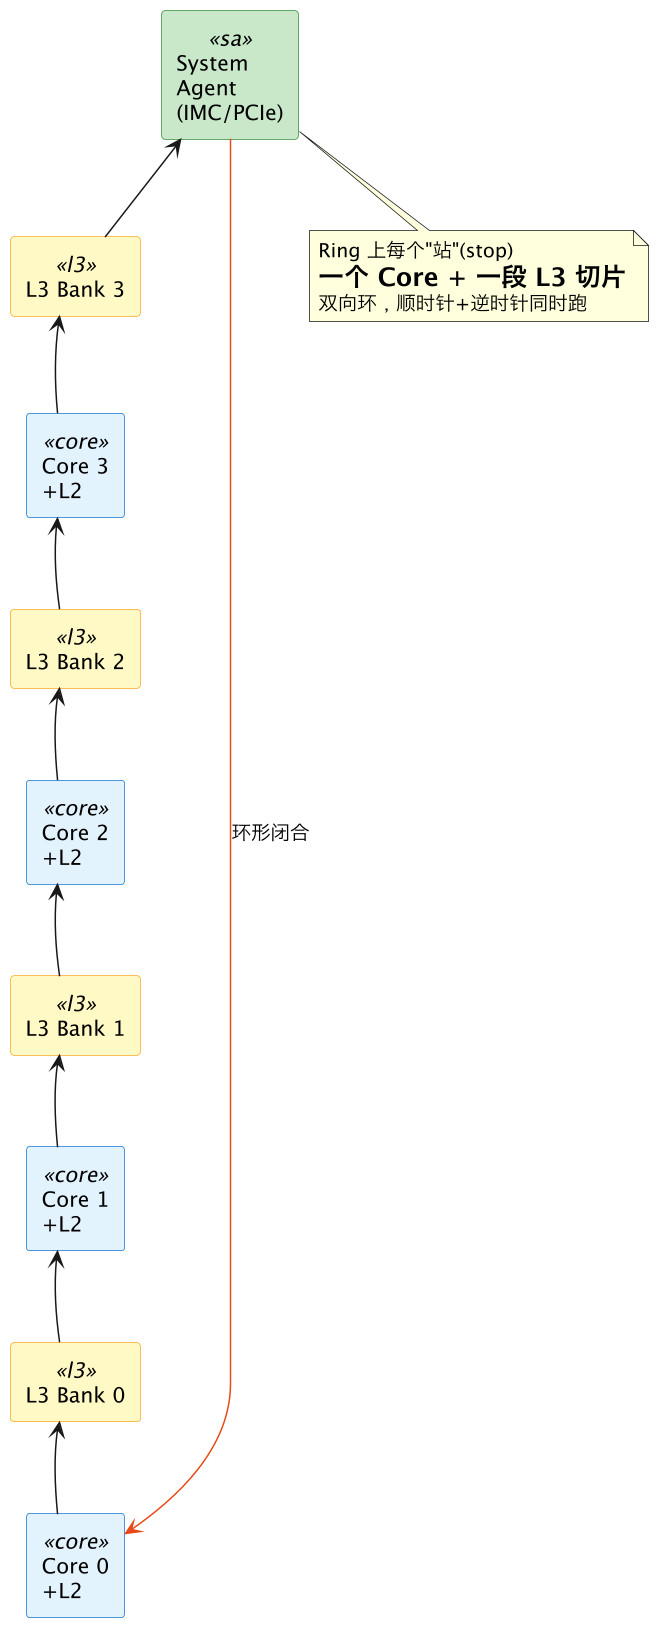
Ring Bus 由 Intel 在 Sandy Bridge(2011)引入,一直用到 Raptor Lake。所有核心和 L3 bank 挂在同一条环形链路上:
1.2 路由与延迟
双向环:数据可以顺时针或逆时针走——取最短路径。8 核时最远 4 跳,每跳 ~1-2 拍(与核心同频)。
Core 0 访问 Core 3 的 L2:
  路径: Core0 → L3Bank0 → Core1 → L3Bank1 → Core2 → L3Bank2 → Core3
  顺时针 6 跳,逆时针 2 跳 → 走逆时针
总延迟 = 跳数 × 每跳延迟 ≈ 2-4 拍
1.3 为什么 10-12 核之后 Ring 撑不住
- 延迟线性增长:核数翻倍 → 最远跳数翻倍 → 延迟翻倍
- 带宽被切分:Ring 上的总带宽固定(每方向 ~32-64 B/拍),核越多每核分到的越少
- 物理绕线变长:环形越长,布线电容越大,频率要降
| 特性 | Ring Bus |
|---|---|
| 拓扑 | 双向环(顺时针+逆时针同时传,取最短路径) |
| 延迟 | 约与跳数成正比,8核≈最远 4 跳 |
| 上限 | ~10-12 核后扩展性差(环太长 → 延迟高、带宽被切分) |
| 带宽 | 每环每方向约 32-64B/拍,频率和核心同步 |
| 代表 | Sandy Bridge ~ Raptor Lake(消费级) |
二、Mesh(网格互联)—— 服务器的大规模方案
2.1 拓扑
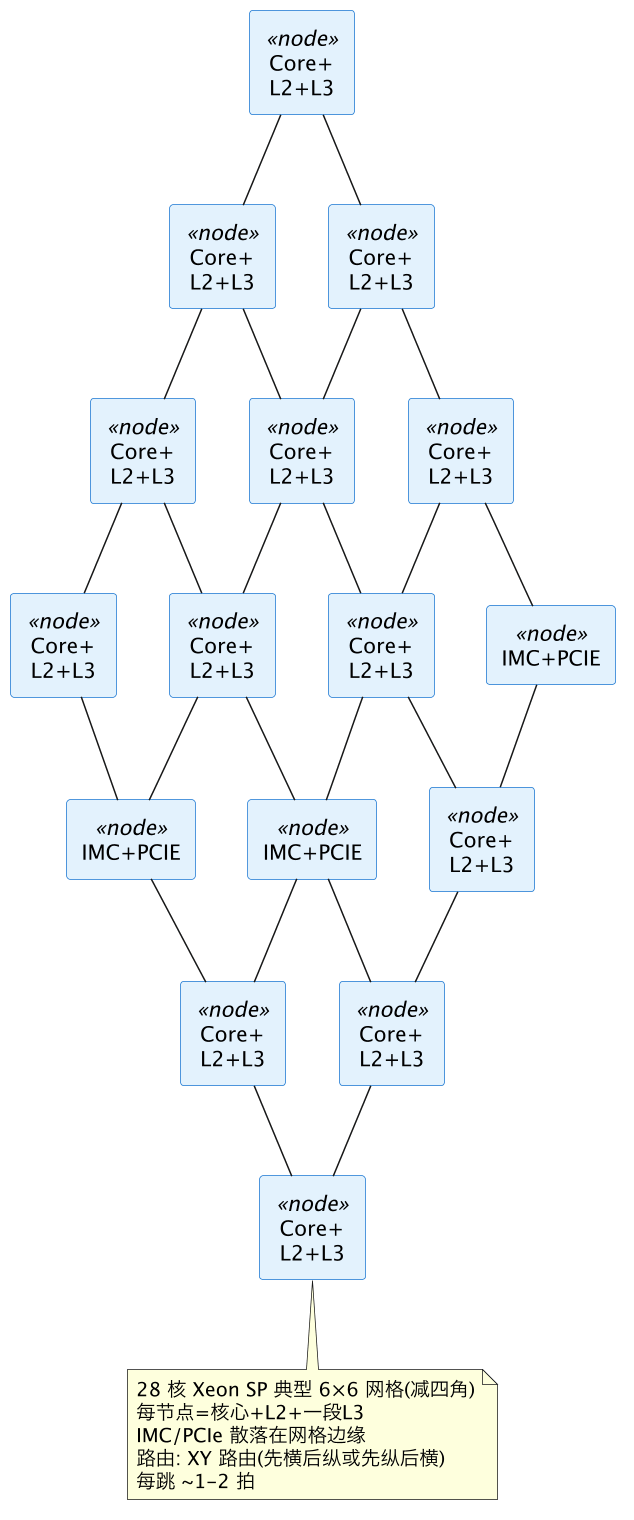
高核数(28核 Xeon SP +)时,Intel 把核心排成二维网格,按行/列路由:
2.2 路径计算
28 核 Mesh(6×6 减四角),最远情况:从最左上的 N00 到最右下的 N33 = 横跳 3 次 + 纵跳 3 次 = 6 跳。
对比 Ring:如果 28 核用 Ring,最远 14 跳。Mesh 的 O(√N) 在 28 核时只需 6 跳,远好于 O(N) 的 14 跳。这就是为什么 Xeon SP 从 Skylake-SP 开始放弃 Ring 改用 Mesh。
2.3 对分带宽
Mesh 有多条并行路径——从 N00 到 N33 的 6 跳路径只是其中之一。同时可以有多对核心通过不共享的链路并发传输,总对分带宽远大于 Ring。
Ring:  对分带宽 = 环截面 × 2 (双向)        → O(1) 常量
Mesh: 对分带宽 = 网格截面行数 × 每行带宽 → O(√N)| 特性 | Mesh | Ring |
|---|---|---|
| 延迟 | O(√N),28 核约 4-6 跳 | O(N),28 核最远 14 跳 |
| 扩展性 | 可上百核 | ~12 核后吃力 |
| 带宽 | 对分带宽大(多条并行路径) | 总带宽固定 |
| 功耗 | 更高(更多中继器) | 更低 |
| 代表 | Skylake-SP ~ Sapphire Rapids(Xeon SP) | 消费级 |
三、AMD Infinity Fabric On-Package (IFOP) —— Chiplet 架构的通讯网
3.1 星型结构:IOD 是中心交换机
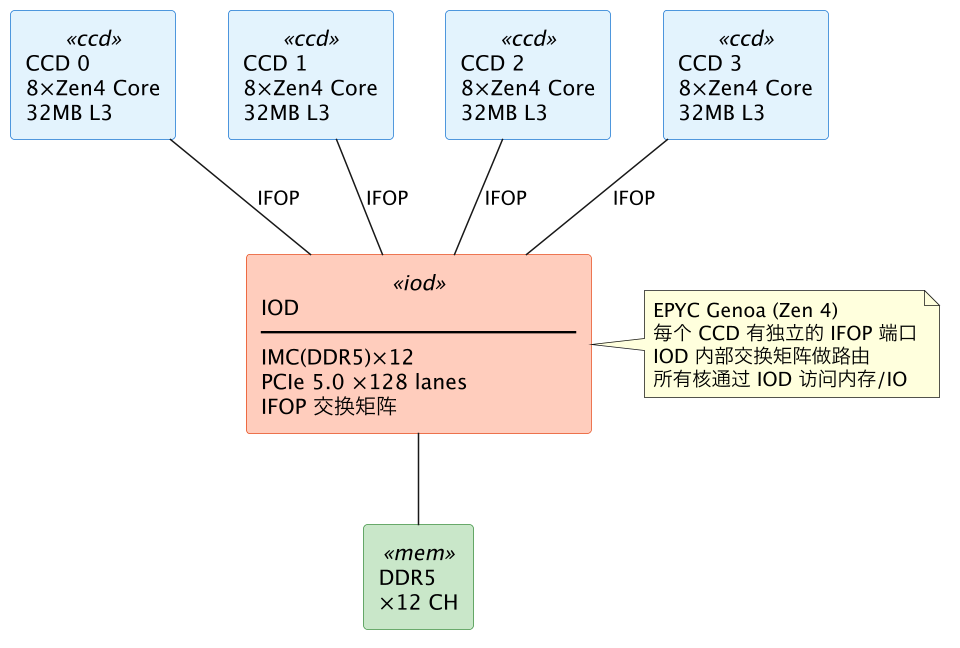
AMD 的 Chiplet 架构把核心和 I/O 拆开:CCD(计算片)只含核心 + L3,IOD(I/O 片)含 IMC、PCIe RC 和互联交换矩阵。所有 CCD 通过 IFOP 链路连到 IOD,形成星型拓扑。
3.2 延迟层次
AMC Chiplet 架构下,延迟有明显的阶梯:
同 CCD 内 (Core0 → Core1):
  L1→L2→L3 (CCD 内共享)  ← 延迟: ~40-50 cycles (L3 命中)
跨 CCD (CCD0 Core0 → CCD1 Core0):
  L1→L2→L3(CCD0 miss)→IFOP→IOD交换→IFOP→L3(CCD1)
  延迟: ~120-200 cycles(远高于同 CCD)
所有核心访问内存:
  核心→L3(大概率miss)→IFOP→IOD→IMC→DDR
  延迟: ~80-100ns (DDR5-4800)
3.3 设计取舍
| 特性 | AMD IFOP | Intel Mesh | Intel Ring |
|---|---|---|---|
| 拓扑 | CCD→IOD 星型(IOD 是中心) | 二维网格 | 环 |
| 核间延迟 | 同 CCD 低;跨 CCD 过 IOD 中转高 | 行列跳数 | 环上跳数 |
| 内存延迟 | 所有核统一过 IOD(跨片惩罚固定) | IMC 在网格边缘 | IMC 在环上一站 |
| 扩展方式 | 加 CCD 即可(IOD 不变,Genoa 最多 12 CCD) | 扩大网格 | 换拓扑 |
| 良率优势 | CCD 用先进工艺(面积小)、IOD 用成熟工艺(面积大) | 单 Die 全在先进工艺上 | 单片 |
| 代价 | 所有内存访问必跨片——轻载也有固定延迟惩罚 | 网格越大中继器越多 | 环太长↗ |
核心取舍:AMD 选择了 Chiplet 的灵活和良率优势,代价是即便单核轻载场景,访问内存也必然穿过 IFOP 到 IOD——约 20-30ns 的固定跨片延迟惩罚。Intel 单片方案(Ring/Mesh)没有这个固定惩罚,但大芯片的良率更低、成本更高。
四、片内互联的核心指标对比
4.1 延迟模型
Ring (N 核):              最远延迟 = N/2 跳 × 每跳 ~2 拍
Mesh (N 核, √N × √N):    最远延迟 = 2×√N 跳 × 每跳 ~1.5 拍
IFOP (N 核, M CCD):      同CCD延迟 = L3 延迟
                         跨CCD延迟 = IFOP 往返 + IOD 交换 ≈ 80-120 额外周期
4.2 带宽模型
Ring:   总带宽 ≈ 64 B/cycle × 核心频率
        每核心可分配 ≈ 总带宽 / N
Mesh:   对分带宽 ≈ √N × 行带宽
        每核心可分配远多于 Ring (尤其是中段核心)
IFOP:   每 CCD→IOD 链路带宽固定 (32B/cycle × IFOP 频率)
        代价: 所有 CCD 共享 IOD 内部交换矩阵——极端情况下 IOD 是带宽瓶颈
4.3 观测工具
# 看核心和缓存的物理拓扑
lstopo --no-io
lstopo --output-format png > topo.png   # 导出图片
# 看 L3 被哪些核心共享(= Ring / CCX 边界)
cat /sys/devices/system/cpu/cpu0/cache/index3/shared_cpu_map
# Perf 监控片内互联事件 (Intel Uncore)
# 注意: 事件名随代际变化,查 Intel PerfMon 手册
perf list | grep -i uncore
perf stat -e uncore_imc/cas_count_read/,uncore_imc/cas_count_write/ ls
# AMD: 监控跨 CCD 延迟
perf stat -e cpu/event=0x91,umask=0x01/    # Zen 4: 跨 CCD 访问计数
更完整的观测诊断见 cpu-bus-architecture §九。
五、一句话总结
Ring(低核消费级)、Mesh(高核服务器)、IFOP(Chiplet 架构)是三种完全不同的片内互联哲学。Ring 的延迟随核数线性增长,10 核就到头;Mesh 用二维网格把延迟降到 O(√N),但功耗更高;IFOP 把互联推到了 Chiplet 层面——同片(CCD 内)低延迟、跨片走 IOD 中转有固定惩罚——核心是"良率、成本、延迟"三角的权衡。
关联:cpu-bus-architecture(CPU 系统架构导读)、cpu-microarch-overview(单核微架构)、numa(NUMA 拓扑与跨 Socket 延迟)