read + write 整体过程 —— 从用户态调用到数据落盘/发网的完整链路
一个最简单的
read(fd, buf, 4096)+write(fd, buf, 4096),背后到底发生了什么?系统调用怎么陷入内核、内核 VFS/页缓存/块层/驱动怎么逐层处理、数据怎么在内存和外设之间流动、什么时候会触发上下文切换、用户态和内核态的栈和特权级怎么切换——本篇把这一整条链路从头拆到尾,用完整的时序图和逐层拆解讲清楚。
一、全景概览:read+write 的 10 层调用链

整条链路的核心角色:
| 层 | 做什么 | 关键数据结构 | 是否可能阻塞 |
|---|---|---|---|
| 用户态 | 调用 read()/write(),准备参数 | 用户栈、buf 指针 | 否(只是发起调用) |
| 系统调用入口 | 特权级切换、参数校验、分发 | sys_call_table、pt_regs | 否 |
| VFS | 统一文件操作接口,按文件类型分发 | file、file_operations | 否(VFS 本身不阻塞) |
| Page Cache | 缓存文件数据,管理页的状态 | address_space、page、radix tree | 是(缺页时等 IO) |
| 块层 | 将 IO 请求排队、合并、调度 | bio、request_queue | 可能(等待调度) |
| 设备驱动 | 与硬件交互,发起 DMA | 设备寄存器、DMA 描述符 | 是(等硬件完成) |
| 磁盘硬件 | DMA 读写物理扇区 | 磁盘控制器 | 是(机械寻道/NAND 读取) |
二、read() 完整时序
以第一次读取某文件(数据不在 page cache 中)为例:
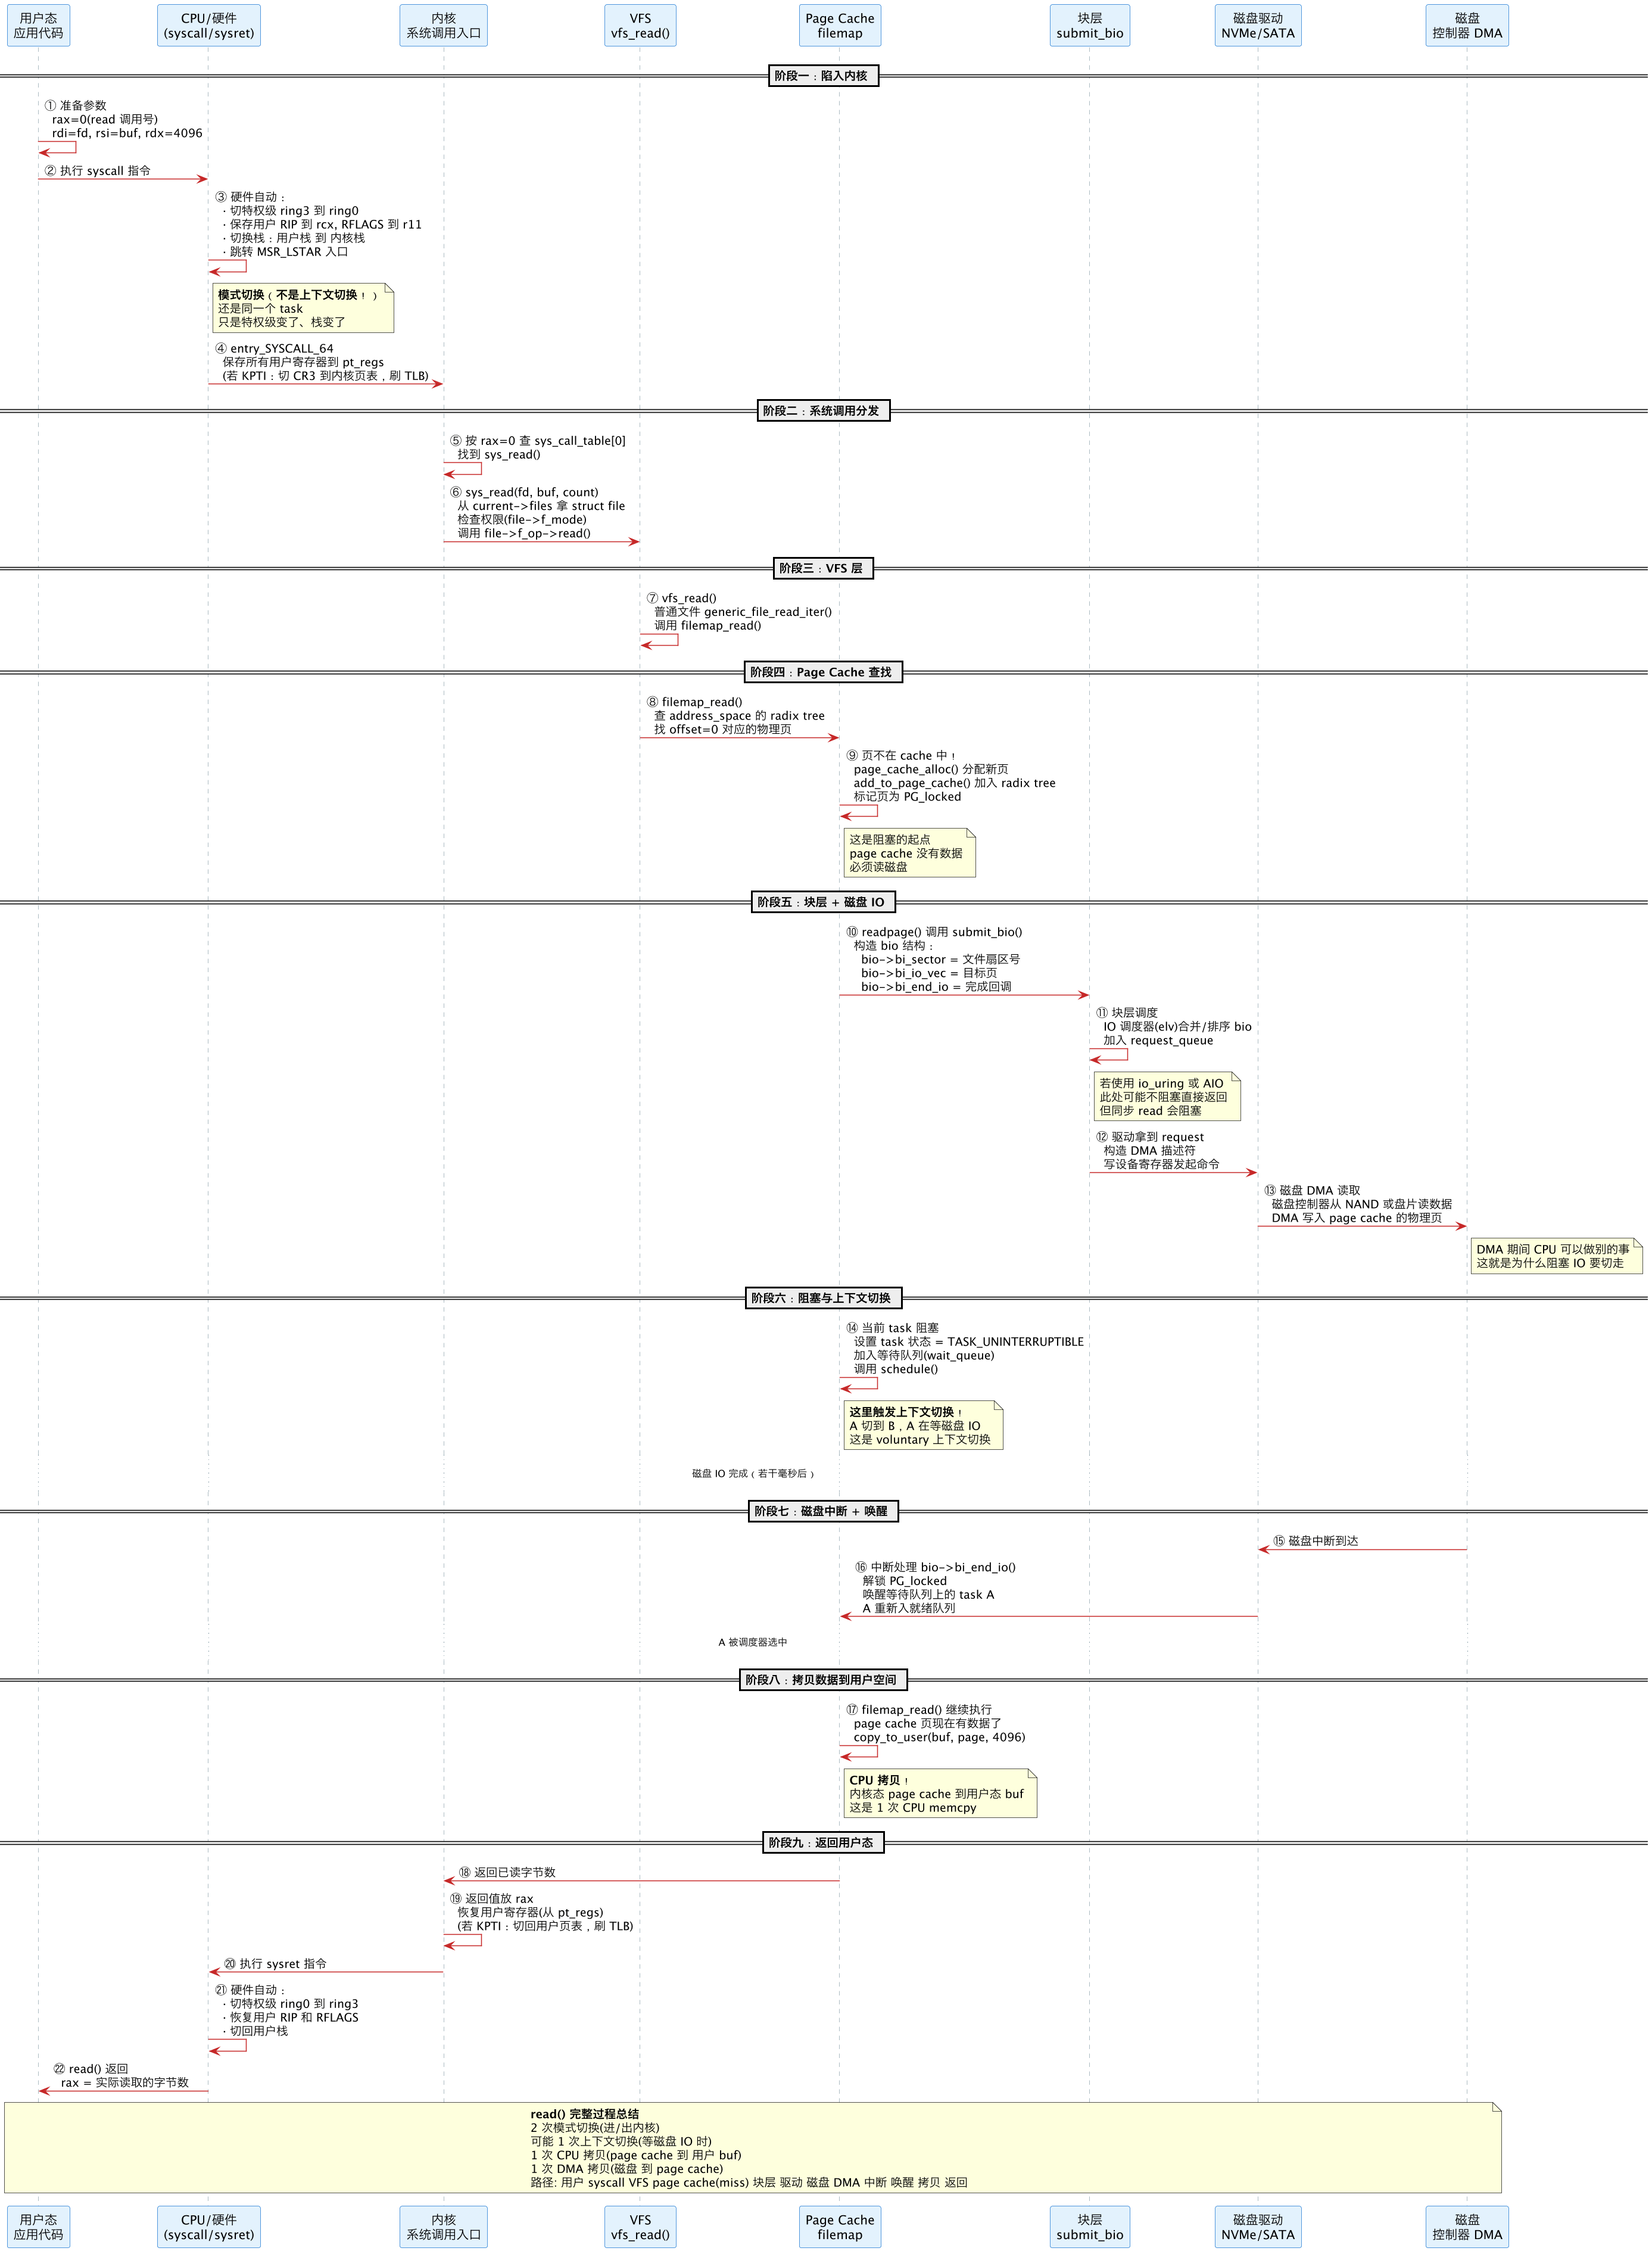
2.1 read() 关键决策点
page cache 命中 vs 未命中:
| Page Cache 命中 | Page Cache 未命中 | |
|---|---|---|
| 磁盘 IO | 无 | 有(DMA 读取) |
| 是否阻塞 | 否 | 是(同步 read 必须等) |
| 上下文切换 | 无 | 1 次(voluntary,等 IO) |
| 延迟 | ~1-5 μs | ~0.1-10 ms(取决于存储介质) |
| CPU 拷贝 | 1 次(page cache 到 用户 buf) | 1 次(同上) |
为什么 page cache 未命中时一定要上下文切换?
数据在磁盘上(不在内存),机械盘寻道 ~5-10ms,NVMe ~0.1ms——这段时间 CPU 如果空等(busy-wait),一个核就废了。内核的做法是:把当前 task 标记为睡眠、切到另一个 task 去跑、等磁盘中断到达再唤醒。这就是阻塞 IO 的本质——"等"的这段时间 CPU 去干别的。
三、write() 完整时序
写操作通常比读更复杂——涉及"写回"策略、脏页管理、可能触发回写:
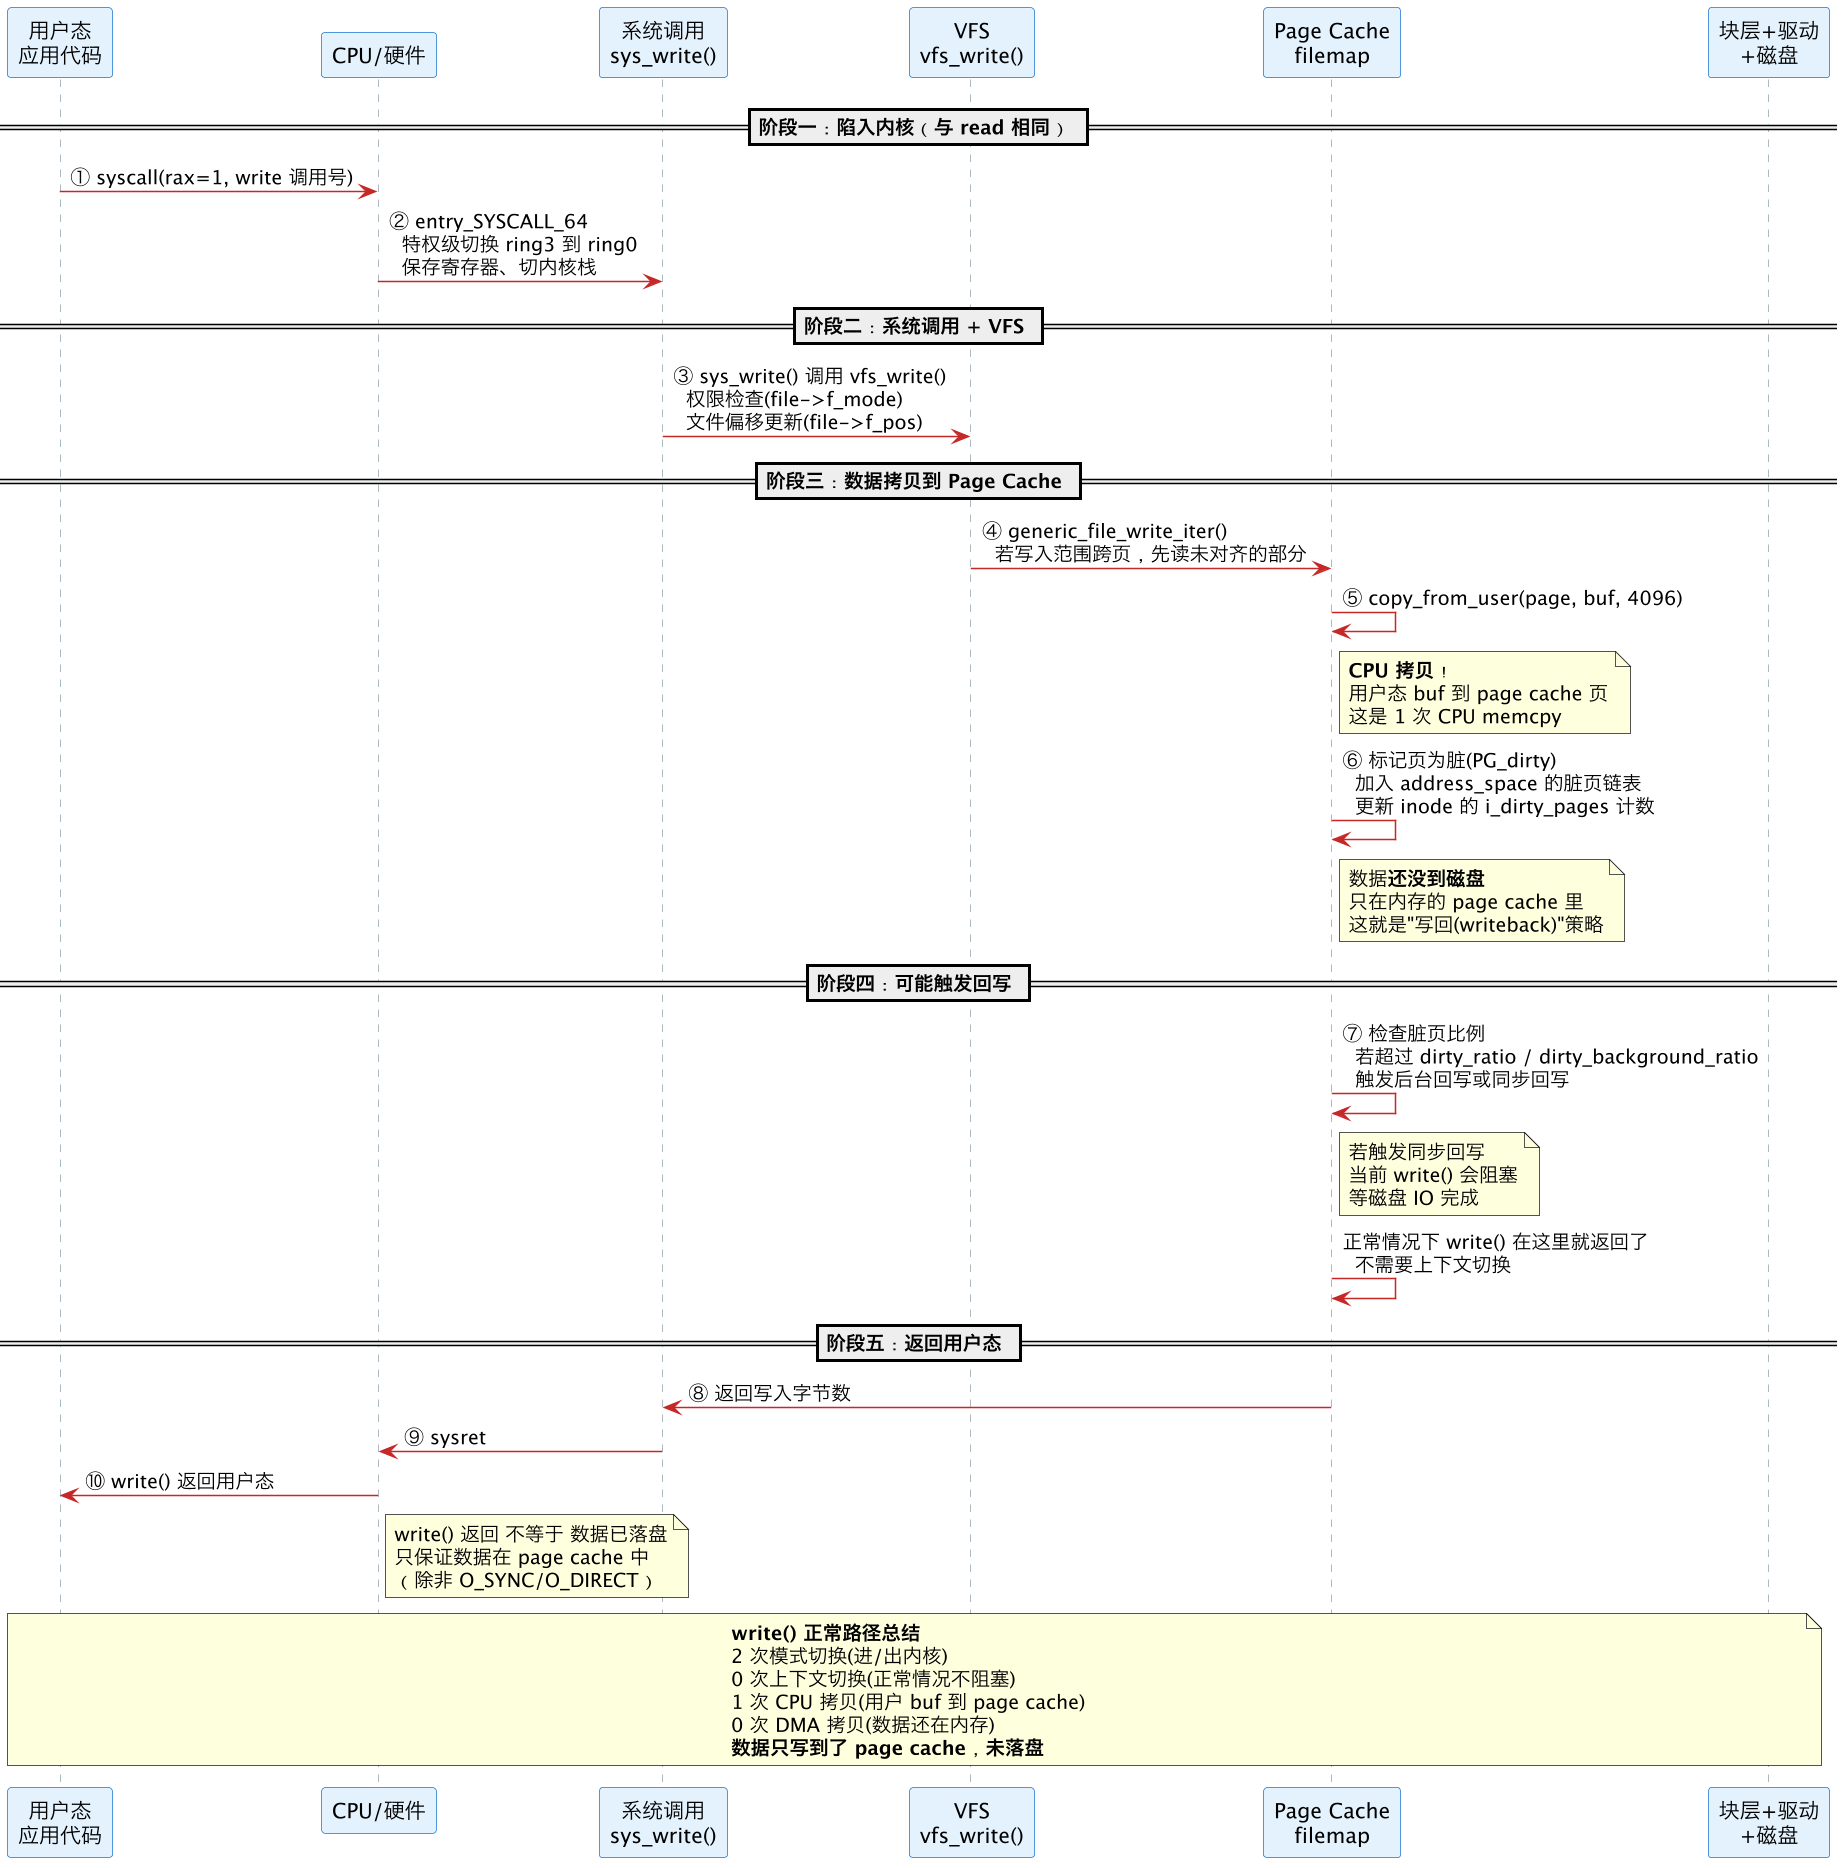
3.1 write() 的写回策略
3.1.1 什么是"写回"?
Linux 默认使用**写回(writeback)**策略——write() 调用只把数据拷到 page cache 并标记为脏页(PG_dirty),不等待磁盘写入完成就立刻返回。真正的物理落盘由内核后台线程异步完成。
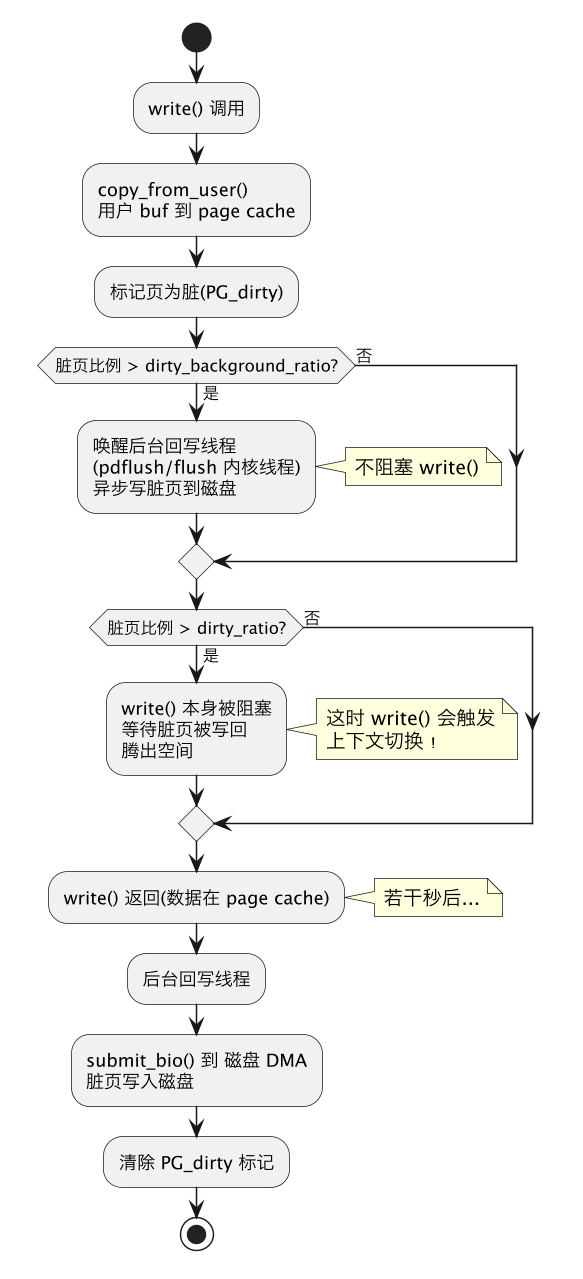
3.1.2 为什么叫"写回"?
这个命名来源于缓存架构中经典的分类术语,核心思想是:写操作的数据流向是"写回到缓存,延迟再写回到磁盘",因此叫"写回"。
来理解一下这个词的构词逻辑:
| 成分 | 含义 |
|---|---|
| 写 | 写操作,用户调用 write() |
| 回 | 回到 page cache(写的数据"回到"内存缓存中,而不是直接"穿过"缓存到磁盘) |
更本质的理解:从 CPU 指令的角度看,"写回"描述了 L1/L2 cache 的写入策略——CPU 执行 store 指令时只写入 cache,不立刻写入主存,修改过的 cache line 标记为 dirty,等到该 cache line 被驱逐时才"写回"主存。Page cache 是同一思想在 OS 层的延伸——write() 只写入 page cache,标记 PG_dirty,后台回写线程再"写回"磁盘。
3.1.3 三种写策略对比
在操作系统和缓存设计中,对"写操作如何处理"有三种经典策略:
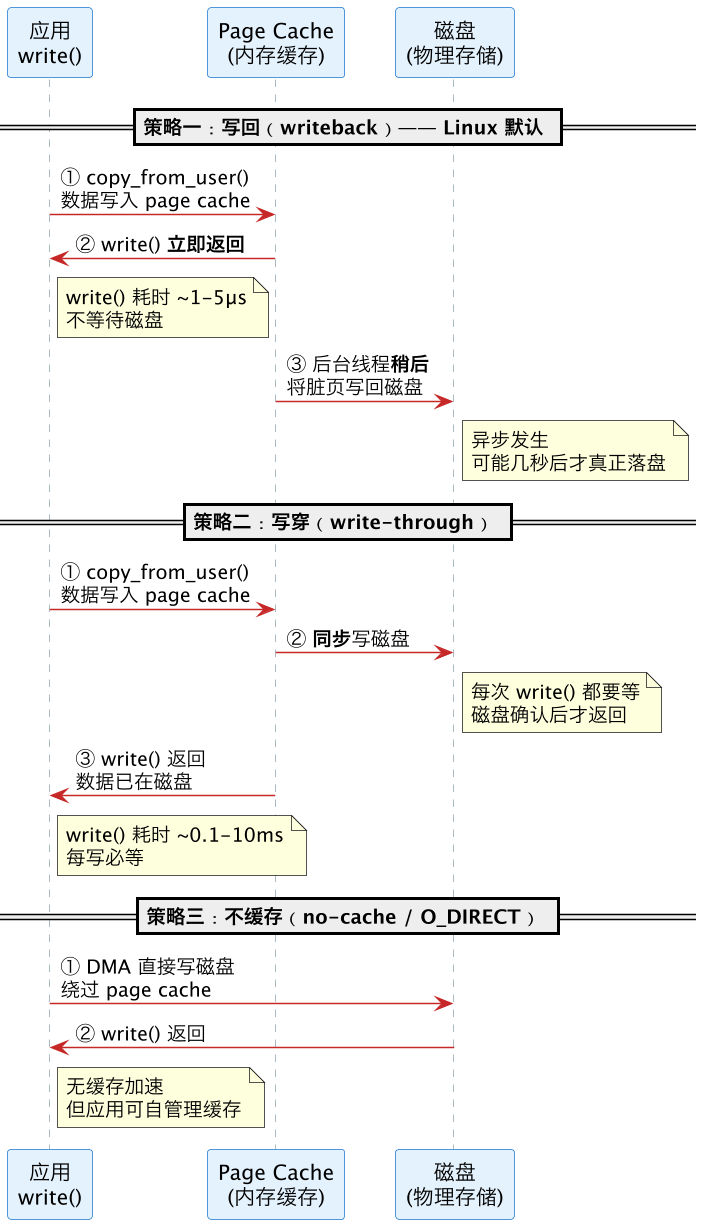
三种策略的全面对比:
| 维度 | 写回(writeback) | 写穿(write-through) | 不缓存(O_DIRECT) |
|---|---|---|---|
| write() 延迟 | 极低(~1-5μs) | 高(~0.1-10ms) | 高(~0.1-10ms) |
| write() 是否阻塞 | 几乎不阻塞 | 每次阻塞 | 每次阻塞 |
| 数据何时落盘 | 异步(最多 30s) | 同步(write 返回时) | 同步(write 返回时) |
| 数据安全性 | 弱(崩溃可能丢数据) | 强(每写必落盘) | 强 |
| 读加速 | 有(page cache 命中) | 有 | 无 |
| 内存占用 | 占用 page cache | 占用 page cache | 不占用 |
| CPU 拷贝 | 1 次(用户到 page cache) | 1 次 | 0 次(DMA 直传) |
| 适用场景 | 通用文件 IO、日志 | 数据库 WAL、关键元数据 | 数据库自管理缓存 |
| Linux 如何启用 | 默认 | 无原生支持,用 O_SYNC 近似 | open(O_DIRECT) |
| 崩溃一致性 | 需 fsync 保证 | 天然保证 | 需应用层保证 |
3.1.4 写回 vs 写穿的深层对比
为什么 Linux 默认选择写回而不是写穿?
写回(writeback)的优势:
- 写延迟极低:write() 只写内存,不等待慢速磁盘,延迟从毫秒级降到微秒级。对于 IOPS 密集的应用(如 Web 服务器写日志),吞吐量差距可达 10-100 倍。
- 写合并(write coalescing):同一个 page cache 页上的多次小写入可以在内存中合并,最终只产生一次磁盘 IO。写穿策略下,每次小写都要触发磁盘操作。
   写回:4次 write() → 4次 page cache 修改 → 1次磁盘 IO(合并后)

写穿:4次 write() → 4次 page cache 修改 + 4次磁盘 IO- 吸收突发写入:应用可能瞬间产生大量写入,page cache 像"蓄水池"一样先接住,后台慢慢排到磁盘。写穿策略下突发写入直接冲击磁盘,IO 队列满后应用被阻塞。
写穿(write-through)的适用场景:
- 数据库 WAL(Write-Ahead Log):redo log 必须保证"写穿"语义——日志记录必须先于数据页落盘,崩溃恢复才能重放。这就是为什么数据库通常用 O_SYNC 或 O_DIRECT 写 WAL。
- 文件系统元数据:inode、目录项等元数据通常需要更强的持久性保证。这就是为什么即使数据用写回,元数据日志(journal)往往用 barrier/FLUSH 强制有序。
- 关键配置/状态文件:不能容忍丢失的场景,直接用 O_SYNC 或每次写后 fsync。
折中方案:定期 fsync
实际应用中常见做法是:使用默认的写回策略享受高性能,同时定期调用 fsync() 保证关键数据落盘:
// 写回 + 定期 fsync:兼顾性能和安全
write(fd, buf, size);   // 快速返回(写回)
// ... 可以继续写更多 ...
fsync(fd);              // 强制所有脏页落盘,阻塞直到完成
这就是大多数数据库的 WAL 策略——日志写用 O_SYNC/O_DIRECT(写穿语义),数据页写用默认写回 + 定期 fsync(checkpoint)。
3.1.5 写回的风险与缓解
风险:数据丢失窗口
写回策略下,write() 返回后数据仅在 page cache 中。如果系统崩溃(掉电、内核 panic),尚未回写的脏页数据会丢失。丢失窗口最大为 dirty_expire_centisecs(默认 30 秒)+ dirty_writeback_centisecs(默认 5 秒)= 最多 35 秒的数据。
缓解手段:
| 手段 | 效果 | 代价 |
|---|---|---|
fsync() / fdatasync() | 应用主动要求落盘 | 阻塞等待磁盘 |
减小 dirty_expire_centisecs | 缩小丢失窗口 | 增加磁盘 IO 频率 |
减小 dirty_writeback_centisecs | 回写线程更频繁检查 | 略微增加 CPU 开销 |
| 使用 O_SYNC | 每次 write 等价于 write+fsync | 性能骤降 |
| 使用带电池的 RAID 卡 | 控制器缓存不怕掉电 | 硬件成本 |
3.1.6 关键参数
| 参数 | 含义 | 默认值 |
|---|---|---|
dirty_background_ratio | 脏页超过此比例时后台开始回写 | 10% |
dirty_ratio | 脏页超过此比例时同步等待回写(write() 会阻塞) | 20% |
dirty_expire_centisecs | 脏页超过此时长强制回写 | 3000(30秒) |
dirty_writeback_centisecs | 回写线程唤醒间隔 | 500(5秒) |
查看和调整:
sysctl -a | grep dirty或cat /proc/sys/vm/dirty_*
3.2 O_SYNC / O_DIRECT / fsync —— 强制落盘
| 方式 | 行为 | 何时阻塞 | 性能 |
|---|---|---|---|
| 默认 write() | 写到 page cache 即返回 | 仅脏页超比例时 | 最快 |
| fsync(fd) | 强制该文件所有脏页落盘 | 等磁盘 IO 完成 | 慢 |
| fdatasync(fd) | 强制该文件数据(不含元数据)落盘 | 等磁盘 IO 完成 | 比 fsync 稍快 |
| open(O_SYNC) | 每次 write() 等价于 write+fsync | 每次 write 都阻塞 | 最慢 |
| open(O_DIRECT) | 绕过 page cache,直接读写磁盘 | 每次 IO 都阻塞 | 对应用自管理缓存有利 |
// O_SYNC:每次 write 都等磁盘确认——最安全也最慢
int fd = open("file", O_WRONLY | O_SYNC);
write(fd, buf, 4096);  // 阻塞直到数据确实写入磁盘
// O_DIRECT:绕过 page cache,DMA 直接在用户 buf 和磁盘间传输
int fd = open("file", O_RDONLY | O_DIRECT);
// buf 必须对齐到 512 字节边界
read(fd, aligned_buf, 4096);  // 磁盘 DMA 直接写入 aligned_buf
四、read + write 组合:一次完整的数据搬运
把 read(从文件读)和 write(写入 socket/另一个文件)串起来看:
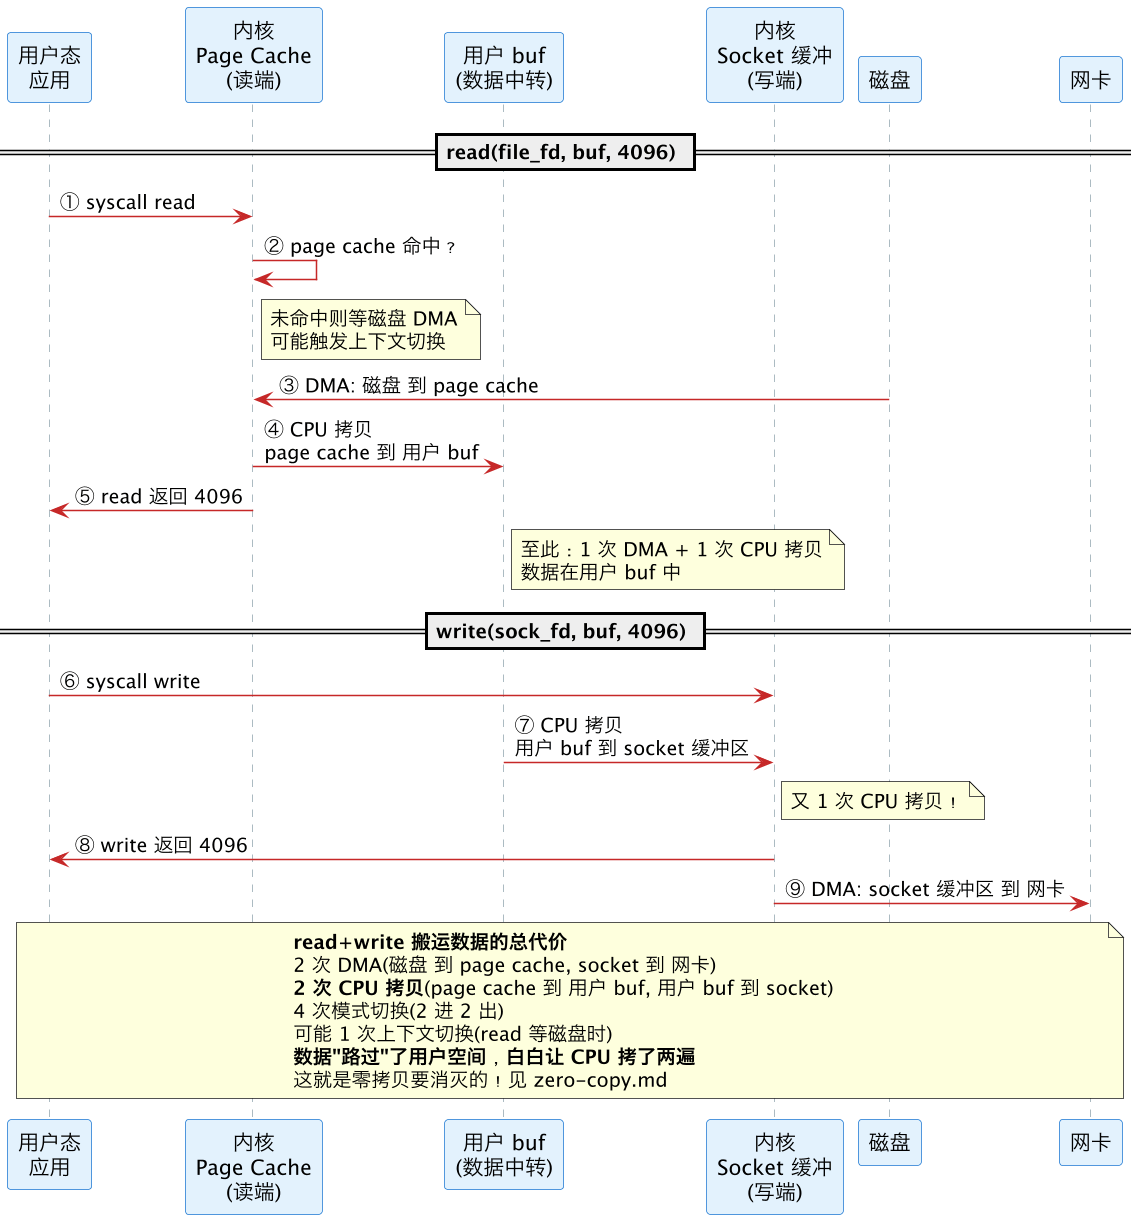
这就是传统 read+write 的问题——数据只是"路过"用户空间(应用没改它),CPU 却做了两次全量 memcpy。零拷贝(见 zero-copy)就是消除这中间的②③号 CPU 拷贝。
五、有没有线程切换?——完整分析
5.1 read+write 过程中的切换全景
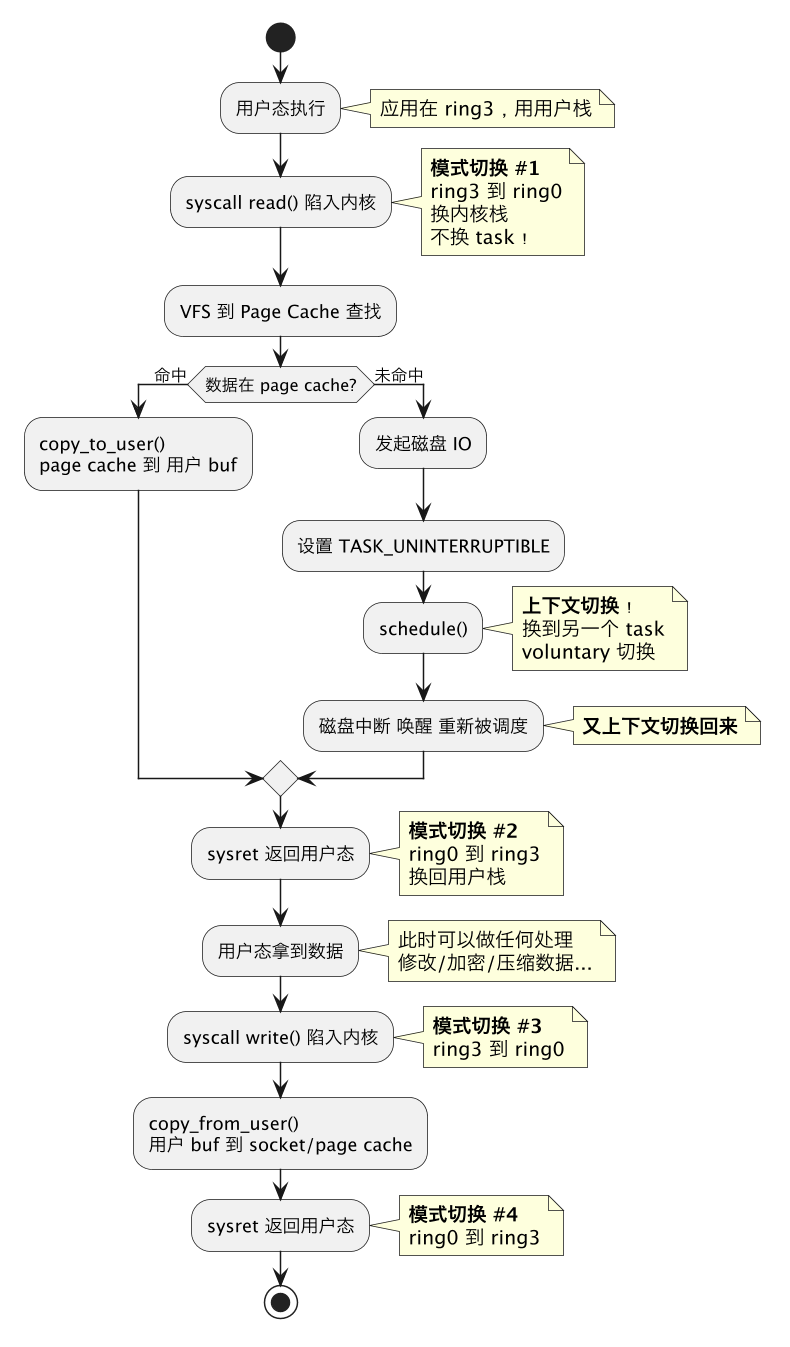
总结:一次完整的 read+write,至少发生:
| 切换类型 | 最少次数 | 最多次数 | 说明 |
|---|---|---|---|
| 模式切换(用户↔内核) | 4 | 4 | read 进/出 + write 进/出,每次都切 |
| 上下文切换(task A 到 B) | 0 | 2+ | read 等磁盘时可能切走再切回 |
| 栈切换(用户栈↔内核栈) | 4 | 4 | 每次模式切换都换栈 |
| 特权级切换(ring3↔ring0) | 4 | 4 | 硬件自动,每次模式切换都做 |
| CR3 切换(开 KPTI 时) | 4 | 4+ | KPTI 下用户/内核用不同页表,每次进出都换 |
5.2 栈的变化详解
时间线 →  read() 调用前    read() 内核态     read() 返回后    write() 内核态    write() 返回后
          ─────────────    ─────────────     ─────────────    ──────────────    ──────────────
栈指针 →  用户栈顶         内核栈顶           用户栈顶          内核栈顶           用户栈顶
          │              │                 │               │                │
          │ main()       │ sys_read()      │ main()        │ sys_write()    │ main()
          │ handler()    │ vfs_read()      │ handler()     │ vfs_write()    │ handler()
          │ read() ←─┐   │ filemap_read()  │ ...           │ copy_from_user │ ...
          │          │   │                 │               │                │
          │          │   └─ 用户 RIP/RSP   │               │                │
          │          │      保存在内核栈顶  │               │                │
          ▼          │                     ▼               │                ▼
特权级    ring3          ring0             ring3           ring0            ring3
页表      用户页表       内核页表            用户页表         内核页表           用户页表
         (KPTI:切到     (KPTI:用户+内核     (KPTI:切回      (KPTI:切到        (KPTI:切回
          内核页表)      都映射)             用户页表)        内核页表)          用户页表)
关键点:
- 每个 task 有两个栈:用户栈(ring3 用)和内核栈(ring0 用)
- 内核栈通常在
task_struct所在的页(thread_info也在那里),大小 8KB-16KB syscall指令自动切换栈:CPU 从 MSR 寄存器读取内核栈地址- 用户态的 RIP/RSP/RFLAGS 被硬件自动保存在内核栈顶(作为
pt_regs)
5.3 特权级切换的硬件细节
syscall 指令执行时 CPU 硬件的原子操作(不可中断):
1. RCX ← RIP          // 保存返回地址(syscall 的下一条指令)
2. R11 ← RFLAGS       // 保存标志寄存器
3. RIP ← MSR_LSTAR    // 跳到内核入口(开机时设定,固定地址)
4. CS ← MSR_STAR[47:32]  // 切换代码段为内核段(ring0)
5. SS ← MSR_STAR[47:32]+8 // 切换栈段
6. RFLAGS ← RFLAGS & ~MSR_FMASK  // 清除中断使能等标志
   // 注意:栈指针切换不是硬件自动的!
   // 内核入口第一条指令通常就是 swapgs + mov rsp, ...
sysret 返回时:
1. RIP ← RCX          // 恢复用户态返回地址
2. RFLAGS ← R11       // 恢复标志寄存器
3. CS ← MSR_STAR[63:48] // 切回用户代码段(ring3)
4. SS ← MSR_STAR[63:48]+8 // 切回用户栈段
   // 内核代码负责恢复用户栈指针 RSP
这就是为什么 syscall 使用
rcx和r11保存返回信息——普通函数调用约定中rcx是第四个参数,r11是临时寄存器,syscall 征用了它们。
5.4 为什么阻塞 IO 一定要切走?—— wait_queue 内部机制
当 page cache 未命中时,filemap_read() 调用 wait_on_page_locked() 等待磁盘 IO 完成。这不是简单的 while 循环——背后是等待队列(wait_queue)和调度器的精密配合。
5.4.1 等待队列的数据结构
// include/linux/wait.h (简化)
struct wait_queue_entry {
    unsigned int        flags;
    void               *private;          // 指向 task_struct
    wait_queue_func_t   func;             // 唤醒回调函数
    struct list_head    entry;            // 挂在 wait_queue_head 上
};
struct wait_queue_head {
    spinlock_t          lock;             // 保护链表的自旋锁
    struct list_head    head;             // wait_queue_entry 链表
};
每个"可能阻塞的点"都有一个 wait_queue_head:
page->wait— 等待该页 IO 完成inode->i_wait— 等待 inode 锁释放bdev->bd_wait— 等待块设备就绪file->f_wait— 等待文件状态变化(如 O_NONBLOCK 的 FIFO)
5.4.2 完整的"睡下去"过程
page cache miss 时的阻塞流程(逐行对应内核代码):
步骤 1: 准备等待
  wait_queue_entry_t wait;
  init_wait_entry(&wait, current);   // current = 当前 task
  // wait.private = current
  // wait.func    = autoremove_wake_function  (默认唤醒回调)
步骤 2: 把自己加入等待队列
  spin_lock_irq(&page->wait.lock);
  __add_wait_queue(&page->wait, &wait);  // 挂到 page->wait.head 链表
  spin_unlock_irq(&page->wait.lock);
步骤 3: 设置 task 状态并调度
  set_current_state(TASK_UNINTERRUPTIBLE);  // 不可中断睡眠
  // 此时 task 的状态标志已改,但 CPU 还在跑这个 task
  // ★ 关键:这是"设置意图",真正的切换在 schedule() 中发生
步骤 4: 主动让出 CPU
  schedule();  // ← 真正的上下文切换发生在这里!
  // ... 若干毫秒后,被唤醒,从这里继续执行 ...
步骤 5: 被唤醒后
  set_current_state(TASK_RUNNING);     // 恢复为可运行状态
  // 检查自己是否真的被唤醒了(而非虚假唤醒)
  if (!page->flags & PG_locked)
      break;  // IO 已完成,页已解锁
为什么在 schedule() 之前先 set_current_state(TASK_UNINTERRUPTIBLE)?
这是一个先声明意图、再让出 CPU 的两步协议:
如果反过来(先 schedule 再改状态)会怎样?
  错误顺序:
  ① schedule() — CPU 切走了
  ② (在别的 CPU 上,磁盘中断到达,唤醒等待队列)
  ③ 唤醒函数检查等待队列上每个 task 的状态
     → task 状态还是 TASK_RUNNING!
     → 唤醒函数跳过它(以为它不需要唤醒)
  ④ task 永远不会被唤醒 → 死锁!
  正确顺序:
  ① set_current_state(TASK_UNINTERRUPTIBLE) — 先声明"我要睡了"
  ② schedule() — 再让出 CPU
  ③ 中断到达时,唤醒函数看到状态 = TASK_UNINTERRUPTIBLE
     → 将其状态改回 TASK_RUNNING 并放入就绪队列
  ✓ 正确唤醒
5.4.3 完整的"醒过来"过程
// 磁盘中断 → bio_endio() → 最终调用 unlock_page()
void unlock_page(struct page *page)
{
    // 1. 清除 PG_locked 标志
    //    并使用内存屏障确保其他 CPU 可见
    clear_bit_unlock(PG_locked, &page->flags);
    smp_mb__after_atomic();  // 保证唤醒之前所有 CPU 都看到页已解锁
    // 2. 唤醒等待队列上的所有 task
    wake_up_page(page, PG_locked);
}
// wake_up_page() → __wake_up_common()
static void __wake_up_common(struct wait_queue_head *wq_head, ...)
{
    struct wait_queue_entry *entry;
    list_for_each_entry(entry, &wq_head->head, entry) {
        // 对队列上每个等待者,调用其唤醒函数
        // 默认是 autoremove_wake_function
        entry->func(entry, ...);
    }
}
// autoremove_wake_function() 做三件事:
int autoremove_wake_function(wait_queue_entry_t *entry, ...)
{
    // 1. 把 entry 从等待队列上摘下来
    list_del_init(&entry->entry);
    // 2. 把 task 状态改回 TASK_RUNNING
    // 3. 把 task 放回就绪队列 (runqueue)
    return try_to_wake_up(entry->private, TASK_NORMAL, ...);
    //                                          ↑
    //                              entry->private 就是 task_struct
}
唤醒后的关键动作 try_to_wake_up():
try_to_wake_up(p) 做了什么:
1. 检查 p 当前状态
   → 是 TASK_UNINTERRUPTIBLE / TASK_INTERRUPTIBLE?
   → 是,将其改为 TASK_RUNNING
2. 选择目标 CPU
   → 优先选 p 上次运行的 CPU(缓存还是热的)
   → 若该 CPU 被隔离(isolcpus)或离线,选空闲的 CPU
   → 见调度器的 select_task_rq()
3. 将 p 放入目标 CPU 的就绪队列 (runqueue)
   → enqueue_task(rq, p, ENQUEUE_WAKEUP)
   → 若 p 的优先级高于当前 task,设置 TIF_NEED_RESCHED 标志
4. 返回
   → p 现在是 TASK_RUNNING 状态,在就绪队列中等待调度
   → 被唤醒不等于立刻执行,需要等调度器选中它
5.5 从 schedule() 到 switch_to() 的完整时间线
当 page cache miss 的 task 调用 schedule() 后,到底发生了什么?下面是把"切走"和"切回"拼起来的完整视角:
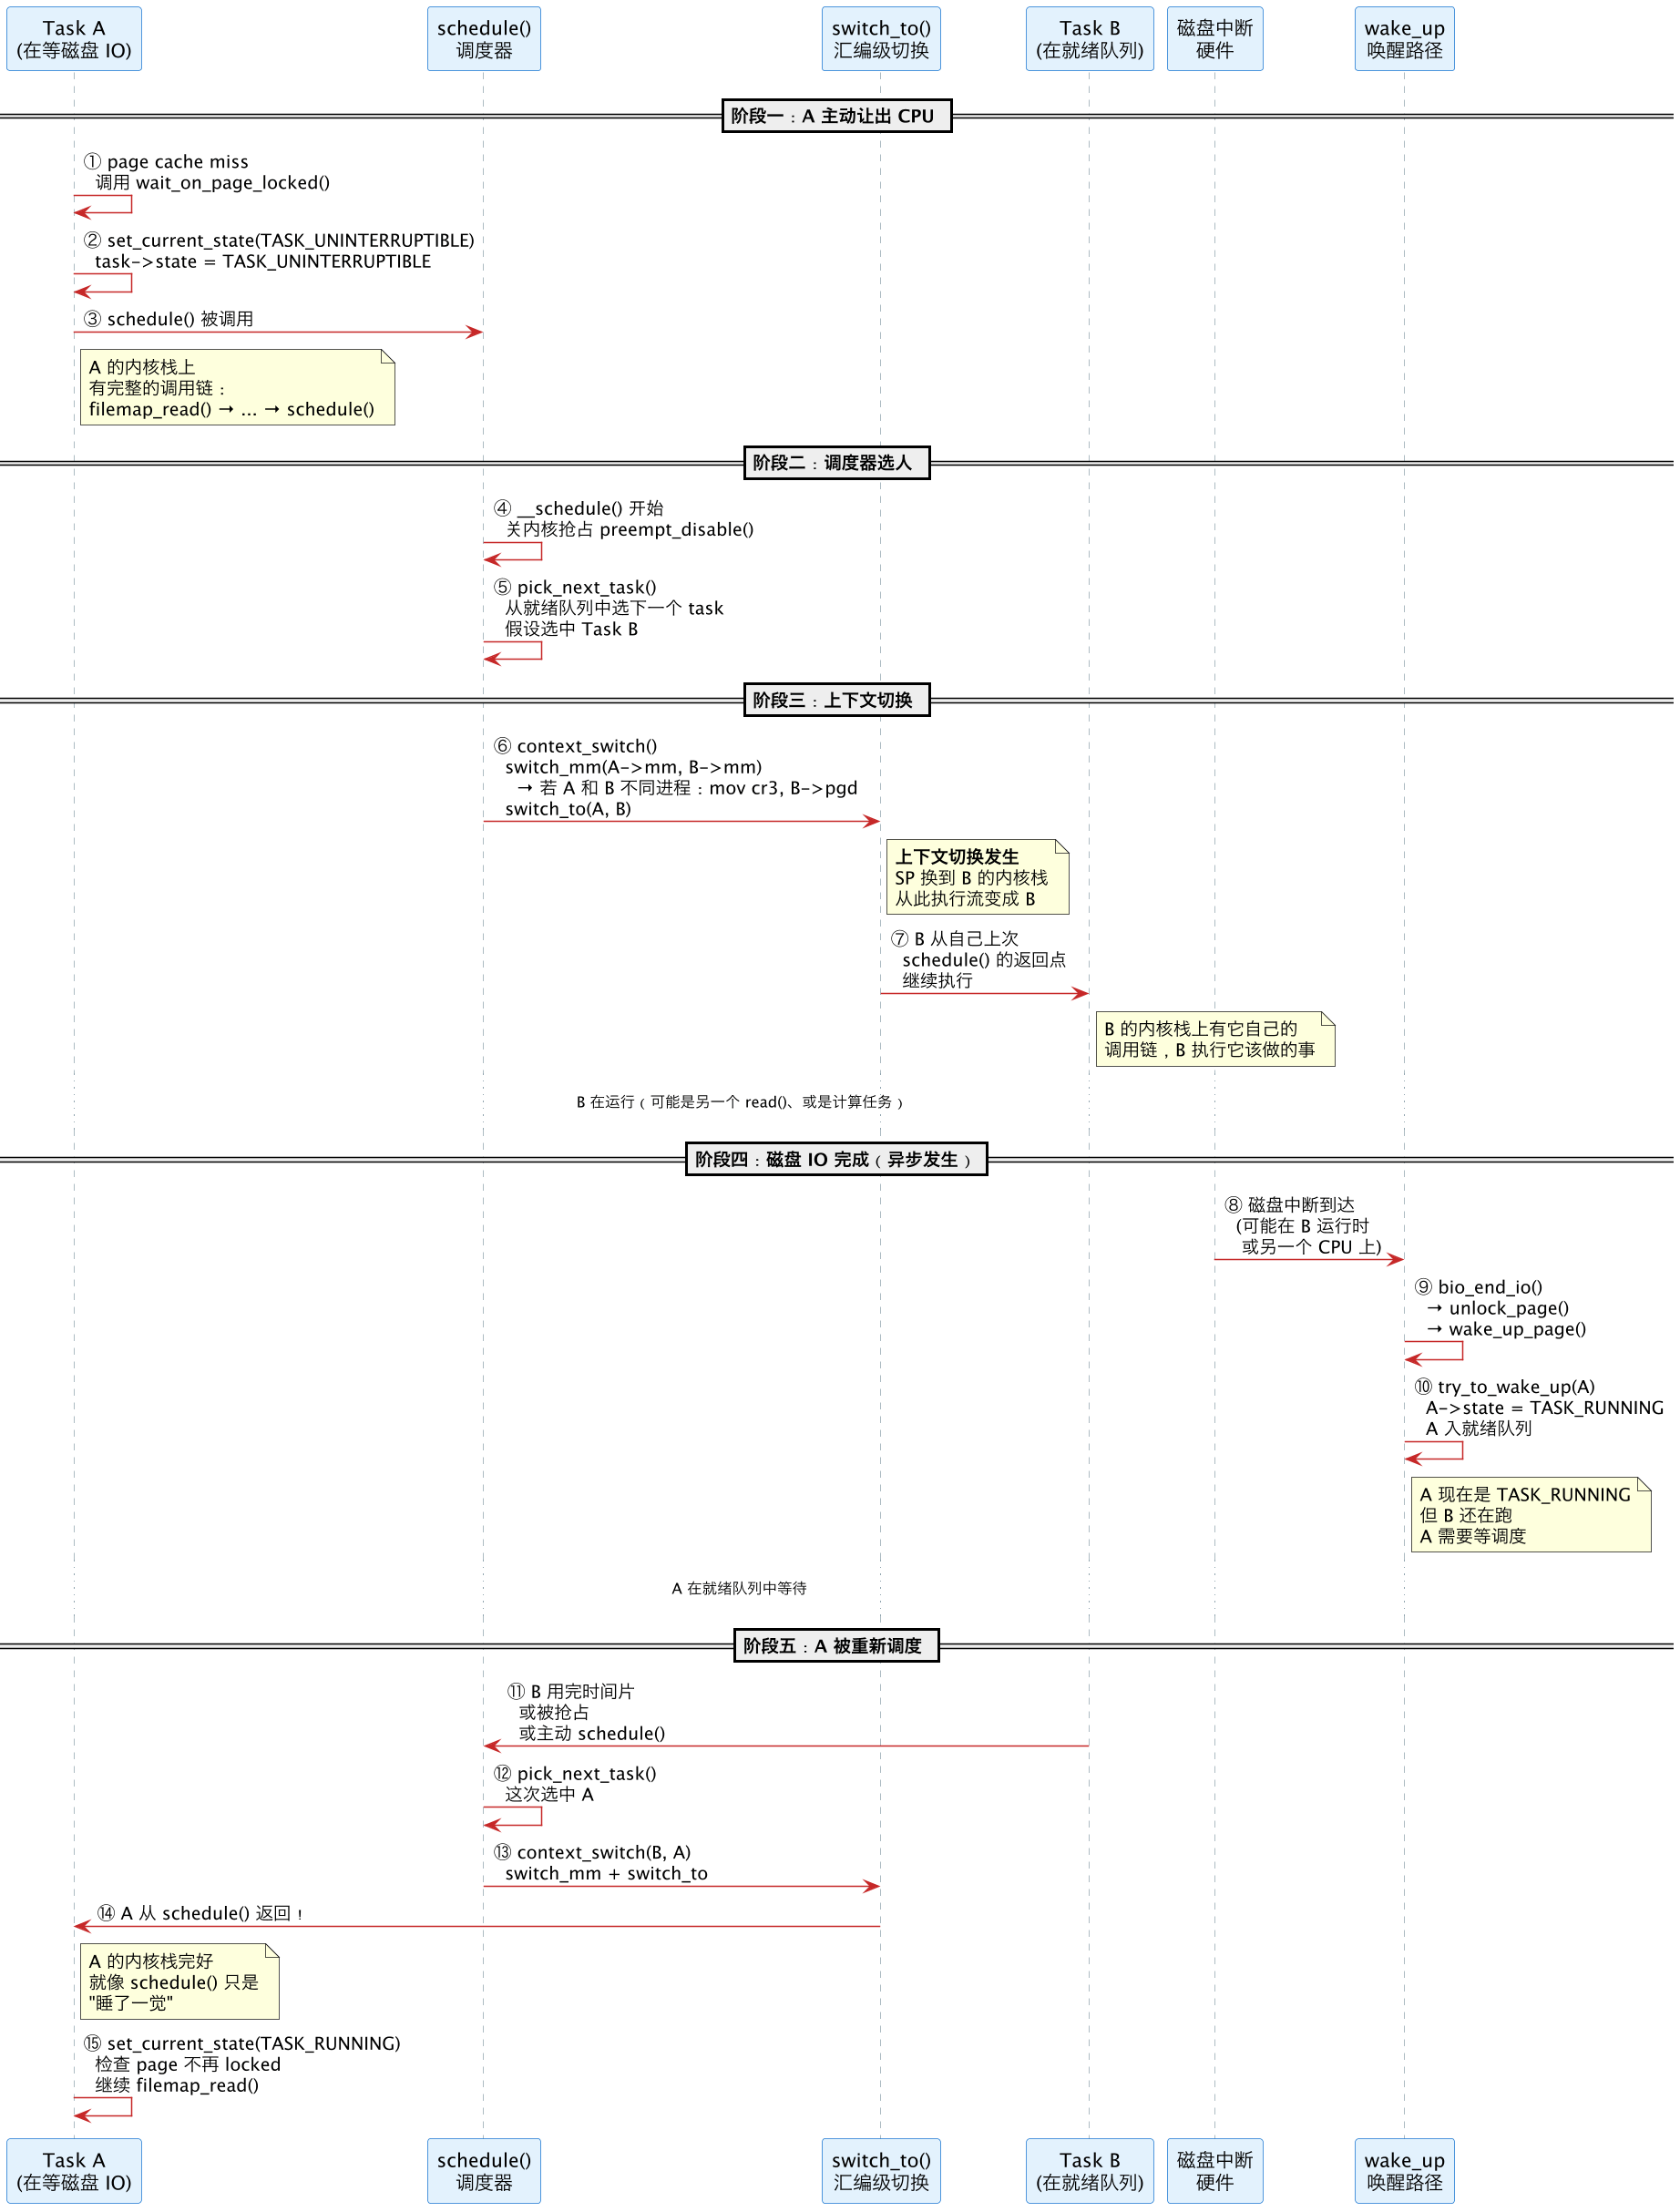
这个时间线揭示的关键事实:
| 阶段 | 谁在跑 | A 的状态 | page cache 页的状态 |
|---|---|---|---|
| ①-② | A | TASK_RUNNING | PG_locked |
| ③-⑥ | A(正在切走) | TASK_UNINTERRUPTIBLE | PG_locked |
| ⑦ | B | TASK_RUNNING | PG_locked |
| ⑧-⑩ | B(中断可能在其他 CPU) | TASK_UNINTERRUPTIBLE → TASK_RUNNING | 解锁了! |
| ⑪-⑬ | B(正在切走) | TASK_RUNNING(在就绪队列) | 已解锁 |
| ⑭-⑮ | A(回来了!) | TASK_RUNNING | 已解锁,数据就绪 |
A 的视角:schedule() 就像一个很慢的函数调用——调用时传入"我要等 IO",返回时 IO 已经完成了。A 的内核栈原封不动,所有局部变量都在,就像时间被冻结了。
5.6 为什么 page cache miss 不直接用 TASK_INTERRUPTIBLE?
// 为什么内核用 TASK_UNINTERRUPTIBLE 而不是 TASK_INTERRUPTIBLE?
// 这是故意的设计选择:
// TASK_INTERRUPTIBLE:
//   → 可以被信号(signal)唤醒
//   → 如果被信号唤醒,read() 返回 -EINTR
//   → 用户程序需要处理 EINTR 并重新调用 read()
//   → 对磁盘 IO 不合适——数据没读完,返回 -EINTR 破坏了语义
// TASK_UNINTERRUPTIBLE:
//   → 信号不能唤醒,只能由等待的事件(磁盘 IO 完成)唤醒
//   → 保证 read() 要么返回实际读到的字节,要么返回错误
//   → 不会出现"读到一半被信号打断"的情况
但这有一个著名的副作用——D 状态进程:
# 如果一个磁盘 IO 永远不完成(NFS 服务端挂了、SAN 断连)
# 等待该 IO 的进程会永远卡在 TASK_UNINTERRUPTIBLE
# 这就是 top 中看到的 D 状态(不可中断睡眠)
$ ps aux | grep ' D'
# root  12345  0.0  0.0  0  0 ?  D   Jan01  0:00 [nfs_io]
# ↑ 状态 D = TASK_UNINTERRUPTIBLE
# 这个进程 kill -9 都杀不掉——它不响应信号!
# 只能等 IO 恢复或重启机器
5.7 并发 IO 场景下的线程切换交互
当多个线程同时对不同文件(或同一文件不同偏移)调用 read() 时,上下文切换的行为会更复杂:
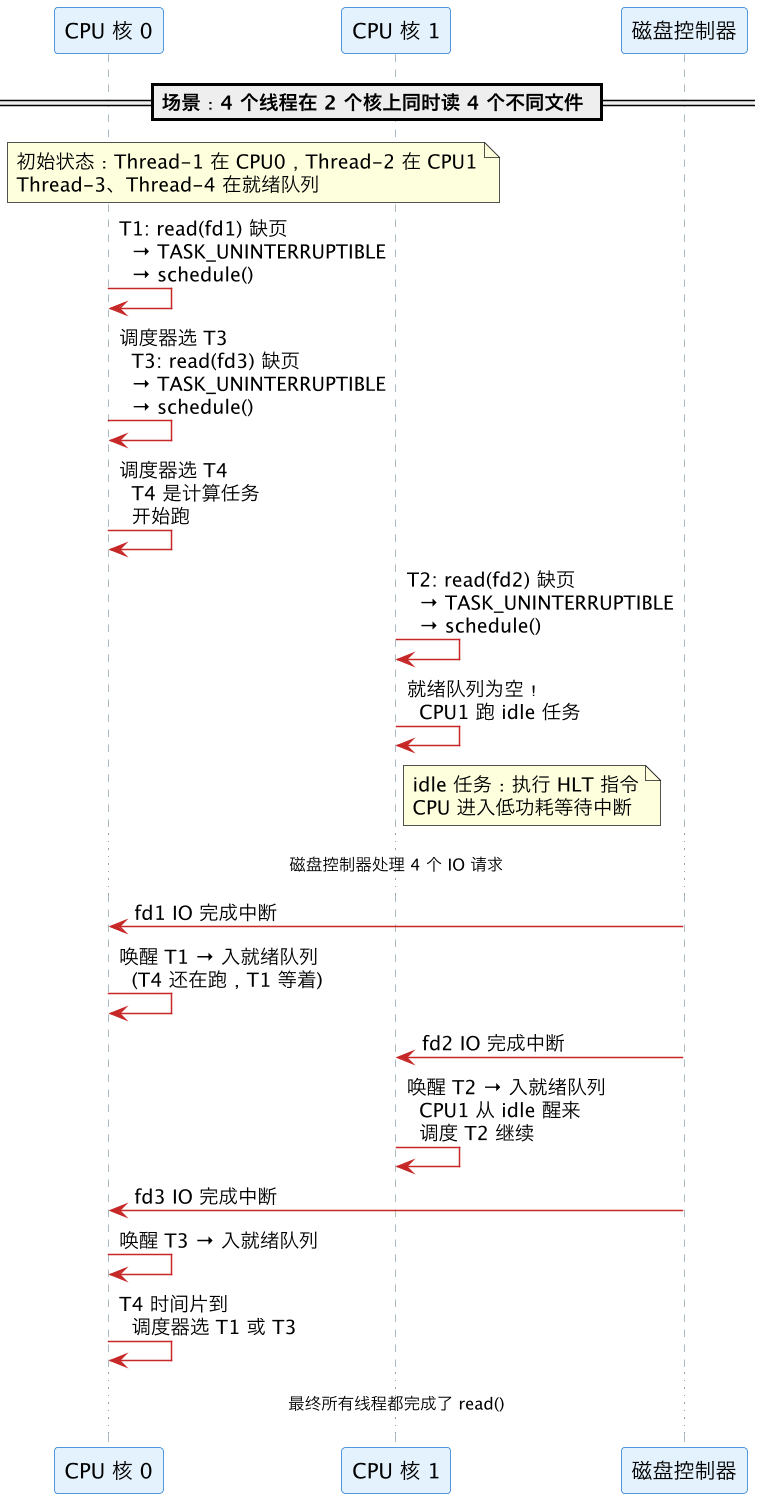
关键观察:
| 现象 | 原因 | 性能影响 |
|---|---|---|
| 多个线程同时 read 不同文件 | 每个缺页都触发一次上下文切换 | 切换次数 = 线程数 × 2(切走+切回) |
| IO 密集型 CPU 利用率低 | 大量线程在 TASK_UNINTERRUPTIBLE,CPU 跑 idle | 瓶颈在磁盘而非 CPU |
| 线程数 > 磁盘 IOPS 时 | 更多线程不会提升吞吐,只会增加切换开销 | 需要限制并发 IO 数(线程池/io_uring) |
| 中断可能在不同 CPU 上处理 | 唤醒和 IO 完成解耦,利用多核 | IRQ affinity 可优化 |
iowait 的含义(见 iowait):
当 CPU 空闲且有至少一个 task 在等该 CPU 发起的 IO 时,这段空闲时间被计入 iowait。但注意——如果 IO 是其他 CPU 发起的,或者该 CPU 在跑 idle 但没有 task 在等 IO,就不算 iowait。
5.8 read+write 中上下文切换的全景汇总
把上下文切换、模式切换、栈切换放在同一张表里对比:
| 切换类型 | 触发时机 | 切换了什么 | 开销 | 是否必然发生 |
|---|---|---|---|---|
| 模式切换 | syscall/sysret 指令 | CS(代码段)、特权级 ring3↔ring0、栈指针 | ~100-200 cycles | 是(每次 read/write 各 2 次) |
| 上下文切换-切走 | schedule() 被调用 | 寄存器现场、SP(换内核栈)、可能 CR3 | ~1-5μs 显性 + 5-50μs 隐性 | 否(仅 page cache miss 或脏页超限时) |
| 上下文切换-切回 | 被调度器选中 | 寄存器现场、SP、可能 CR3 | 同上 | 否(同上) |
| KPTI CR3 切换 | 每次模式切换时(若开启 KPTI) | CR3 寄存器 → TLB 刷新 | ~300-500 cycles(无 PCID) ~100 cycles(有 PCID) | 是(开启 KPTI 时) |
| FPU 惰性切换 | 切换后新 task 首次用浮点 | x87/SSE/AVX 寄存器组 | 0(若不用) ~256B-2KB 的保存/恢复 | 否(仅新 task 用浮点时) |
read+write 中切换的三种典型场景:
场景一:page cache 命中(最快路径)
  read()  2 次模式切换(进/出)
  write() 2 次模式切换(进/出)
  上下文切换:0 次
  KPTI CR3 切换:4 次
  总开销:~1-2μs(模式切换)+ ~1μs(KPTI 若开启)
  ★ 这是最快的路径——数据已经在内存里
场景二:page cache 未命中(磁盘 IO)
  read()  2 次模式切换 + 1 次上下文切换(切走)+ 1 次上下文切换(切回)
  write() 2 次模式切换
  上下文切换:2 次
  总开销:~1-2μs(模式切换)+ ~2-10μs(上下文切换显性)+ ~5-50μs(缓存恢复)
  实际延迟:~0.1-10ms(磁盘 IO 占主导)
  ★ 上下文切换本身开销不大,真正慢的是磁盘
场景三:write 触发脏页回写
  read()  2 次模式切换(假设命中)
  write() 2 次模式切换 + 可能 1-2 次上下文切换(等脏页回写)
  上下文切换:0-2 次
★ write() 通常不阻塞,但脏页超限时会一句话:read+write 中"有没有线程切换"取决于 page cache 是否命中。命中了就 0 次上下文切换(只有模式切换),没命中就 1-2 次(等磁盘 IO)。上下文切换本身的显性开销(1-5μs)远小于磁盘 IO 延迟(0.1-10ms),但切换后的缓存恢复期(5-50μs)在并发场景下不可忽视。详见 context-switch §5.6。
六、数据流的走向:内存在哪、谁在搬
| 数据搬运动作 | 谁在搬 | 经过什么总线 | 内存带宽消耗 |
|---|---|---|---|
| ① 磁盘 到 page cache | DMA 控制器 | PCIe 到 内存总线 | 1x 数据量 |
| ② page cache 到 用户 buf | CPU(memcpy) | 内存总线(读+写) | 2x 数据量(读出再写入) |
| ③ 用户 buf 到 socket 缓冲 | CPU(memcpy) | 内存总线(读+写) | 2x 数据量 |
| ④ socket 到 网卡 | DMA 控制器 | 内存总线 到 PCIe | 1x 数据量 |
| 总计 | 6x 数据量的内存带宽 |
1MB 数据搬运 → 消耗 6MB 内存带宽。高并发下这很快成为瓶颈。零拷贝(sendfile+SG-DMA)把②③都省掉 → 只用 2x 带宽。
七、观测与调试
# 跟踪 read/write 系统调用
strace -e trace=read,write -T ./app     # -T 显示每次耗时
strace -c ./app                          # 统计次数和总耗时
# 查看 page cache 命中率
cat /proc/vmstat | grep pg
# pgpgin  - 从磁盘读入的页数(page-in)
# pgpgout - 写出到磁盘的页数(page-out)
# pgfault - 缺页次数(含 page cache miss)
# 查看 IO 统计
iostat -x 1                              # 磁盘 await/svctm/%util
cat /proc/<pid>/io                       # 进程级 IO 统计
# read_bytes, write_bytes, cancelled_write_bytes
# 查看上下文切换
pidstat -w 1                             # 自愿/非自愿切换
vmstat 1                                 # cs 列
# 火焰图看内核态耗时
perf record -g -e syscalls:sys_enter_read ./app
perf script | stackcollapse-perf.pl | flamegraph.pl > read.svg
八、与仓库其他文档的关系
- 系统调用机制:syscall(陷入/返回的细节、开销、vDSO)
- 上下文切换:context-switch(四大触发场景、switch_mm/switch_to、切进程 vs 切线程)
- DMA 原理:dma(磁盘 DMA 如何读写 page cache、SG-DMA)
- Page Cache:mmap(mmap 四象限、page cache 映射机制)
- 零拷贝:zero-copy(sendfile/splice 如何省掉 read+write 的 CPU 拷贝)
- 中断处理:interrupts(磁盘 IO 完成中断如何唤醒阻塞的 task)
- 块层调度:iostat(iostat 观测磁盘 IO)
九、一句话总结
一次最简单的 read+write 搬运数据,至少经历 4 次特权级模式切换(用户↔内核)、2 次 CPU memcpy(page cache↔用户 buf↔socket 缓冲)、可能 1-2 次上下文切换(等磁盘 IO 时),数据在内存里被 CPU 来回搬了两趟、每次搬动都消耗 2 倍内存带宽(读+写)。栈从用户栈切到内核栈再切回来、CR3 在 KPTI 下也要切——所有这些都是纯开销。理解这条链路是理解"为什么要零拷贝"、"为什么要用 io_uring"、"为什么 page cache 未命中时系统变慢"的基础。