C++ 内存序(memory_order)—— 从语义模型讲透六个选项
前面的 memory-reordering 从硬件讲内存序(四种重排、store buffer / invalidate queue、屏障挡哪种),atomic 从原子操作讲。但很多人"内存序一直没弄明白",卡的不是硬件,而是 C++ 语言层的语义模型——
memory_order到底在承诺什么、acquire/release为什么要配对、relaxed到底能不能用。
本篇换一个视角:自顶向下,从 C++ 标准的 happens-before 模型讲起,把六个
memory_order逐个讲清它"保证什么、不保证什么",每个都配一段可运行的代码。读完能回答:"这段并发代码该用哪个 order,为什么。" 硬件成因请回看 memory-reordering,二者互补。
一、先建立一个心智模型:内存序管的是"可见性顺序",不是"执行速度"
初学者最大的误解:以为 memory_order 是性能开关、或者"让代码按顺序执行"。都不是。它回答的是一个更微妙的问题:
一个线程对内存的修改,别的线程能不能看到、以什么顺序看到?
单线程里这从来不是问题(你写了就能读到)。但多线程 + 多核下,由于编译器重排、CPU 乱序、store buffer 延迟可见(reordering-overview 的三层),"我写了 x=1" 和 "你看到 x==1" 之间没有天然的顺序保证。memory_order 就是你用来建立这种跨线程顺序保证的工具。

核心认知:
memory_order是加在原子操作上的"顺序约束标签"——它约束的不只是这个原子变量本身,而是这个原子操作周围那些普通读写能不能"搭车"跨线程可见。理解这句话,就理解了 acquire/release 的全部。
二、两个关键概念:happens-before 与 synchronizes-with
C++ 内存模型的全部正确性,建立在一个关系上:happens-before(先行发生)。
- 定义(够用版):如果操作 A happens-before 操作 B,那么 A 的所有内存效果对 B 保证可见。反过来,两个操作若没有 happens-before 关系,它们就是"数据竞争"——结果未定义(UB)。
- 单线程内:程序顺序(sequenced-before)天然构成 happens-before——所以单线程永远自洽。
- 跨线程:默认没有 happens-before!必须靠同步操作建立。这就是
synchronizes-with(同步于)出场的地方。
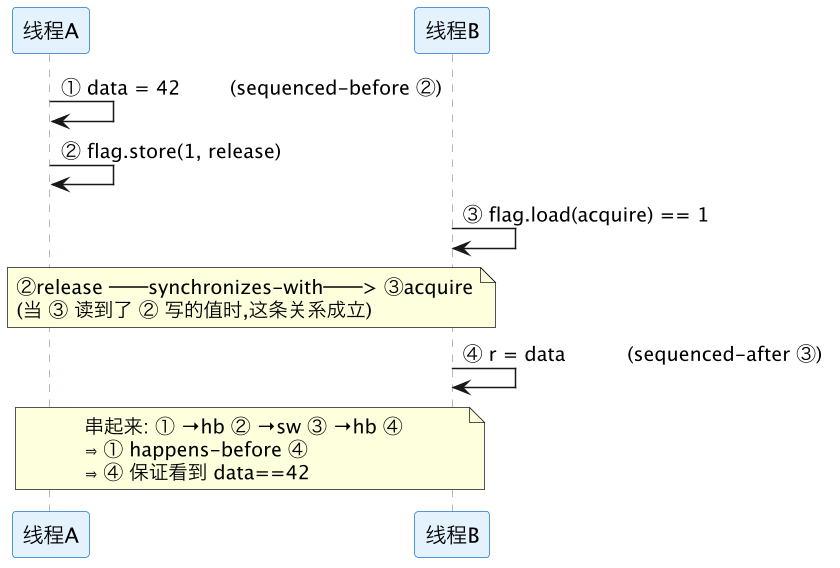
这就是整个模型的引擎:
release写 与 读到该值的acquire读 之间,建立一条 synchronizes-with。- 它像一座桥:把"release 之前的所有写"和"acquire 之后的所有读"用 happens-before 连起来。
- 于是
data=42(release 前)对r=data(acquire 后)可见——哪怕 data 本身是个普通非原子变量。
一句话:
acquire/release不是给那个原子变量用的,是用来在两个线程之间架一座 happens-before 的桥,让桥这头的普通写对桥那头的普通读可见。这座桥只有当 acquire 真的读到了 release 写的值时才建立——这是最容易忽略的前提。
三、六个 memory_order 逐个讲
C++ 有六个枚举,实际是四档语义(acquire/release/acq_rel 是同一档的三个方向):
| memory_order | 用在 | 保证 | 典型场景 |
|---|---|---|---|
relaxed | 读/写 | 只保证这个变量本身的原子性,不建立任何跨线程顺序 | 计数器、统计量 |
acquire | 读 | 此后的读写不能重排到它之前;能"收下"配对 release 的桥 | 加锁、读标志位 |
release | 写 | 此前的读写不能重排到它之后;发出一座给 acquire 的桥 | 解锁、发布数据 |
acq_rel | 读改写(RMW) | 同时是 acquire + release(读的部分 acquire、写的部分 release) | fetch_add 兼收发 |
seq_cst | 读/写 | 在 acquire/release 之上,再加全局单一总顺序(所有线程看到的 seq_cst 操作顺序一致) | 默认;需要全序推理时 |
consume | 读 | acquire 的弱化版(只对数据依赖链建立顺序)——实践中已被劝退,当 acquire 用 | 几乎不用 |
下面挑三档最关键的,各配可运行代码。
3.1 relaxed —— 只要原子性,不要顺序
#include <atomic>
#include <thread>
#include <vector>
std::atomic<long> counter{0};
void work() {
    for (int i = 0; i < 1'000'000; ++i)
        counter.fetch_add(1, std::memory_order_relaxed);  // 只需计数不丢,不关心顺序
}
int main() {
    std::vector<std::thread> ts;
    for (int i = 0; i < 4; ++i) ts.emplace_back(work);
    for (auto& t : ts) t.join();
    // counter 一定等于 4'000'000:relaxed 仍保证每次 +1 不丢(原子性)
    // 但多个 relaxed 操作之间的先后,别的线程看到的顺序不保证
}- 能用 relaxed 的判据:这个原子变量的值,不用来"守卫"其它数据的可见性。计数器就是典型——你只在乎最终计数对,不在乎"看到 counter==500 时别的什么也得可见"。
- 不能用 relaxed 的场景:一旦你想"看到 flag==1 就认为 data 已就绪",relaxed 立刻错——它不建桥,data 可能还没可见。
3.2 release / acquire —— 发布-订阅的标准姿势
这是 producer/consumer、无锁队列、"填好数据再抬起标志"的核心。回到第二节那张图的代码:
#include <atomic>
#include <thread>
#include <cassert>
int data = 0;                     // 普通变量,非原子
std::atomic<bool> ready{false};
void producer() {
    data = 42;                                        // ① 普通写
    ready.store(true, std::memory_order_release);     // ② release:把①"封"进桥
}
void consumer() {
    while (!ready.load(std::memory_order_acquire))    // ③ acquire:等桥
        ;
    assert(data == 42);   // ④ 一定成立!①happens-before④
}- 为什么对:③ 读到 ② 写的
true的那一刻,②─sw→③ 成立,① happens-before ④,所以data==42保证可见。 - 为什么必须配对:只有 producer 用 release、consumer 也用 acquire,桥才架得起来。任一边换成 relaxed,桥就断,
data的可见性失去保证,assert可能失败(尤其在 ARM 等弱内存模型上,x86 因 TSO 较强可能碰巧不炸——但那是运气,不是正确,见 memory-reordering §3)。 - 对应硬件:release ≈ 排空 store buffer 让
data=42先出去;acquire ≈ 排空 invalidate queue 让data的旧副本作废、读到新值。详见 store-buffer / invalidate-queue。
3.3 seq_cst —— 默认档,唯一提供"全局总顺序"
acquire/release 只保证"配对的两个线程之间"有序,不保证所有线程对所有 seq_cst 操作看到同一个全局顺序。有些算法(如 Dekker 互斥、多个标志位交叉判断)需要更强的保证:存在一个所有线程一致同意的单一总顺序。这就是 seq_cst。
#include <atomic>
#include <thread>
std::atomic<bool> x{false}, y{false};
int z = 0;
void write_x() { x.store(true, std::memory_order_seq_cst); }
void write_y() { y.store(true, std::memory_order_seq_cst); }
void read_x_then_y() { while (!x.load(std::memory_order_seq_cst)); if (y.load(std::memory_order_seq_cst)) ++z; }
void read_y_then_x() { while (!y.load(std::memory_order_seq_cst)); if (x.load(std::memory_order_seq_cst)) ++z; }
// 四个线程各跑一个。seq_cst 保证 z 不可能为 0
// (存在全局总顺序 → 不可能两个 reader 都认为"我这个先、对方那个后")
// 若把这些换成 acquire/release,z==0 是可能的(没有全局总顺序,StoreLoad 重排暴露)- 代价:
seq_cst是唯一能压住 StoreLoad 重排的档(要强排 store buffer,x86 上编译成mfence/lock),所以最贵。见 memory-reordering §5。 - 为什么是默认:
std::atomic不写 order 就是seq_cst——最强、最不容易错。语言把"安全"设成默认,把"更快但要自己想清楚"(acquire/release/relaxed)留给你显式选择。
四、决策树:这段代码该用哪个 order?
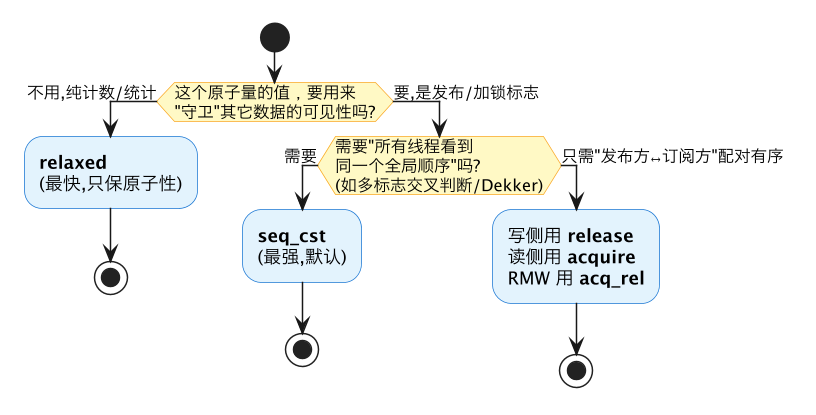
实践准则:
- 拿不准就用默认
seq_cst——正确性优先,它永远不会错,只是可能不是最快。 - 热点路径再考虑放松:能证明"只是计数"→
relaxed;能证明"只需配对发布-订阅"→release/acquire。 consume别用:语义复杂、编译器普遍当acquire实现,标准委员会自己都在劝退。- **放松内存序是"高危优化" **:错了不会崩在测试机(x86 强模型常常碰巧对),而是上线后在 ARM 服务器上偶发、极难复现。所以放松之前,必须能用 happens-before 说清楚"为什么这里够"。
五、常见误区速查
| 误区 | 真相 |
|---|---|
| "memory_order 让代码按顺序执行" | 不。它约束跨线程可见性顺序,不改变单线程执行、也不是"关掉乱序" |
| "用了 atomic 就线程安全了" | 只保证单个操作原子;多个操作的顺序/组合仍要靠 order 或锁 |
| "relaxed 就是不安全" | relaxed 仍保证原子性(计数不丢),只是不建立跨线程顺序——用对场景完全安全 |
| "acquire 单独用就行" | 不。acquire 必须有配对的 release 才架起桥;单边等于没有 |
| "x86 上测过没问题就对了" | x86 是强模型(TSO),会掩盖很多错;搬到 ARM 才暴露。正确性要靠模型推理,不靠平台运气 |
| "seq_cst 慢,能不用就不用" | 先保证对再谈快;seq_cst 是默认正是因为它最不容易错 |
六、和本仓库其他文档的关系
- 硬件成因(为什么会有重排、屏障怎么对应):memory-reordering(四种重排 × 成因 × 架构)、store-buffer(release 对应排空它)、invalidate-queue(acquire 对应排空它)。本篇讲语言语义,那几篇讲硬件机制——遇到"为什么"回去看它们。
- 原子操作本身:atomic(
lock前缀、CAS、RMW、争用开销)——memory_order是加在这些原子操作上的标签。 - 三层重排框架:reordering-overview——理解"编译器重排也要 memory_order 一起压住"。
- 观测:
seq_cst用多了看perf stat -e machine_clears.memory_ordering(见 perf)。
七、一句话总结
memory_order是加在原子操作上的"跨线程可见性标签",靠 release↔acquire 配对建立 happens-before 的桥,让桥这头的普通写对桥那头的普通读可见。四档:relaxed(只保原子性、不建桥,用于纯计数)、release/acquire(配对发布-订阅)、acq_rel(RMW 兼收发)、seq_cst(额外加全局总顺序、最强也是默认)。选择准则:拿不准用默认 seq_cst,能证明够弱再放松;放松是高危优化,正确性靠 happens-before 推理、不靠 x86 的运气。