网络高并发导读 —— 一台机器怎么扛住成千上万连接
高并发的本质命题只有一句话:一台机器怎么同时服务几万、几十万乃至上百万条连接? 这就是业界从 C10K(一万连接)一路追到 C10M(一千万连接)的问题。本篇是"网络高并发" cluster 的导读:先讲清高并发到底卡在哪两大瓶颈,画出优化的整体框架(应用层 + 内核层),再给一张"瓶颈 → 对策 → 去哪篇"的路由表,把你带进后面 5 篇分篇。全篇呼应本仓库进程篇(线程/切换/中断)与观测工具(ss、内核调优)。
一、高并发要解决什么:C10K → C10M
一句话:连接数从"几百"涨到"几万、几百万",老的"一连接一线程 + 阻塞读写"模型会在两个维度上崩掉。
设想一个服务端:每来一个客户端连接,就开一个线程去 read()/write()。连接少时岁月静好;连接一多,两条成本曲线同时爆炸:
| 瓶颈 | 具体开销 | 随连接数 N 增长 |
|---|---|---|
| ① 每连接的资源开销 | 线程栈内存(默认 8MB/线程)、内核 task 结构、socket fd、收发缓冲区 | 线性 O(N),很快吃光内存 |
| ② 每次 IO 的 CPU 开销 | 系统调用(read/write 陷入内核)、内核↔用户态数据拷贝、线程被唤醒/阻塞引发的上下文切换、网卡收包中断 | 每个请求都付一遍,QPS 一高就打满 CPU |
- 瓶颈①(资源):1 万个线程 × 8MB 栈 = 80GB 虚拟内存;就算调小栈,几万个内核调度实体本身也让调度器不堪重负。
- 瓶颈②(CPU):每次
read()都是一次系统调用(陷入/返回有固定开销)+ 一次内核到用户的数据拷贝;线程在"有数据才醒、没数据就睡"之间反复横跳,每次都是一次上下文切换;网卡每收一批包还要打中断。连接一多,这些"每次 IO 的固定税"叠起来就压垮 CPU。
高并发的全部优化,都是围绕把这两笔开销摊薄展开的:瓶颈①靠"别为每连接开一个线程"(IO 多路复用 + 合适的线程模型);瓶颈②靠"减少系统调用/拷贝/切换/中断次数"(epoll 的批量就绪、零拷贝、内核网络调优)。
一句话:高并发就是和两笔账死磕——每连接的资源账(别开那么多线程)和每次 IO 的 CPU 账(别付那么多次系统调用/拷贝/切换/中断)。
二、优化的整体框架:应用层 + 内核层两条线
一个请求从"网卡收到字节"到"应用拿到数据",要穿过一串层次;每一层都有可优化点。把它们理成应用层和内核层两条线:
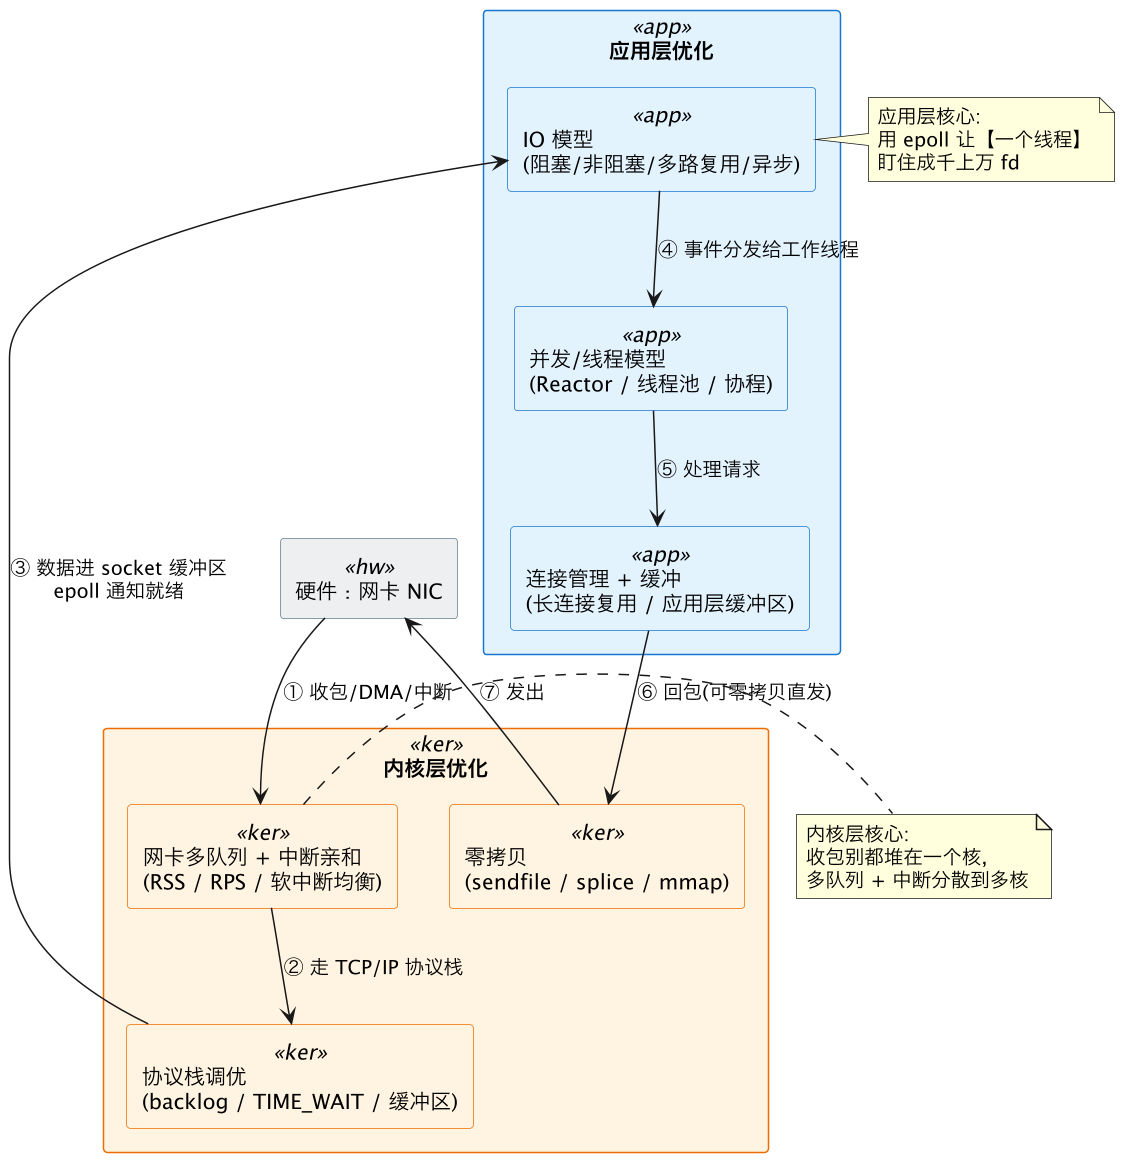
- 应用层:决定"用几个线程、怎么等 IO、怎么分发事件"。这是收益最大、最先要做对的一层——选对 IO 模型(多路复用)和线程模型(Reactor),瓶颈①基本解决。
- 内核层:决定"协议栈和网卡把包送到应用手上的效率"。当应用层已经用满、单机 QPS 还要再上一个台阶时,就往内核调优、RSS和零拷贝要性能。
一句话:先把应用层的 IO 模型和线程模型做对(解决"开太多线程"),再向内核层的协议栈调优、网卡多队列、零拷贝要极致吞吐(解决"每次 IO 太贵")。
三、瓶颈 → 对策 → 去哪篇(路由表)
这张表是本 cluster 的导航图。遇到具体问题,按"现象"找到"对策",再翻对应分篇:
| 你遇到的瓶颈/现象 | 根因 | 对策 | 去哪篇 |
|---|---|---|---|
| 连接一多线程就爆、内存吃光 | 一连接一线程,瓶颈① | 换 IO 多路复用,一个线程盯多个 fd | io-models |
| 想知道 select/poll/epoll 到底差在哪、epoll 为什么快 | 不懂多路复用内部机制 | 红黑树注册 + 就绪链表回调,O(1) 拿就绪 | epoll |
| 有了 epoll,但一个线程处理不过来 / 多核用不满 | 单 Reactor 撑不住计算 | 主从 Reactor / 多线程 / 线程池 / 协程 | thread-models |
| CPU 全耗在收包中断、软中断集中在一个核 | 网卡单队列、中断没分散 | 多队列 RSS/RPS、中断亲和、somaxconn/缓冲区调优 | kernel-tuning-net |
| 不知道 RSS 哈希怎么算、间接表怎么调、RPS/RFS/XPS/FDir 怎么选 | 不理解网卡硬件收包分流机制 | RSS 完整机制:Toeplitz 哈希+间接表+哈希字段+三环绑定+RPS/RFS/XPS 全线对比+ethtool 诊断 | rss |
| 大文件/大响应传输,CPU 全在拷贝数据 | 内核↔用户态多次拷贝,瓶颈② | sendfile/splice/mmap 零拷贝 | zero-copy |
| 每次 read/epoll_wait 系统调用开销大 | 系统调用/拷贝次数太多 | 批量就绪 + io_uring 减少 syscall | io-models + zero-copy |
一句话:瓶颈①(资源)主要在 io-models / epoll / thread-models 三篇解决;瓶颈②(CPU 税)主要在 kernel-tuning-net / rss / zero-copy 三篇解决。
四、C10K 的历史脉络:为什么"每连接一线程"扛不住
一句话:C10K 是一篇 1999 年的经典问题——单机同时一万连接,逼着服务端从"线程堆机器"转向"事件驱动"。
早期服务端两种老模型,在万级连接下都撞墙:
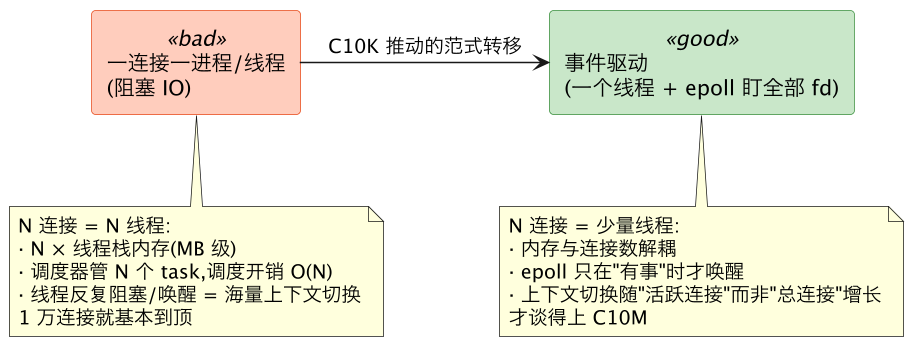
- 每连接一线程为什么崩:① 线程栈内存——每线程一个独立栈(默认 8MB),万级线程直接吃光内存;② 调度开销——内核调度器要在成千上万个 task 间轮转,O(N) 的管理成本;③ 上下文切换——线程"没数据就阻塞、有数据被唤醒",每次切换都要保存/恢复寄存器、刷 TLB,纯属浪费。
- 为什么转向事件驱动:核心洞察是**"连接数多不等于活跃连接多"**——一万条连接里,某一刻真正有数据可读的可能只有几十条。事件驱动(epoll)就是让一个线程用一次
epoll_wait拿回"这批就绪的 fd",只干真正有活的连接,把开销从"随总连接数"降到"随活跃连接数"。这就是从 C10K 走向 C10M 的钥匙。
一句话:C10K 的教训是"别拿线程数去顶连接数"——连接是廉价的、线程是昂贵的,事件驱动让二者解耦。
五、关键指标 & 与本仓库其他文档的关系
衡量高并发系统,盯这几个指标:
| 指标 | 含义 | 关注点 |
|---|---|---|
| QPS / 吞吐 | 每秒处理请求数 / 字节数 | 越高越好,看单机能压到多少 |
| 延迟(p99 / 尾延迟) | 99% 请求的响应时间 | 高并发下平均值会骗人,尾延迟才是体验瓶颈 |
| 并发连接数 | 同时保持的连接数 | C10K/C10M 的主战场 |
| CPU / 内存占用 | 每连接、每请求的资源消耗 | 瓶颈①②的直接体现 |
本篇是导读,很多机制在本仓库已有独立文档,交叉着看:
- 线程开销(栈内存/创建成本):thread-creation
- 上下文切换开销:context-switch
- 网卡收包中断(软中断/硬中断):interrupts
- 每次 read/epoll_wait 的系统调用开销:syscall
- 观测连接状态/数量(
LISTEN/ESTABLISHED/TIME_WAIT、backlog):ss - 内核参数调优入口(
sysctl//proc/sys/net):kernel-tuning
一句话:优化前先测(QPS/p99/连接数/CPU),用 ss 看连接、用进程篇理解每笔开销的来源,再对症下药。
总结
高并发就是把"每连接的资源账"和"每次 IO 的 CPU 账"这两笔钱摊到最薄——应用层用 IO 多路复用 + 合适的线程模型解决"别开太多线程",内核层用协议栈调优 + 网卡多队列 + 零拷贝解决"每次 IO 别那么贵";这条路的起点是 C10K 逼出的"事件驱动"范式,终点是 C10M。