C ABI(System V AMD64)—— 函数调用在汇编层面到底怎么传参数、怎么回值
API 是源码层面的约定(
int open(const char*, int)),改了编译报错重来就行。ABI 是二进制层面的约定(参数放哪个寄存器、栈怎么对齐、long是多少位),改了旧的.o和.so全不认——这是"为什么换编译器版本后链接会炸""为什么 debug/release 混用会崩"的根因。本篇讲 x86-64 Linux 下 C 语言的 ABI,即 System V AMD64 ABI 规范。任何探讨"函数调用为什么慢/编译器怎么优化寄存器/栈帧为什么长这样"的问题,最终都要回到 ABI 才能清楚。
相关:x86-64-registers 讲了寄存器本身是什么;本篇讲 C 函数调用用哪些寄存器、怎么用。compile-link-load 讲编译到运行的宏观过程;本篇聚焦微观——函数调用在机器码层面的规则。
零、什么是 ABI,为什么每个程序员都该懂一点
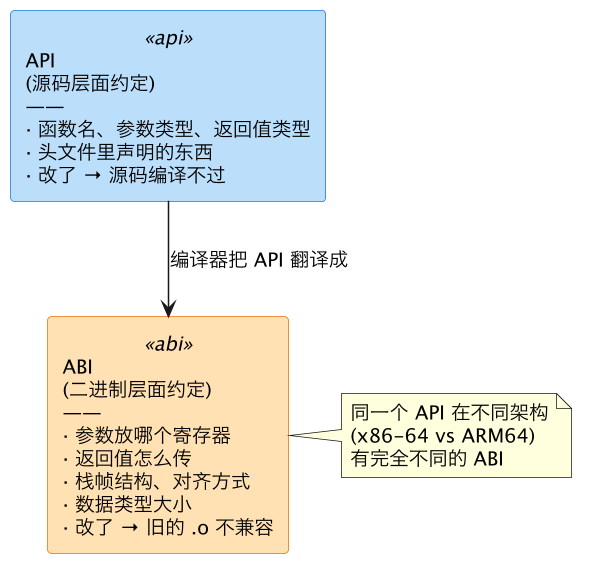
关键区分:
int open(const char *path, int flags)→ 这是 API(大家都能看懂)- "第一个参数放
rdi,第二个放rsi,返回值放rax" → 这是 ABI(编译器+链接器+调试器需要遵守的底层规则)
同一套 API 在不同平台有不同 ABI。本篇讲的是 x86-64 Linux(System V AMD64) 的 C ABI。Windows x64 用的是 Microsoft x64 ABI(传参用 rcx/rdx/r8/r9),不一样,别混了。
一、寄存器使用约定:谁保护谁
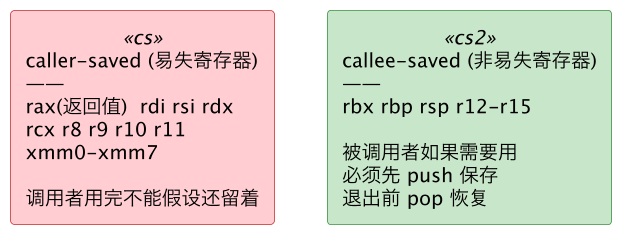
函数 A 调用函数 B,B 可以随便用某些寄存器,但必须保护另一些——这就是 caller-saved(调用者保存)和 callee-saved(被调用者保存)的分工:
| 寄存器 | 角色 | 约定 | 典型用途 |
|---|---|---|---|
rax | 返回值 | caller-saved | 函数返回值(整数/指针)、syscall 调用号 |
rdi | 传参 #1 | caller-saved | 第一个参数 |
rsi | 传参 #2 | caller-saved | 第二个参数 |
rdx | 传参 #3 | caller-saved | 第三个参数,syscall 返回值 #2 |
rcx | 传参 #4 | caller-saved | 第四个参数(普通函数调用) |
r8 | 传参 #5 | caller-saved | 第五个参数 |
r9 | 传参 #6 | caller-saved | 第六个参数 |
r10 | 临时 | caller-saved | 传参时备用;syscall 的第四个参数(替代 rcx) |
r11 | 临时 | caller-saved | 临时变量;syscall 会写入 RFLAGS |
rbx | 通用 | callee-saved | 被调用者如果用,先保存、退出前恢复 |
rbp | 帧指针 | callee-saved | 指向前一帧的 rbp(可选,-fomit-frame-pointer 可省) |
rsp | 栈指针 | 特殊约定 | 函数调用前 16 字节对齐 |
r12-r15 | 通用 | callee-saved | 被调用者的"保险柜" |
xmm0-xmm7 | 浮点传参 | caller-saved | 浮点参数/返回值 |
对性能的意义:
- callee-saved 寄存器多的好处:如果函数用不到 6 个以上变量,就不用碰栈——全在寄存器里周转。
- 被调函数自己决定要不要保存 callee-saved 寄存器,只保存它真正用到的那些——不是每个函数都 push/pop 全部 7 个。
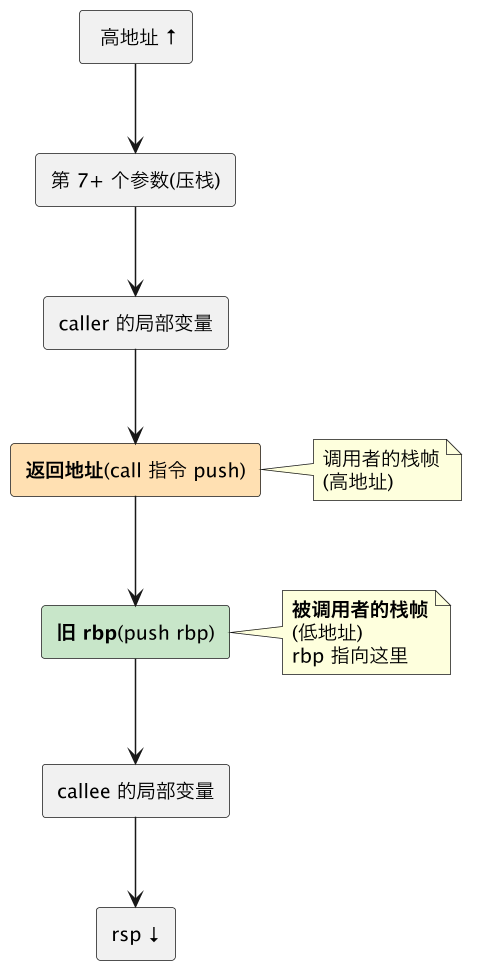
二、函数调用的栈帧结构
以 func(42, "hello", 3.14) 为例,在 x86-64 System V ABI 下:
2.1 标准函数序言(prologue)和尾声(epilogue)
# 被调用者的 prologue(进入函数时执行)
push  rbp           # 保存调用者的 rbp
mov   rbp, rsp      # 设自己的帧指针
sub   rsp, N        # 给局部变量腾地方
# ... push callee-saved regs(rbx, r12-r15 等,按需)
# 被调用者的 epilogue(返回前执行)
# ... pop callee-saved regs(逆序)
mov   rsp, rbp      # 或直接 leave 指令
pop   rbp
ret # 弹出返回地址并跳转如果没有帧指针(-fomit-frame-pointer,-O2 默认开启),就不会做 push rbp / mov rbp,rsp,而是直接用 rsp 偏移访问栈上变量——省两条指令,但没了帧指针链,perf/gdb 回溯调用栈时可能丢帧。
2.2 Red Zone(红区)
x86-64 System V ABI 定义了一个 128 字节的红区(red zone):
rsp之下 128 字节区域,信号处理函数保证不会碰。叶子函数(不再调其他函数的函数)可以直接用rsp - N(N ≤ 128)访问这些字节而不用减rsp。
# 有了 red zone,叶子函数可以省掉 sub rsp / add rsp:
some_leaf:
    mov [rsp-8], rdi    # 直接用,不用动 rsp
    ; ... 干活 ...
    ret                  # 无需 add rsp
⚠️ Linux 内核代码不能用 red zone:内核栈有中断上下文,信号/中断不保证不碰红区。内核编译时用
-mno-red-zone。
三、参数传递
3.1 整数/指针参数
优先级从高到低:
rdi → rsi → rdx → rcx → r8 → r9 → 压栈
 1     2     3     4     5     6     7+
前 6 个参数走寄存器,第 7 个开始压栈。 小于 64 位的参数会做寄存器内的截断/零扩展,由被调函数负责处理。
// func(a, b, c, d, e, f, g, h)
//      1  2  3  4  5  6  7  8
// 实际传递:
//   rdi=a  rsi=b  rdx=c  rcx=d  r8=e  r9=f
//   栈: g (rsp+8), h (rsp+16)   【注意:返回地址占了 8 字节】
3.2 小于 64 位的参数——"剩余垃圾"是合法的
一个 char 虽然只需 1 字节,但进寄存器时占 8 字节——高 7 字节是未定义垃圾,被调用者不能假设它是 0。这就是为什么 printf("%d", c) 有时不自洽(如果传的小类型未正确扩展)。
3.3 浮点和 SIMD 参数
浮点参数用 xmm0 到 xmm7(共 8 个),每个最多 8 字节。超过 8 字节的返回值(如 _Complex long double)走内存间接传。
3.4 结构体传参——不是"整个压栈"
< 16 字节的结构体:拆分放进两个寄存器(整数部分放整数寄存器、浮点部分放 xmm)。
struct Point { int x; double y; };
void draw(Point p);
// rdi = p.x (int)
// xmm0 = p.y (double)
16 字节的结构体:整个压栈(复制一份),传指针效率更高——所以 C++ 习惯用
const &传大对象。
3.5 系统调用的"特殊 ABI"
系统调用不是普通的 C 函数调用,它用另一套约定(见 x86-64-registers §一):
| 普通函数调用 | 系统调用 | |
|---|---|---|
| 调用号 | — | rax |
| 参数 1-3 | rdi, rsi, rdx | 相同 |
| 参数 4 | rcx | r10(因为 syscall 指令会踩 rcx) |
| 参数 5-6 | r8, r9 | 相同 |
| 返回值 | rax | rax(负值 = -errno) |
| 红区 | 有(128 字节) | 无 |
3.6 可变参数(variadic)——一个 "看不见" 的坑
printf(format, ...) 的 ... 部分怎么传?其实非常直接——所有可变参数都走同样的传参规则,但在 va_list 里要数出类型(编译器帮不了忙,全靠 format 字符串对齐)。这就是为什么 printf("%d", 3.14) 会出乱码:整数寄存器被放了 double 的位模式,但按 int 去读。
四、返回值
4.1 整数/指针返回值
rax 返回 64 位以内的值。void 函数 rax 的内容是未定义垃圾。
4.2 大于 64 位但不大于 128 位的值
rax(低 64 位)+ rdx(高 64 位)。比如 128 位 __int128 就拆成两个寄存器返回。
4.3 大于 128 位的结构体
调用的地方不一样——调用者在自己的栈上专门预留一块"返回空间",把这块空间的地址作为隐藏的第一个参数(rdi)传给被调用者;被调用者往这块空间填结果,返回后调用者从这里读。
struct Big { char data[256]; };
Big create();
// 等价于 void create(Big *hidden_return_ptr);  ← rdi 指向它
五、栈对齐——一个极容易忽略的 bug 来源
x86-64 System V ABI 要求:call 指令执行前,rsp 必须 16 字节对齐。(call 本身会 push 8 字节的返回地址,所以进函数时 rsp + 8 是 16 的倍数。)
这意味着一件事:如果在函数内部调用另一个函数,对自己栈上的空间分配必须是 16 字节对齐的。最常见的 crash 是在手写汇编或从其他语言调 C 时忘了对齐,导致 movaps(对齐的 SSE 指令)在栈上访问时 GP fault。
# 错误示例——分配了奇怪的栈空间导致不对齐
sub rsp, 24          # 24 不是 16 的倍数!进函数后 rsp 可能已经偏了
call printf          # 这里 rsp 不是 16 字节对齐 → 可能崩
# 正确做法
sub rsp, 16          # 按 16 字节对齐分配
这个约束在性能上也有意义:保证 SSE/AVX 的 16/32 字节对齐访问不会跨 cache line 边界而性能骤降。
六、数据类型(x86-64 Linux LP64 模型)
LP64 意为 Long 和 Pointer 为 64 位:
| C 类型 | 大小(字节) | 对齐 | 备注 |
|---|---|---|---|
char | 1 | 1 | 有无符号是 platform-specific(x86 上 signed) |
short | 2 | 2 | |
int | 4 | 4 | 永远是 32 位 |
long | 8 | 8 | LP64 下是 64 位(Windows 用 LLP64 → 32 位) |
long long | 8 | 8 | |
float | 4 | 4 | IEEE 754 single |
double | 8 | 8 | IEEE 754 double |
long double | 16 | 16 | x86-64 上通常是 80-bit x87 扩展精度 padded 到 16 字节 |
指针 T* | 8 | 8 | |
size_t | 8 | 8 | unsigned long |
ptrdiff_t | 8 | 8 | long |
enum | 4 | 4 | 默认是 int(除非显式指定底层类型) |
⚠️
long在 x86-64 Linux 上是 8 字节,在 x86-64 Windows 上是 4 字节——这是"跨平台代码最常出错的 ABI 差异"之一。用int64_t/uint64_t(<stdint.h>)可以避免这个坑。
七、与性能分析的关联
| 性能场景 | ABI 相关的点 |
|---|---|
系统调用多、%system 高 | syscall 用 r10 而非 rcx 传第 4 参数,加上切栈/保存寄存器——见 syscall |
| 函数调用开销大 | 参数 ≥ 7 个要走栈(多一次内存访问);大 struct 传值全部压栈(memcpy 成本) |
movaps 崩了 | 栈没对齐到 16 字节,调试看 rsp 的末 4 位是否为 0 |
| callee-saved 寄存器 push/pop | 程序在 -O0 下每条函数都在 push/pop rbx/rbp,-O2 用 callee-saved 寄存器少就少刷栈 |
| red zone | 叶子函数不用动 rsp,省指令、省寄存器压力;但在信号处理上下文中是隐患 |
| perf 采样缺帧 | 被优化掉帧指针(-fomit-frame-pointer),perf 需要 dwarf unwind info 才能回溯 |
| TLB miss 高 | 大栈帧的局部变量分配可能跨页,改小栈帧、用寄存器优化 |
八、一句话总结
C ABI 定义了函数调用在二进制层面的游戏规则:前 6 个整型参数放 rdi/rsi/rdx/rcx/r8/r9,大于 6 个压栈;返回值放 rax(>128 位则通过隐藏的 rdi 参数用栈间接返回);rbx/rbp/r12-r15 是 callee-saved(被调用者保护),其余通用寄存器可随意使用;rsp 在 call 前必须 16 字节对齐;对大小 ≤ 128 字节的栈帧叶子函数可直接用 red zone 不动 rsp——这就是编译器把源码翻译成机器码时必须遵守的底层规则。任何跨模块调用、手写汇编、调试栈回溯的场景都建立在 ABI 之上。
九、深入阅读
- c++-abi —— C++ ABI:名字改编、虚表、异常处理——C++ 怎么在 C ABI 之上实现多态等高级特性。
- compile-link-load —— 从源码到运行:编译→链接→加载的完整流程,ABI 是链接器能做符号解析的前提。
- x86-64-registers —— 寄存器体系详解:本篇讲的是"怎么用",那篇讲的是"是什么"。
- syscall —— 系统调用的特殊 ABI(第 4 参数为什么不能用 rcx?r11 被怎么毁了?)。