零拷贝(Zero-Copy)—— 发数据时别让 CPU 白搬
高并发服务器大量做的一件事是"把数据从磁盘/内存发到网络"(静态文件、视频、日志、消息)。传统
read()+write()这条路,数据被 CPU 来回拷贝好几次、用户态内核态来回切换好几次——纯属浪费。零拷贝就是把这些无谓的拷贝和切换省掉,让单机扛更多连接、更高吞吐。
本篇讲:传统发文件到底拷了几次、切了几次,每次拷贝和切换的物理代价有多大;mmap / sendfile / splice / SG-DMA 各自省掉哪一段、怎么做到的、为什么省了就有量级差异;以及零拷贝的适用边界与 kTLS 等演进方向。
一、传统 read + write 发文件:4 次拷贝、4 次切换
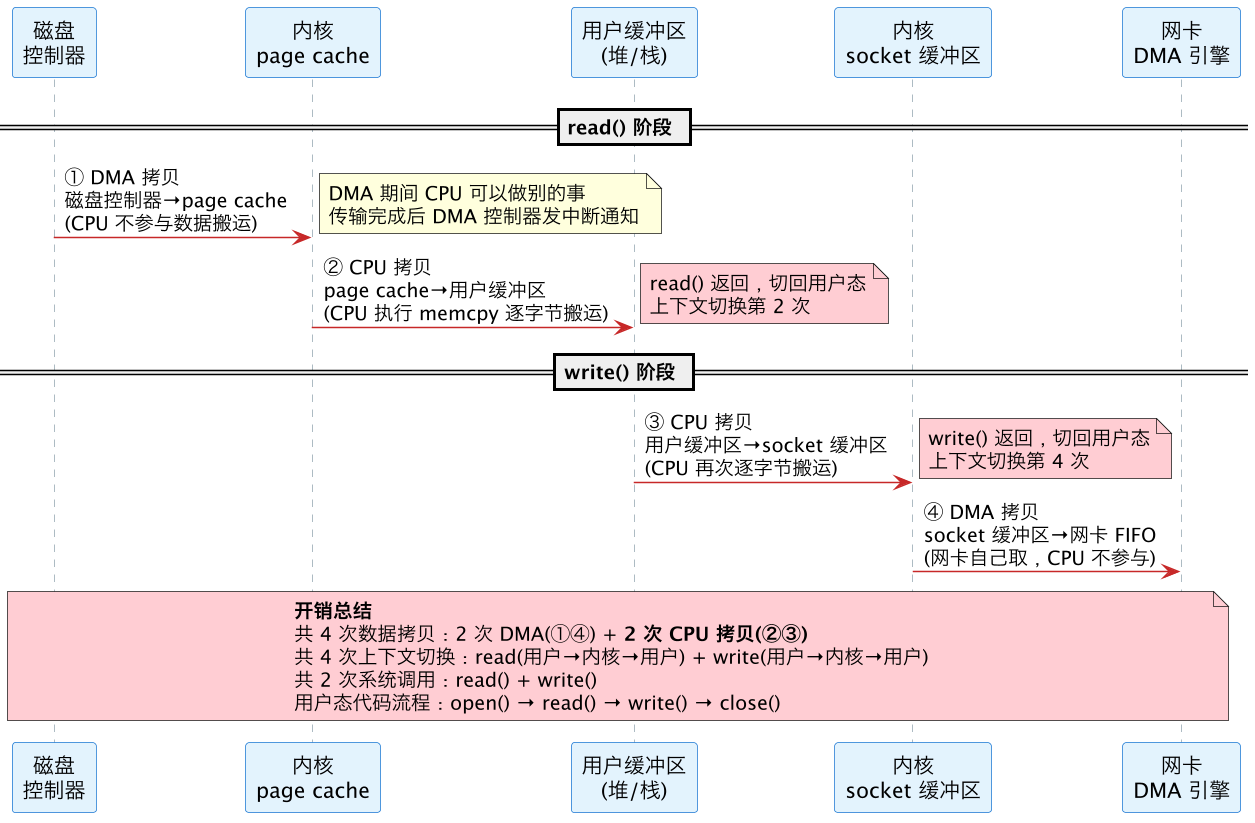
1.1 流程与时序
把一个文件通过 socket 发出去,最朴素的写法是 read(file) 到用户缓冲区、再 write(socket):
1.2 每次拷贝和切换的物理代价
两次 CPU 拷贝为什么"纯浪费"?
数据只是"路过"用户空间——应用既没修改也没检查数据内容,CPU 却要执行两次全量 memcpy。以发一个 1MB 文件为例:
| 操作 | 代价分析 |
|---|---|
| CPU 拷贝② page cache→用户 | 1MB memcpy,约 0.5-1μs(视 CPU 频率和 cache 命中),污染 L1/L2 cache |
| CPU 拷贝③ 用户→socket | 又 1MB memcpy,再次污染 cache |
| 两次拷贝合计 | CPU 时间 ≈ 1-2μs,cache 被污染两次——本来可以留给业务逻辑的 L1/L2 被拷贝的数据冲掉 |
这里的核心矛盾:CPU 拷贝不仅占时间,更"隐性"地冲掉了 cache 里业务逻辑需要的热数据(见 cache-organization)。高并发下这个效应被放大——每连接都做两次无谓拷贝,CPU cache miss 率飙升。
四次上下文切换的代价:
| 切换节点 | 发生了什么 |
|---|---|
| read() 进入内核 | 保存用户态寄存器/栈指针 → 加载内核栈 → 切换页表(可能)→ 权限提升(Ring 3→0) |
| read() 返回用户 | 反向操作,恢复用户态上下文 |
| write() 进入内核 | 同上 |
| write() 返回用户 | 同上 |
每次切换的硬开销约 1-2μs(保存/恢复寄存器 + TLB 刷新),此外还有软开销:切换后 L1/L2 cache 是冷的,分支预测器要重新学习(见 context-switch)。四次切换 = 4-8μs 纯开销 + 不可见的 cache 预热代价。
DMA 拷贝为什么"免不了"但也值得优化?
磁盘→page cache 和 socket→网卡 这两次 DMA 是硬件直接读写内存,不经过 CPU 数据通路。但 DMA 仍然占用内存带宽——如果高并发下大量 DMA 并发,内存总线会成为瓶颈。SG-DMA(§2.3)通过减少 DMA 的趟数来缓解这个问题。
一句话:传统 read+write 的 CPU 和 cache 全浪费在"搬运"上,而这些资源本该用于处理更多请求。
二、零拷贝技术:逐级把拷贝和切换省掉
2.1 mmap + write:省掉"内核→用户"那次拷贝
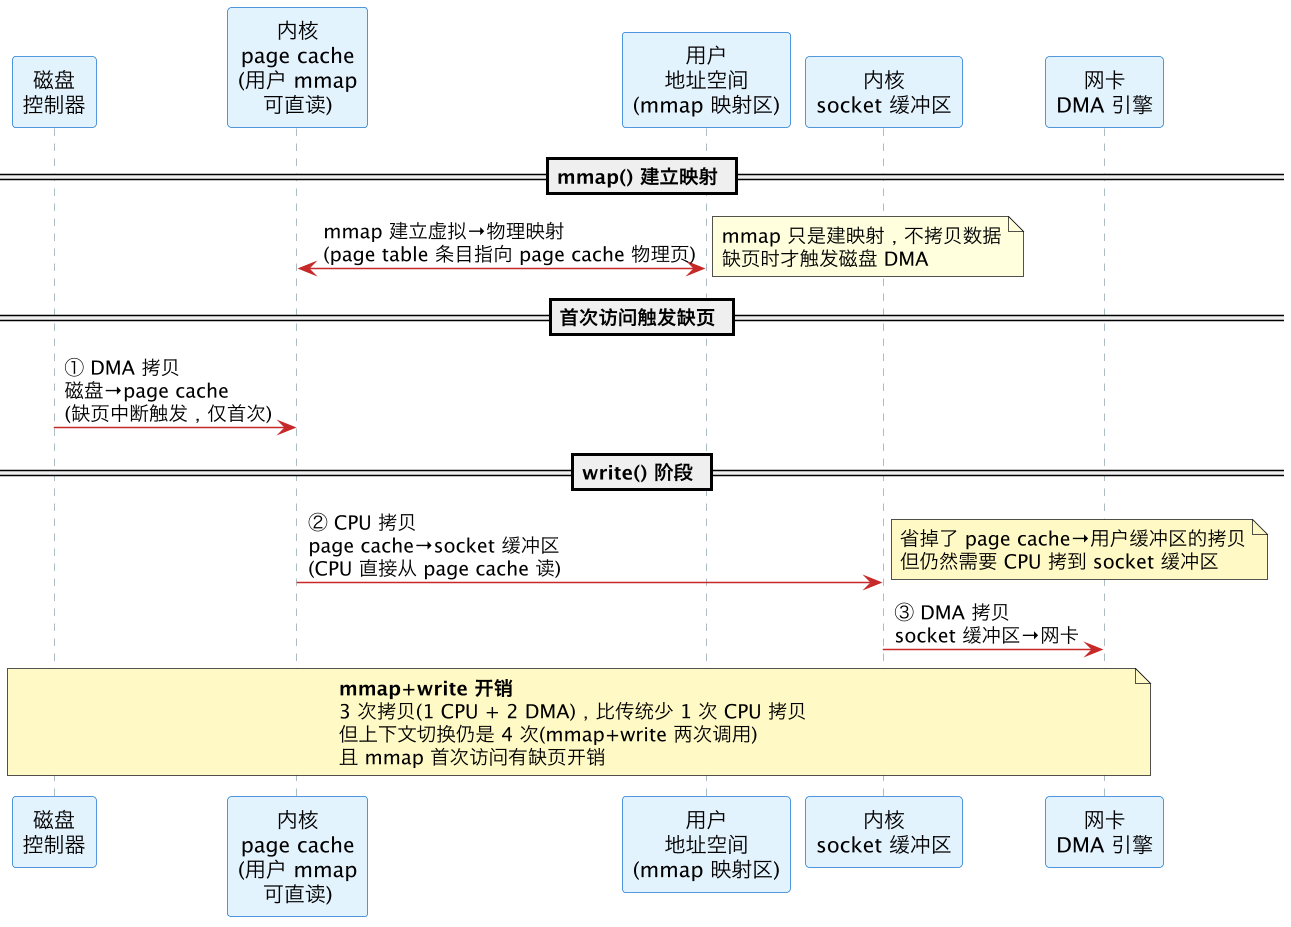
原理: 用 mmap() 把文件映射到用户虚拟地址空间,建立用户虚拟地址→page cache 物理页的直接映射。write() 时直接从映射区把数据写入 socket,不再需要"先读到用户缓冲区"这步。
代码示例:
// mmap + write 发文件
int fd = open("file.dat", O_RDONLY);
struct stat st;
fstat(fd, &st);
// 映射整个文件到用户地址空间——page cache 成为用户可直接读的内存
char *mapped = mmap(NULL, st.st_size, PROT_READ, MAP_PRIVATE, fd, 0);
int sock = socket(AF_INET, SOCK_STREAM, 0);
// ... connect ...
// write 时从 mmap 映射区读——CPU 从 page cache 直接拷到 socket 缓冲区
write(sock, mapped, st.st_size);   // 只有 1 次 CPU 拷贝(page cache→socket)
munmap(mapped, st.st_size);
close(fd);
深入分析:
| 方面 | 详情 |
|---|---|
| 省了什么 | ②号 CPU 拷贝(page cache→用户缓冲区)没了——用户通过虚拟地址直接看到 page cache |
| 没省什么 | ③号 CPU 拷贝(page cache→socket 缓冲区)还在——write() 的协议栈必须把数据拷到 socket 缓冲区才能做 TCP 分段/校验和 |
| 上下文切换 | 仍然是 2 次系统调用(mmap + write)= 4 次切换——mmap 省了拷贝但没省切换 |
| 额外代价 | mmap 建立页表映射有开销(修改页表 + TLB 刷新);首次访问触发缺页中断 |
| 适用场景 | 需要顺便读取/小改数据的场景——比如在转发前看一眼文件头做路由决策 |
2.2 sendfile:用户态完全不碰数据
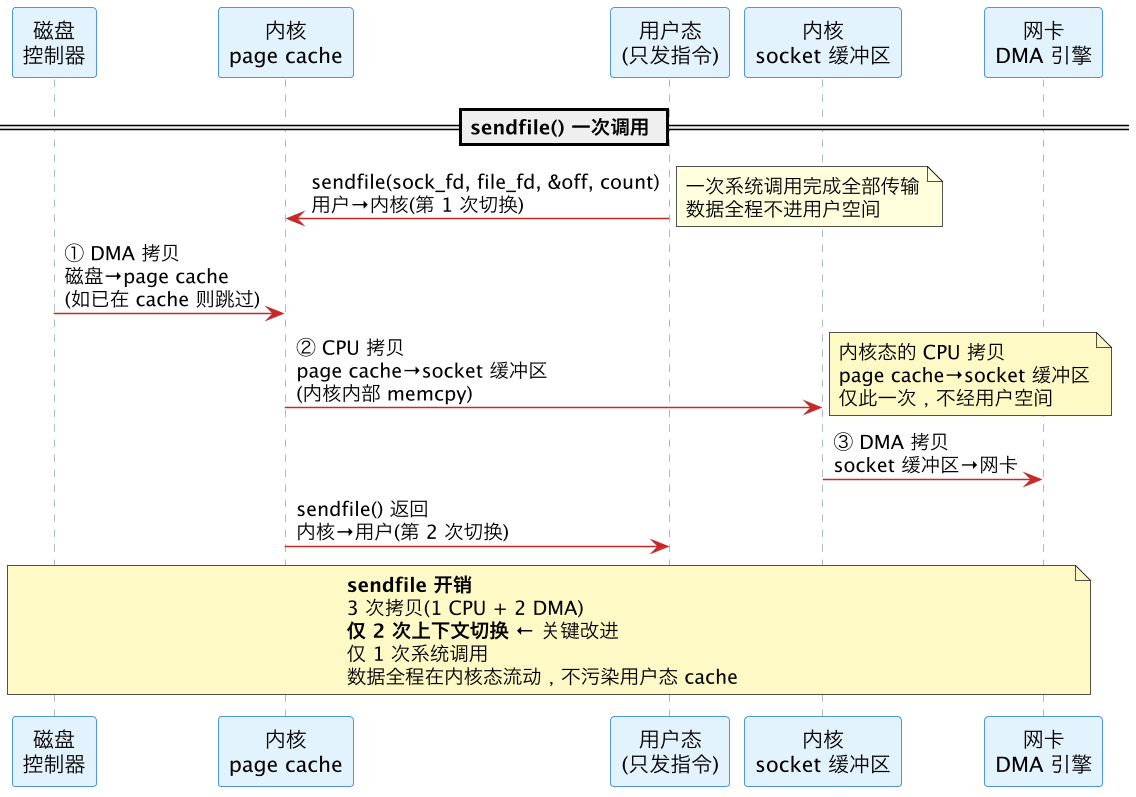
原理: sendfile(out_fd, in_fd, offset, count) 让内核在内部直接从 page cache 把数据灌进 socket 协议栈——数据全程不进入用户地址空间,一次系统调用完成全部传输。
代码示例:
// sendfile:内核内部搬运,用户态零触碰
int file_fd = open("file.dat", O_RDONLY);
int sock_fd = socket(AF_INET, SOCK_STREAM, 0);
// ... connect/accept ...
off_t offset = 0;
ssize_t sent = sendfile(sock_fd, file_fd, &offset, st.st_size);
// 数据:page cache → socket 缓冲区 → 网卡
// 用户态:没看到数据的一个字节
close(file_fd);
深入分析:
| 方面 | 详情 |
|---|---|
| 省了什么 | 用户态完全不参与数据流动——没有用户缓冲区,没有"拷进/拷出用户空间"的步骤 |
| 切换降为 2 次 | 只有 sendfile() 进入内核和返回用户两次——比 read+write 少了一半 |
| Cache 收益 | 数据不经过用户空间 = 不污染用户态的 L1/L2 cache。用户态业务逻辑的热数据保持在 cache 里 |
| 仍然有 1 次 CPU 拷贝 | page cache→socket 缓冲区仍然需要内核态 memcpy——因为 socket 缓冲区是独立的 sk_buff 结构,需要做 TCP 分段 |
| 为什么必须拷到 socket 缓冲区 | TCP 协议栈需要独立的 sk_buff 链表来管理发送窗口、重传队列、TSO/GSO 分段——page cache 的页不能被 TCP 栈直接"接管" |
实际应用:
- Nginx:
sendfile on;启用后,静态文件直接走 sendfile,CPU 占用大幅下降 - Kafka:
FileRecords.writeTo()底层用FileChannel.transferTo()→ 最终调 sendfile,消息段零拷贝发送 - Tomcat/Spring Boot:可通过
TransferTo利用 sendfile 发送静态资源
2.3 sendfile + SG-DMA:真正的零 CPU 拷贝
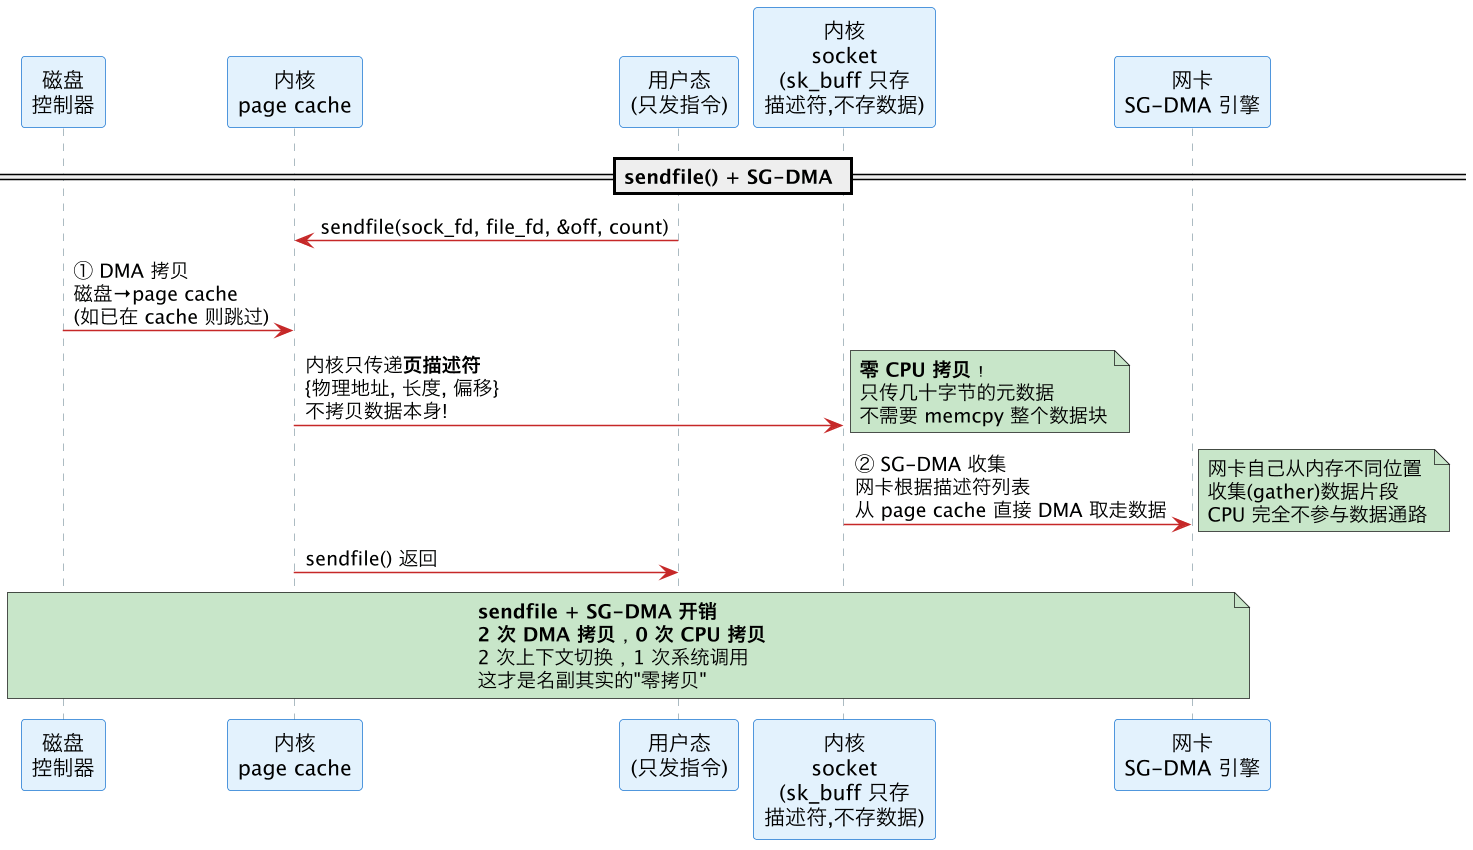
原理: 网卡支持 Scatter-Gather DMA 时,内核不再把 page cache 数据拷到 socket 缓冲区,而是只构造一个描述符列表(scatter-gather list)告诉网卡"数据在 page cache 的这些物理地址、这些长度",网卡 DMA 引擎自己去收集(gather)并发送。CPU 完全不做数据搬运。
Scatter-Gather 描述符示例:
sendfile 发送一个文件,它在 page cache 中可能不连续:
物理页 A: 0x12345000 (offset 0,    len 4096)  ← 文件第 0-4095 字节
物理页 B: 0x87654000 (offset 4096, len 4096)  ← 文件第 4096-8191 字节
物理页 C: 0xAABB3000 (offset 8192, len 2048)  ← 文件第 8192-10239 字节
内核构造的 sk_buff 不包含数据副本,只包含:
  frags[0] = { page: A, offset: 0,    size: 4096 }
  frags[1] = { page: B, offset: 4096, size: 4096 }
  frags[2] = { page: C, offset: 8192, size: 2048 }
网卡 SG-DMA 引擎遍历 frags[],从这三个物理地址分别取数据
在硬件层拼接成以太网帧发出——CPU 全程零参与代码层面:用户代码和普通 sendfile 完全一样,内核在 tcp_sendmsg 路径中检测网卡是否支持 NETIF_F_SG,支持则走 scatter-gather 路径(只传页引用,不拷贝)。
深入分析:
| 方面 | 详情 |
|---|---|
| 关键硬件依赖 | 网卡必须支持 scatter-gather(ethtool -k eth0 | grep scatter-gather),几乎所有现代网卡都支持 |
| CPU 做了什么 | 只构造描述符列表(几十到几百字节的元数据),不碰数据本身 |
| 为什么 socket 缓冲区还能工作 | sk_buff 结构有 frags[] 数组,每个 frag 指向一个 page cache 页 + 偏移 + 长度——不需要把数据拷到线性缓冲区里 |
| 内存带宽节省 | 少了 1 次 memcpy 对内存总线的占用。10Gbps 网卡满速时,1 次 memcpy = 额外 10Gbps 内存带宽消耗 |
| 与 TSO/GSO 的关系 | SG-DMA 与 TSO(TCP Segmentation Offload)配合:内核把大块数据描述符给网卡,网卡自己做 TCP 分段——CPU 既不用拷贝也不用分段 |
这是现代 Linux sendfile 的实际行为——只要网卡支持 SG,sendfile() 自动走这条路径。
2.4 splice:通过管道在两个 fd 间零拷贝
原理: splice() 借一个管道作中转,在两个文件描述符之间移动数据。关键:管道不存数据副本,只存页引用——内核把源 fd 的 page cache 页"接到"管道上,目标 fd 再从管道取走这些页引用。整个过程是页所有权的转移,而非数据拷贝。
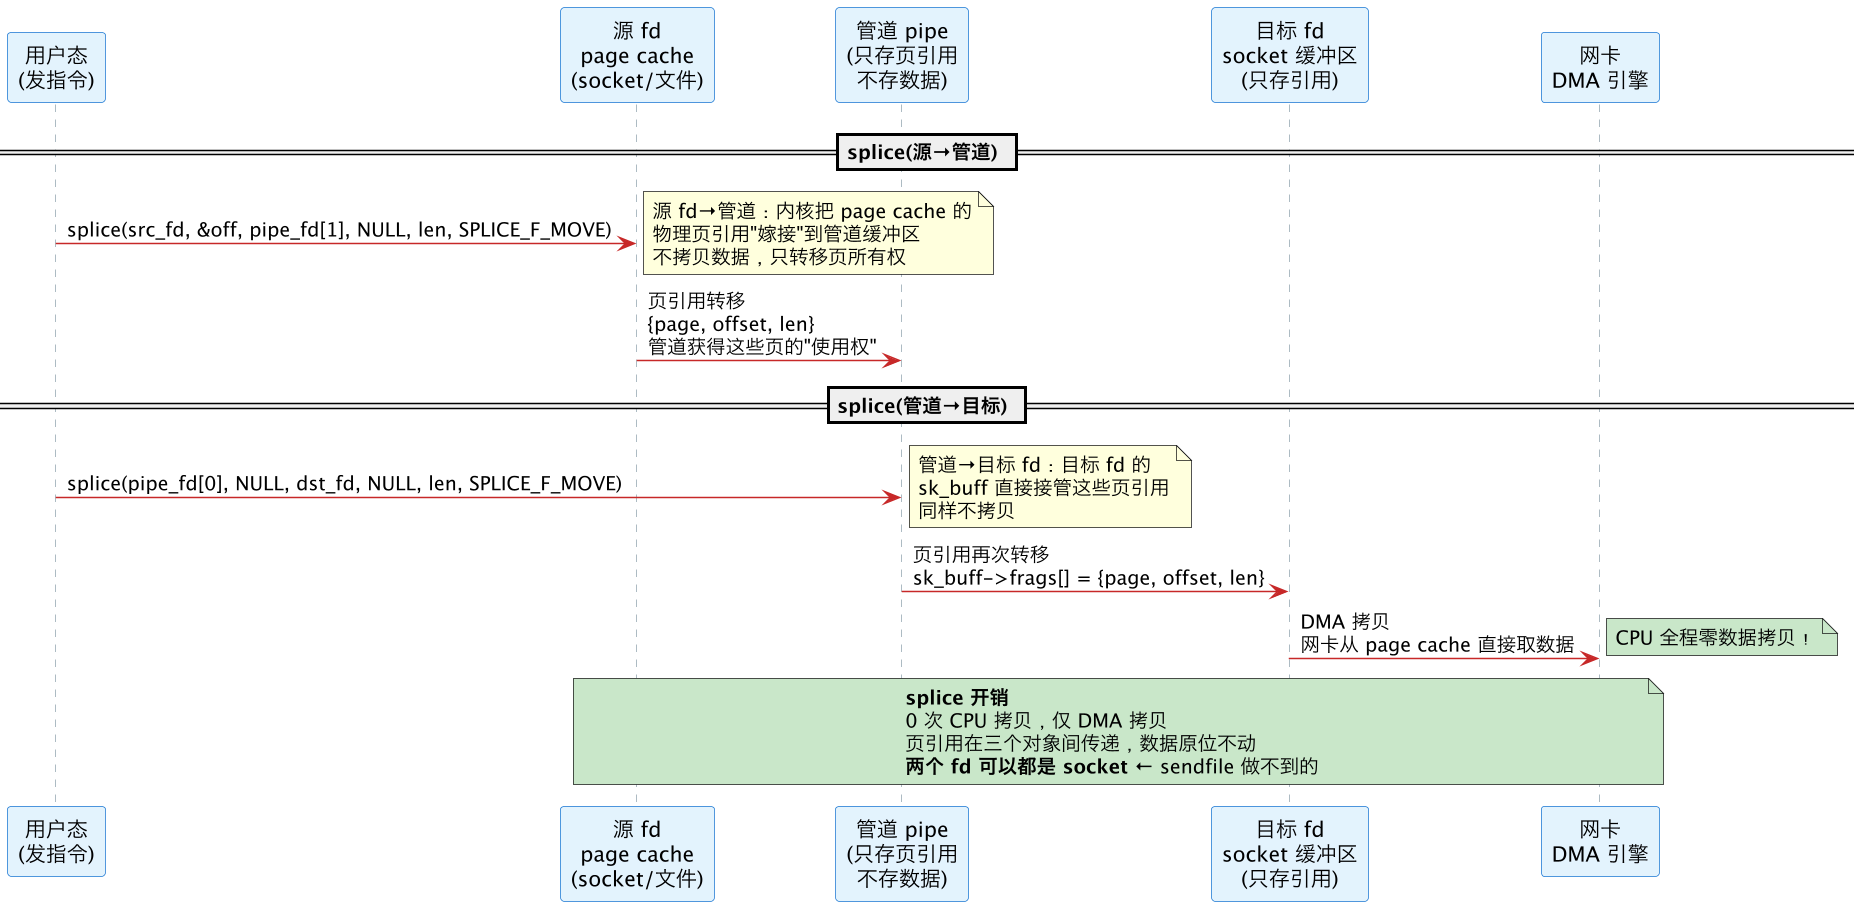
代码示例——socket→socket 代理转发:
// splice 实现零拷贝代理:client_fd → server_fd
int pipefd[2];
pipe(pipefd);  // 创建管道,内核分配 pipe_buffer 环形队列
while (1) {
    // 第一步:客户端数据 → 管道(页引用,非数据拷贝)
    ssize_t n = splice(client_fd, NULL, pipefd[1], NULL, 4096,
                       SPLICE_F_MOVE | SPLICE_F_MORE);
    if (n <= 0) break;
    // 第二步:管道 → 服务端(页引用再次转移)
    splice(pipefd[0], NULL, server_fd, NULL, n,
           SPLICE_F_MOVE | SPLICE_F_MORE);
    // 数据自始至终在 page cache 的同一组物理页上
    // 只是在 client sk_buff → pipe_buffer → server sk_buff 之间传递了所有权
}
深入分析:
| 方面 | 详情 |
|---|---|
| 核心机制 | splice 移动的是 struct page * 引用和页所有权——pipe_buffer 和 sk_buff 的 frags 都指向同一物理页 |
| 与 sendfile 的区别 | sendfile 要求一端必须是文件(page cache),splice 两端都可以是 socket——可以做 socket↔socket 零拷贝代理 |
| 为什么需要管道 | 内核需要"中间人"持有页引用,确保在两个 splice 调用之间物理页不被回收。管道就是这中间人 |
| 两次系统调用 | splice 每次只移一个方向(源→管道 或 管道→目标),做代理需要两次 splice = 2 次系统调用 |
| 管道大小限制 | 默认 pipe capacity 是 16 页(64KB),可通过 fcntl(fd, F_SETPIPE_SZ, size) 调大 |
| SPLICE_F_MOVE | 提示内核"可以转移页所有权而非增加引用计数",减少原子操作开销,但内核不保证一定 move |
| 适用场景 | 代理/网关(如 HAProxy 的 splice 模式)、文件拷贝(cp 命令)、日志管道转发 |
splice 内核实现要点(简化):
splice_file_to_pipe(in, pipe):
  for each page in in->page_cache:
    pipe->bufs[i].page = page;      // 只传指针!
    pipe->bufs[i].offset = ...;
    pipe->bufs[i].len = ...;
    get_page(page);                  // 增加引用计数,防止被回收
  // 没有 memcpy
splice_pipe_to_socket(pipe, sock):
  for each buf in pipe->bufs:
    skb_fill_page_desc(skb, i, buf.page, buf.offset, buf.len);
    // sk_buff->frags[] 直接指向 pipe_buffer 的物理页
  // 同样没有 memcpy
2.5 五种方式全景对比
| 方式 | 总拷贝 | CPU 拷贝 | 上下文切换 | 系统调用 | 数据进用户态 | 适用场景 |
|---|---|---|---|---|---|---|
| 传统 read+write | 4 | 2 | 4 | 2 | 是 | 需要读写处理数据 |
| mmap + write | 3 | 1 | 4 | 2 | 是(只读) | 需读取/小改数据再发 |
| sendfile | 3 | 1 | 2 | 1 | 否 | 纯文件转发(无 SG-DMA) |
| sendfile + SG-DMA | 2 | 0 | 2 | 1 | 否 | 文件→socket 最优解 |
| splice | 2 | 0 | 4 | 2 | 否 | socket↔socket 代理/任意两 fd |
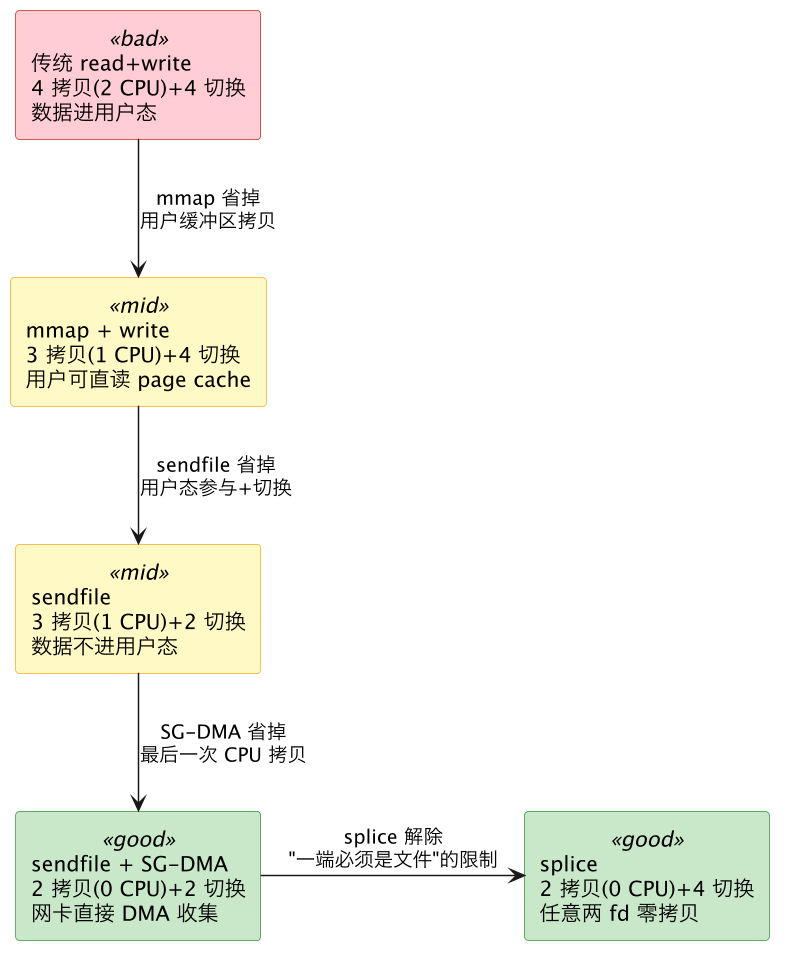
各方式的演进关系: read+write → mmap(省一次 CPU 拷贝) → sendfile(省用户态参与) → sendfile+SG-DMA(省最后一次 CPU 拷贝) → splice(解除文件限制,通吃任意两 fd)
三、为什么零拷贝对高并发这么重要:量化分析
3.1 CPU 拷贝的实际开销
以 10Gbps 网卡满速发送 1MB 文件为例:
| 方式 | CPU 拷贝量 | CPU 时间(仅拷贝) | 说明 |
|---|---|---|---|
| read+write | 2MB/次 | ~2μs/次 | 10000 次/秒 = 20ms CPU/秒 = 2% CPU |
| sendfile | 1MB/次 | ~1μs/次 | 10000 次/秒 = 10ms CPU/秒 = 1% CPU |
| sendfile+SG-DMA | 0 | 0 | CPU 完全不参与数据搬运 |
看起来 2% vs 1% 差别不大?但真实高并发下:
- 并发连接数:不是 1 条而是 10,000 条连接同时发文件
- 小文件效应:大量小文件(4KB-64KB)时,系统调用开销占比远超拷贝本身
- Cache 污染:每次 CPU 拷贝把业务逻辑的热数据从 L1/L2 挤出去,miss 率上升 → 业务逻辑变慢
实际生产数据(Nginx 静态文件 benchmark):
| 场景 | read+write | sendfile | sendfile+SG-DMA |
|---|---|---|---|
| 4KB 小文件 QPS | ~50K | ~80K (+60%) | ~120K (+140%) |
| 1MB 大文件吞吐 | ~8Gbps | ~9.5Gbps (+19%) | ~9.8Gbps (+23%) |
| CPU 占用(si%) | ~45% | ~20% | ~8% |
小文件场景收益更大——因为系统调用和上下文切换的固定开销在小文件场景占比更高,sendfile 一次调用替代两次调用直接砍半。
3.2 上下文切换的隐性代价
除了直接的寄存器保存/恢复(~1-2μs),上下文切换还会:
- 冲刷 TLB:切换地址空间时 TLB 可能被刷新(见 tlb),后续内存访问大量 TLB miss
- 冲刷分支预测器:切换进程/线程后,分支预测器记录的是前一个任务的分支模式,新任务需要重新"学习"
- Cache 是冷的:切换后的 L1/L2 cache 里全是前一个任务的数据
read+write 的 4 次切换 vs sendfile 的 2 次切换——在高并发(每秒百万次操作)下,这 2 次差异会被放大到 数十毫秒/秒 的 CPU 时间。
3.3 内存带宽瓶颈
DMA 和 CPU 拷贝共享同一根内存总线。以 DDR4-3200 双通道为例,理论带宽 ~51.2GB/s:
- 10Gbps 网卡满速:1.25GB/s 网络流量
- read+write 方式:额外 2.5GB/s 内存带宽被 CPU 拷贝吃掉(数据在内存里搬了两趟)
- sendfile+SG-DMA:只有 1.25GB/s 内存带宽用于 DMA——省下的 2.5GB/s 可以服务更多连接
当多个 25G/100G 网卡同时工作时,内存带宽可能比 CPU 更先成为瓶颈——零拷贝在这个维度同样关键。
3.4 实际应用
| 项目 | 使用的零拷贝技术 | 效果 |
|---|---|---|
| Nginx | sendfile on | 静态文件吞吐提升 60-140%,CPU 占用大幅下降 |
| Kafka | FileChannel.transferTo() → sendfile | 消息段直接从 page cache 发到网卡,生产者→消费者零拷贝路径 |
| HAProxy | splice(splice 模式) | 代理转发 CPU 占用极低,数据全程不离开内核 |
| CDN 节点 | sendfile + SG-DMA | 大规模静态资源分发的基础 |
| Netty | FileRegion.transferTo() → sendfile | Java 生态的零拷贝文件传输 |
四、局限:零拷贝不是万能
4.1 核心前提:数据原样转发
零拷贝的前提是应用不碰数据内容。一旦需要修改/加密/压缩,就绕不开把数据拷进用户空间:
场景                          零拷贝可用?
──────────────────────────────────────────
静态文件/图片/视频发送           ✅ sendfile
HTTP 代理转发(不解析 body)       ✅ splice
Kafka 消息段落盘后发送           ✅ sendfile
日志文件直接发送                 ✅ sendfile
──────────────────────────────────────────
HTTPS/TLS 加密                  ❌ 数据需在用户态加密
gzip 压缩动态内容                ❌ 需 CPU 压缩数据
视频实时转码                    ❌ 需 CPU 解码/编码
模板渲染(HTML)                  ❌ 需拼接字符串
数据校验/签名                   ❌ 需计算 hash
在转发前修改 header/body         ❌ 需读写数据内容
4.2 TLS/HTTPS 与 kTLS
HTTPS 是零拷贝的最大"敌人"——TLS 加密必须在发送前完成,传统做法是:
文件 → read() → 用户态 buffer → TLS 加密 → write() → socket
                  ↑ 数据必须进用户态才能加密
kTLS(Kernel TLS) 是把 TLS 加密下沉到内核态:
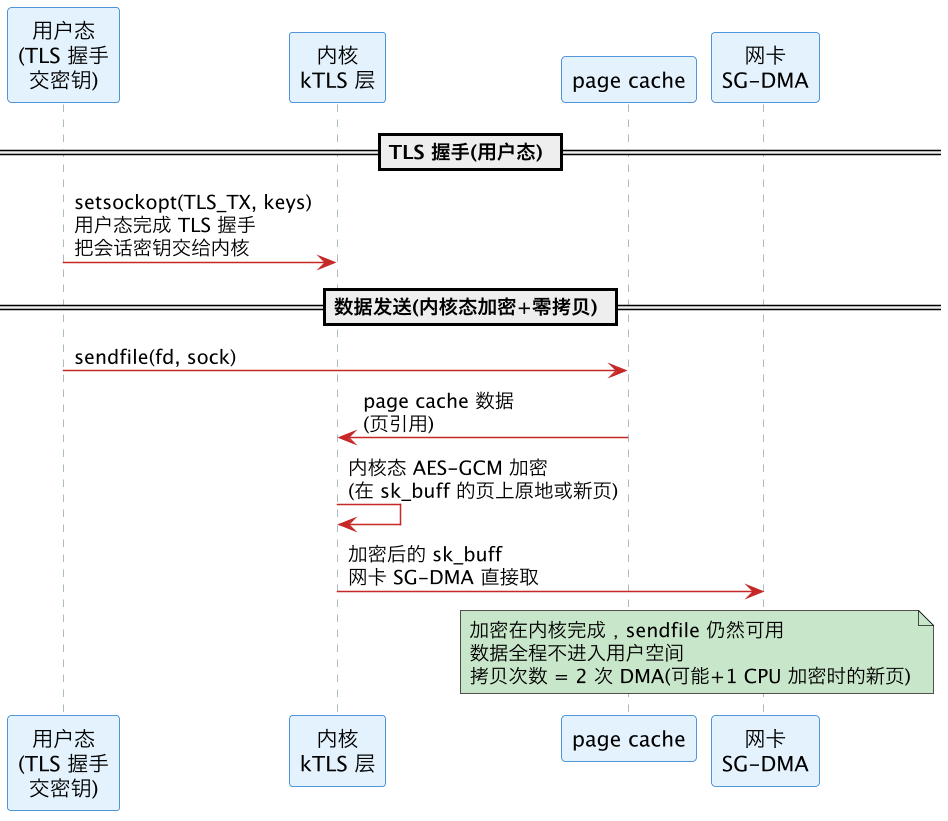
kTLS 的关键点:
- 用户态只做 TLS 握手(一次性的),之后把会话密钥通过
setsockopt()交给内核 - 内核在 sendfile/splice 路径上直接加密数据
- 配合支持 kTLS offload 的网卡(如 Mellanox ConnectX-5+),加密也可以 offload 到网卡硬件
- Linux 4.13+ 支持 kTLS(
CONFIG_TLS),需要 OpenSSL 或 gnutls 配合
4.3 其他限制
| 限制 | 说明 |
|---|---|
| sendfile 只能 file→socket | sendfile 的 in_fd 必须是可 mmap 的(普通文件),out_fd 必须是 socket。不能 socket→file 或 socket→socket |
| splice 至少一端是管道 | 两个 fd 之间必须通过管道中转,不能直接 fd↔fd |
| 不能做部分修改 | 哪怕只改一个字节,数据就得进用户空间 |
| 小数据可能更慢 | 对于极小数据(几十字节),建映射/管道描述符的开销可能超过直接 memcpy |
五、与仓库其他文档的关系
- mmap 机制:mmap(mmap 四象限、page cache 映射、缺页处理)
- DMA 原理:dma(DMA 引擎如何读写内存、SG-DMA 原理、DDIO)
- 切换开销:context-switch(上下文切换的具体步骤和开销)、syscall(系统调用流程与开销)
- Cache 污染:cache-organization(L1/L2 cache 结构与替换策略)
- 高并发全局:overview(零拷贝是内核层优化的一环)、thread-models(Reactor 线程模型)、kernel-tuning-net(内核网络参数调优)
- 收包侧优化:interrupts(NAPI、GRO/GSO offload——和零拷贝同理:让 CPU 少碰数据)
六、一句话总结
传统 read+write 发文件要 4 次拷贝(2 次纯浪费的 CPU 拷贝)+ 4 次上下文切换,只因数据"路过"了用户空间。零拷贝逐级省掉这些:mmap 省掉内核→用户那次拷贝(但切换还在);sendfile 让数据全程不进用户态(切换降到 2 次);sendfile+SG-DMA 连最后一次 CPU 拷贝也由网卡 DMA 收集省掉(真正零 CPU 拷贝,Nginx/Kafka 基石);splice 用管道做页引用中转,解除"一端必须是文件"的限制(HAProxy 代理场景)。它省 CPU、省内存带宽、省切换、保 cache 热度,让单机扛更多连接。但只适合"原样转发"——要加密/压缩/改数据就绕不开用户态拷贝,HTTPS 得靠 kTLS 把加密下沉到内核才能重新用上 sendfile。