间接分支预测:quadirect 四级目标缓存与 BTB 如何减少间接跳转误预测
姊妹篇 间接分支预测(indirect-branch-prediction) 建立了一个基本事实:call *%rax / jmp *%rax 这样的间接分支,目标地址在运行时才能确定,CPU 不仅要猜「跳不跳」,还要猜「跳到哪一个地址」。本篇往硬件结构里再走一层,回答一个更具体的问题:如果同一个分支点历史上跳去过 A、B、C、D 好几个地址,预测器到底拿什么把这几个地址都记住,又凭什么在它们之间做选择?quadirect(四级目标缓存)正是这类结构的最小完整答案——为每个间接分支点保存最多 4 个最近目标,再用分支历史当索引挑出这一次最可能的那个。
它是 CPU 微架构导读(cpu-microarch-overview) 里「分支预测 + 投机执行」环节的结构性补充。本篇不再重复 BTB、方向预测器、流水线 flush 的基础定义,没接触过这些概念建议先读 分支预测(branch-prediction)。
本文要回答的问题
- 同一个
call */jmp *分支点,为什么会对应多个目标地址?哪些源码写法会产生这种情况? - 普通 BTB 只为一个分支点保存一个目标,这在多目标场景下会造成什么样的误预测?
- quadirect 四级目标缓存的结构是什么:4 个槽位怎么组织,选择器靠什么挑目标?
- 查到目标和查不到目标分别怎么处理?4 个槽位装满后新目标如何替换?
- 4 个目标的容量边界在哪里?误预测一次要付出多大代价,用 perf 怎么量出来?
一、同一个分支点,为什么会跳出多个目标
条件分支 je 的目标是指令里写死的立即数偏移,一条指令永远只对应一个落点。间接分支相反:指令编码里只有一个寄存器号或内存操作数,真正的跳转地址执行时才取出来,于是同一条指令每次执行都可能落在不同地方。
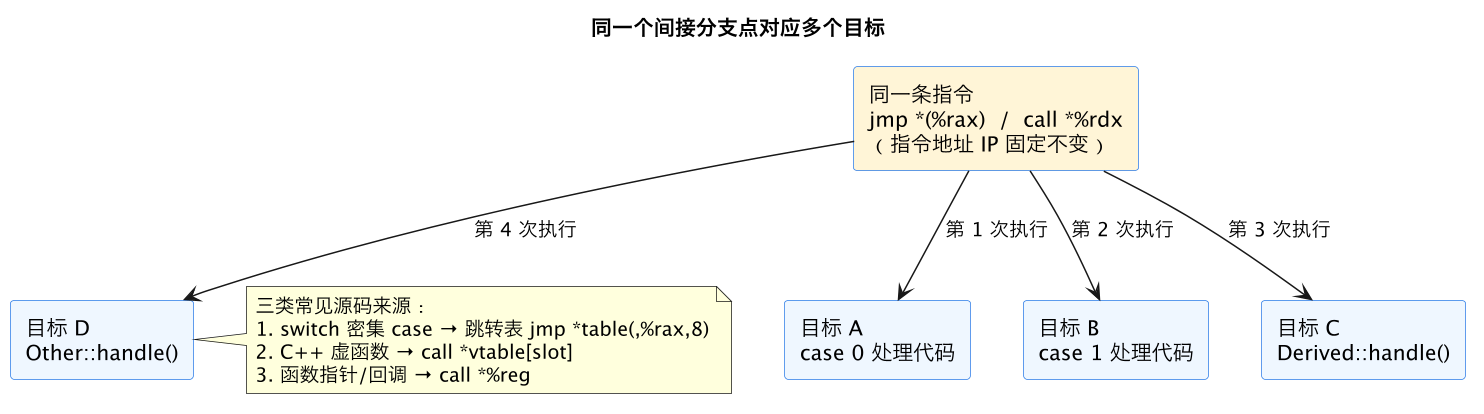
图里最关键的一点是:变化的是目标,不变的是分支点自身的指令地址。这给了预测器一个可以利用的锚点——虽然目标有多个,但它们都挂在同一个 IP 下。
三种典型来源各有各的多目标规律。编译器为 case 值密集连续的 switch 生成跳转表,一条 jmp *table(,%rax,8) 按索引跳进表中的任一表项;C++ 虚函数调用编译成 call *vtable[slot],槽位固定,但对象类型不同,槽里装的函数入口就不同;注册回调、函数指针数组、解释器的 opcode 分发放大器(dispatcher)同理。下表把它们的目标分布特征放在一起,因为目标的数量和切换规律,直接决定了后面预测器能做到多准。
| 源码写法 | 间接分支指令 | 目标个数的典型范围 | 切换规律 |
|---|---|---|---|
| switch 跳转表 | jmp *table(,%r,8) | 数个到数十个 | 常随输入数据分布,可能高度倾斜 |
| C++ 虚函数 | call *offset(%rax) | 1 个到数个(单态居多) | 同一调用点常长期只有一种类型 |
| 函数指针/回调注册表 | call *%reg | 数个到数十个 | 取决于事件类型,可能周期性轮转 |
| 解释器/VM 分发 | jmp *handler_table(,%r,8) | 等于指令集 opcode 数 | 随字节码序列,有强局部性 |
注意多目标不等于难预测:如果 95% 的执行都去同一个目标,问题退化成单目标;真正麻烦的是目标在几个地址之间反复、且切换与「程序是怎么走到这里的」相关——这正是单目标结构束手无策、而历史索引能派上用场的情形。
二、单目标 BTB:只会记住「上一次」
普通 BTB 是一张以 IP 为索引的表,每个表项记录这个分支点最近一次的跳转目标。这套机制对条件分支足够,因为条件分支本来就只有一个落点;但把它原样套到多目标间接分支上,结构性缺陷立刻暴露:表项只有一个位置,写入新目标就必然覆盖旧目标。
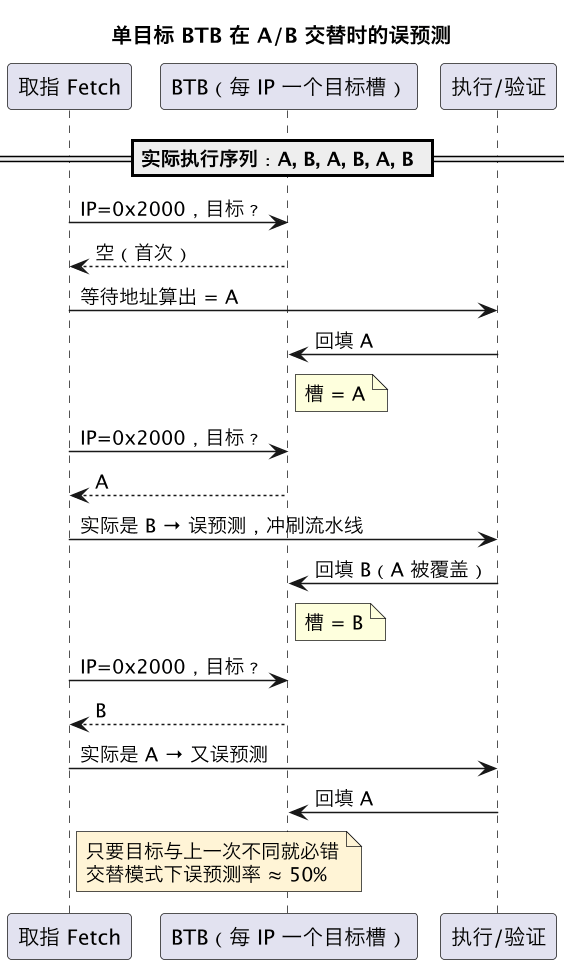
序列图展示的是最坏的规律性情形:A、B 严格交替,单目标 BTB 的命中率理论上限只有 50%——每次都拿「上一次」当「这一次」,而交替模式下两者必然不同。即使模式不那么极端,只要目标在两三个地址间轮转,每次切换都是一次误预测。
更深一层的问题是:BTB 的索引键只有 IP,它无法表达「在不同上下文里,这个分支点该去不同目标」。同一个虚函数调用点,从处理网络包的路径进来时对象是 TcpConn,从处理定时器的路径进来时是 Timer,BTB 看到的却是同一个 key,只能不断互相覆盖。要根治这个问题,需要两样东西:把多个目标同时存下来的空间,以及能区分上下文的索引信息。
| 单目标 BTB | 多目标缓存(quadirect) | |
|---|---|---|
| 每分支点目标容量 | 1 个 | 4 个 |
| 新目标写入 | 直接覆盖旧目标 | 四个槽内分配/替换,其余目标保留 |
| 目标切换 | 切换即误预测 | 在 4 个已知目标间切换可命中 |
| 选择依据 | 无,唯一条目 | 分支历史等上下文索引 |
| 适用分支 | 条件分支、单态间接分支 | 双态到四态的间接分支 |
三、quadirect:一个分支点缓存四个目标
quadirect 的思路直白而对症:既然一个分支点可能去多个地方,就把 BTB 表项里那一个目标槽扩成四个;既然单靠 IP 分不出上下文,就再配一个用分支历史驱动的选择器,在四个槽里挑一个。
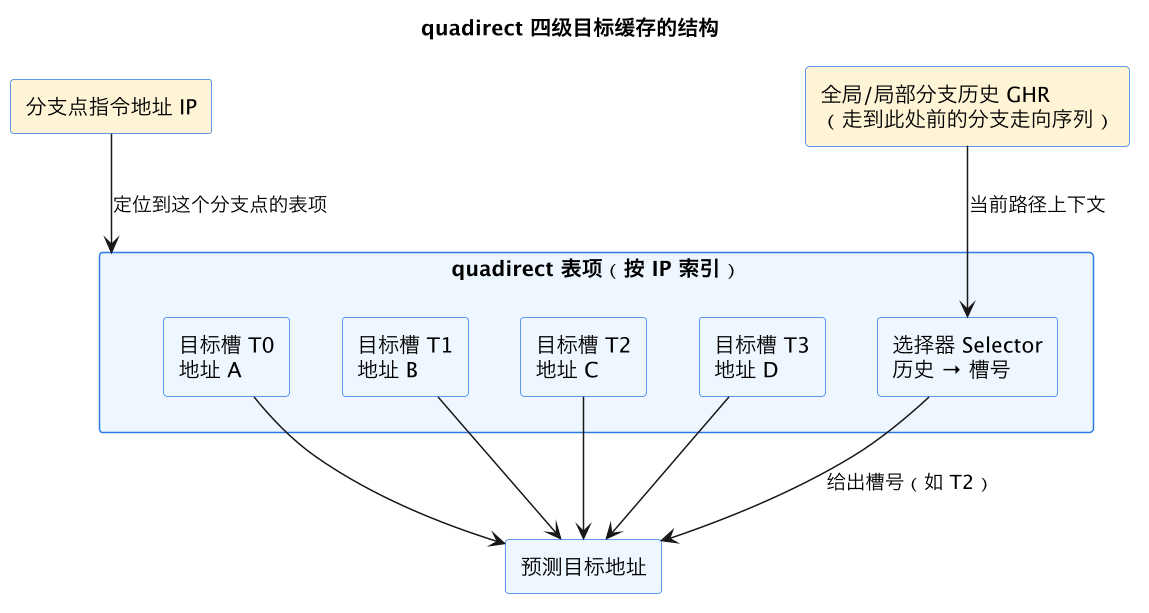
读图时把它拆成「存什么」和「怎么选」两半。存储侧,一个 IP 对应一个表项,表项内 T0–T3 四个槽各放一个最近见过的目标地址,于是 A、B、C、D 可以共存而不再互相覆盖——这直接修好了第二节里「写入即覆盖」的缺陷。选择侧,选择器以分支历史(GHR,记录到达该分支点之前若干条分支的 taken/not-taken 序列)为输入,输出一个两比特的槽号,CPU 从对应槽取目标地址送进前端流水线。
为什么是历史而不是别的?因为在真实代码里,「这次跳去哪」往往由前面的一串判断决定:opcode 怎么解码的、消息类型匹配了哪个分支、对象是在哪条路径上构造的。这些信息对预测器唯一可见的形态,就是近期分支的走向序列。历史寄存器把「程序是沿哪条路走到这里的」压缩成一串比特,选择器要学的,正是这串比特与四个目标之间的对应关系。槽位数量取 4,是硬件成本与收益的折中:四个槽覆盖了双态、三态和典型四态场景,占比最高的单态调用只占用其中一个;超过四个目标的巨态场景,则交给姊妹篇介绍的 ITTAGE 一类更长历史、更多表项的预测器处理,quadirect 代表的是「多目标缓存」这个思路最精简的形态。
四、命中、未命中与四个槽位的更新替换
预测发生在取指阶段,此刻真实目标地址还没算出来;等间接分支在执行阶段拿到真实地址,硬件再回头核对预测对不对,并按结果更新缓存。下图把查表、核对、更新三段流程画在一起。
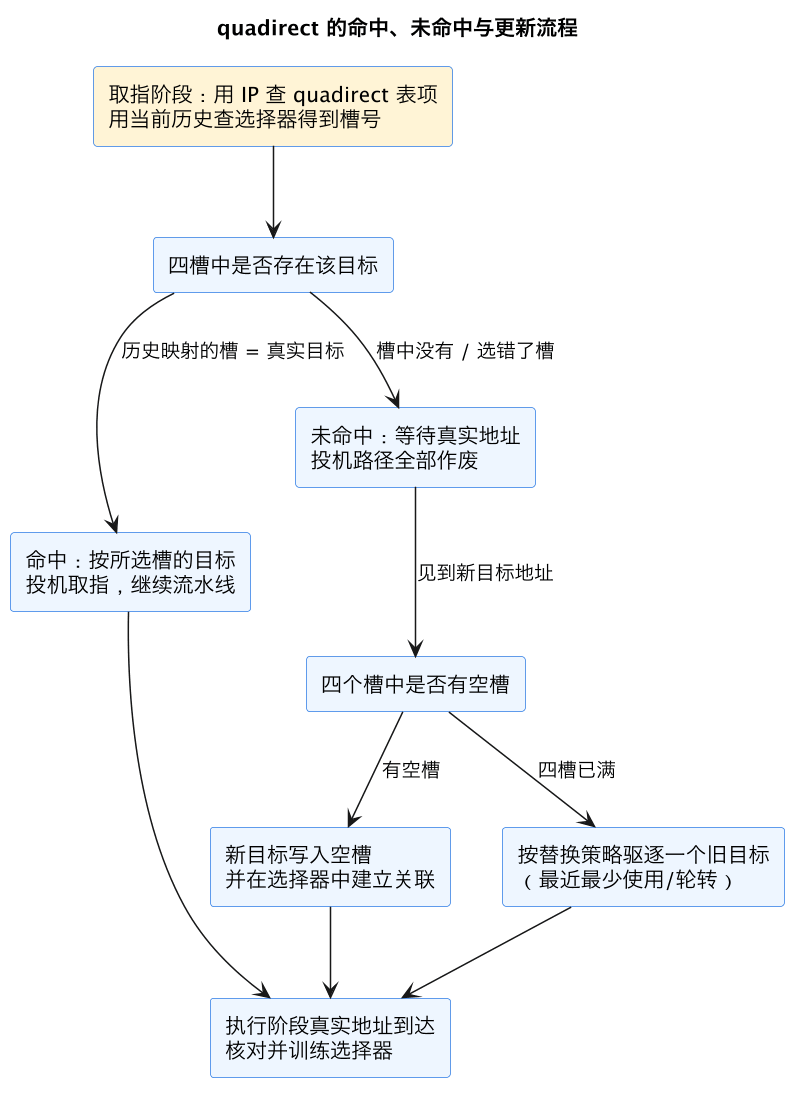
图中有两条关键路径。命中路径上,选择器给出的槽号恰好对应真实目标,投机取指沿正确地址继续,代价只是查表本身,完全对程序透明。未命中路径又分两种情况:一是目标地址确实在四个槽里,但选择器挑错了槽——这是「选择失误」,存储没丢信息,训练选择器即可;二是真实目标四个槽里都没有——这是「目标缺失」,必须先解决存储问题。
目标缺失时的更新规则决定了缓存在稳态下装着什么。首次出现的新目标优先写入空槽;四个槽都占满后,需要按替换策略驱逐一个旧目标,常见做法是驱逐最近最少使用的条目,或按轮转方式让位。与此同时,选择器记住「这样的历史模式对应新目标所在的槽」,下次同样的路径上下文再来,才能直接选中它。需要强调的是,槽位的物理位置和目标本身没有固定对应关系:T2 里今天装的是 C,驱逐重建后可能装的是 E,选择器跟着更新走。这也解释了为什么预测器需要一个「热身」过程——程序刚启动或刚发生 phase 切换时,槽是空的、选择器没训练好,前几次执行必然 miss,之后命中率才爬升。
五、用历史选目标、命中率边界与性能实测
把前面的机制收拢,可以画出 quadirect 在运行中真正做的事:历史模式在变,选择器把不同模式翻译成不同槽号,四个槽于是被「按需取用」。
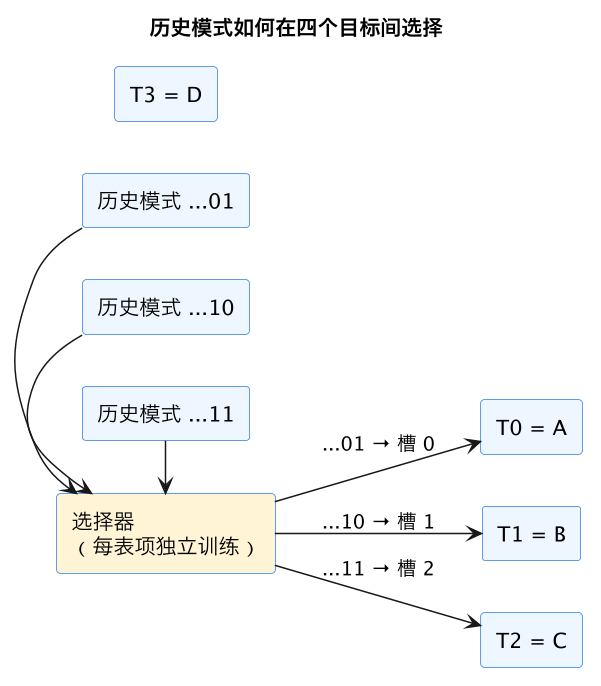
图中三种历史前缀映射到三个不同槽位,含义是:即便分支点和指令完全相同,只要到达它的路径不同,预测就分流到不同目标。这把第二节里「IP 单键无法区分上下文」的难题解开了——键从「只有 IP」变成「IP + 路径历史」,而存储只花了四个槽。
命中率的边界同样清晰。目标数不超过 4、且「历史 → 目标」存在可学规律时,quadirect 热身之后可以把误预测压到很低;目标数超过 4,第五个目标开始引发替换颠簸(thrashing),旧目标还会被再次用到时命中率下滑;目标选择与分支历史无关(比如目标由随机输入决定),选择器无规律可学,准确率退化为在四个槽里盲猜。反过来,只有 1–2 个目标的调用点,quadirect 显得「大材小用」,但也不会更慢。
误预测的惩罚要算全账:间接分支猜错地址,前端沿错误地址投机取出的指令全部作废,流水线冲刷后从正确地址重新取指;错误目标往往在不相干的代码段,I-cache 大概率缺失,还可能跨页引发 iTLB 缺失,一次误预测的总代价通常在二十到三十拍,明显高于条件分支方向误判。下表给出 perf 的量化入口,事件名与分支类型的对应关系不要搞混。
| 想确认的事 | perf 命令 / 事件 |
|---|---|
| 间接分支总量与误预测数 | perf stat -e branch-loads,branch-load-misses ./app |
| 误预测率是否超过 5% 的警戒线 | 计算 branch-load-misses / branch-loads |
| 哪个函数在间接分支上 miss | perf record -e branch-load-misses:pp -g ./app 后 perf report |
| miss 是否连带取指侧缺失 | perf stat -e branch-load-misses,L1-icache-load-misses,iTLB-load-misses ./app |
| 定位到具体指令 | perf annotate 进入 report 中的热点函数 |
branch-loads / branch-load-misses 统计的是间接分支(call * / jmp *),不要与统计条件分支的 branch-instructions / branch-misses 混用。实测时一个很有说服力的对照是:让同一调用点分别呈现单态、双态交替和五目标轮转,可以看到单态下 miss 率趋近于零,双态被四目标缓存轻松吸收,而五目标开始出现替换导致的 miss 回升。可运行的对照实验见 indirect-branch demo,make perf-branch-loads 即可复现;perf 事件的完整释义见 perf 工具文档。
这一篇在知识体系里的位置
- 姊妹篇:间接分支预测(indirect-branch-prediction)——从虚函数、函数指针、switch 跳转表的软件视角讲间接分支预测,并介绍 ITTAGE、RSB、去虚拟化与 Spectre v2;本篇是它的硬件结构补充,聚焦「多目标怎么存、怎么选」。
- 前置基础:分支预测(branch-prediction)——BTB、方向预测器、两位计数器与流水线冲刷的完整框架。
- 体系位置:CPU 微架构导读(cpu-microarch-overview)——分支预测在整条微架构演进链中的坐标;前端取指与解码的细节可对照 µop 流水线走读(uop-pipeline-walkthrough)。
- 动手观测:perf 工具文档 与 indirect-branch demo,把命中率和误预测惩罚量成数字。
总结
间接分支预测的核心难点是「一个分支点、多个目标」:单目标 BTB 只存上一次的地址,目标切换就误预测,A/B 交替时命中率上限只有 50%;quadirect 把每个分支点的目标容量扩到 4 个槽,再用分支历史驱动选择器在槽间选择,等于把索引键从「IP」升级成「IP + 路径上下文」,双态到四态且有规律的间接分支在热身后几乎不再误预测,而超过 4 个目标或目标无历史规律时会因替换颠簸和盲猜失效;一次误预测要付流水线冲刷加 I-cache、iTLB 缺失的二十到三十拍账单,用
perf stat -e branch-loads,branch-load-misses就能确认你的 switch、虚函数或回调分发是否正卡在这上面。